
Peking, 16. Oktober– Die Fanshi Intelligence Technology Group Co., Ltd. („Fanshi“ oder „die Gruppe“, Aktienkürzel: 6682.HK) gibt gemeinsam mit Beijing Ruisi Zhilian Technology Co., Ltd. („Ruisi Zhilian“) bekannt, dass die All-in-One-KI-Plattform für produktive Einsätze „Moyu“ (ModelSphere) offiziell gestartet ist. Die Plattform ist für Unternehmensnutzer kostenlos als Open Source verfügbar und integriert Rechenleistungsverwaltung, Modellbereitstellung und Laufzeitoptimierung in einer einheitlichen Plattform. Sie hilft Unternehmen, die Einstiegs- und Betriebsbarrieren für Bereitstellung und Wartung zu senken und Rechenleistung effizienter in sichere, stabile und für den realen Geschäftsbetrieb nutzbare KI-Dienste umzuwandeln. Die Plattform ist auf GitHub als Open Source verfügbar.
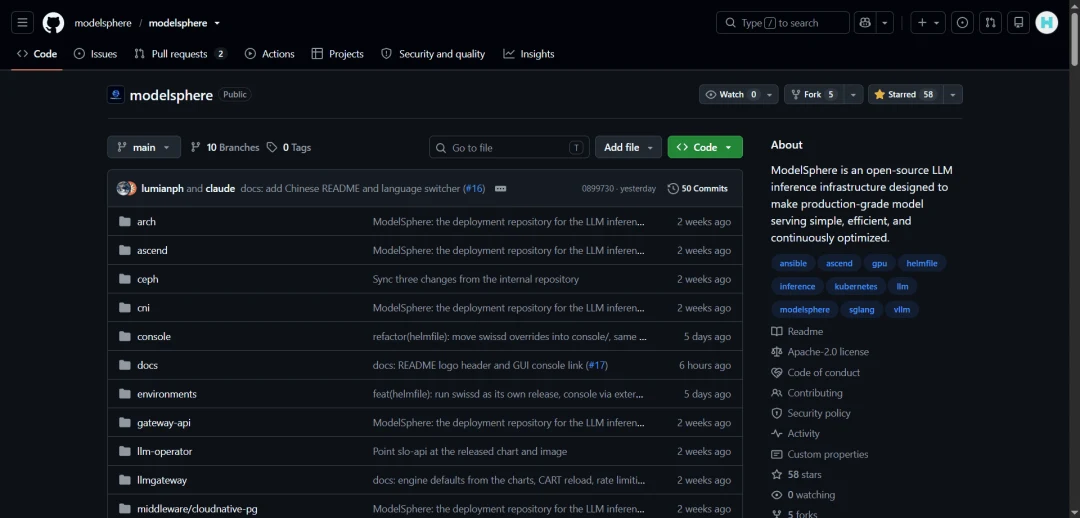
GitHub-Adresse: https://github.com/modelsphere/modelsphere
Mit dem Eintritt großer Modelle in die Phase der Kommerzialisierung im großen Maßstab stehen Unternehmen bei der Rechenleistungskoordination, Modellbereitstellung und Effizienzoptimierung häufig vor Problemen wie niedriger Ressourcenauslastung, fragmentierten Chip-Ökosystemen, hohen Bereitstellungshürden und schwieriger Optimierung in Produktionsumgebungen. Moyu setzt sich zum Ziel, diese Arbeiten in einen einheitlichen Bereitstellungs- und Verwaltungsprozess zu integrieren und wiederholte Aufwände für Anpassungen an unterliegende Systeme, Ressourcenscheduling und den täglichen Betrieb zu reduzieren. Unternehmen können so ohne tiefe Kenntnisse komplexer Aufgaben wie Treiberkompilierung und Hardwareanpassung verschiedenste Open-Source-Großmodelle in ihre Kerngeschäftsprozesse einbinden, sodass sich Technikteams stärker auf Anwendungsentwicklung und Geschäftsanforderungen konzentrieren können.
Moyu bietet vier zentrale Vorteile:
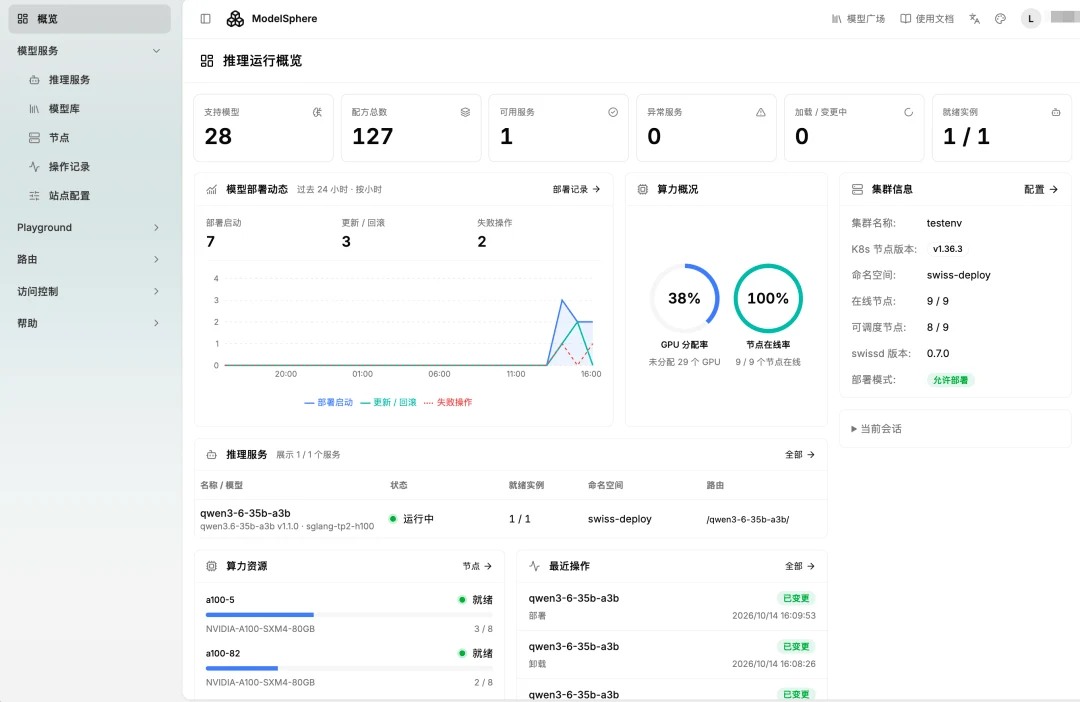
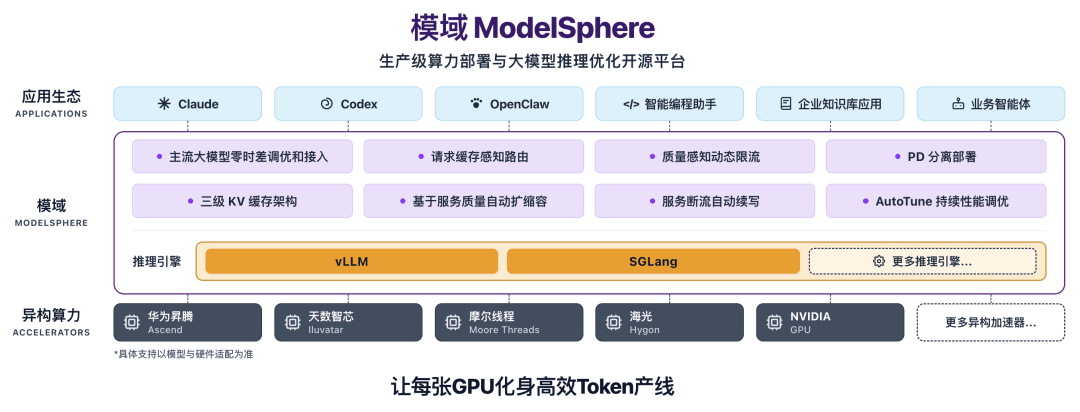
1. Vereinfachte Bereitstellung und stabiler Betrieb der Modelldienste:Moyu bietet eine grafische Bedienoberfläche und vorinstallierte Bereitstellungsfunktionen, wodurch der Aufwand für das Schreiben von Umgebungskonfigurationscode reduziert wird. Entwickler können schnell Inferenzdienste für große Modelle aufbauen und die Einrichtung verschiedener Chip-Cluster vereinfachen. Die Plattform verfügt über integrierte Unternehmensfunktionen wie automatische elastische Skalierung, PD-getrennte Bereitstellung, dreistufigen KV-Cache, hochverfügbaren Lastausgleich sowie automatische Fortsetzung nach Dienstabbrüchen und unterstützt den stabilen Betrieb von Modelldiensten in Produktionsumgebungen.
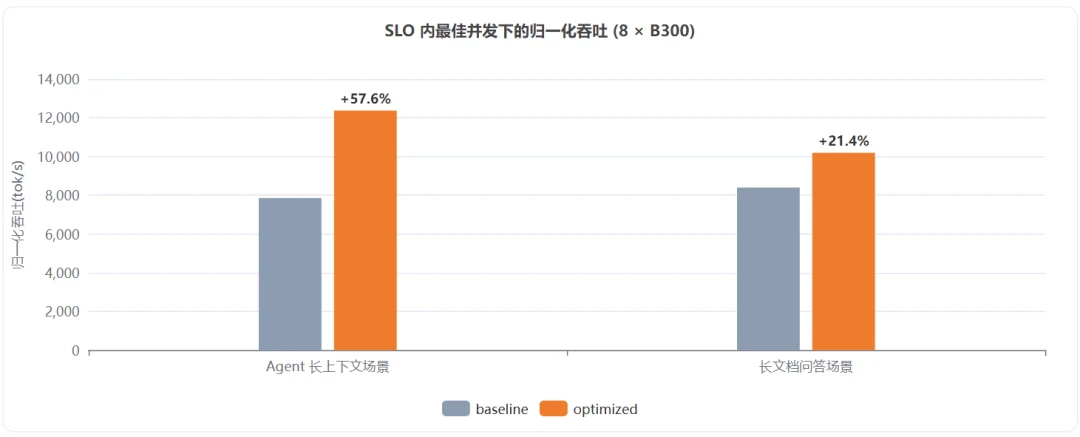
2. Kontinuierliche automatische Optimierung zur Steigerung der Modelleffizienz:Die Plattform verfügt über die intelligente Modelleinsatzstrategie AutoTune sowie einen adaptiven Lastausgleich, der Hardware-Beschleunigungsfähigkeiten nutzt. Dadurch werden die Anfrageverarbeitung der Modelle und die Zeit bis zur ersten Antwort optimiert. Der maximale Systemdurchsatz liegt deutlich etwa 285 % über dem Basiswert, die Leistung steigt auf das 4-Fache, was eine „volle“ Auslastung der Rechenleistung wahrhaftig erreicht.
3. Einheitliche Verwaltung verschiedener Chips zur Verringerung doppelter Anpassungen:Die Plattform integriert die EngineX-Inferenz-Engine, unterstützt und optimiert gezielt verschiedene Rechenchips und kann nationale Rechenleistungsressourcen wie Huawei Ascend, Tianshu Zhixin, Moore Threads und Hygon DCU einheitlich und gemischt verwalten, ohne dass Nutzer zugrunde liegenden Logikcode für verschiedene Chips neu schreiben müssen.
4. Kontinuierliche Optimierung der Anpassung an gängige Modelle zur beschleunigten Bereitstellung und Anwendung:Das Moyu-Team verfolgt kontinuierlich die Weiterentwicklung der Open-Source-Community und hat bereits gängige Modelle wie DeepSeek-V4/V4-Flash, Qwen, Kimi, MiniMax und GLM angepasst und optimiert, sodass eine schnelle Bereitstellung nach Modellveröffentlichung sowie eine Leistungsoptimierung für Produktionsumgebungen möglich ist und Unternehmen neue Modelle in ihre Geschäftspraxis integrieren können.
Auf technischer Ebene arbeitet Moyu mit Inferenz-Engines wie vLLM und SGLang zusammen: Die Inferenz-Engine verbessert die Recheneffizienz eines einzelnen Servers, während Moyu für die Verwaltung und Optimierung auf Cluster-Architekturebene verantwortlich ist, einschließlich last- und cachebewusstem Anfragenrouting, einheitlichem KV-Cache-Pool, automatischer skalierung basierend auf Dienstqualität, automatischer Fortsetzung nach Dienstabbrüchen, automatischer Leistungsoptimierung auf Basis von Echtzeitdaten, Betriebsüberwachung und Dienstverwaltung, um hohe Leistung und Hochverfügbarkeit des Systems in Produktionsumgebungen zu gewährleisten.
Moyu ist unter der liberalen Apache 2.0-Lizenz vollständig als Open Source verfügbar und stellt Unternehmen und Entwicklern Engineering-Kompetenzen für Bereitstellung und Optimierung großer Modelle zur Verfügung. Gleichzeitig bündelt die Plattform Kräfte aus der Branche, um die Unterstützung verschiedener Chips und Modelle kontinuierlich zu verbessern, Hardwareanpassungshürden abzubauen, die Einstiegshürden für den Einsatz großer Modelle zu senken und Unternehmen zu helfen, vorhandene Rechenleistung optimal zu nutzen und das kommerzielle Potenzial heterogener Rechenleistung effizient freizusetzen.
Dieser Artikel wurde von Fanshi bereitgestellt. QbitAI hat ihn mit Genehmigung nachgedruckt; die Meinung liegt beim ursprünglichen Autor.