
Jin Lei, aus Shenzhen
Quantum Bit | Public Account QbitAI
Furcht ist eine sehr schlechte Art der Entscheidungsfindung.
Wenn Unternehmen Angst haben, die Chance für eine Transformation in Richtung KI zu verpassen, erinnert Amazon-CTO Werner Vogels daran, dass je mehr man sich beeilt, desto wichtiger ist es, erst einmal klar zu werden: Welche Probleme das Unternehmen wirklich lösen möchte und welchen Beitrag KI leisten kann.
Heutzutage kommen jeden Woche neue Modelle auf den Markt. Die Leute werden immer besorgter, aus Angst, dass sie einen Schritt zu langsam sind. Der Wunsch nach Effizienz und Innovation ist immer dringender, aber was die Technologie eigentlich kann, wird nicht richtig verstanden.
Bei einer Diskussion in Shenzhen sagte er offenherzig, dass Unternehmen nicht sofort zugrunde gehen würden, weil sie im Moment keine AI verwenden. Deshalb müssen Unternehmen vor der Entscheidung erst sicherstellen, dass Ingenieure und Manager die Technologie vollständig verstehen.
Aber wenn diese Worte aus Werners Mund kommen, hat das etwas Ungewöhnliches an sich.
Schließlich ist dieser technische Veteran, der seit mehr als zwanzig Jahren als CTO bei Amazon tätig ist, nie bereit, das Unmögliche zu akzeptieren. Wenn es um die Hintergründe von Cloud Computing geht, zitiert er extra den Satz des Computerpioniers Grace Hopper, um Entwickler daran zu erinnern, vorsichtig zu sein vor dem Spruch „Wir haben immer so gemacht“.
Warum ermutigt jemand, der Ingenieure dazu anregt, das Normalverhalten zu brechen, bei KI die Leute dazu zu bringen, sich erst einmal zu beruhigen?
Die von ihm beschriebene Datenbankpanne könnte vielleicht die scheinbar widersprüchliche Haltung erklären.
Die Fallen, die das Datenbank-System erlebt hat, soll die KI noch einmal durchmachen?
Am 12. Dezember 2004 befand sich Amazon in einem entscheidenden Punkt der Weihnachtskaufsaison. Damals konnten Nutzer, die 25 US-Dollar einbrachten, kostenlosen Versand erhalten, aber der Versand benötigte Zeit. Wenn man später bestellte, könnte das Paket nicht rechtzeitig für Weihnachten fertig sein.
Genau an diesem Tag hatte das gemeinsame Datenspeicher hinter der Kundendatenbank einen Defekt, sodass die Nutzer nicht einloggen konnten und keine Bestellungen ausführen konnten. Laut Werners Erinnerung dauerte dieser Defektmehr als zwölf Stunden, wodurch AmazonMilliarden von US-Dollar verloren ging.
Der Datenbankanbieter kam später vorbei. Werner hatte erwartet, dass der andere eine ernsthafte Entschuldigung machen würde, aber stattdessen hörte er: „Ihr solltet die Tests gut durchführen.“
Wenn ein Problem mit dem eigenen Produkt auftritt, wem soll man dann die Schuld geben?
Werner war natürlich wütend, aber er erkannte später auch, dass die Größe von Amazon tatsächlich weit über den Rahmen des Designs dieses Geschäftsprogramms hinausgeht. Das weitere Streiten mit den Lieferanten würde auch keine Lösung für das nächste Problem bringen.
Daher begann das Team eine grundlegendere Frage zu untersuchen. Wie verwendet Amazon tatsächlich die Datenbank?
Laut den Untersuchungsergebnissen benötigen etwa 70% der Anwendungsfälle für relationale Datenbanken nur den Zugriff über Schlüssel-Wert-Paare.
Im Fall des Warenkorbes benötigt das System normalerweise nur die Benutzeridentität, um den entsprechenden Warenkorb abzurufen. Amazon muss nicht alle Warenkörbe aller Benutzer ausliefern und eine komplexe Abfrage durchführen.
Da die Anforderungen so sind, könnte das Team einen anderen Implementierungsansatz verwenden? Wenn man den tatsächlichen Zugriff betrachtet, hat das Team ein Key-Value-Speicher-System Dynamo erstellt, welches der Vorläufer von DynamoDB ist.
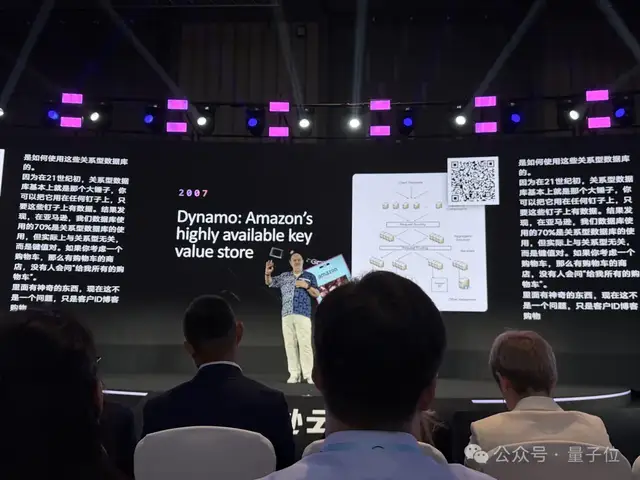
Diese Erfahrung hat heute ein gewisses Echo. Damals nutzten alle relationale Datenbanken als großen Hammer, um verschiedene Datenprobleme zu lösen, und heute kann auch das große Modell leicht dazu dienen.
Wenn es um die Verwendung von KI durch Unternehmen geht, stellt Werner wiederholt ähnliche Fragen. Was genau wollen die Unternehmen lösen? Ist KI geeignet? Ist die aktuelle Generation von KI geeignet?
Er erinnerte daran, dass in Bereichen wie Bildverarbeitung, Sprachverarbeitung und Vorhersage bereits viele effektive Methoden gesammelt wurden. Bevor Unternehmen eine Technologie wählen, müssen sie zunächst die Aufgabe selbst betrachten. Auch wenn es sich um große Modelle handelt, ist es nicht notwendig, den ersten Platz in der Rangliste zu erreichen.
Werner hat Bedenken bezüglich der Benchmarktests, da es noch einen Unterschied zwischen künstlich erstellten Tests und dem echten Geschäftsbetrieb gibt. Wenn ein Modell bereits ausreicht, um die Aufgabe zu erfüllen, müssen Unternehmen überdenken, ob sie weiterhin für eine höhere Platzierung Geld zahlen sollten.
Und Werner hat diese Rechnung bereits mehr als zwanzig Jahre lang gerechnet.
Als das Thema der Diskussion sich auf die grundlegenden Veränderungen durch Cloud Computing richtet, legt er besonderen Wert auf die Veränderung des Wirtschaftsmodells.
Früher musste man bei der Kauf von Unternehmenssoftware oft einen Vertrag für fünf oder zehn Jahre abschließen. Die Manager hatten es kaum geschafft, die Bedürfnisse des nächsten Jahres vorherzusagen, und mussten trotzdem das Geld auszahlen. Werner meinte, das sei wie wenn ein Kunde im Restaurant tausend Dollar hinterlässt, ohne etwas zu essen, und kein Geld zurückbekommt.
Cloud Computing verbindet die Ressourcennutzung mit den Kosten und gibt der „Skalierung“ auch eine wirkliche Bedeutung. Wenn es nachts nicht so viele Benutzer gibt, kann das Unternehmen die nicht benötigten Ressourcen schalten. Die Kosten können endlich in die Architekturdiskussion einfließen, und die Geschäftsbereiche müssen auch beantworten, wie viel Geld für eine bestimmte Fähigkeit eigentlich ausgegeben werden sollte.
In der AI-Ära gibt es wieder ein neues Projekt für diese Rechnung.
Zum Beispiel, als die Quantenbit gefragt wurde: „Warum ist das Vergessen eines Agenten sogar ein wichtiges ingenieurtechnisches Problem?“ sagte Werner direkt. Wenn der Agent vor jeder Arbeit alle Informationen scannen müsste, die er kennt, würde das Systemaufwand erzeugen; Entwickler müssen einen Weg finden, damit er nur noch das behält, was für die Aufgabe wirklich wichtig ist.
Er sagte auch, dass bei der Neustartung einiger Programmierwerkzeuge erneut der Inhalt des Projekts geladen wird. Die Nutzer haben gestern bereits für diese Vorbereitungen Geld bezahlt, und heute müssen sie wieder zahlen. Kiros Überschallisten soll dazu beitragen, solche wiederholten Arbeiten zu verringern.
Also, abgesehen davon, wie intelligent das Modell ist, müssen die Entwickler weiterhin fragen: Wie viele unnötige Aufgaben hat das Modell wiederholt erledigt, um eine Aufgabe zu erledigen.
Das erklärt auch, warum Werner bereit ist, kleinere Modelle zu besprechen, sowie offene Gewicht-Modelle wie DeepSeek, Tongyi Qianwen und Kimi. Nach seinen Beobachtungen haben einige Kunden durch kontinuierliche Experimente festgestellt, dass kleinere Modelle bereits die Anforderungen erfüllen und die Kosten deutlich niedriger sind.
Womit man es macht, wie man es macht und wie viel Geld es kostet – diese alten Fragen können Unternehmen auch mit KI nicht umgehen.
Wer wird für die Fehler des Agenten verantwortlich sein?
Selbst wenn das Unternehmen die Kosten kalkuliert hat, gibt es noch ein weiteres Problem, das auf die Entwicklungsmannschaft wartet.
Der Chatbot gibt einen Text an, den der Mensch lesen kann, bevor er entscheidet, was zu tun ist. Der Agent handelt dann im Namen des Benutzers: er ändert den Plan, ruft Tools herbei oder führt Programme aus. Wenn das Modell eine falsche Antwort gibt, kann der Fehler im Laufe des Vorgehens zu realen Folgen werden.
Werner sagte im Gespräch, dass er gerne die Hilfe des Agenten für die Änderung der Zugtickets in Anspruch nehmen würde, aber er hatte auch klare Anforderungen. Das System muss wissen, wie es zu handeln hat, seine Präferenzen im Gedächtnis behalten und gleichzeitig eingeschränkt werden.
Und diese Besessenheit mit den Grenzen wird in der Nitro-geschichte, die er erzählt, bereits erwähnt.
Frühe Cloud-Computing-Anwendungen waren auf Virtualisierung angewiesen, indem ein physischer Server an mehrere Benutzer verteilt wurde; doch die Software, die für die Verwaltung von Virtualisierungsmaschinen, die Netzwerk- und Speicherzugriffe verarbeitet, auch Ressourcen verbraucht, kann ebenfalls ein Hindernis werden. Mit zunehmender Anzahl an Virtualisierungsmaschinen kann die Verwaltung sogar zu einem Engpass werden.
AWS baute später Nitro auf, entferte viele Funktionen wie Netzwerk und Speicher von speziellen Hardware, und entfernte die ursprüngliche vollständige Linux-Verwaltungsumgebung dom0. Das Team reduzierte die Leistungseinschränkungen und verringerte dadurch auch das Angriffsflächenrisiko erheblich.
Nitro hat noch ein interessantes Design namens „Passive Kommunikation“. Laut Werner wartet der virtuelle Maschinenmonitor auf Befehle vom Nitro-Controller. Wenn er das Gegenteil tut und aktiv mit dem Controller in Kontakt tritt, entsteht Verhalten, das im normalen Prozess nicht vorkommen sollte. Die Plattform kann daraufhin das betreffende System aus dem Dienst nehmen und eine Untersuchung starten.
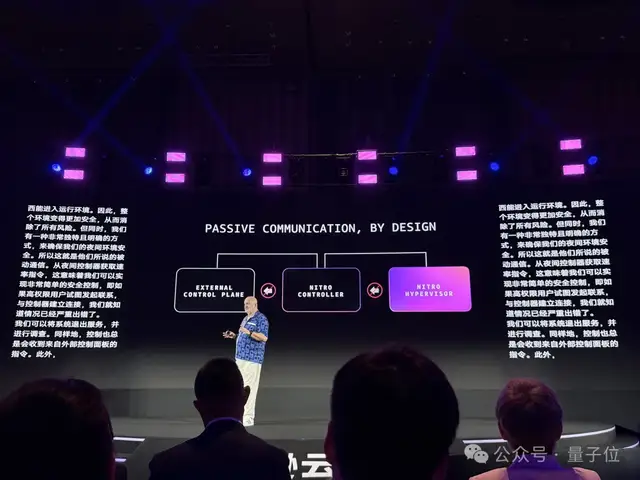
Mit diesem Ansatz ist es auch einfacher, Werners Anforderungen an den Agent zu verstehen. Was das System erlauben darf, muss im Voraus klar definiert werden. Er gab ein einfaches Beispiel an: Der Benutzer kann festlegen, dass der Agent pro Tag nicht mehr als 100 US-Dollar ausgeben darf; sobald dies überschritten wird, muss eine menschliche Entscheidung getroffen werden.
Laut seiner Einführung hat Amazon ein Mechanismus zur Ausführung von Regeln für den Agent entwickelt. Dieser überprüft Aktivitäten wie die Nutzung von Tools und das Ausführen von Skripten, um zu verhindern, dass der Agent innerhalb des klar genehmigten Bereichs des Kunden handelt.
Die Autorisierung des Benutzers für freie Handlungen legt eine konkrete Grenze fest; selbst wenn das Modell entscheidet, dass etwas getan werden sollte, muss das Ausführungssystem noch überprüfen, ob es die Berechtigung dafür hat.
Aber könnten diese Einschränkungen die Effizienz des Agents beeinträchtigen? Auf diese Frage antwortete Werner zunächst mitVerantwortung.
Wenn du es baust, bist du dafür verantwortlich. (Du baut es, du besitzt es.)
Seiner Ansicht nach müssen die Entwickler des Agents in der Lage sein, es zu kontrollieren. Welche Handlungen das System ausführt und ob es die Grenzen überschreitet, muss letztendlich von Menschen überwacht werden.
Werner hat auch sein Vertrauen in die AI wieder in die Erfahrung mit verteilten Systemen umgesetzt. Ingenieure gehen niemals davon aus, dass jedes Komponenten für immer zuverlässig ist, deshalb sind Kopien, Isolation und verschiedene Zuverlässigkeitsmechanismen notwendig. Das Team muss auf jede einzelne Komponente achten, um Vertrauen in das gesamte System zu gewinnen.
Aber die Ingenieure müssen diese Schutzmechanismen so gestalten, dass die Kunden sie bezahlbar nutzen können und gleichzeitig nicht die Leistung beeinträchtigen. Es gibt viele Entscheidungen, die getroffen werden müssen. Lambda hat bereits ähnliche Herausforderungen erlebt.
In den Anfangsjahren musste WeTransfer, um die auf S3 hochgeladenen Dateien zu verarbeiten, eine Reihe von Berechnungsinstanzen laufen lassen, während neue Dateien eintrafen. Der Kunde musste ein ganzes Infrastruktursystem unterhalten, nur um auf das Ereignis zu warten.
AWS möchte diese Arbeiten übernehmen, sodass die Kunden Code einreichen und nach der Ausführungszeit sowie dem Speicherverbrauch bezahlen. Das Team hat sich über die Bezahlweise und wie das Grundlagenwerk effizient umgesetzt werden kann ausgedrückt, aber es bleibt immer noch eine Herausforderung.
Um verschiedene Kunden voneinander zu trennen, waren die virtuellen Maschinen, die zu Beginn von Lambda verwendet wurden, für Funktionstasks immer noch zu groß und kostspielig. Später machte das Team mit Firecracker die Isolierungsuniten zu leichteren Mikrovirtuellen, wodurch die Ressourcennutzung verbessert wurde.
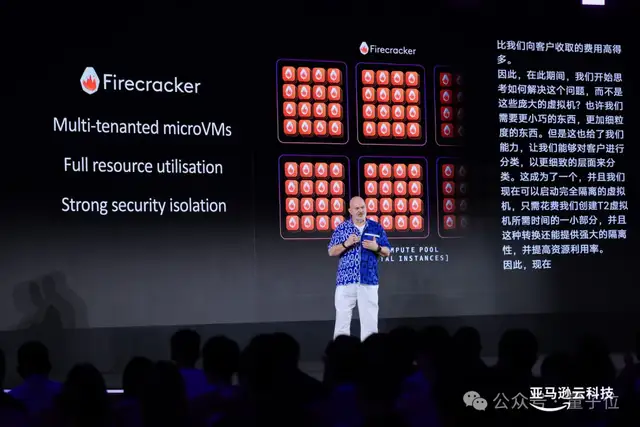
Nach der Lösung des Isolationsproblems muss das Team noch den Kaltstart bewältigen. Bevor die Funktion tatsächlich ausgeführt wird, muss das System die Betriebsumgebung, den Code und die Abhängigkeiten bereitstellen. SnapStart reduziert diesen Vorbereitungsaufwand durch die Speicherung einer Snapshot der initialisierten Umgebung und verbessert so den Startverlauf.
Was der Kunde sieht, ist möglicherweise nur eine einfache Funktionaufruf. Die Entwickler-Team muss jedoch hinter den Kulissen kontinuierlich die Isolierung, Ressourcenzuteilung, Start und Netzwerkmethoden verbessern.
Werner bezeichnet diese Arbeiten als „unsichtbene Ingenieurrevolution“ (Invisible Engineering”).
Um in den tatsächlichen Betrieb einzutreten, sind diese Details für das Entwicklungsteam unerlässlich. Nachdem die Demonstration erfolgreich abgehalten wurde, muss das Team weiterhin klären, wie die Rechte eingeschränkt werden, wie Anomalien behandelt werden und welche Ausmaße der Aufgaben der Benutzer bereit sind, ihnen zu überlassen.
Erfahrung hat keinen Komprimierungsalgorithmus
Wenn der Agent mit dem Schreiben von Code beginnt, gelangen diese Probleme wieder zu den Entwicklerteammitgliedern zurück.
Über die Beschäftigung von Grundlagen-Ingenieuren antwortete Werner, dass die Anzahl der von Amazon eingestellten Grundlagen-Ingenieure wie in der Vergangenheit ist. Danach wandte er das Thema auf das Lernen der Neulinge nach ihrem Eintritt in das Team um.
Ein gerade abgeschlossener Student tritt in das S3-Team ein und muss sich mit Code aus vor zwanzig Jahren auseinandersetzen. Es ist schwierig für die Schule, ihm frühzeitig beizubringen, wie man ein solches System versteht sowie wie man die Mitarbeiter zusammenarbeiten lässt, um es zu warten und zu pflegen.
Daher legt Werner Wert auf Neugier, Lernfähigkeit und Erfahrungen mit Open-Source-Projekten. Dass ein Neuling an Open-Source-Kooperationen teilgenommen hat, bedeutet, dass seine Codekodierung von anderen überprüft wurde und er auch Probleme mit anderen lösen muss.
Die KI kann Neulingen die Teamregeln erklären, sodass erfahrene Ingenieure weniger Zeit damit verlieren müssen, immer wieder zu erklären. Als Werner Kiro vorstellte, betonte er auch die Leitlinien der Spezifikationsbeschreibung. Die Entwickler geben zunächst die Anforderungen, die Architektur und die Entwicklungsregeln klar vor, bevor das System in Betrieb geht.
Aber die Geschwindigkeit, mit der die AI-Generierung von Code stattfindet, ist gestiegen, und die Geschwindigkeit, mit der das Team den Code versteht und überprüft, muss nicht immer mit dieser Geschwindigkeit gehen.
Werner erwähnte ein Konzept, das die Entwicklungsteam beachten sollte: die Verifizierung von Schulden.
In der Vergangenheit nahmen Entwickler, um den Zeitplan zu schaffen, Abkürzungen und notierten, dass sie später repariert werden müssen. Das, was sie aufbauten, ist technisches Schuldenrisiko. Heute haben in den von KI erstellten Code-Teilen einige Teile noch nicht überprüft werden können, und das Team hinterlässt somit eine weitere Schuldenrisiko.
Ein Interface-Element, der ein paar Millimeter abweicht, unterscheidet sich von einem Code, der möglicherweise Kundendaten preisgibt, stark von den Folgen. Das Entwicklungsteam muss nach dem Risikomanagement Überprüfungen durchführen und seine Energie auf die Bereiche konzentrieren, die am dringendsten verifiziert werden müssen.
Aus der Sicht von Werner ist es einfach, dass das Team die Code-Menge erhöhen kann, aber ob man diese Code versteht und die damit verbundenen Konsequenzen übernimmt, muss anders bewertet werden. Andernfalls wird die Zeit, die Entwickler heute sparen, möglicherweise in späteren Fehlersuche- und Rückbau-Prozessen wieder verschwendet werden.
Das ist auch der Grund, warum Werner darauf besteht, dass die Junior-Ingenieure den Code lesen und mit den erfahrenen Ingenieuren überprüfen und diskutieren. Werkzeuge können Wissen erklären, aber das Urteilsvermögen, das für konkrete Probleme benötigt wird, muss weiterhin schrittweise aufgebaut werden.
Erfahrung hat keinen Komprimierungsalgorithmus.
Werners Worte sind eine passende Antwort auf die Sorgen der Entwickler.
Aber wenn es um die Reise nach China ging, erzählte er wieder ein Beispiel, das seine Zuversicht in die Anwendung von KI verstärkte. Er verbrachte viel Zeit damit, die Besuchsreisen zu „Reis und Klebreis“ vorzustellen.
Die Institution bietet Interventionen für Kinder mit Entwicklungsbedarf wie Autismus und Aufmerksamkeitsdefizit-Hyperaktivitätsstörung an. Laut Werner nutzt die Institution AI-Analyse von Unterrichtsaufzeichnungen und beobachtet den Fortschritt der Kinder, um den Therapeuten Anregungen zu geben. Die Therapeuten entscheiden anschließend auf Grundlage ihres fachlichen Urteils, welche Vorschläge angewandt werden sollen.
Was ihn beeindruckte, war, dass die KI den Fachleuten hilft, administrative Arbeiten zu reduzieren, sodass sie mehr Energie für ihre Kinder und ihre Familie haben können.
Wenn es um diesen Punkt geht, hat Werners Optimismus einen konkreten Gegenstand. Welche Menschen können durch Technologie weniger Belastung erleiden und welche haben es ohnehin schwer, Unterstützung zu bekommen? Diese konkreten Anwendungen zeigten ihm den Wert von KI.
Wenn man zurückblickt auf die Aussage „Zuerst drücken Sie die Pause-Taste“, werden die Dinge, die eine Unternehmen tun muss, um klar zu denken, konkret. Ob die Aufgabe für eine KI geeignet ist, ob die Kosten übernommen werden können, wie der Umfang der Handlungen festgelegt werden soll und wer die Ergebnisse überprüft, müssen alle diese Punkte von der Entwicklungsteam beantwortet werden.
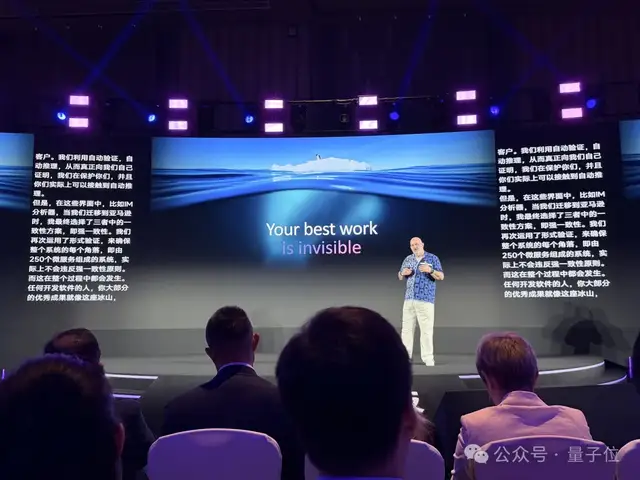
Werner sagte, dass die beste Arbeit der Entwickler oft an Orten stattfindet, die andere nicht sehen können.
Die AI hat einen Code für die Leute geschrieben, und die Ingenieure müssen wissen, was nach der Veröffentlichung dieses Codes passieren wird.