
Entwicklung effizienterer Quantenkreise mit Claude
16. Oktober 2026
Quantencomputer benötigen sorgfältig entworfene Schaltkreise, um auf begrenztem Hardware-Equipment nützliche Algorithmen ausführen zu können. Wir haben Claude spezifische Anweisungen in einfacher Sprache für acht solche Schaltkreise gegeben, die aus Chemie, Optimierung, Physiksimulation und Zahlentheorie stammen, sowie einen automatisierten Bewertungsmechanismus, der jede Konstruktion überprüft und bewertet. Claude arbeitete größtenteils selbstständig und fand Konstruktionen, die die besten veröffentlichten Schaltkreise verbessern – in einigen Fällen um eine Größenordnung oder mehr. Solche Verbesserungen reduzieren erheblich die Quantenressourcen, die nützliche Anwendungen benötigen, sodass praktische Quantencomputer früher als erwartet entstehen könnten.
Dieses Projekt wurde von Andi Gu als Teil des STEM Fellows-Programms von Anthropic geleitet, unter der Mentorenleitung von Alek Kemeny, einem Quantenphysiker bei Anthropic. Es fand in Zusammenarbeit mit Susanne Yelin (Harvard University) und Mikhail Lukin (Harvard University und QuEra Computing) statt Lesen Sie den vollständigen Artikel auf arXiv.
Im Gegensatz zu klassischen Computern, die Informationen in Bits speichern, deren Wert entweder 0 oder 1 ist, speichern Quantencomputer Information in Qubits, die aus einzelnen Atomen, supraleitenden Schaltkreisen oder Lichtteilchen entstehen können. Diese Qubits nutzen Quanteneffekte wie Superposition – wodurch ein Quantensystem gleichzeitig in einer Kombination von Zuständen existieren kann – um Informationen auf eine Weise zu verarbeiten, die bestimmte Probleme in Bereichen wie Chemie, Materialwissenschaft und Zahlenlehre zugänglich macht, selbst wenn sie für traditionelle Computer zu schwierig sind.
Die bisher entwickelten Quantencomputer haben nur Hunderte bis Tausende von Qubits – zu wenige, um viele der Algorithmen durchzuführen, die über praktische Vorteile gegenüber klassischen Computern verfügen. Und diese Qubits sind sehr empfindlich gegenüber Umwelteinflüssen wie Wärme, Vibrationen und sogar kosmischen Strahlen. Ein kleiner Störfaktor kann den Zustand eines Qubits verändern, und diese kleine Fehler sammeln sich an, bis der Computer die falsche Antwort gibt.
Da sowohl die Qubits als auch die Rechenzeit knappe Ressourcen sind, haben Forscher daran gearbeitet, Quantenalgoritmen neu zu gestalten, um weniger Qubits zu verwenden und die Berechnungen in kürzerer Zeit durchzuführen. Ein beispielhafteres Beispiel ist die Simulation von FeMoco, dem Eisen-Sauerstoffkomplex im Zentrum von Nitrogenase, der Enzym, das Bakterien verwenden, um Stickstoff aus der Luft in Ammoniak zu wandeln. Die Kenntnis dessen, wie es funktioniert, könnte Wissenschaftlern helfen, bessere industrielle Katalysatoren zu entwickeln – die Substanzen, die Hersteller verwenden, um chemische Reaktionen zu beschleunigen.
Im Jahr 2017 schätzten Forscher, dass ein Quantencomputer etwa 50 Billionen Toffoli-Gates benötigen würde, um die Energie des Grundzustands von FeMoco zu berechnen – die Energie seiner stabilsten Konfiguration, die von Chemikern benötigt wird, um vorherzusagen, wie FeMoco reagiert. (Ähnlich wie normale Computer arbeiten Quantencomputer durch die Anwendung einer langen Abfolge einfacher Operationen, genannt Gates, auf ihre Qubits.) Die Toffoli-Gate ist eine der teuersten Gate, die betrieben werden müssen, daher ist die Zählung der Toffoli-Gates eine Standardmethode, um zu schätzen, wie lange eine Berechnung dauern wird.
Durch eine Reihe von algorithmischen Fortschritten ist die geschätzte Anzahl der Gate verringert auf etwa 340 Millionen – ein Rückgang von etwa 150.000-fach, was einer wenigen Stunden an Rechenzeit auf einer zukünftigen Maschine mit etwa drei Millionen physischen Qubits entspricht.1
Diese Reduzierungen stammten größtenteils von der Neugestaltung der Schaltkreise, die die Berechnungen durchführen, und nicht von der Verbesserung des Hardware. Claude hat sich besonders gut darin bewiesen, klassische Algoritmen zu optimieren, daher wollten wir sehen, ob es das Gleiche mit Quantenalgorithmen tun könnte, wenn ihm nur eine klare Beschreibung gegeben wird, was jeder Schaltkreis berechnen muss.
Claude ist aus mehreren Gründen besonders geeignet für diese Aufgabe. Erstens werden Quantenalgorithmen als QuantenKreise implementiert. Diese bestehen aus Sequenzen von Schaltern, wie die Toffoli-Schalter oben erwähnt. Wichtig ist, dass diese Kreise in Code beschrieben werden können, sodass wir die Kodierfähigkeiten von Claude nutzen können, um Designs der Kreise wie gewöhnliche Programme zu schreiben, auszuführen und zu überarbeiten. Zweitens können die (erheblich verbreiteten) Klassen von Quantenalgorithmen, die wir am meisten interessiert haben, effizient für ihre Korrektheit getestet werden, da jeder Eingabe ein bestimmtes Ergebnis gegeben wird, das ein gewöhnlicher Computer überprüfen kann. Das bedeutet, dass wir einen externen Bewertungsprogramm haben könnten, um Clodes Vorschläge zu validieren. Schließlich können wir Claude eine klare, objektive Punktzahl geben, um zu verbessern: die Anzahl der Qubits, die verwendet werden, multipliziert mit der Anzahl der Schalter, was als Proxy für die Laufzeit des Kreises dient.
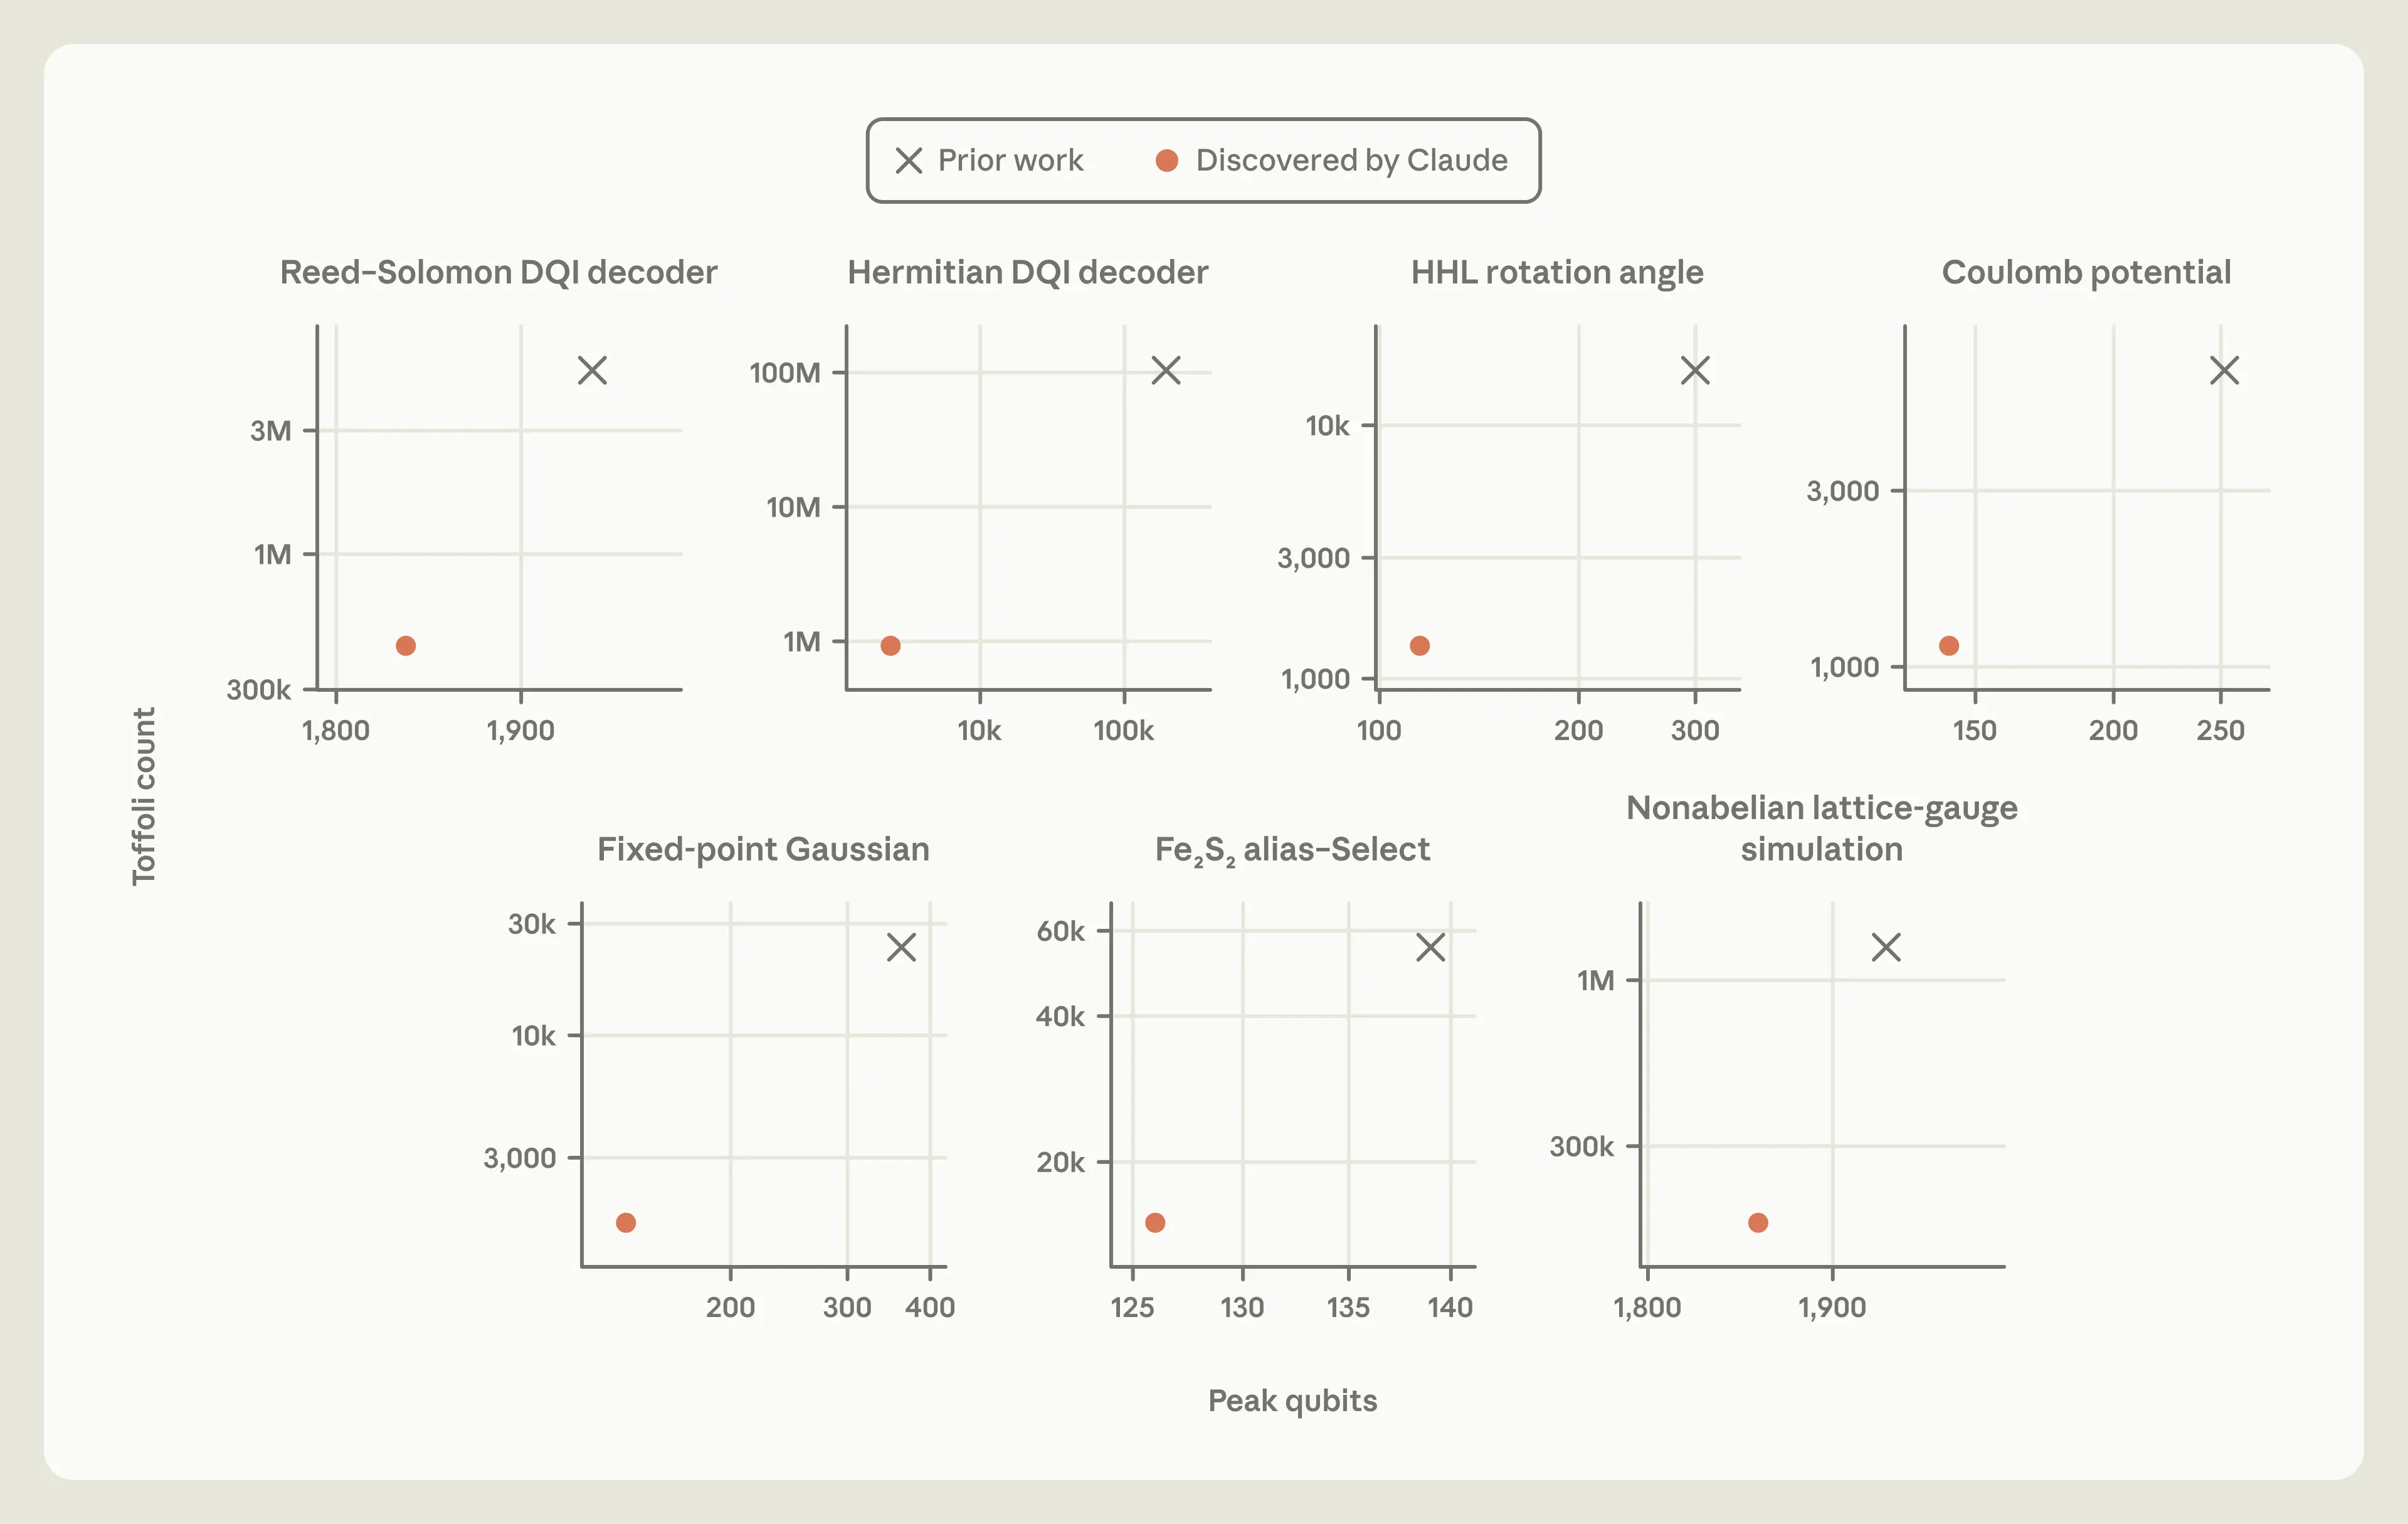
Wir haben festgestellt, dass Claude Mythos 5 in einem geschlossenen Kreislauf erfolgreich funktioniert: Es erstellt ein Schaltkreisdesign, erhält Feedback und eine Punktzahl vom Bewertungsprogramm, und nutzt dieses Feedback, um seine nächste Anwendung zu verbessern – ohne menschliche Einflüsse zwischen den Runden (siehe Abbildung 1). Über acht computergestützte Primitiven – die grundlegenden Routinen, aus denen größere Quantenalgorithmen entstehen – für Chemie, Optimierung, Quantensimulation, Zahlentheorie und numerische Berechnungen entdeckte Claude neue Designs, bei denen sowohl weniger Qubits als auch weniger Gates verwendet wurden als bei den besten bisher veröffentlichten Algorithmen (Abbildung 2).
In jedem Fall resultierte die Verbesserung aus der Entdeckung neuer struktureller und mathematischer Erkenntnisse bezüglich des Problems, anstatt aus der Feinjustierung bestehender Designs. Beispielsweise bemerkte Claude bei der Erstellung eines Schaltkreises zur Simulation einer Eisen-Sulfid-Molekülstruktur, dass die Symmetrien und die wiederholte Struktur des Moleküls es ermöglichten, einige Ergebnisse einmal berechnet und dann wieder verwendet zu werden, anstatt sie für jeden Teil des Systems erneut zu berechnen. In anderen Fällen stellte es fest, dass die bestehenden Schaltkreise kostspielige Komponenten enthielten, die nur für äußerst seltene Eingaben benötigt wurden, und es überarbeitete sie ohne diese Komponenten.
Unterhalb beschreiben wir zwei von Claude entdeckte Erkenntnisse. Das erste ist eine neue Methode zur Durchführung der modularen Inversion – eine Art Rechenoperation, die der kostspieligste Schritt bei den Berechnungen mit Elliptikkurven ist. Das zweite Erkenntnis macht den kostspieligsten Schritt eines führenden Quanten-Optimierungssalters etwa 12-mal günstiger.
Diese Ergebnisse deuten darauf hin, dass künstliche Intelligenz nun dabei helfen kann, Quantenkreise neu zu gestalten – ein wichtiger Schritt, um Quantenalgorithmen schneller und einfacher zu betreiben. Eine schnellere Kreisgestaltung könnte es ermöglichen, die Probleme, die Quantencomputer lösen sollen – von der Entwicklung neuer Medikamente und besserer Batterien bis hin zu saubereren Methoden zur Herstellung von Dünger – früher in Angriff zu nehmen.
Ein neuer umkehrbarer Algorithmus
Das Entwerfen eines Quantenkreises beinhaltet zwei Einschränkungen, die normale Programmierung nicht hat. Die erste ist, dass ein Quantenkreis keine „if-then“-Entscheidungen wie eine normale Programmierung machen kann. Eine normale Programmierung kann einen Wert überprüfen und anschließend nur eines von zwei Codeabschnitten ausführen. Aber ein Quantencomputer arbeitet mit einer Superposition vieler Eingaben gleichzeitig – einige dieser Eingaben führen den ersten Code aus, während andere den zweiten Code ausführen. Deshalb muss der Schaltkreis jede Zeit die Operationen für beide Codes enthalten.
Das zweite ist, dass ein Quantenkreis keine Informationen verwerfen kann. Ein gewöhnlicher Programmierer kann seine Zwischenergebnisse nach Abschluss überschreiben oder löschen; in einem Quantencomputer können solche Zwischenergebnisse nicht einfach gelöscht werden, weil jeder Schritt eines Quantenkreises umkehrbar sein muss. Es ist auch keine Option, diese Informationen an ihrem Platz zu lassen, denn übrig gebliebene Zwischenergebnisse würden das endgültige Ergebnis verderben. Die einzige Möglichkeit, Informationen zu vernichten, ist, sie durch das Umkehren der Berechnung zu erzeugen, die sie hervorgebracht hat – bei den Kosten von zusätzlichen Gaten. Beide Einschränkungen machen Quantenkreise in Bezug auf den Laufzeit und die Anzahl der Qubits deutlich teurer als ihre klassischen Gegenstände.
Diese Einschränkung erfordert einen schwierigen Kompromiss zwischen Raum (d.h. Qubits) und Zeit. An einem Extrempunkt kann ein Quantenkreis die Zwischenergebnisse sofort berechnen, sobald sie verwendet wurden. Dadurch werden die Qubits frei, aber wenn diese Ergebnisse später wieder benötigt werden, muss der Kreis sie erneut berechnen – was Gate hinzufügt und die Laufzeit verlängert. An einem anderen Extrempunkt kann der Kreis die Zwischenergebnisse behalten, bis sie nicht mehr benötigt werden. Dadurch wird das Wiederholen von Arbeit vermieden, aber es kann viele mehr Qubits erfordern.
Das macht das Design von Quantenkreisen zu einem besonders interessanten Test für Clodes Fähigkeiten. Die Kreise können wie gewöhnlicher Code geschrieben werden, aber deren Verbesserung erfordert, dass das Modell unter einer Reihe von Einschränkungen denkt – ganz anders als bei normalem Programmieren.
Ein schwieriger erster Test: modulare Inversion
Die erste Aufgabe, die wir Claude gaben, war das Addition von Punkten – eine Regel zur Kombination von zwei Punkten auf einer mathematischen Kurve (einer Ellipsenkurve), um einen dritten Punkt zu erzeugen. Die Punktaddition ist der Kernschritt in Quantenalgoritmen für das diskrete Logarithmusproblem auf Ellipsenkurven: Gegeben ist ein Ausgangspunkt und das Ergebnis der Addition desselben mit sich selbst n Mal, es gilt n. Für große Kurven können gewöhnliche Computer dieses Problem nicht in einer angemessenen Zeit lösen, aber ein ausreichend großer Quantencomputer könnte es.
Diese Algorithmen führen die Punktaddition mehrmals durch, einschließlich in umgekehrter Form, und diese Additionen machen den größten Teil der Kosten für Qubits und die Laufzeit aus. Probleme wie diese – leicht zu berechnen, aber äußerst schwierig zu umkehren – gehörten zu den ersten, bei denen gezeigt wurde, dass Quantencomputer eine exponentielle Geschwindigkeitssteigerung gegenüber gewöhnlichen Computern bieten. Aus diesen Gründen ist die Punktaddition zu einem der Standard-Messzahlen in diesem Bereich geworden. Das machte sie zu einer anspruchsvollen Prüfung für Claude. Also haben wir es gebeten, herauszufinden, wie wenige Qubits sowie wie wenige Gate-Elemente für die Punktaddition tatsächlich benötigt werden.
Wir gaben Claude einen einseitigen Abriss. Er erklärte die mathematische Regel für die Addition von Punkten sowie wie der Auswerter jeden vorgeschlagenen Schaltkreis auf Richtigkeit prüft und ihn anhand der Anzahl der Qubits und der verwendeten Gatter bewertet. Zudem befahl er Claude, mehrere Ansätze gleichzeitig zu untersuchen. Nach 53 Stunden Arbeit mit minimaler menschlicher Einmischung (begrenzt auf den Anfangsbrief und gelegentliche Anweisungen zur breiteren Überlegung) kam Claude auf einen völlig neuen Ansatz für das Problem.
Die Speicheranforderungen von divsteps
Der Großteil der Kosten für das Hinzufügen von Punkten entsteht aus einem einzigen Schritt, dermodulare Inversion genannt wird. Die Arithmetik für Elliptikkurven verwendet Zahlen, die bei Erreichen eines festen Limits wieder zurückgehen. Die modulare Inversion ist die umgehende Version der Division: Gegeben ein ganzzahliges a, finden Sie x so dass ax ≡ 1 (mod p). Normale Computer können diese Operation effizient durch eine Methode ausführen, diedivsteps genannt wird. Divsteps beginnt mit einem Paar von Zahlen und vereinfacht sie wiederholt über viele Iterationsrunden. In jeder Runde untersucht divsteps das aktuelle Paar von Zahlen und wechselt, addiert, subtrahiert oder teilt sie je nach den Bedingungen. Unterwegs bewahrt es nur genügend Informationen, um am Ende den modularen Inversen zu erzeugen.
Trotz seines Erfolgs auf gewöhnlichen Computern hatte divsteps noch kein praktisches Quantenkreischen erstellt, aufgrund der oben beschriebenen Reversierbarkeitsbeschränkung. Die Aufzeichnung der in jeder Iteration gewählten Operationen wird als Branch-Information bezeichnet – es handelt sich dabei um eine Art „Kratzarbeit“, die ein traditionelles Programm einfach verwerfen kann. Im Gegensatz dazu muss ein Quantenkreischen diese Aufzeichnung behalten, damit die Berechnung rückwärts durchgeführt werden kann. Eine einfache Quantenversion von divsteps ist daher gezwungen, eine lange Historie an Branch-Informationen zu sammeln – was eine enorme Anzahl an zusätzlichen Qubits für die Speicherung erfordert.
Wie Claude das Gedächtnisproblem löste
Claude erkannte, dass dieser divsteps-Ansatz für Quantenkreise vielversprechend sein könnte, aber nur, wenn es eine Möglichkeit gab, die notwendige Speicherung des gesamten Verlaufs zu umgehen. Er hatte eine Idee: Vielleicht musste die Aufzeichnung überhaupt nicht gespeichert werden. Claude argumentierte, dass es möglich sein könnte, die Branch-Informationen direkt abzuleiten (oder „dekodieren“), indem man sorgfältig das Paar von Zahlen nach jeder Iteration untersucht. Im Grunde würden die Zahlen selbst die Aufzeichnung speichern. Der Kreisprozess könnte dann rückwärts ausgeführt werden, ohne dass weitere Qubits benötigt werden.
Um diese Idee zu testen, untersuchte Claude eine Reihe einfacher Kandidatregeln zur Durchführung der Dekodierung. Diese frühen Regeln funktionierten in kleineren Testfällen, aber sie scheiterten, als Claude sie bei der vollen Problemgröße auf 256-Bit-Zahlen testete.
Claude versuchte anschließend eine theoretischere Herangehensweise. Anstatt zu erraten und Regeln zu testen, versuchte er, mathematisch zu verstehen, warum divsteps sich so verhält. Er zeigte eine Reihe von Ergebnissen bezüglich des Iterationsprozesses auf, einschließlich mehrerer neuer algebraischer Identitäten. Aus diesen Identitäten ableitete Claude eine präzise Formel für die Decodierungsempfehlung, die die Branchinformationen aus den numerischen Paaren korrekt wiederherstellen konnte. Dann überprüfte er die Formel, erst durch großflächige numerische Simulierungen und anschließend durch die Formalisierung im Lean-Format. Nach der vollständigen Validierung erstellte Claude die erste umkehrbare Implementierung von divsteps ohne gespeicherten Branch-History.
Eine Familie von Designs
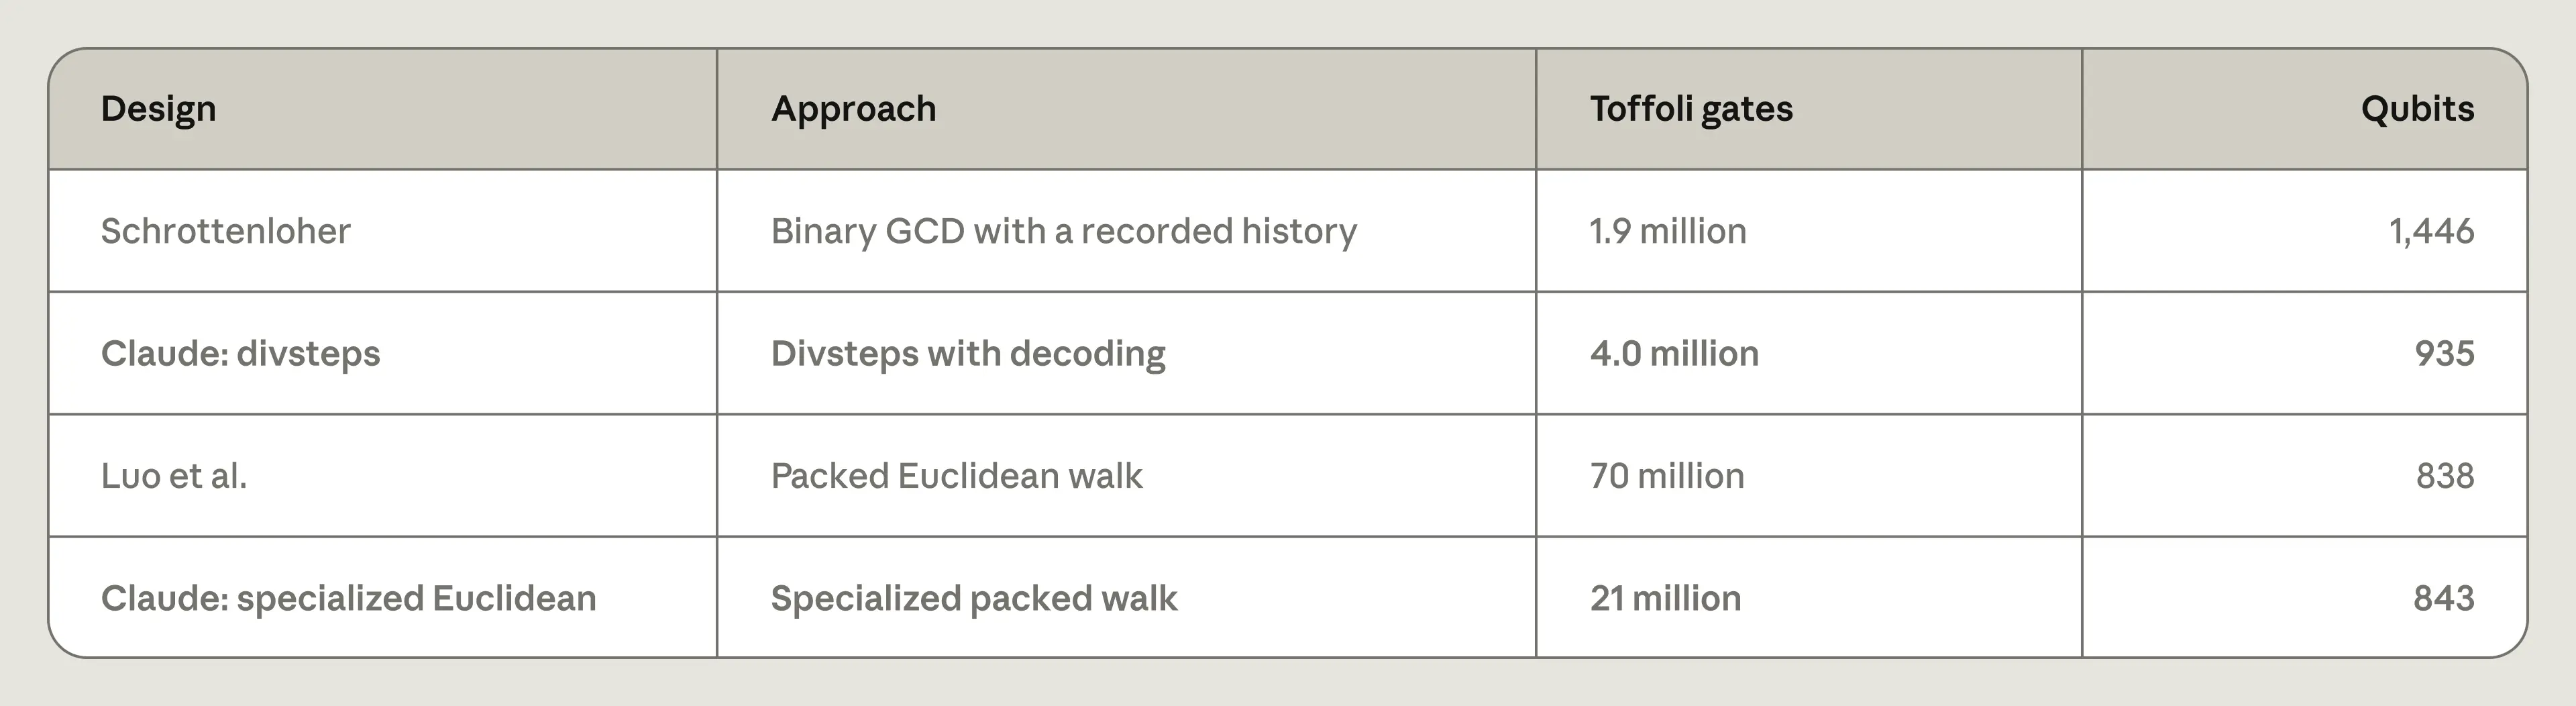
Die Dekodierung spart Qubits, aber es kostet Zeit. Deshalb suchte Claude nach Situationen, in denen es günstiger wäre, die Branch-Information zu speichern, als sie zu dekodieren. Durch Variation des Schwellwerts, bei dem der Kreis die Branch-Information speichert anstatt zu dekodieren, erstellte Claude eine neue Familie von Designs zwischen den beiden Extremen. Im Vergleich zum kleinsten vorherigen Design verwendet ein Kreis in der Familie 12% mehr Qubits, aber 17-mal weniger Gates. Im Allgemeinen erweitern die neuen Designs die Pareto-Grenze und bieten Kombinationen von Quantenspinnenanzahl und Laufzeit, die vorher nicht verfügbar waren (Tabelle 1).
Optimierung eines Quantenoptimators
Optimierungsprobleme stehen im Zentrum einer Vielzahl von Aufgaben, einschließlich Zeitplanung, Logistik und Materialdesign. Ein Optimierungsproblem stellt eine Reihe konkurrierender Einschränkungen dar und fordert die Lösung, die möglichst viele dieser Einschränkungen erfüllt. Viele Quantenalgorithmen wurden für solche Probleme vorgeschlagen, doch die meisten versprechen nur geringe oder unzuverlässige Vorteile im Vergleich zu gewöhnlichen Computern. Decoded Quantum Interferometry (DQI) ist einer der stärksten Kandidaten, der ein superpolynomiale Quantenbeschleunigung— einen Vorteil, der sich mit zunehmender Größe des Problems schnell vergrößert, anbietet.
Wenn ein Quantencomputer eine Berechnung beendet hat, liefert die Auslese seiner Qubits nur eine Antwort, die zufällig aus den Möglichkeiten gewählt wird, die sie in Superposition halten. DQI funktioniert dadurch, dass ein Quantenzustand vorbereitet wird, in dem die guten Lösungen wahrscheinlicher als die schlechten ausgegeben werden. Dazu wird ein FehlerkorrigierenderDecoder verwendet, der eine kurze Liste von „Fehlern“ aus einer kompakten Zusammenfassung wiederherstellt. Dies ist der teuerste Schritt im Algorithmus. Wenn wir also einen schnelleren Decoder entwickeln könnten, könnten wir auch die DQI-Verfahren schneller durchführen.
Ein effizienterer Quantendekoder
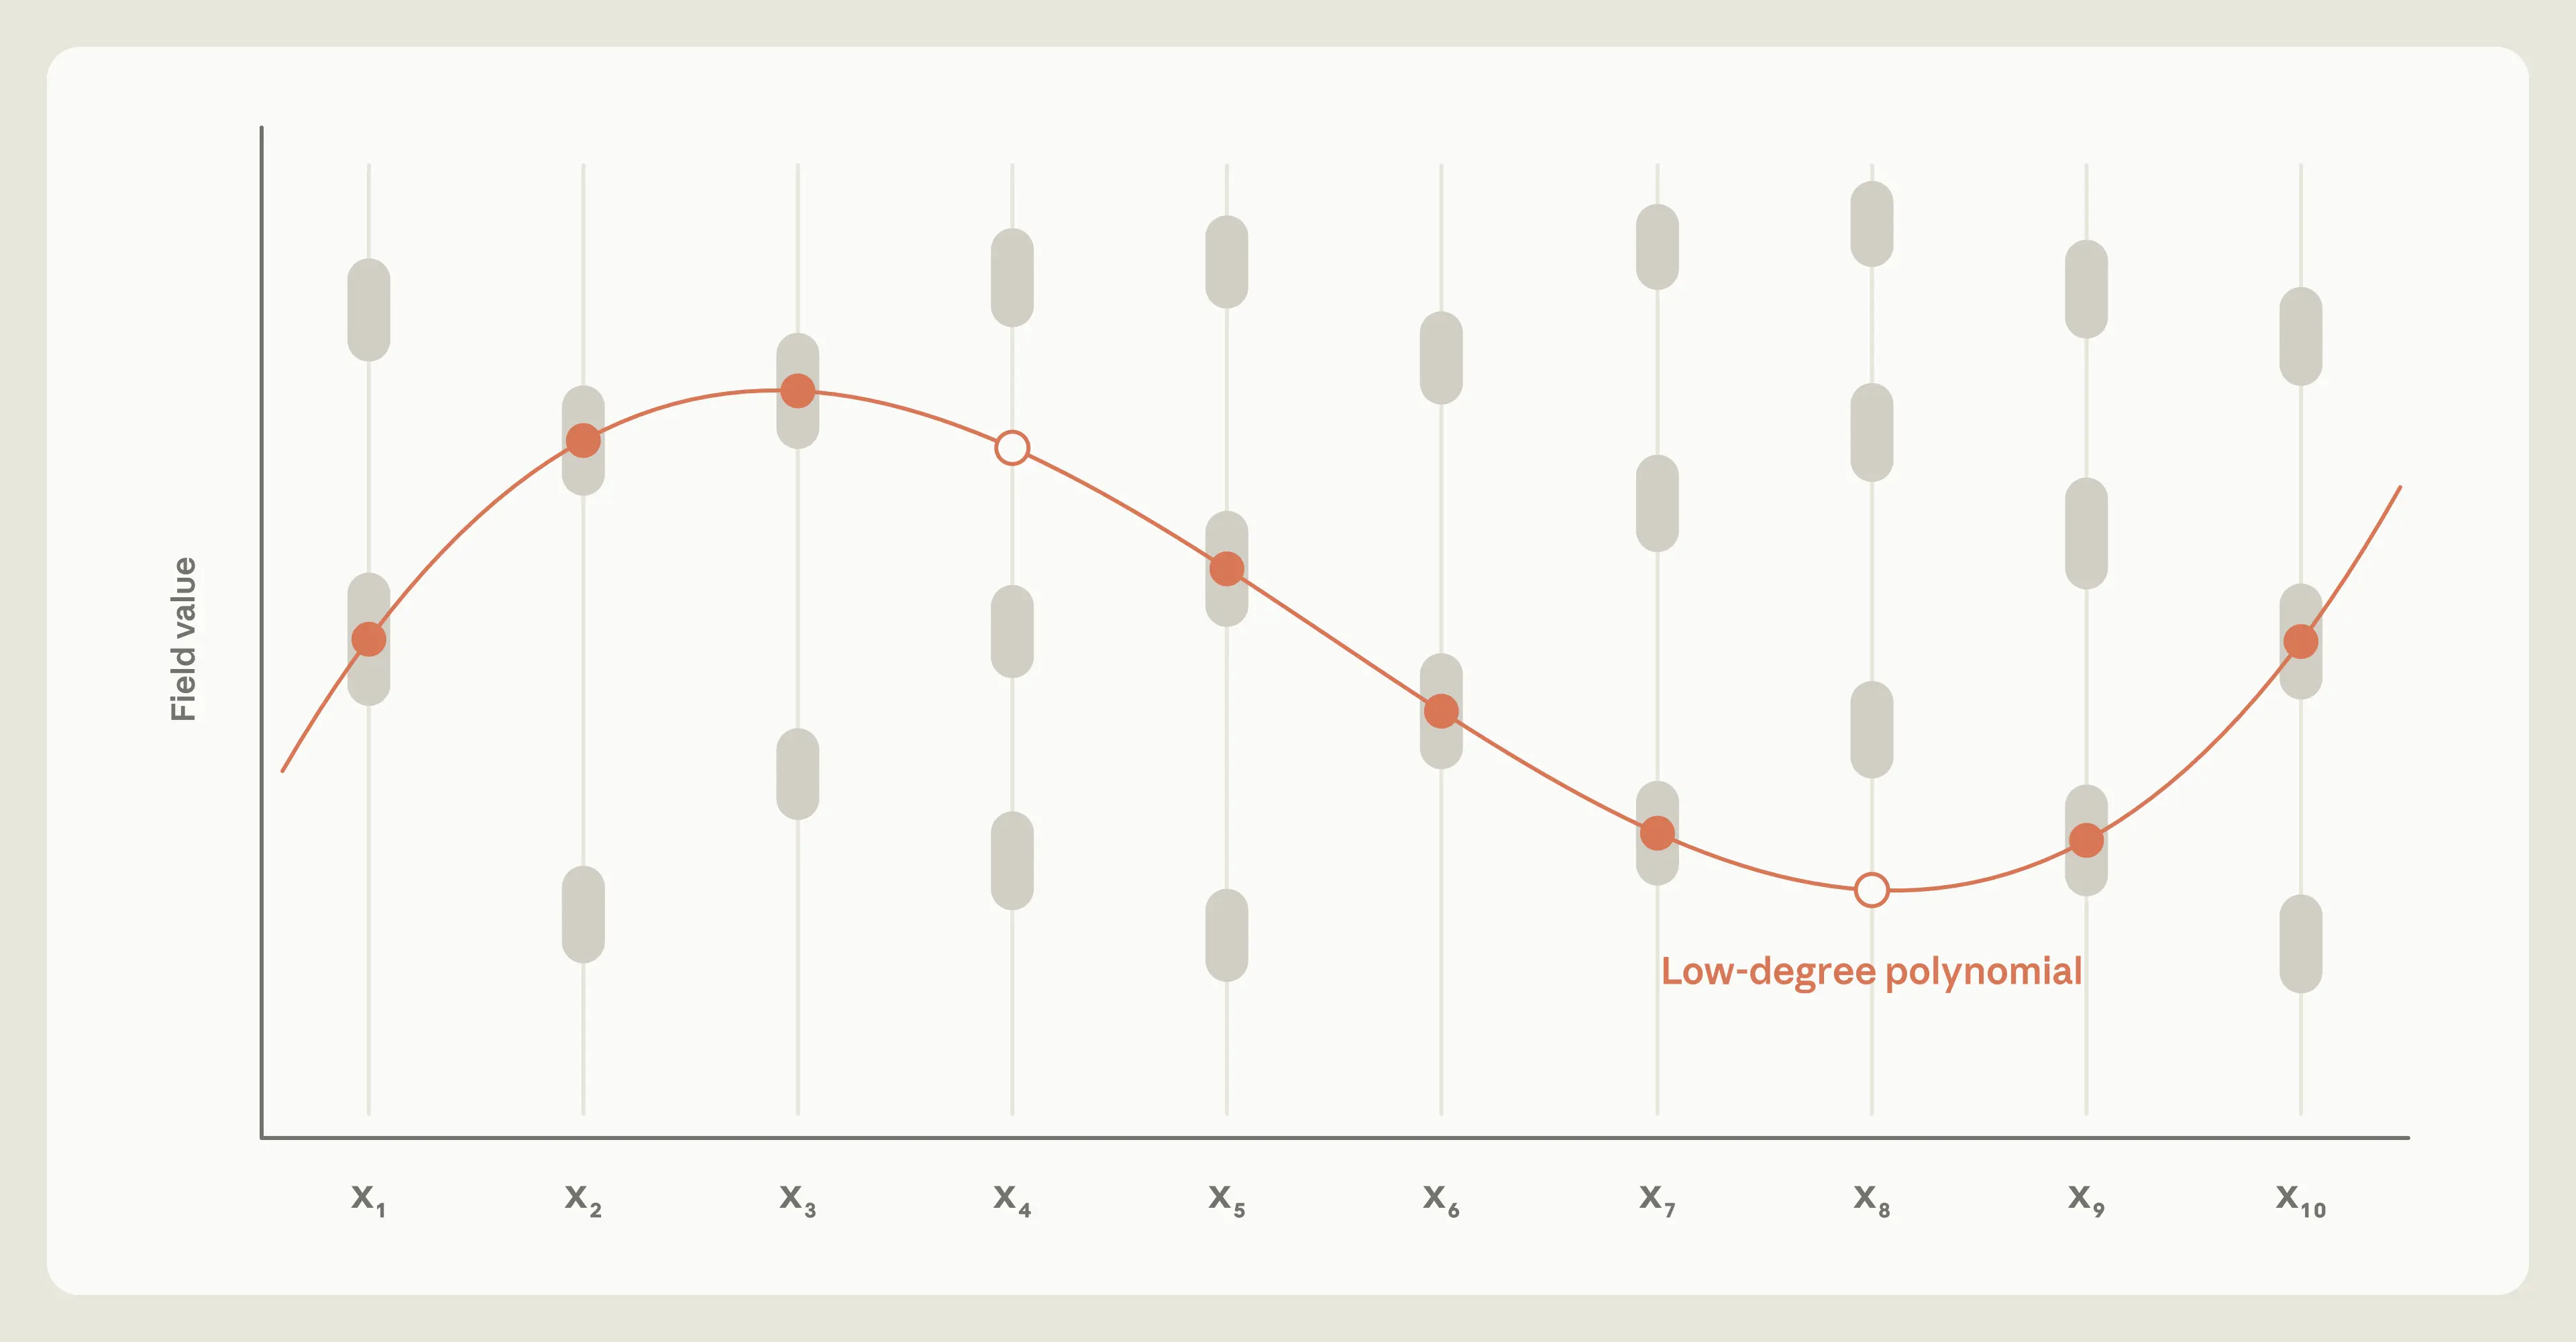
Die Forscher, die das DQI vorstellten, zeigten es an einem Problem namens optimal polynomial intersection (OPI), einer gridbasierten Version des Kurvenanpassens (Abbildung 3). Stellen Sie sich eine Grid dar, in der jede Position x mehrere akzeptable Werte für y enthält. Das Ziel ist es, eine einfache Kurve (ein Polynom niedriger Grad) zu finden, die durch so viele x-Positionen wie möglich durch ein akzeptables Quadrat geht. DQI löst dieses Optimierungsproblem mit einem bestimmten Art von Decoder, einem Reed–Solomon-Decoder.
Der Reed-Solomon-Dekodierung beginnt mit der kompakten Zusammenfassung der Fehler, die oben erwähnt wurden, und diese wird als Syndrom bezeichnet. Die Aufgabe des Decoders besteht darin, aus dieser Zusammenfassung herauszufinden, wo in den Daten die Fehler auftraten und was sie waren. Der vorherige fortschrittliche Quantenkreis verarbeitete diese Syndrome mit dem erweiterten Euklidischen Algorithmus – einer Abfolge von Divisionen und Wechseln, bei denen die Anzahl und Reihenfolge der Schritte von der jeweiligen Eingabe abhängen. Hier zeigen sich wieder die Einschränkungen von Quantenkreisen: Während ein gewöhnlicher Programmcode für jede Eingabe einen anderen Weg verfolgen kann, muss ein Quantenkreis, der gleichzeitig mit vielen Eingaben arbeitet, alle Eingaben mit einer einzigen festen Schleife von Schaltungen behandeln. Um dies zu bewältigen, musste das vorherige Design die Berechnung über viele mehr Iterationsrunden durchführen als für eine einzelne Eingabe erforderlich wäre, und jede Operation in jeder Runde ausführen – auch wenn dies unnötig war.
Die Verbesserung dieses Decoders könnte die Laufzeit von DQI erheblich verringern. Schätzungen von Forschern bei Google Quantum AI deuten darauf hin, dass die Lösung eines bestimmten OPI-Problems etwa drei Monate auf Frontier verletzen würde – einem der mächtigsten Supercomputer der Welt – im Vergleich zu etwa einer Stunde auf einem zukünftigen Quantencomputer, der DQI ausführt. Der Großteil dieser Stunde würde auf die Reed-Solomon-Dekodierung verwendet werden.
Also haben wir Claude gebeten, einen effizienteren Quantenkreis für die Decodierungsschritt zu entwerfen. Claude kam schnell zu dem Schluss, dass das erweiterte Euklidische Algorithmus nicht geeignet für einen Quantenkreis ist. Stattdessen organisierte er seinen Kreis um eine andere Decodierungstechnik, die als Berlekamp–Massey-Decodierung bekannt ist. Dabei wird jeder Symptom (Summe der Fehler) einzeln gelesen und nach und nach die einfachste Regel ermittelt, die jedes Nummer in der Liste auf der Grundlage der vorherigen Nummern vorhersagt. Sobald diese Regel gefunden wird, werden die Fehler aufgedeckt. Im Gegensatz zum erweiterten Euklidischen Algorithmus führt Berlekamp–Massey in jeder Runde denselben Schritt aus und durchläuft immer dieselbe Anzahl von Runden, was zur passenden einzigen festen Sequenz von Gaten eines Quantenkreises passt. Letztendlich bietet dies Claude eine viel effizientere Grundlage für die Entwicklung.
Eine vereinfachte Vorgehensweise für die Speicherung
Die Umstellung auf Berlekamp–Massey entfernte die Notwendigkeit, dass der Schaltkreis für verschiedene Eingaben unterschiedliche Wege nehmen muss. Doch die Reversibilität führte zu einer weiteren Herausforderung – diesmal aufgrund der oben besprochenen Unkompilierungsbeschränkung. In jeder Runde berechnet der Schaltkreis vorübergehende Werte, die er nur kurz benötigt, aber diese Informationen können nicht einfach gelöscht werden: Um sie später wieder zu kompilieren zu können, muss der Schaltkreis in der Lage sein, diese Informationen wiederherzustellen.
Die Speicherung dieser Informationen wäre zu teuer gewesen. Deshalb verwendete Claude denselben Ansatz wie bei divsteps: Er fand einen Weg, den größten Teil dieser Informationen aus dem aktuellen Zustand des Circuits wiederherzustellen, sodass sie nicht gespeichert werden mussten. Allerdings konnten einige außergewöhnliche Werte auf diese Weise nicht rekonstruiert werden und mussten gespeichert werden.
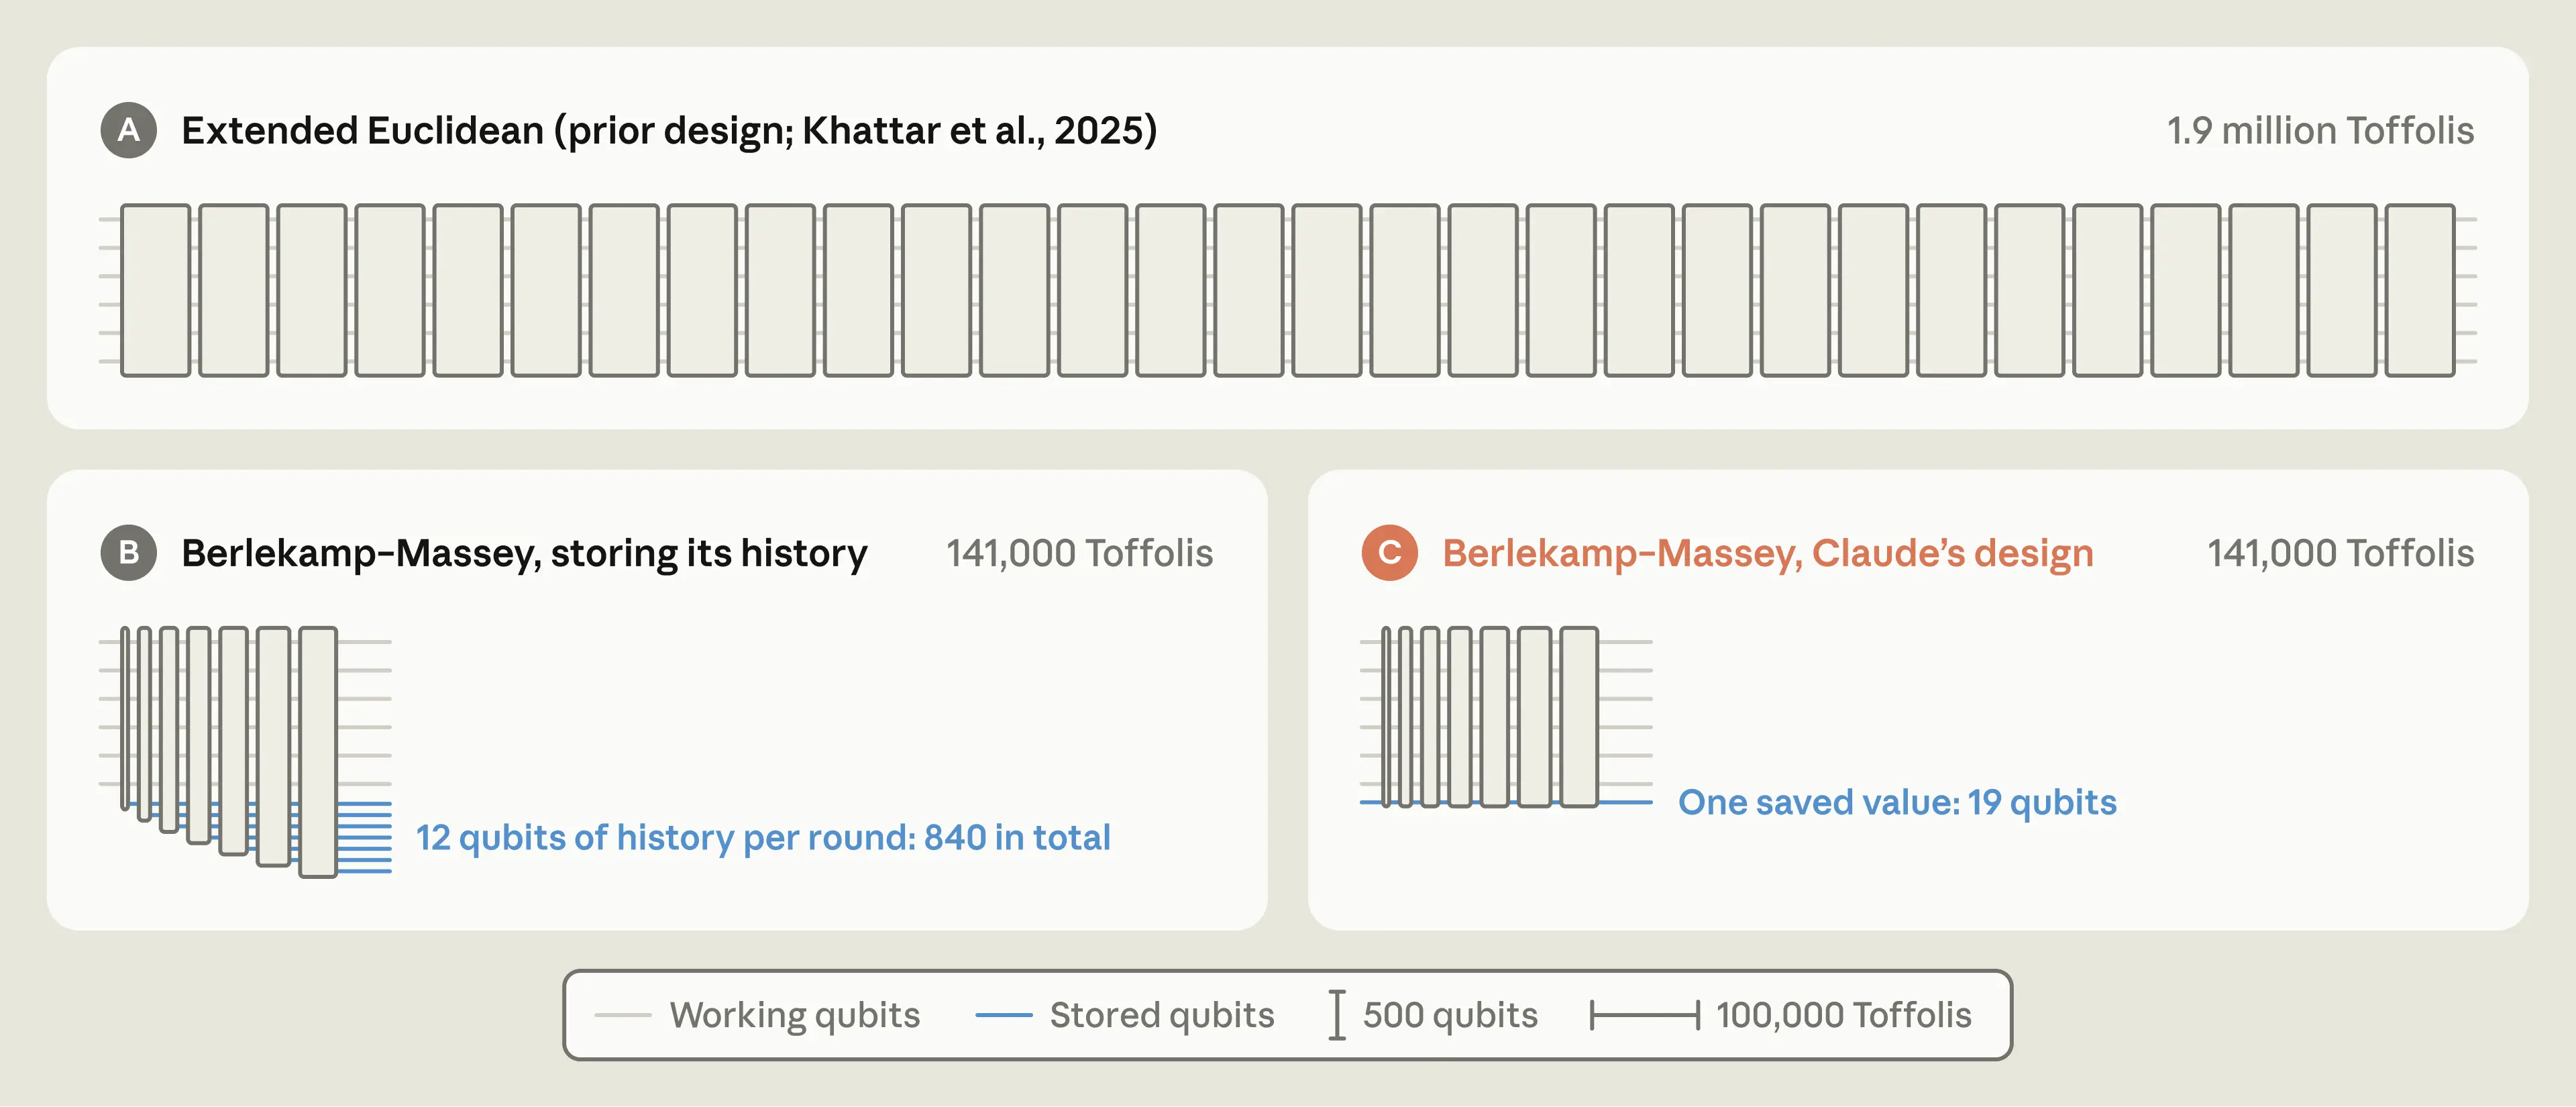
Um ausreichend Speicher für den schlimmsten Fall bereitzustellen, bei dem eine außergewöhnliche Werte in 35 verschiedenen Runden auftritt, würden 665 Qubits benötigt. Stattdessen entwickelte Claude einen Hochgeschwindigkeitssimulator und führte 403 Millionen Beispieldekodierungen durch, um zu messen, wie oft diese Ausnahmen tatsächlich auftraten. Fast jede Durchführung erforderte höchstens die Speicherung eines einzigen Wertes. Somit bereitet Clodes Schaltkreis Platz nur für einen gespeicherten Wert – also 19 Qubits. Etwa ein Lauf von 10.000 erfordert mehr als das und führt zu einem Fehler, was innerhalb des Fehlerrates, der für die Aufgabe vorgesehen ist, liegt. Diese Verbesserungen ersetzten große, schlechteste-Szenario-Reserven durch eine kleine, feste Anzahl von Qubits und Gates (Abbildung 4).
Gemeinsam reduzierten diese Optimierungen die Anzahl der Gate im Decoder um einen Faktor von 12 im Vergleich zur vorherigen Konstruktion von Google. Die Verbesserung resultierte aus einer Neugestaltung der Berechnung auf drei Ebenen: einer anderen Methode (ersetzung des erweiterten Euklidischen Algorithmus durch Berlekamp–Massey-Decodierung), einer anderen Schaltkreisarchitektur (Rekonstruktion von vorübergehenden Werten anstatt deren Speicherung) und einem anderen Ressourcenbudget (genaue Messung der tatsächlich benötigten Speicher- und Berechnungskapazität des Schaltkreises). Keine einzelne Änderung wäre allein ausreichend gewesen, aber zusammen macht die teuerste Schritt der DQI nur etwas über einen Ordnungsgrad günstiger.
Was wir gelernt haben
Wissenschaftlicher Fortschritt entsteht oft durch die Praktizierung theoretischer Ideen. Eine der Hauptwege dazu ist es, einen einst als unpraktisch angesehenen Prozess so schnell und kostengünstig wie möglich umzusetzen. Die Entwicklung von Quantenkreisen ist ein hervorragendes Beispiel: Der 150.000-fache Rückgang in der FeMoco-Schätzung dauerte mehrere Forschungsgruppen acht Jahre, wobei jeder Schritt typischerweise Monate an Arbeit umfasste. Im Gegensatz dazu war Claudes elliptische-Kurven-Design das Ergebnis einer einzigen 53-stündigen Ausführung.
Unsere Ergebnisse deuten darauf hin, dass KI die Arbeit am Schaltkreisdesign unterstützen kann, wodurch Implementierungen entstehen, die nützliche Quantenberechnungen näher an die Fähigkeiten des echten Hardware bringen. Wenn KI diese Arbeit beschleunigen kann, könnte nützlicher Quantencomputing früher verfügbar werden.
Trotz der ermutigenden Leistung von Claude bei diesen Aufgaben bemerkten wir auch einige Einschränkungen. In unseren frühen Experimenten war Claude von Natur aus vorsichtig. Er zweifelte immer wieder an scheinbaren Verbesserungen und überprüfte manchmal weiterhin die Ergebnisse, die bereits gut unterstützt waren, doppelt und sogar dreifach. Diese Vorsicht war manchmal wertvoll: zum Beispiel veranlasste sie Claude, Lean-Beweise zu schreiben, um sein divsteps-Design zu überprüfen. Aber es zeigte sich auch in der Tendenz, etablierte, bekannte Ansätze gegenüber neueren Ansätzen zu bevorzugen.
Wir haben zwei Maßnahmen ergriffen, um dies zu vermeiden. Erstens erforderte unsere Setup, dass Claude mehrere qualitativ unterschiedliche Ansätze vorschlug und diese gleichzeitig entwickelte. Zweitens forderten wir gelegentlich Claude auf, seine Suche auszuweiten. Diese Eingriffe führten dazu, dass Claude ehrgeizigere Ideen verfolgte. Das Ergebnis der Ellipsenkurve kam beispielsweise nicht von der Entfernung von Toren aus einem vorhandenen Design hervor, sondern von der Erforschung einer Methode zur umkehrbaren modularen Inversion, die zuvor nicht möglich war, und anschließend von der Herleitung der mathematischen Ergebnisse, die für die Praxis notwendig waren. Sobald die Idee entwickelt war, entwickelte Claude den Ansatz, implementierte ihn und überprüfte seine Richtigkeit selbstständig.
Der Schaltkreisdesign ist nur ein Teil der Entwicklung eines nützlichen Quantencomputers. Da Qubits so zerbrechlich sind, muss das Gerät auch seine eigenen Fehler erkennen und beheben, während es läuft. Dies hängt von vielen anderen Komponenten ab, darunter Code zur Fehlerkorrektur, schnelle Dekoder und die Steuerung des Hardware selbst. Diese Komponenten beeinflussen sich gegenseitig, aber um die Komplexität zu bewältigen, werden sie meist separat entwickelt. Viele von ihnen teilen die Eigenschaften, die das Schaltungsdesign für Claude besonders geeignet machen: Ein Design kann als Code geschrieben werden, überprüft auf Richtigkeit und nach seinem Kostenaufwand bewertet werden.
Dies eröffnet eine faszinierende Möglichkeit. Anstatt jeden Komponenten einzeln zu entwerfen, könnte die KI alle Komponenten gemeinsam optimieren – vom Algorithmus bis zum Hardware-Design – um einen vollständig fehlerkorrigierten Quantencomputer zu erstellen, der auf ein bestimmtes Problem zugeschnitten ist. Solche Konstruktionen könnten auch den Herstellern von Hardware erkennen, welche Fähigkeiten für eine bestimmte Anwendung am wichtigsten sind. Dadurch könnten Probleme wie die Entwicklung Katalysatoren oder das Verständnis neuer Materialien in den Zuständigkeitsbereich der ersten fehlertoleranten Maschinen rücken.
Danksagungen
Wir danken Arjun Kar und Vinay Ramasesh für die hilfreichen Diskussionen in den frühen Phasen des Projekts.
Fußnoten
- Beide Schätzungen beziehen sich auf das gleiche 54-orbitalmodell von FeMoco, wie in der Tabelle von Low et al., „Fast quantum simulation of electronic structure by spectrum amplification“ (2025), Tabelle 1, aufgeführt wird. Die Schätzung aus dem Jahr 2017 stammt von Reiher et al.. Zwischenschätzungen für das gleiche Modell stammen von Berry et al. (2019), von Burg et al. (2021), Lee et al. (2021) und Rocca et al. (2024).
Verwandte Inhalte
Künstliche Intelligenz-Modelle könnten in der Lage sein, sich selbst zu replizieren, ohne Zugang zu einem Datacenter
Unsere Experimente zeigen, dass kleine KI-Modelle in wenigen Monaten in der Lage sein könnten, sich selbst auf kommerziellen IoT-Geräten wie Android-Fernsehern und Smart-Kochplatten zu replizieren.
Mehr lesenStärkung unserer Verteidigungsmaßnahmen gegen Destillation-Angriffe
Die illegale Destillation ermöglicht es Entwicklern von Modellen, die fortschrittlichen AI-Fähigkeiten zu kopieren, ohne entsprechend robusten Schutzmechanismen zu schaffen. Hier beschreiben wir, wie wir den Destillationsrate um mehr als 90% reduziert haben.
Mehr lesenUnbeabsichtigte Modelverhalten bei unseren Evaluierungen und internen Nutzung untersuchen
Dieser Bericht beschreibt Beispiele für unbeabsichtigte Modellverhalten, die wir während der Evaluierungen und im internen Einsatz von Claude beobachtet haben.
Lesen Sie mehrAbonnieren Sie Anthropic Science
Funktionen für künstlerische Entdeckungen mit AI-Unterstützung, praktische Arbeitsabläufe und Feldnotizen in allen Wissenschaften.