
Frontier-KI-Systeme haben das Potenzial, die biologische Forschung und die Arzneimittelforschung zu transformieren, indem sie intelligently durch riesige kombinatorische Suchräume navigieren (z. B. umfasst ein einzelnes Protein mit 100 Aminosäuren mindestens 20100 mögliche Sequenzen), was eine dynamische Mehrkandidaten-Exploration erfordert. Unsere langfristige Forschungsvision ist, dass KI-Agenten nicht nur Ideen generieren und analysieren, sondern auch Laborexperimente durchführen, um ihre Hypothesen zu testen, aus den Ergebnissen zu lernen und sich selbst zu verbessern, um komplexe Probleme zu lösen — alles angetrieben durch menschliche wissenschaftliche Handlungsfähigkeit.
Die Verwirklichung dieser Vision erfordert die Lösung zweier miteinander verflochtener Herausforderungen: Erstens reasoning Frontier-Modelle noch nicht zuverlässig über 3-dimensionale Geometrie und physikalische Zustände — was ein Problem bei der Automatisierung der spezialisierten Flüssigkeitshandhabungsroboter darstellt, die Reagenzien bewegen, Volumina verfolgen und molekularbiologische Protokolle in einem Wet Lab ausführen. Zweitens, während agentische Hypothesengenerierung und in-silico -Design rasant voranschreiten und wiederholte Zyklen realer Rückmeldung benötigen, um die Vorschläge zu validieren und riesige Suchräume zu durchqueren, sind reale Wet-Lab-Experimente nicht Schritt gehalten, sodass experimentelle Ausleseergebnisse mehr denn je zum Engpass werden.
In diesem Beitrag stellen wir drei Forschungsprojekte vor, die unsere Fortschritte bei der Überbrückung der Kluft zwischen in-silico-KI-Exploration und realer Wet-Lab-Experimentation hervorheben:
- Ermöglichung sicherer, ressourceneffizienter Experimentation für KI-Agenten, verankert in physikalischen Messungen, durch Verwendung des VERID-Frameworks.
- Demonstration geschlossener, agentischer wissenschaftlicher Entdeckungen an unseren Prototypen für Aptamer- und De-novo-Proteindesign.
Agenten in der physikalischen Realität verankern
Zuerst präsentieren wir das VERified Infrastructure for Discovery Laboratories (VERID)-Framework, um die Kluft zwischen dem hochrangigen Reasoning von KI-Agenten und der komplexen, fehleranfälligen physikalischen Realität eines Wet Labs zu überbrücken. Es ist ein semantischer digitaler Zwilling des Laborarbeitsbereichs, d. h. ein live-Zustandsbehafteter 3D-volumetrischer Entitätsbaum, der alles verfolgt, von der Geometrie des Roboterarms bis zu einzelnen Kuvettenvolumina, Reagenzidentitäten und Pipettenspitzenbeständen.
Die Sicherheit eines Befehls hängt vom live-physikalischen Kontext sowie vom Code ab. Ein Agent kann syntaktisch gültigen Code generieren, der physikalisch unmöglich ist (z. B. das Absenken einer 8-Kanal-Pipette in eine zu schmale Rinne), logistisch ungültig ist (z. B. das Ansaugen aus einer erschöpften Kuvette) oder wissenschaftlich durch nicht modellierte Fluidik-Effekte beeinträchtigt ist.
Durch VERID plant, simuliert und führt ein KI-Agent Flüssigkeitshandhabungsprotokolle auf einem Flüssigkeitshandhabungsroboter aus und kombiniert synchronisierte Mehrkameraansichten mit live-Zustandsverfolgung, um Experimente über Zyklen hinweg zu verfeinern.
Aufbauend auf dem Open-Source- PyLabRobot frameworkbietet VERID vier Kernfunktionen:
- Live 3D-Zustandsverfolgung: Ermöglicht Agenten, das Deck-Layout, Kuvettenvolumina und verfügbare Spitzen zu prüfen, bevor sie handeln.
- Schnelle virtuelle Trockenläufe: Simulieren Protokolle in Sekunden, um Kollisionen oder leere Kuvetten zu erkennen, bevor Reagenzien angefasst werden.
- Hardware-Sicherheitsprüfungen: Blockieren ungültige Befehle, bevor sie den Roboter erreichen.
- Synchronisierte Video- und Aktionsprotokolle: Erfassen eine vollständige Aufzeichnung jedes Laufs für Forschungsrigor, Reproduzierbarkeit und Fehlersuche.
In unserem Berichtzeigen wir diese Funktionen in Aktion anhand von Fallstudien. Zuerst entdeckten synchronisierte Videos und Ausführungsspuren eine ungleichmäßige Farbstoffschiebung, die durch zu nahes Dispensieren am Kuvettenboden verursacht wurde, sodass der Agent seine Mischstrategie verfeinern konnte. In derselben Kampagne ermöglichte der persistente digitale Zwilling state erlaubte dem Agenten, mitten im Lauf eine Störung des Plattenlesers ohne erneutes Pipettieren zu überstehen. Zweitens: Als der Simulator eine 8-Kanal-Aspiration zurückwies, die physikalisch nicht in einen schmalen Trog gepasst hätte, plante der Agent auf der Stelle um und entwarf eine gezielte faktorielle Diagnostik, die eine subtile Verzerrung isolierte, die durch Restübertrag an der Spitzenwand verursacht wurde und die bloße Replikation übersehen hätte. Schließlich entwarf und führte ein Agent in einer Closed-Loop-Self-Play-Kampagne iterativ Robot experimente durch, um geblendete Farbstoffmischungen aus Aufsichtskamerabildern zu rekonstruieren, wobei er seine eigenen optischen und fluidischen Artefakte über mehrere Läufe hinweg identifizierte, um die Genauigkeit um mehr als das Fünffache zu verbessern.
Reproduzierbare Ausführung und vollständige Trace-Protokolle – mit prozeduralen Variablen wie Verweilzeiten, Verdunstung und Plattenlayout – legen den Grundstein dafür, dass Agenten letztlich in der Lage sein werden, biologische Signale vom experimentellen Rauschen zu trennen, während sie viele Kandidaten parallel über mehrere Runden hinweg erkunden und verfeinern.
Lernen zu lernen mit Aptameren
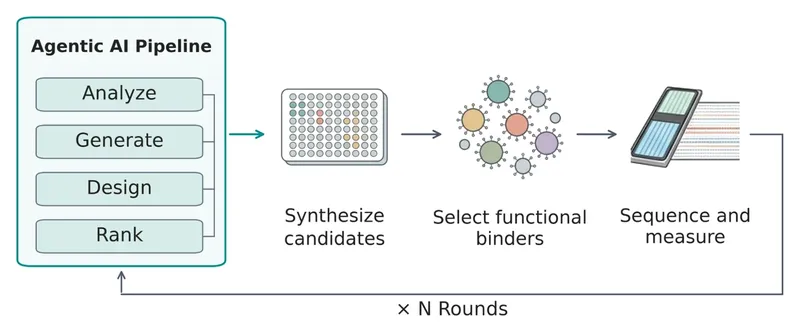
Agenten brauchen echte experimentelle Messwerte, um ihre Hypothesen zu verfeinern, da computerbasierte Modelle nicht das vollständige Bild dessen erfassen, was in einer Reaktion im Nasslabor geschieht, und keine empirische Validierung ersetzen können. In “Aptamers as a sandbox for lab-in-the-loop agentic molecular discovery” verwenden wir proteïnbindende DNA- Aptamere um das Labor in einer geschlossenen Schleife mit KI-Agenten über 3 Design-Test-Iterationszyklen hinweg zu prototypisieren. Die Aptamer-Entdeckung ist eine Art von Experiment, das in Forschungsbemühungen zur klinischen Biomarker-Entdeckung häufig vorkommt. Ein vollständiger Aptamer-Design-Test-Analyse-Zyklus dauert nur 7–10 Tage, da DNA chemisch in gepoolten Bibliotheken synthetisiert und direkt durch Sequenzierung ausgelesen werden kann. In jeder Runde entwerfen die Agenten Kandidatensequenzen, die gegen Zielproteine an Magnetperlen gescreent werden, um funktionale Binder zu isolieren, und anschließend sequenziert, um umfangreiche quantitative Daten für den nächsten Zyklus zurückzuliefern.
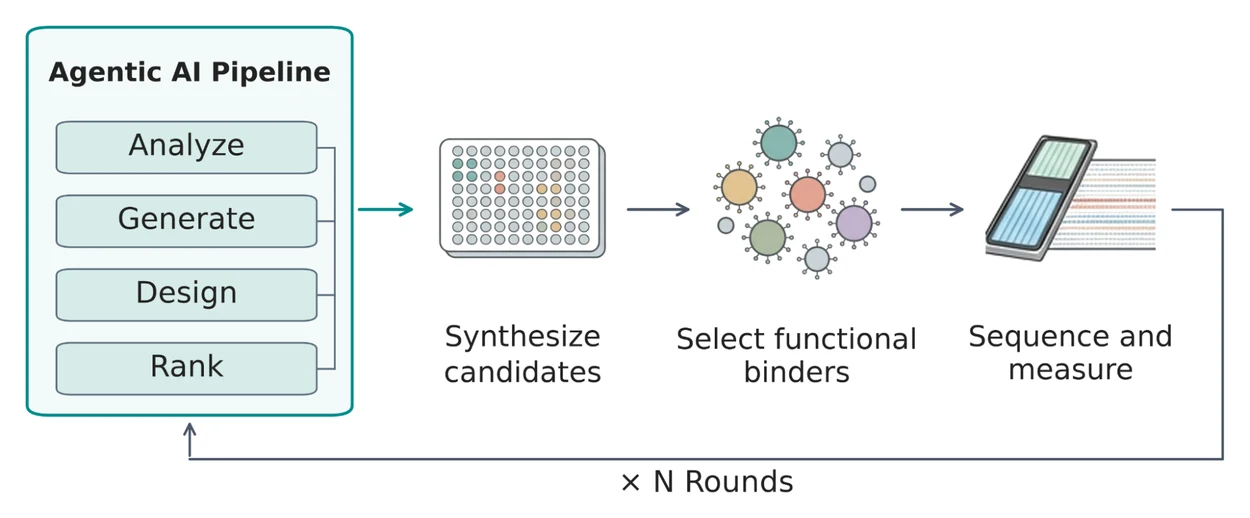
Agenten entwerfen, synthetisieren, selektieren und sequenzieren Aptamere iterativ in einer geschlossenen Schleife.
Über drei Runden hinweg an zwei Proteinzielen mit unterschiedlichen Schwierigkeitsgraden (Myoglobin und α-Thrombin) erhöhte die KI-gestützte rationale und de-novo-Konstruktion die bestätigten On-Target-Trefferquoten, wie im Bild unten zu sehen (auf 33.5% bzw. 42.1% für Myoglobin und α-Thrombin), wobei jedes Ziel die Identifizierung und Überwindung eines anderen Fehlermodus im Nasslabor erforderte.
Bei α-Thrombin lieferte Runde 1 0% Binder, weil feste Primer-Überhänge bei 48% der Sequenzen die Faltung störten; sobald die Agenten in Runde 2 geklemmte flankierende Stämme einführten und in Runde 3 diversifizierten, stiegen die Trefferquoten auf 26.0% und dann auf 42.1% bei 98.5% Spezifität.
Bei Myoglobin reicherten die Agenten, da sie in Runde 2 primär die rohe Bindungsaffinität priorisierten, stark G-Quadruplex- Motife an (63% der Designs). Während der rohe Pull-down zunahm, zeigten die Nasslabor-Daten, dass die meisten dieser G-Quadruplexe unspezifische „klebrige“ Binder waren, die an Off-Target-Proteine und blanke Magnetperlen hafteten, wodurch sowohl die Zielspezifität (von 75.0% auf 19.1%) als auch die wahre, perlenkorrigierte Trefferquote (von 10.2% auf 3.7%) einbrachen. Nachdem sie dieses Artefakt aus dem Readout von Runde 2 erkannt hatten, überarbeiteten die Agenten autonom ihre Designregeln für Runde 3, kappten promiske Motife, subtrahierten Perlenbinder und wechselten zu nicht-G4-strukturellen Gerüsten, um die Spezifität (72.4%) wiederherzustellen und die On-Target-Trefferquote neunfach zu steigern (33.5%).
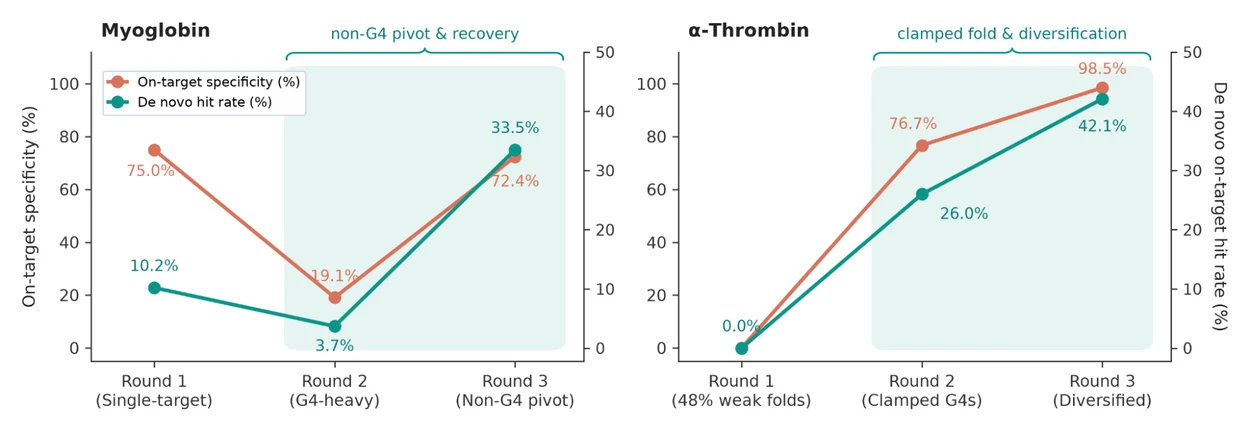
Über drei Runden hinweg lernen die Agenten aus Nasslabor-Readouts, die Zielspezifität wiederherzustellen und die bestätigten de-novo-Trefferquoten bei Myoglobin (links) und α-Thrombin (rechts).
In der Arbeit untersuchen wir auch, wie Agenten wie Wissenschaftler argumentieren, Daten analysieren und Anpassungen an Nasslabor-Protokolle vorschlagen, manchmal aber auch atypisch denken und Sequenzräume erkunden, die Strukturbiologen möglicherweise nicht in Betracht ziehen.
Accelerating de novo protein binder design
Das Schließen der Schleife für Proteine ist komplexer. Anders als chemisch synthetisierte Aptamere müssen Proteine biologisch exprimiert werden, sodass jede Schleife zusätzliche Schritte für zelluläre oder zellfreie Selektion, Expression und Faltung erfordert. Zusammen mit einem größeren Sequenzraum entstehen dadurch Engpässe sowohl auf der computergestützten als auch auf der Nasslabor-Seite.
In “Agent-guided epitope excision enables economical de novo binder design” haben wir unseren Workflow auf fibroblast activation protein alpha (FAP)angewendet, einen großen, anspruchsvollen Rezeptor, der in soliden Tumoren überexprimiert wird. In nur wenigen Experimentalläufen lieferten die besten Designs Binder mit einstelliger nanomolarer Affinität, ein Grad an enger, medikamentenähnlicher Bindung, der typischerweise erst nach umfangreichen Optimierungsrunden im Labor erreicht wird.
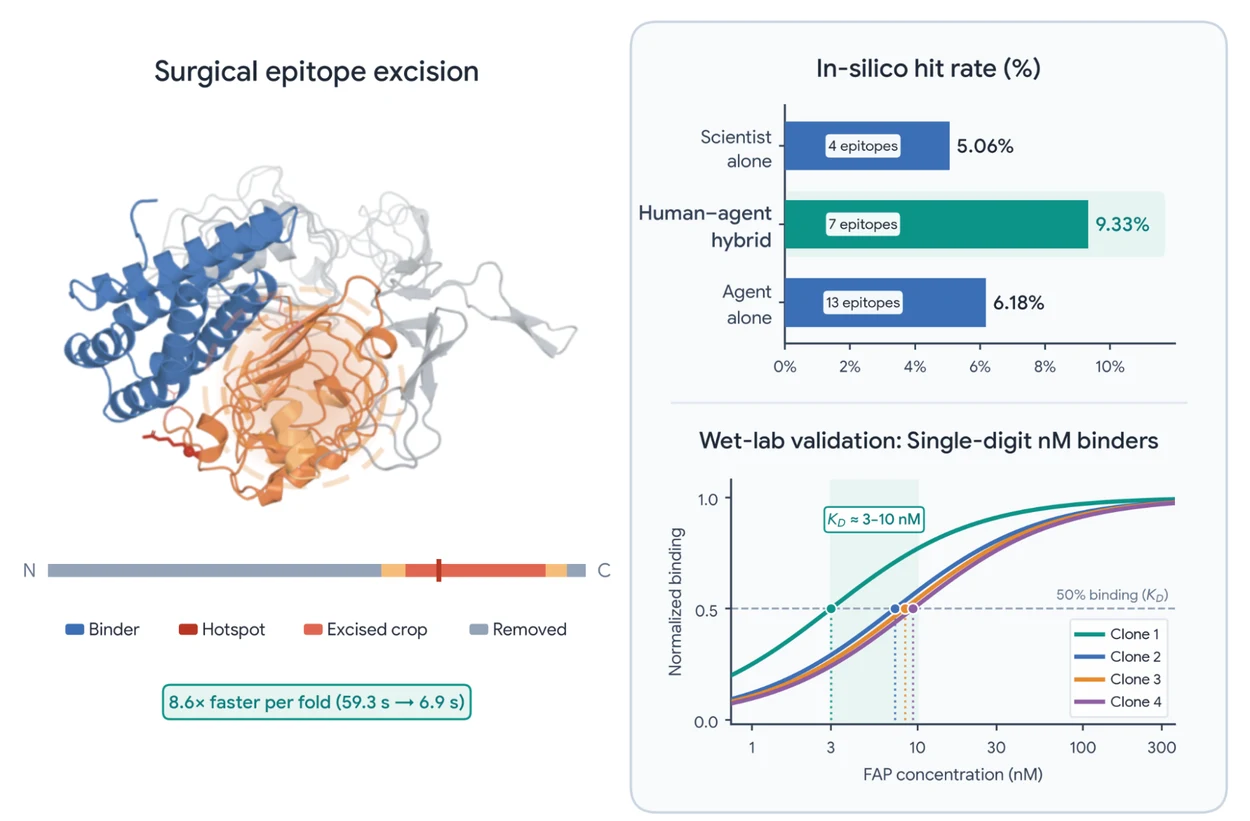
Die chirurgische Epitop-Exzision beschleunigt die Strukturvorhersage um das 8.6-fache (links), ermöglicht eine Mensch-Agent-Hybrid-Pipeline, die In-silico-Trefferquote nahezu zu verdoppeln (oben rechts), und führt zur Entdeckung von FAP-Bindern mit einstelliger nanomolarer Affinität im Nasslabor (unten rechts).
Rechnerisch erfordert de-novo-Binderdesign die Generierung von Kandidaten-Rückgraten, den Entwurf von Sequenzen, die zu ihnen passen, und das erneute Falten der resultierenden Komplexe, um die Bindung vorherzusagen. Dieser letzte Refolding-Schritt verbraucht den weitaus größten Teil der GPU-Rechenleistung, da er quadratisch mit der Ziellänge skaliert. Durch die chirurgische Entfernung nur der lokalen Bindungstasche während des Faltens beschleunigte unsere Pipeline jeden Zyklus um mehr als das Achtfache, ohne an struktureller Genauigkeit zu verlieren. Dies macht Entscheidungen darüber, wo gebunden werden soll und wie viel umgebende Struktur einbezogen werden soll, zu taktischen Hebeln, deren Optimierung LLM-Agenten bestens gewachsen sind.
In einem direkten Vergleich bei gleicher Rechenleistung verdoppelte die Zusammenarbeit zwischen Mensch und Agent – bei der ein Wissenschaftler die übergeordnete Strategie festlegt und ein Agent die taktische Umsetzung steuert – fast die In-silico-Trefferquote eines allein arbeitenden Wissenschaftlers und fand zugleich Treffer über ein viel breiteres Spektrum an Zielstellen. Um das Screening in Nasslaboren neben unserer rechnerischen Pipeline zu skalieren, haben wir das Yeast Surface Display mit fluoreszenzaktivierter Zellsortierung (FACS) operationalisiert, einem Arbeitsablauf, der es uns ermöglicht, große Bibliotheken konstruierter Proteinvarianten parallel anhand der Fluoreszenz zu durchmustern.
Unser nächster Schritt ist es, diese Fäden zusammenzuführen, indem wir VERIDs vollständig nachvollziehbare Automatisierung mit Closed-Loop-Lernen für die Proteinentdeckung kombinieren, damit Agenten komplexe, unebene biologische Suchräume direkt im Nasslabor navigieren können.
Sicherheit
In Übereinstimmung mit Googles Frontier Safety Framework und unserem Ansatz zur Bioresilienzbauen wir Schutzmaßnahmen sowohl auf der rechnerischen als auch auf der Nasslabor-Seite unserer Workflows ein:
- Sichere Testumgebungen und Screening: Wir haben bewusst gut kontrollierte, nicht infektiöse biologische Systeme ohne Gain-of-Function-Risiko als Testumgebungen ausgewählt, um das Verhalten von Agenten zu evaluieren und Abweichungen frühzeitig zu erkennen. Jede entworfene Sequenz durchläuft ein Biosecurity-Screening.
- Simulation vor der Ausführung: Über VERID senden Agenten niemals unverifizierten Code direkt an die Flüssigkeits-handhabungsroboter. Jedes Protokoll wird in einer Simulation als Trockenlauf getestet und gegen den digitalen Zwilling validiert, bevor es Reagenzien berührt.
- Menschliche Aufsicht: Menschen autorisieren und überprüfen entworfene Sequenzen direkt, verifizieren Nasslabor-Protokolle und überwachen Roboterläufe.
Da KI-Agenten mehr und mehr des Design-Test-Zyklus übernehmen, entstehen neue Herausforderungen in Bezug auf Sicherheit und Zuverlässigkeit. Der Weg zu einem autonomen Nasslabor erfordert die Lösung dieser offenen Probleme mit Möglichkeiten für menschliche Handlungsfähigkeit und Aufsicht: sicherzustellen, dass Agenten auf die tatsächliche Zielbindung statt auf unbeabsichtigte experimentelle Abkürzungen optimieren, mehrstufige Nasslabor-Protokolle verifizieren und die Denk- und Ausführungsprotokolle der Agenten kontinuierlich überwachen.
Von der Verankerung von Agenten in der physischen Laborrobotik über schnelle Closed-Loop-Aptamer-Zyklen, bei denen Agenten lernen, den Sequenzraum zu erkunden, bis hin zur Entdeckung von Proteinbindern mit einstelligen nanomolaren Werten bilden diese Anstrengungen die Bausteine für menschlich gelenkte autonome Entdeckung in den Lebenswissenschaften. Wir sind von diesem Fortschritt begeistert und freuen uns darauf, die nächsten Schritte zu teilen.
Danksagungen
Diese Forschung wird von Annalisa Pawlosky geleitet, gemeinsam mit Pooja Rao und Petar Sirkovic. Wir möchten unseren Co-Autoren und Mitarbeitern aus den grundlegenden Arbeiten danken, die diese Forschung unterstützen: Zach Cutts, John Coller, Rachel Chen, Mathias Bellaiche, Hua Tang, Ryder Easterlin und Dina Zverinski (Aptamer-Entdeckung); Jun Kim, Artiom Myaskovsky, Oscar Donosa, Jamie Rogers und Lawrence Chan (Proteindesign); sowie Yves Delley, John Coller, Zach Cutts, Alexander Daryin, Mathias Bellaiche, Jun Kim, Oscar Donosa, Srinidhi Seshadri, Tanner Clary und Sandy Klemm, mit zusätzlichen technischen und experimentellen Beiträgen von Xinyi Deng, Sanath Ramachandran und Jiawu Bi (VERID-Automatisierung).
Wir sind zutiefst dankbar gegenüber Reuven Sayag, Avinatan Hassidim, Ronit Levavi Morad, Yossi Matias und James Manyika für ihre Führung und Unterstützung sowie gegenüber Matthias Heiler, Burak Gokturk, Bill Jia und Pushmeet Kohli für ihre Unterstützung während dieser Forschung. Wir danken außerdem Shekoofeh Azizi, Andrew Carroll, Philip Q. Nelson, Yishay Mansour, Dan Popovici und Riccardo Pisoni für ihre Rezensionen und wertvollen Rückmeldungen, Amanie Brik für ihre allgemeinen Beiträge zu diesem Vorhaben und Udi Graff für das visuelle Design und die Grafiken dieses Beitrags.