
Der Leitstern
Jede Organisation, die im Rennen um den Einsatz von KI-Agents steht, sieht sich derselben Ernüchterung gegenüber: Ein Agent, der in der Demo glänzt, kann in der Produktion unbemerkt an Qualität verlieren, und sobald ein Mensch es bemerkt, ist das Vertrauen bereits zerstört. Wo traditionelle Software laut versagt, versagen Agents leise. Sie liefern eine Antwort, die selbstbewusst klingt, flüssig liest – und falsch ist. Wenn diese Antwort eine echte Geschäftsentscheidung beeinflusst, ist der Preis nicht ein defektes Feature. Es ist eine zerstörte Beziehung zum Nutzer.
Das ist das Qualitätsproblem in seinem Kern. Die Herausforderung besteht daher nicht darin, Agents zu bauen, die einmal funktionieren, sondern zu beweisen, dass sie weiter funktionieren – in großem Maßstab, über jeden Sub-Agent, jeden Workflow und jede Release hinweg. Die Teams, die im Zeitalter der Agents gewinnen werden, sind diejenigen, die Qualität nicht als letzten QA-Schritt behandeln, sondern als das Betriebssystem des Agents selbst: kontinuierlich gemessen, automatisch verteidigt und mit jeder Interaktion verbessert. In diesem Beitrag zeigen wir, wie wir mit Amazon Bedrock AgentCore eine kontinuierliche Qualitätsschleife für produktionsreife agentische Lösungen in großem Maßstab aufgebaut haben.
Geschäftsproblem
Die Lösung nutzt Amazon Bedrock AgentCore und andere AWS-Services für den internen Gebrauch, sodass Verkäufer und Vertriebsleiter in Amazon Quick Geschäftsfragen in natürlichem Englisch stellen können. Hinter dieser einen Oberfläche arbeiten mehrere spezialisierte Sub-Agents zusammen: der Performance Insights Agent für gebietsspezifische Umsatz- und Performance-Einblicke, der Customer Insights Agent für Kundenintelligenz, der Data Insights Agent für Text-to-SQL über Basisdatensätze sowie direkter Dashboard-Zugriff. Antworten sind auf das Territorium jedes Nutzers und dessen rollenbasierte Sicherheit beschränkt. Feldteams nutzen diese Antworten zur Unterstützung bei der Planung der Kontostrategie und zur Vorbereitung auf Kundentreffen – die Zahlen müssen daher stimmen. Der schädlichste Fehler ist kein Absturz. Es ist eine flüssige, selbstbewusste Antwort, die stillschweigend falsch ist. Vor dem Launch, als wir den Customer Insights Agent evaluierten, fanden wir genau das:
- Er meldete 410.08 USD des Dreimonatsumsatzes eines Kunden für einen Service als „$410.08 Million“.
- Er meldete Sales Revenue, beschriftet als Sales Revenue excluding Adjustments.
- Er bot eine Schätzung des Annual Recurring Revenue an, die in den Daten nirgendwo auftauchte.
- Er stellte eigene Berechnungen als belegte Fakten dar.
Über die verschiedenen Durchläufe hinweg blieb das Monitoring grün. Es sagte uns, dass das System geantwortet hatte – nicht, ob die Antwort richtig war.
Wären diese Fehler unentdeckt ausgeliefert worden, hätte das Feldteam den Preis dafür bezahlt. Ein Verkäufer, der eine aufgeblähte Zahl wiederholt, kann an Glaubwürdigkeit beim Kunden verlieren. Genau deshalb haben wir es vor dem Launch erkannt. Das Risiko endet nicht mit dem Launch: Es wächst mit jedem neuen Agent und jeder Änderung an Daten, Prompts, Code oder Modellen. Es wächst auch ohne jede Release, weil vorgelagerte Pipelines die Daten jede Woche aktualisieren. Koordinierte Releases bergen ein verwandtes Risiko: Wenn eine Datenänderung, eine Tool-Änderung und ein zugehöriges Prompt-Update zusammen ausgeliefert werden sollen, aber zeitversetzt ankommen, läuft das System mit inkonsistenten Zuständen, bis alle Änderungen nachgezogen sind. In einem Pre-Production-Test senkte allein dieses Inkonsistenzfenster die Bestehensquote von 78 Prozent auf 38 Prozent. Um solche Fehler zu erkennen – vor jeder Release und kontinuierlich in der Produktion – benötigen wir ein Framework, das zeigen kann, ob Antworten fundiert und korrekt sind, und jeden Fehler bis zu seiner Ursache in den Daten, im Prompt oder im Code des Agents zurückverfolgen kann.
Bei AWS entwickelte das Sales, Marketing, and Global Services (SMGS) Operations Team ein Multi-Agenten-Produktionssystem, das AWS Field Sales weltweit bedient. Es richtet sich an zwei unterschiedliche Zielgruppen. Für Field-Sales-Teams ersetzt es stundenlange manuelle Datenanalyse durch bedarfsgesteuerte, dialogorientierte Intelligence und hilft Verkäufern, den Zustand ihres Geschäfts zu verstehen, Risiken und Chancen aufzudecken und schneller zu handeln. Für Führungskräfte unterstützt es Geschäftsmanagement-Routinen wie Weekly Business Reviews (WBRs) und bringt die relevanten Signale über das gesamte Portfolio ans Licht, ohne dass Berichte manuell vorbereitet werden müssen. Dasselbe agentische System bedient sowohl den Verkäufer an der Frontlinie als auch die Führungskraft, die Performance in großem Maßstab prüft.
Das agentische System orchestriert ein wachsendes Portfolio spezialisierter Sub-Agents, die jeweils eine eigene Fähigkeitsdomäne besitzen. Darunter: der Performance Insights Agent erzeugt Business-Intelligence-Narrativen in natürlicher Sprache aus komplexen Vertriebsdaten und verwandelt Rohmetriken in umsetzbare Erkenntnisse für Verkäufer. Der Customer Insights Agent erstellt eine 360-Grad-Sicht auf jeden Kunden, indem er Signale aus Produktnutzung, Support-Historie, Vertragsstatus und Engagement-Daten zusammenführt und Verkäufern hilft zu verstehen, wo ein Kunde auf seiner Reise steht und was er als Nächstes benötigt. Der Data Insights Agent ist ein Text-to-SQL-Agent, mit dem Account-Teams strukturierte Analysedaten in natürlichem Englisch abfragen können, ohne eine einzige Zeile SQL zu schreiben. Diese drei Agents sind diejenigen, auf die im restlichen Beitrag Bezug genommen wird.
Diese Agenten zuverlässig und im großen Maßstab zu koordinieren, machte eines deutlich: Agentic Quality war keine operative Angelegenheit, die man später verwalten konnte. Sie war die Voraussetzung für den Betrieb. Ein einzelnes degradiertes Sub-Agent kann stillschweigend jede nachgelagerte Antwort verfälschen, und herkömmliches Monitoring wird das nicht erkennen. Diese Realität machte ein umfassendes Lifecycle-Evaluierungs-Framework nicht optional, sondern notwendig. AgentCore Evaluations, eine Funktion von Amazon Bedrock AgentCore, ist das verbindende Element, das dies antreibt, neben Amazon Bedrock Guardrails (Sicherheit), Amazon CloudWatch (Metriken, Alarme, Tracing), Amazon Simple Storage Service (Amazon S3) und Amazon Redshift (Evaluationsspeicherung), Amazon Quick (Dashboards) und AWS Lambda (eigene Evaluatoren).
In diesem Beitrag teilen wir, wie wir die härtesten operativen Herausforderungen beim Betrieb von KI-Agenten im Unternehmensmaßstab gemeistert haben und wie Amazon Bedrock AgentCore Evaluations das Rückgrat der Agentenqualität wurde. Konkret behandeln wir:
- Agenten folgen anderen Regeln – Warum Agenten eine andere operative Disziplin erfordern und warum herkömmliches Monitoring (Latenz, Fehlerraten, Verfügbarkeit) Sie gegenüber den wichtigsten Fehlern blind macht.
- Eine Karte für die gesamte Reise – Das neunstufige Evaluierungs-Framework, das wir auf AgentCore Evaluations aufgebaut haben und das jede Phase des Agentenentwicklungs-Lebenszyklus vom ersten Commit bis zur Produktion abdeckt.
- Von der Theorie zur Praxis – Konkrete Muster (Continuous Integration and Continuous Delivery (CI/CD) Regression Gates, Canary Scoring, Drift Detection und automatisierte Feedback-Schleifen) und genau, wie AgentCore Evaluations jedes davon antreibt.
- Metriken, die wirklich zählen – Die messbaren Auswirkungen auf die Verlässlichkeit von Deployments, die Vermeidung von Regressionen und die Iterationsgeschwindigkeit über unser gesamtes Agentenportfolio.
Warum Agenten ein strukturiertes Evaluierungs-Framework brauchen
Traditionelle Software ist deterministisch: Derselbe Input erzeugt denselben Output. Machine-Learning-Modelle (ML) führten probabilistische Outputs ein, und MLOps entstand, um deren Training, Versionierung, Monitoring und Nachtraining zu verwalten. KI-Agenten fügen eine dritte Schicht operativer Komplexität hinzu: autonomes, mehrstufiges Reasoning, bei dem sich die Frage von „ist etwas kaputtgegangen?“ zu „trifft der Agent die richtigen Entscheidungen entlang seiner gesamten Reasoning-Kette?“ verschiebt.
Agenten erben die schwierigen Probleme beider Vorgänger und führen einige neue ein. Sie sind nicht-deterministisch und verfolgen für identische Inputs unterschiedliche Reasoning-Pfade. Sie treffen kaskadierende Entscheidungen über Routing, Tool-Auswahl und Synthese hinweg, wobei ein einzelner Schritt leise fehlschlagen und alles Nachgelagerte verfälschen kann. Am kritischsten ist, dass sie still degradieren: Die Latenz bleibt niedrig, die Fehlerrate bleibt konstant, doch die Qualität der Agentenantworten sinkt, weil der Agent weiterhin antwortet. Er antwortet nur noch falsch.
Die Agentenevaluation ist genau dafür die Praxis, dies zu erkennen. Sie umfasst fünf Dimensionen: Sicherheit (verhält sich der Agent innerhalb definierter Grenzen?), Qualität (produziert der Agent korrekte, kohärente, fundierte Antworten?), Leistung (ist er schnell und zuverlässig genug?), Kosten (läuft er im großen Maßstab effizient?) und operative Kontrolle (können wir Probleme schnell erkennen, diagnostizieren und beheben?). Eine ausgereifte Evaluierungspraxis behandelt alle fünf kontinuierlich über den gesamten Agenten-Lebenszyklus hinweg.
In diesem Beitrag zeigen wir, wie wir die fünf Evaluierungsdimensionen in einem Multi-Agenten-System in der Produktionsumgebung operationalisieren. Sicherheit ist unsere erste Priorität. Kein Agent wird ausgeliefert und kein Agent bleibt im Betrieb, wenn er seine Sicherheitsanforderungen nicht erfüllen kann. Qualität erhält in diesem Beitrag den meisten Raum, weil sie die schwerste der fünf Dimensionen richtig umzusetzen ist und am meisten von einem dedizierten Framework profitiert, aber sie rangiert nicht über der Sicherheit. Leistung, Kosten und operative Kontrolle ziehen sich wie Sicherheit und Qualität durch jede Phase des Lebenszyklus. Entscheidend ist, dass dieses Framework auf jeder Ebene der Agentenhierarchie anwendbar ist. Auf der Tool-Ebenehat jede Fähigkeit (ein Tool zur Kunden-Disambiguierung, ein Graph-Retrieval-Tool) ihren eigenen Evaluierungsvertrag. Auf der Agenten-Ebenewird jedes Sub-Agent end-to-end evaluiert. Auf der Multi-Agent-Ebene, Orchestrierungspfade werden auf Kohärenz, korrektes Routing und Synthese-Genauigkeit über Agentengrenzen hinweg bewertet.
Die neun Stufen greifen gleichzeitig auf drei Ebenen, und diese Hierarchie ist nicht produktspezifisch. Es ist das richtige mentale Modell, wenn wir neue Produktions-Agents entwickeln oder integrieren. Die meisten Teams beginnen mit der Evaluierung auf der Agent-Ebene und hören dort auf. Aber die Qualität auf Agent-Ebene ist nur so gut wie die Werkzeuge, auf die sie sich stützt, und Multi-Agenten-Systeme führen eine dritte Fehlerfläche ein, die keine der beiden Ebenen allein erkennen kann. Eine robuste Evaluierungspraxis deckt alle drei ab, wobei jede Ebene ihren eigenen Golden Set, ihre eigenen Evaluatoren und ihre eigenen Promotion-Kriterien durch die neun Stufen hat.
Das Agent-Evaluierungsframework: neun Stufen, ein geschlossener Kreislauf
Diese neun Stufen bilden den Agent-Lebenszyklus vom ersten Commit bis zur Live-Produktion ab, und jede einzelne beantwortet eine Frage, mit der Teams konfrontiert werden, wenn ihre Agents reifen.
Der Agent-Lebenszyklus und die neun häufigen Fragen
Jedes Team, das Produktions-Agents entwickelt, begegnet den folgenden Fragen, während sein Agent reift:
Stufe 1: Das Fundament: „Wie sieht gut aus?“
Stufe 2: Das Experiment: „Welche Version ist besser?“
Stufe 3: Der Merge (CI): „Habe ich etwas kaputtgemacht?“
Stufe 4: Das Tor (CD): „Ist es sicher für die Produktion?“
Stufe 5: Der Canary: „Ist etwas stillschweigend kaputtgegangen?“
Stufe 6: Der Gegner: „Was, wenn jemand versucht, es zu brechen?“
Stufe 7: Die Drift: „Verschlechtert sich die Qualität im Live-Betrieb?“
Stufe 8: Der Puls: „Woher wissen wir, dass es gerade jetzt funktioniert?“
Stufe 9: Der Feedback-Loop: „Wie wird es automatisch besser?“
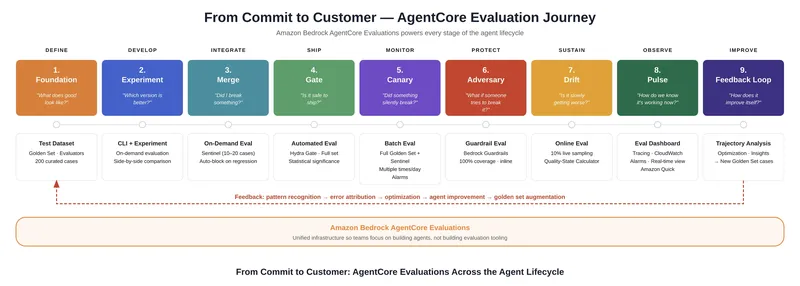
Wir bauen ein Framework für jede Phase des Agent-Lebenszyklus mit AgentCore Evaluations. Die neun Phasen sind keine separaten Werkzeuge, die nachträglich zusammengesetzt werden. Es sind neun Punkte auf einer einzigen, durchgehenden Bewertungsoberfläche, angetrieben von AgentCore Evaluations vom ersten Commit bis zur Produktionsantwort, wie in Abbildung 1.
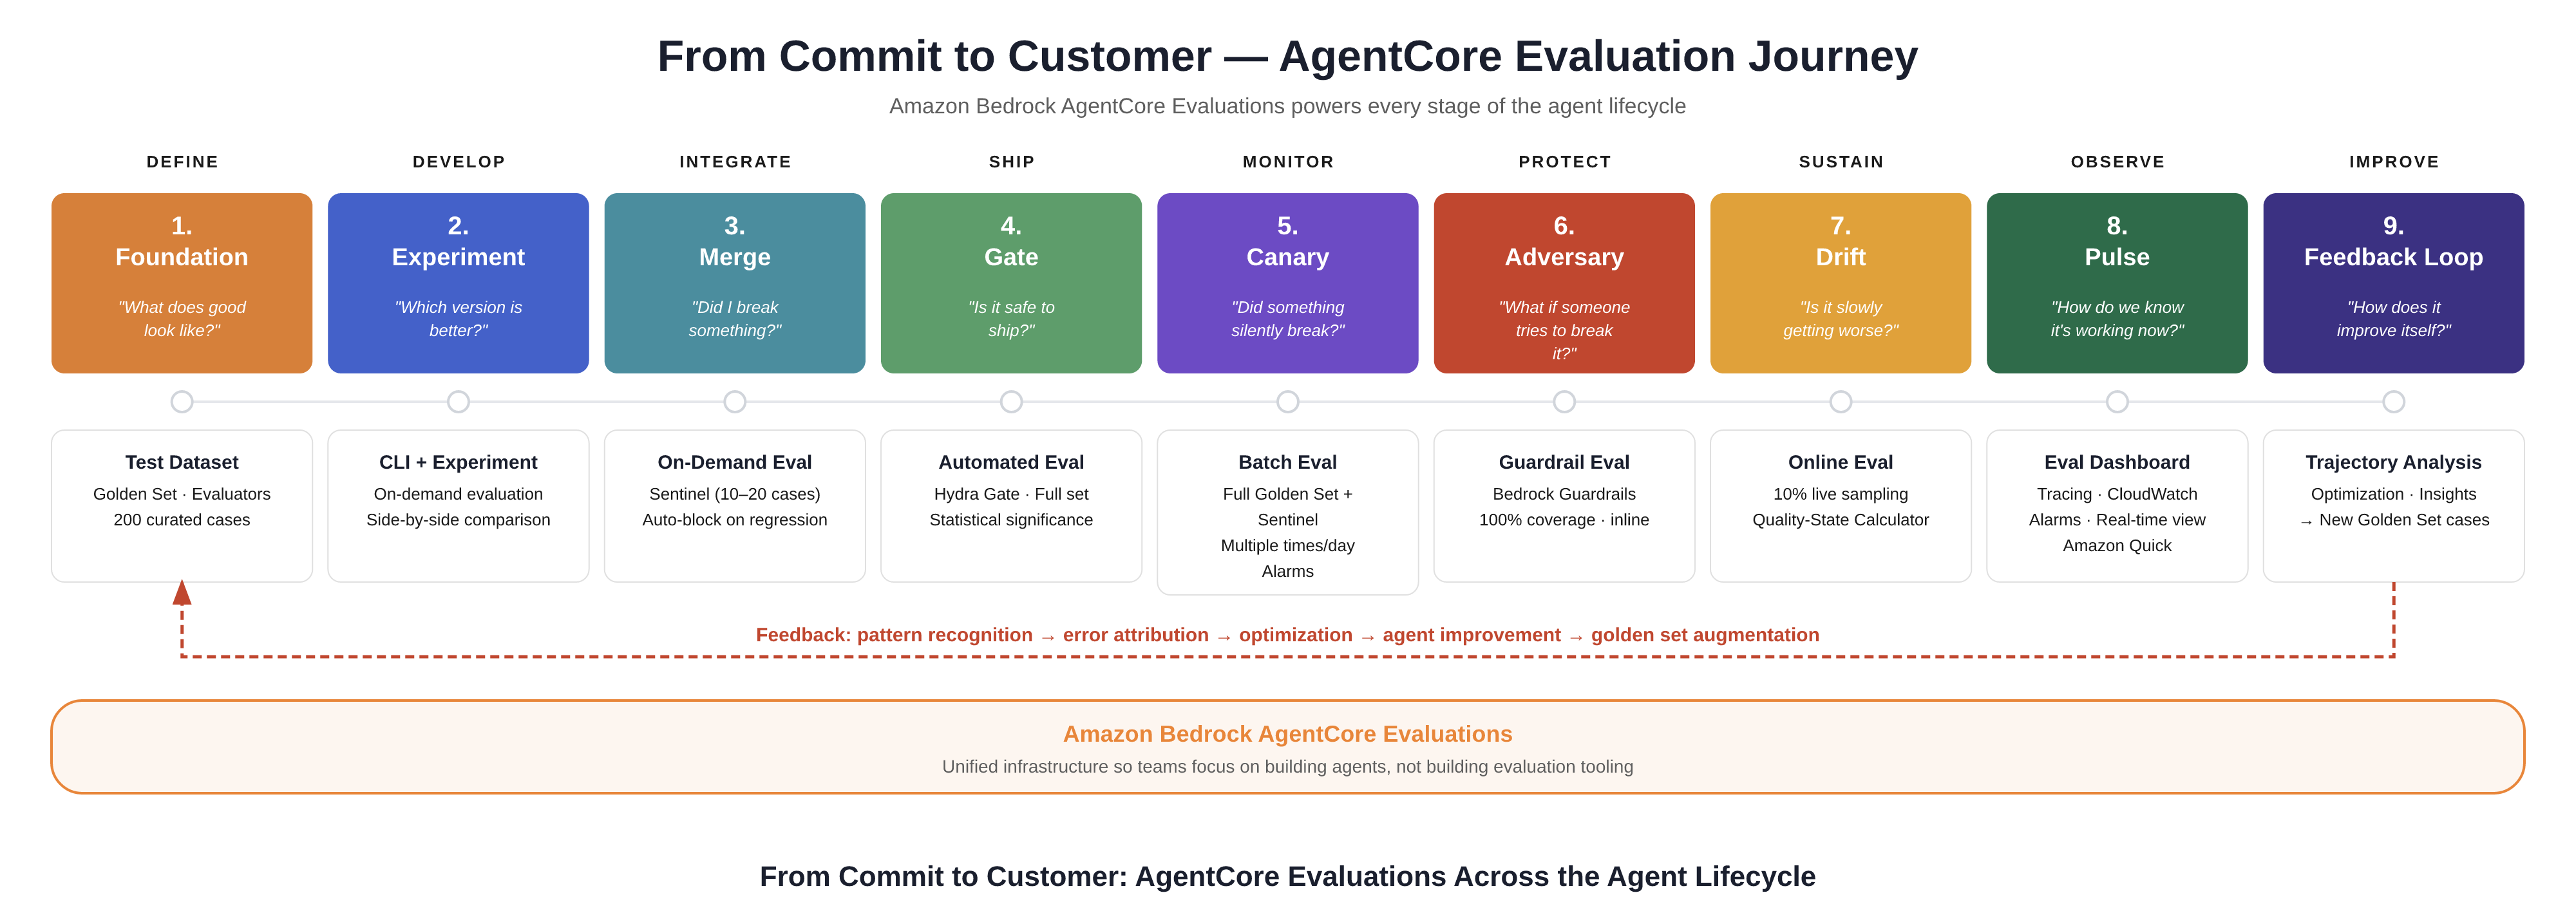
Abbildung 1: Die neunphasige AgentCore-Evaluations-Journey von Define bis Improve
So gehen wir jede einzelne an: das Muster, das funktioniert, die AgentCore-Dienste dahinter und wie es sich im Betrieb zeigt, dargestellt im Systemdesign in Abbildung 2.
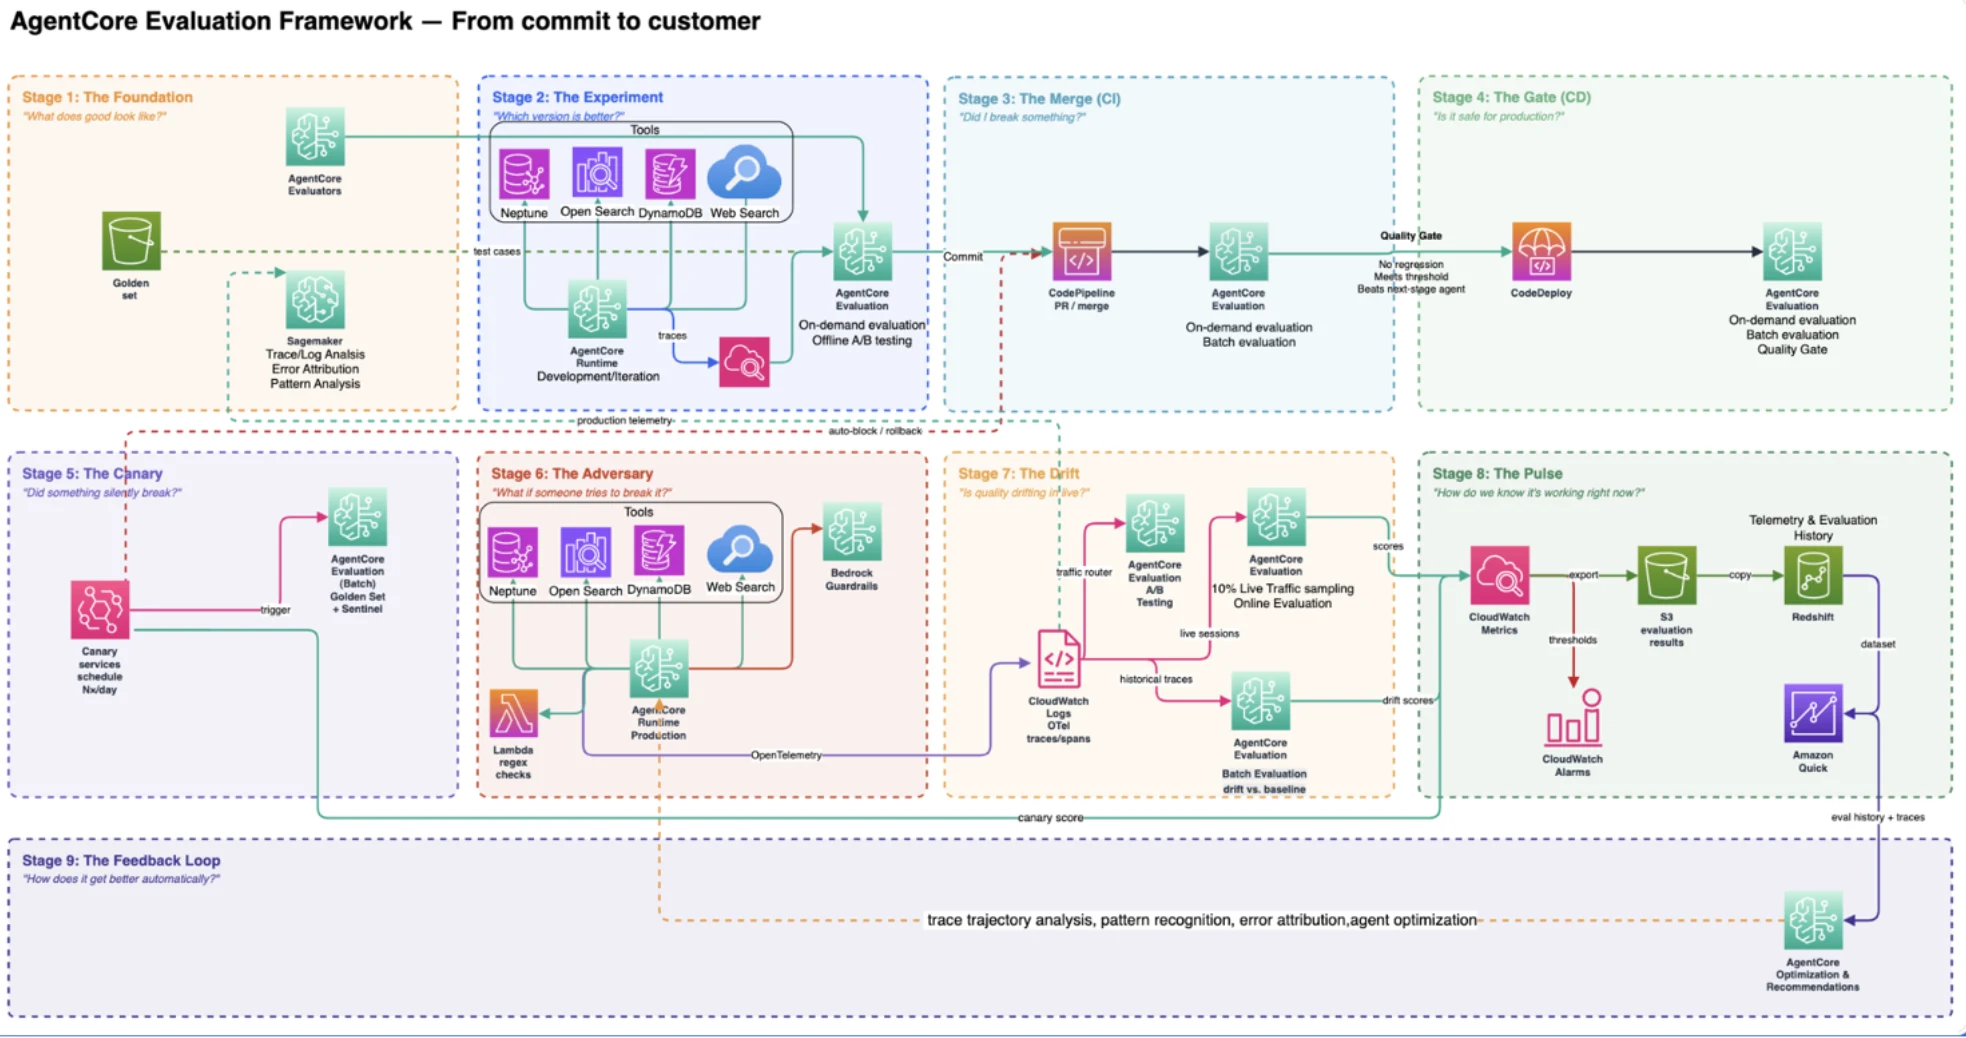
Abbildung 2: Systemdesign des AgentCore-Evaluations-Frameworks
Phase 1: Das Fundament. Qualität definieren
Das Fundament der Bewertung eines Agents besteht nicht darin, die richtigen Werkzeuge zu wählen. Es geht darum, die richtige Frage zu stellen: Wie sieht Erfolg für diesen Agent aus, und woran erkennen wir, dass er versagt? Die Antwort muss vom Kunden kommen, nicht vom Modell. Dies ist ein iterativer Prozess. Unsere Definition von Erfolg hat sich geschärft, als wir beobachtet haben, was der Agent in der Produktion tatsächlich tut. Alles, was hier definiert wird (Fehlerschwellen, Evaluator-Stack, Golden Set, Sicherheitsregeln, Latenzbudgets und Kostenziele), ist der Vertrag, den jede nachfolgende Phase durchsetzt. Ist Phase 1 vage, rät jedes nachgelagerte Tor nur.
Phase 1.1: Zuerst Ihre Geschäftskennzahlen definieren. Beginnen Sie mit der Frage, was der Agent liefern soll. Die beiden Endnutzer-Personas definieren Erfolg unterschiedlich:
- Für Vertriebler bedeutet Erfolg, mit präziser, aktueller Information auf der richtigen Detailebene und zum richtigen Zeitpunkt in ein Kundengespräch zu gehen.
- Für die Führungsebene bedeutet Erfolg verlässliche wöchentliche und unternehmensübergreifende Review-Inputs ohne langwierige manuelle Vorbereitung. Dies sind Geschäftsergebnisse, keine Modelleigenschaften.
Phase 1.2: Diese Geschäftskennzahlen in Bewertungsmetriken übersetzen. Ermitteln Sie für jedes Ergebnis das Signal, das bestätigt, dass der Agent es geliefert hat. Jedes Signal wird zu einer verfolgten Metrik mit einer expliziten Schwelle und einer Alarmbedingung. Präzise Konto-Intelligenz entspricht Entity-Resolution-Genauigkeit und Grounding Rate. Verkäufervertrauen entspricht Faithfulness und Halluzinationsrate. Verkäuferhandlung entspricht Helpfulness und Scope Adherence. Verlässlichkeit der Führungsebene-Reviews entspricht Accuracy Pass Rate und Response Coverage. Diese Übersetzung muss fünf Dimensionen abdecken: Definieren Sie neben Qualitätsschwellen Sicherheits-Guardrail-Richtlinien, setzen Sie p50-, p90- und p99-Latenzziele pro Tool und pro Agent, legen Sie Kosten-pro-Abfrage-Budgets fest und definieren Sie die Service Level Agreements (SLAs), die festlegen, wann ein Alarm ausgelöst wird und welches Runbook er aktiviert.
Speziell bei der Genauigkeit ist die Messlatte hoch, da die Lösung direkt Umsatzentscheidungen, Verlängerungsstrategien und Executive Reviews beeinflusst. Eine selbstbewusst falsche Antwort verschwendet nicht nur die Zeit eines Vertrieblers. Sie führt zu einer falschen Entscheidung in einem echten Geschäftsmoment. Wir definieren sechs Fehlertypen, abgeleitet aus echten Produktionsfehlern, von denen jeder einzelne eine Antwort als ungenau kennzeichnet:
- Metriktausch: richtiger Kunde und richtige Periode, falsche Metrik zurückgegeben. Erfasst als Vorkommen pro 100 Antworten.
- Falsche Periode: Daten aus einem Zeitfenster werden als anderes bezeichnet, z. B. eine Year-over-Year-Figur (YoY), die dem Vertriebler als Month-over-Month (MoM) präsentiert wird, oder umgekehrt. Erfasst als % mit korrektem Fenster.
- Falsche Entität: vermischte Kontonamen oder Tochtergesellschaften. Erfasst als Entity-Resolution-Genauigkeit in %.
- Reine Halluzination: ungestützte Zahlen ohne nachvollziehbare Quelle. Erfasst als Grounding Rate in %.
- Falsche Symbole: korrekte Metrik, falsches Währungs- oder Einheitensymbol. Erfasst als Scope Adherence Rate in %.
- Nicht autorisierte Berechnung: nicht freigegebene abgeleitete Zahlen, die in den Quelldaten nicht vorhanden sind. Erfasst als Vorkommen pro 100 Antworten.
Die gesamte Accuracy Pass Rate ist die Hauptmetrik. Die Verfolgung pro Dimension macht sie handlungsrelevanz. Über Genauigkeit hinaus verfolgen wir auch Response Relevance, Faithfulness, Helpfulness, Instruction Following,Genauigkeit der Werkzeugauswahl„. Eine richtige Antwort, die in drei Absätzen vergraben ist oder zu spät kommt, hat den Verkäufer ebenfalls im Stich gelassen.“
Stufe 1.3: Bauen Sie einen Evaluator-Stack, der diese Metriken widerspiegelt. Kein einzelner Evaluatortyp deckt die verschiedenen möglichen Fehlermodi ab. Wir kombinieren vier Typen:
- Integrierte AgentCore-Evaluator für eine breite Baseline-Abdeckung. Relevanz, Treue und Hilfslichkeit lassen sich direkt auf Auswertungsvorlagen abbilden, die nativ in verfügbar sind AgentCore Evaluations.
- Spezialisierte Evaluatorren, einen pro Fehlertyp in unserer Taxonomie: einen Metric-Swap-Evaluator, einen Wrong-Period-Evaluator, einen Wrong-Customer-Evaluator, einen Pure-Hallucination-Evaluator, einen Wrong-Symbols-Evaluator und einen Unauthorized-Calculation-Evaluator. Keiner der sechs wird durch native Templates abgedeckt. Es sind domänenspezifische Signale, die wir auf dem AgentCore-Framework aufgebaut haben. Von vornherein zu wissen, welche Metriken ein natives Template bereits abdeckt und welche einen spezialisierten Evaluator erfordern, ist selbst Teil der Designentscheidung.
- Evaluatorren von Drittanbietern, setzten wir die verwalteten Evaluatorren aus den Open-Source-Bibliotheken von Drittanbietern DeepEval und AutoEval ein.
- Deterministische Evaluatorren für Ground-Truth-Prüfungen, bei denen die korrekte Antwort exakt bekannt ist, wie Umsatz, Verlängerungsdatum und Vertragsstatus.
Wo bei Reasoning-Qualität und Nützlichkeit keine einzelne richtige Antwort existiert, verwenden wir stattdessen LLM-as-judge-Rubriken, mit eingebauten Rubriken für Relevanz, Treue (Faithfulness) und Nützlichkeit sowie Unterstützung für vollständig eigene Rubriken. AgentCore Evaluations bietet sowohl Ground-Truth- als auch LLM-as-judge-Evaluierung nativ an, was es uns ermöglichte, beide Evaluierungspfade aufzubauen, ohne selbst eine der Scoring-Engines zu entwickeln. Deterministisch liefert Präzision bei Fakten. LLM-as-judge liefert Breite beim Reasoning.
Phase 1.4: Bauen Sie ein goldenes Set auf, um Ihre Evaluierungsmetriken zu üben. Auf der Tool-Ebenehat jedes kritische Tool seine eigenen deterministischen Ground-Truth-Paare: Die Kundenidentifikation muss zur exakten kanonischen Entität auflösen oder fehlschlagen. Auf der Agent-Ebeneerzeugt die Themenanalyse an echten Nutzeranfragen einen Datensatz über vier Fragetypen (comprehensive, reporting, reasoning und ambiguous), von denen jeder eine andere Evaluierungsstrategie erfordert, die monatlich überprüft wird. Auf der Multi-Agent-Ebenefangen End-to-End-Orchestrierungsszenarien Fehler ab, die nur auftreten, wenn Agenten interagieren. Das goldene Set ist nicht nur ein Qualitätsdatensatz. Es umfasst auch Sicherheitstestfälle, Latenz-Benchmark-Fälle und Kostenreferenzfälle, damit die Phasen 3 und 4 fünf Dimensionen gegen denselben kuratierten Datensatz prüfen können.
Das goldene Set ist ein lebendiges Dokument, das aus drei Quellen aufgebaut wird. Produktionsabgeleitete Fälle werden aus echten Verkäufer- und Führungsanfragen gesampelt, einschließlich der in Phase 7 hochgestuften Live-Sitzungen mit niedrigen Bewertungen. Fehlerabgeleitete Fälle stammen aus jeder in Staging oder Produktion entdeckten Regression, einschließlich der in Phase 3 hochgestuften Sentinel-Fälle und der in Phase 9 hochgestuften permanenten Regressionswächter. Synthetische Randfälle werden gezielt konstruiert, um die Abdeckung von Szenarien zu garantieren, die uns wichtig bekannt sind, aber nicht darauf warten können, in freier Wildbahn anzutreffen, wie die vier oben genannten Fragetypen und die Disambiguierungsfälle für Mutter-/Tochtergesellschaften und Tickersymbole in Phase 4. Das Set ist versioniert, wird geprüft und über die drei Quellen hinweg kontinuierlich erweitert.
Phase 2: Das Experiment. Wissen Sie, welche Version gewinnt
Jede Änderung (ein Prompt-Update, ein neues Tool, ein Modell-Upgrade, eine Datenaktualisierung) wirft dieselbe Frage auf: ist diese Version tatsächlich besser? In einem System, das das AWS-Feld in globalem Maßstab bedient, ist Intuition keine akzeptable Antwort.
Bevor eine Änderung gemergt wird, führen wir eine AgentCore On-Demand Evaluationdurch, bewertet gegen dasselbe goldene Set mit derselben Evaluator-Suite. Das Entwicklungsteam nutzt die Qualitäts-, Latenz- und Kostenmetriken sowie die Context-Token, um nachgelagerte Vergleiche zu kurieren, die gleichzeitig über fünf Dimensionen hinweg ausgewertet werden, wie nebeneinander dargestellt in Abbildung 3. Ein Modell, das die Genauigkeit um 5 Prozent verbessert, aber die Latenz verdoppelt und die Kosten verdreifacht, gewinnt nicht automatisch.
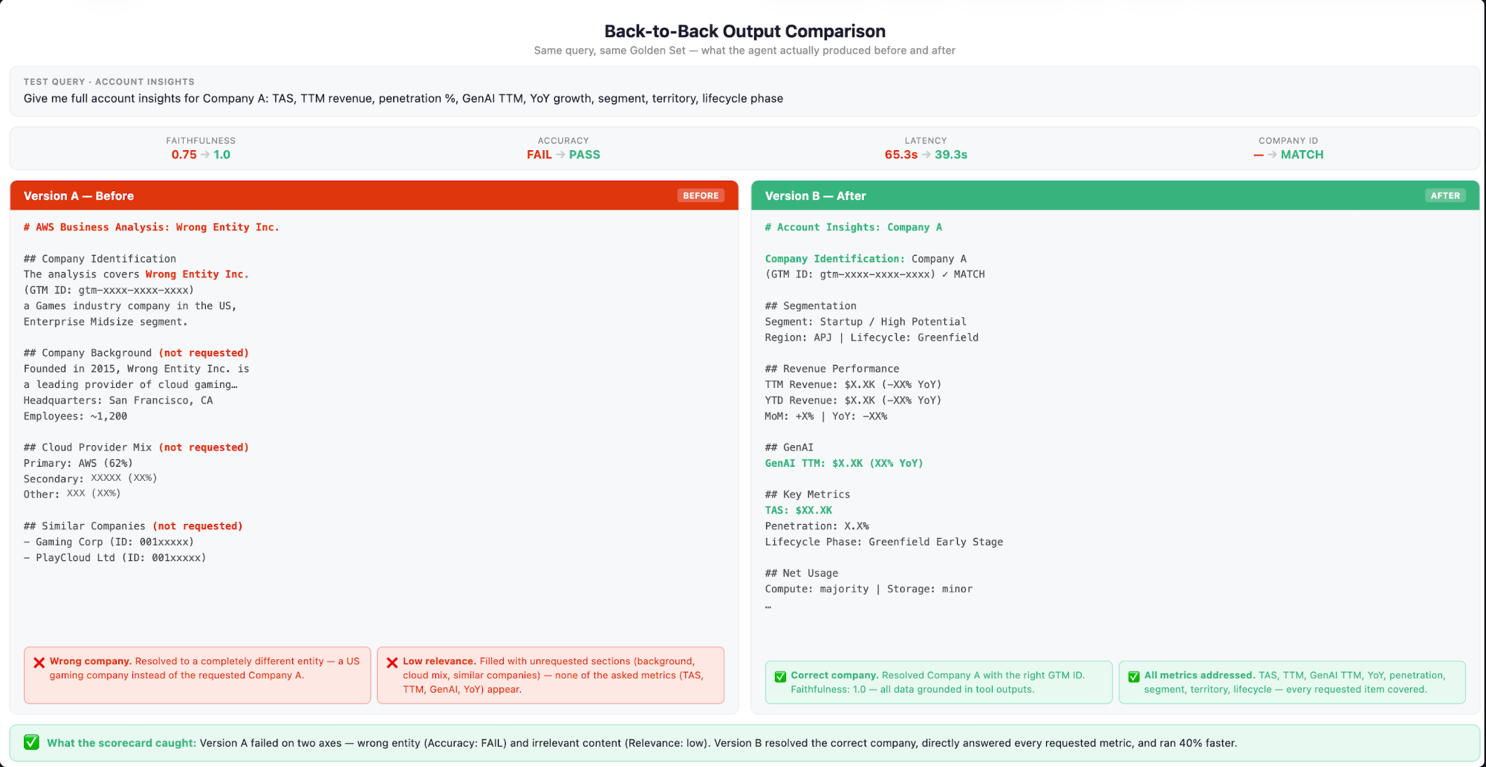
Abbildung 3: Vergleich zweier Kandidaten-Antworten eines Agenten in einer AgentCore On-Demand Evaluation nebeneinander über Qualität, Latenz und Kosten. Die Zahlen und Werte in der Abbildung sind illustrativ.
Wir verfolgen Qualität als umfassende Scorecard, nicht als einzelne Zahl. Eine Passrate allein sagt nicht genug aus. Jeder Eval-Lauf erzeugt eine vollständige Aufschlüsselung über jede Fehlerkategorie in unserer Taxonomie: nicht nur, ob sich die Qualität verbessert hat, sondern wo und warum, wie in der Scorecard in Abbildung 4 erfasst. Jede Evaluierung wird auch vollständig aufgezeichnet: Eingaben, Ausgaben, abgerufener Kontext, Bewertungen und Evaluierungsgründe werden in S3 und unserem Data Lake gespeichert, was uns eine persistente Observability-Schicht gibt, um Fehler bis zur Ursache zurückzuverfolgen: was der Agent gesehen hat, was er generiert hat und warum es schiefging. Über drei Monate gezielter Iteration trieb diese Scorecard die Passrate von 93 Prozent auf stabile 96 Prozent: Pure Hallucinations sanken von 138 auf unter 52 pro 10,000 Antworten, unauthorized calculations fielen von 59 auf unter 44, was bestätigte, dass die Retrieval solide war und die Gewinne aus Generation-Fixes kamen. Ohne die Aufschlüsselung pro Kategorie und die detaillierten Trace-Daten dahinter hätten wir blind iteriert.
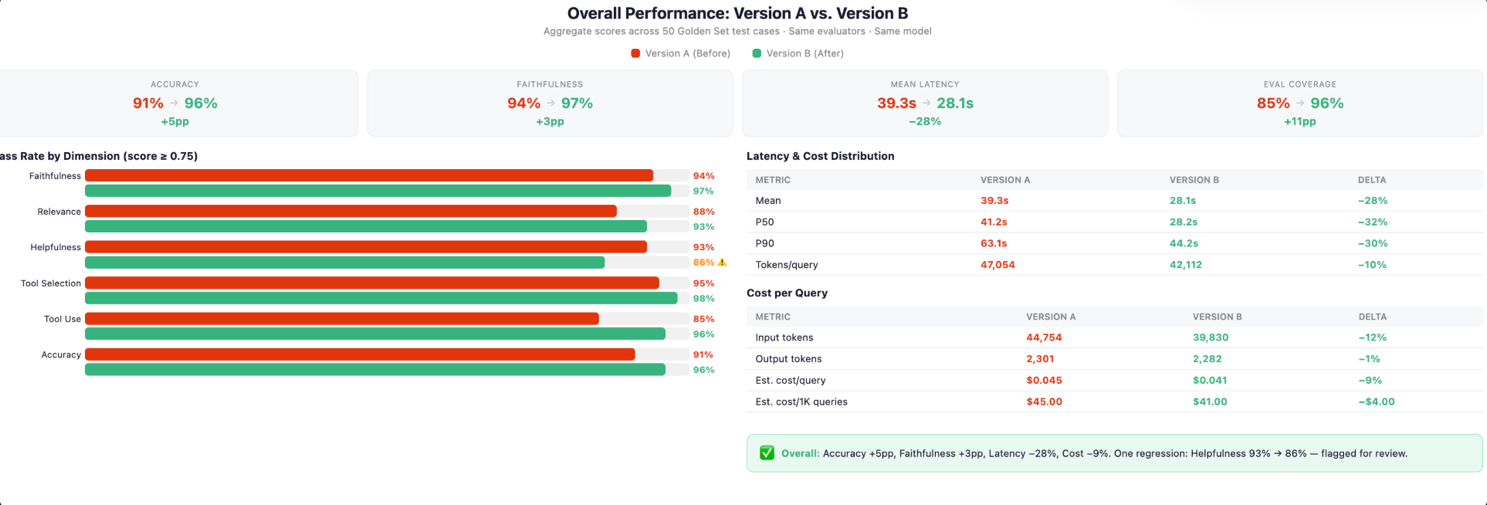
Abbildung 4: Evaluierungs-Scorecard mit Fehleraufschlüsselung pro Kategorie und Passraten-Trend. Die Zahlen und Werte in der Abbildung sind illustrativ.
Phase 3: Der Merge (CI). Regression zum Merge-Zeitpunkt verhindern
Phase 3 ist ein Pre-Production-Gate. Es läuft in der Staging-Umgebung, ausgelöst durch Code- und Konfigurationsänderungen, und seine Aufgabe ist es, eine schlechte Änderung zu blockieren, bevor sie überhaupt die Produktion erreicht. Wenn Phase 3 eine Regression findet, wird nichts ausgeliefert.
Ingenieure oder Wissenschaftler ändern das System auf viele Arten: den Prompt, die zugrunde liegenden Daten, die Tools oder das Modell. Die Änderung sieht lokal sauber aus, die Tests bestehen, aber ein Prompt, der die Antworten für Technologie-Konten verbessert, könnte still die Antworten für Konten im Finanzdienstleistungssektor verschlechtern. Ohne ein automatisiertes Gate wird dies ausgeliefert.
Unsere CI-Evaluierung wird bei jedem Staging-Deployment automatisch über AgentCore On-Demand Evaluation ausgelöst. Ingenieure müssen nicht daran denken, eine Evaluierung auszuführen. Kein Deployment kann die Schleuse stillschweigend umgehen. Der Lauf ist nach Minuten abgeschlossen, weil er nur das Sentinel-Set und nicht das vollständige Golden-Set auswertet. Die Geschwindigkeit ist beabsichtigt: Der Sentinel ist schmal genug, um bei jedem Deployment zu laufen, aber repräsentativ genug, um die wichtigsten Fehler zu erkennen.
Das Sentinel-Set ist eine kuratierte Auswahl der risikoreichsten Szenarien über fünf Dimensionen. Qualitätsregressionen jenseits der Toleranz blockieren das Deployment. Eine Sicherheitsgrenzverletzung blockiert genauso hart. Eine Änderung, die die p90-Latenz verdoppelt, geht nicht ohne eine bewusste Entscheidung weiter. Token-Kostenspitzen werden markiert, bevor sie sich bei Skalierung aufsummieren. Jeder Sentinel-Lauf veröffentlicht seine Scores in CloudWatch als benutzerdefinierte Metriken; Qualitäts-Scores, Latenz, Kosten pro Abfrage und Safety-Pass-Rate werden nach jedem Lauf ausgegeben, und CloudWatch-Alarme sind so konfiguriert, dass sie auslösen, wenn eine Metrik ihren Stage-1-Schwellenwert überschreitet. Jeder Lauf wird außerdem protokolliert und gespeichert und speist den Audit-Trail, auf den sich Stage 8 und Stage 9 stützen. Wir pflegen einen separaten Sentinel auf jeder Ebene: Tool, Agent und Multi-Agent. Eine Änderung, die die Qualität auf Agent-Ebene verbessert, aber ein kritisches Tool verschlechtert, blockiert dennoch. Der Sentinel wird monatlich überprüft, und eine Regression, die bis in die Produktion durchrutscht, wird sofort zu einem permanenten Fall befördert, damit sie die Nutzer nicht ein zweites Mal erreicht.
Ein Beispiel dafür, was dies erkennt. Nach einem Daten-Normalisierungs-Update begann ein Disambiguierungs-Tool, für eine Teilmenge von Kontonamenformaten unaufgelöste Entitäten zurückzugeben. Der Agent antwortete auf die unaufgelöste Entität mit einer bestmöglichen Übereinstimmung und lieferte echte Daten für den falschen Kunden. Unser Sentinel auf Tool-Ebene enthält genau diese Klasse von Randfällen: Die Entity-Resolution-Ground-Truth-Prüfung schlug für die betroffenen Kontonamenformate fehl, und das Deployment wurde automatisch blockiert. Die Änderung erreichte nie die Produktion.
Stage 4: Die Schleuse (CD). Mit quantitativer Sicherheit ausliefern
Der Sentinel umfasst 15 Fälle. Die Produktion umfasst Zehntausende von Abfragemustern über Hunderte von Kontotypen, Geografien und Verkäufersegmenten. Das Bestehen des Sentinels ist notwendig. Es ist nicht ausreichend.
Bevor ein Kandidat ausgeliefert wird, führen wir eine AgentCore On-Demand Evaluation über das vollständige Golden-Set entlang der Evaluator-Dimensionen durch. Wir nennen dies das Quality Gate. Es ersetzt „es scheint in Ordnung“ durch eine quantitative Freigabeentscheidung.
Sandgeboxte Ausführung und Tool-Mocking. Denken Sie es sich als eine Wiedergabe, nicht als einen Live-Aufruf. Im Voraus frieren wir einen bekannten, versionierten Datensatz korrekten Tool-Verhaltens ein. Jeder Tool-Aufruf, den der Kandidat während der Schleuse macht, wird abgefangen und aus diesem eingefrorenen Datensatz statt aus einem echten System beantwortet. Wir erstellen diesen eingefrorenen Datensatz in zwei Schritten. Zuerst testen wir jedes Tool für sich: Wir senden ihm eine zurückgehaltene Menge von Eingaben aus unserem Golden-Set, bei denen die richtige Antwort bereits bekannt ist, und bewerten, was es tatsächlich zurückgibt, gegen diese bekannte Antwort. Das zeigt uns, ob das Tool selbst funktioniert (Entity Resolution, Retrieval, SQL-Generierung), bevor der Agent überhaupt beteiligt ist. Zweitens frieren wir, nachdem die Antworten eines Tools als korrekt bestätigt wurden, genau diese validierten Antworten in den Replay-Datensatz ein, den der Agent während der Gate-Evaluierung sieht. Das bedeutet, dass der Agent rein auf sein eigenes Reasoning getestet wird, nicht auf die Geschwindigkeit oder Verfügbarkeit live Tools, und da jeder Kandidat aus demselben eingefrorenen Datensatz wiedergibt, geht jeder Score-Unterschied im direkten Vergleich auf den Agenten zurück, nicht auf Tool-Varianz.
Aggregiertes End-to-End-Scoring. Die Schleuse führt auch einen ganzheitlichen Durchlauf durch: Der vollständige Kandidat-Agent beantwortet 200 zurückgehaltene Fragen End-to-End, bewertet nach einer LLM-as-judge-Rubrik über alle Evaluator-Dimensionen. Jede von drei Bedingungen schließt die Schleuse automatisch: Der aggregierte Score verschlechtert sich gegenüber dem vorherigen Lauf des Kandidaten selbst, er schafft es nicht, den aktuellen Produktions-Baseline zu schlagen, oder mehr als ein definierter Prozentsatz der 200 Fragen fällt unter den Schwellenwert pro Frage. Ein Kandidat muss alle drei erfüllen, was erfasst, was ein einfacher Durchschnitt verbergen kann: Ein Modell, das den Mittelwert verbessert, während es stillschweigend einen größeren Anteil einzelner Fragen nicht besteht, kommt nicht durch.
Ein Beispiel dafür, was dies erkennt. Hier testet das Mocking das eigene Reasoning des Agenten, nicht nur die Tools darunter. Unser Golden-Set enthält einen Fall mit Hierarchie-Konflikt: Der Customer Insights Agent und der Data Insights Agent geben für denselben Kunden unterschiedliche, jeweils für sich korrekte Umsatzzahlen zurück, eine auf das Elternkonto, die andere auf eine Tochtergesellschaft bezogen. Keine der Zahlen ist falsch. Der Fall testet, ob der Agent den richtigen Geltungsbereich aus der Semantik der Abfrage und der Persona des Anfragenden ableitet (ein Verkäufer will wahrscheinlich die Tochtergesellschaft, während eine Führungsebenen-Abfrage wahrscheinlich das konsolidierte Elternergebnis will), statt standardmäßig einen Wert zu wählen, zu mitteln oder den Verkäufer zu bitten, zu unterscheiden. Der Kandidat scheiterte und lieferte die Zahl auf Elternebene für eine Frage mit Tochtergesellschaft-Bezug. Die Ground Truth des Golden-Sets für diesen Fall legt fest, welchen Geltungsbereich die Frage erwartet, sodass das Quality Gate den Konflikt sofort markierte: keine falsche Zahl, sondern die richtige Zahl für den falschen Geltungsbereich.
Stage 5: Der Canary. Stille Fehler nach dem Deployment erkennen
Stage 5 ist ein Post-Production-Monitor. Er läuft kontinuierlich in der Produktionsumgebung gegen Live-Traffic und synthetische Evaluierungsfälle, und seine Aufgabe ist es, Probleme zu erkennen, die kein Code-Change ausgelöst hat und die Stage 3 daher nicht gesehen hat. Stage 3 schützt vor dem, was Ingenieure ändern. Stage 5 schützt vor allem anderen – wie Upstream-Datenverschiebungen, sich veränderndem Modellverhalten, Änderungen an Drittanbieter-Abhängigkeiten oder anderen Bedingungen wie erhöhter Latenz oder sich verschiebenden Traffic-Mustern, die sich nur unter realer Last zeigen.
Das Produkt arbeitet gegen einen Datenbestand, der von tausenden Upstream-Schemas und Datenpipelines gespeist wird. An einem gegebenen Tag aktualisieren sich Dutzende dieser Pipelines, ohne ein Deployment oder ein CI-Gate auszulösen. Der Agent-Code bleibt unverändert, das Modell bleibt unverändert, aber die Daten, über die es reasoning betreibt, haben sich geändert, und die Qualität kann dadurch stillschweigend abnehmen. Das haben wir auf die harte Tour gelernt: eine Upstream-Pipeline wurde mit einer Schema-Änderung aktualisiert, der Agent begann, Daten aus dem falschen Zeitfenster zu zitieren, und das erste Signal kam über eine Verkäuferanfrage statt über einen automatisierten Alarm. Stage 5 ist die Methode, mit der wir dies stattdessen bereits im ersten 30-minütigen Evaluationsfenster erkennen.
Wir führen AgentCore Batch Evaluation nach zwei komplementären Zeitplänen durch, und die Wahl der Kadenz war bewusst getroffen.
Wir haben uns nach Erkenntnissen in beide Richtungen auf 30-minütige Zyklen geeinigt: 15 Minuten erzeugten zu viele Fehlalarme; bei 60 Minuten vergingen zwei Stunden, bevor eine echte Verschlechterung registriert wurde. Wir bezeichnen jeden 30-minütigen Zyklus als Evaluationsfenster. Dreißig Minuten erkennen einen echten Trend innerhalb von 90 Minuten (drei aufeinanderfolgende Fenster) und filtern zugleich Einzelabfrage-Rauschen heraus. Jedes Fenster bewertet eine Round-Robin-Auswahl aus dem Golden Set, womit eine vollständige Abdeckung innerhalb von 24 Stunden erreicht wird.
Die Schwellenwerte liegen bewusst niedriger als die CI/CD-Gates. Ein einzelnes fehlerhaftes Fenster ist ein Ops-Signal, kein Vorfall. Wir benachrichtigen oncall erst, wenn drei aufeinanderfolgende Fenster den Schwellenwert überschreiten. Diese Regel haben wir auf die harte Tour gelernt: Im ersten Monat mit einem Einzelfenster-Schwellenwert verlor oncall das Vertrauen in das System vollständig. Einmal pro Tag läuft das vollständige Golden Set mit Gate-Schwellenwerten als maßgebliche Tagesbewertung. Die 30-minütigen Fenster zeigen den Trend auf. Der tägliche Lauf bestätigt ihn und erstellt ein Ticket.
Jeder Lauf veröffentlicht Metriken in CloudWatch (Genauigkeit, Halluzinationsraten, Grounding-Rate, Latenz und Kosten), mit Alarmlogik, die zwischen den beiden Kadenzarten unterscheidet. Der Canary läuft auf drei Ebenen: Tool-level-Scores decken ein verschlechtertes Retrieval-Tool auf, bevor es Antworten auf Agent-Ebene verfälscht.
Ein weiteres Beispiel dafür, was dies aufdeckt. Nach einer Upstream-Aktualisierung eines Index begann ein Retrieval-Tool, nur lose relevante Chunks statt des präzisen Kontexts zurückzugeben, der zur Beantwortung der Abfrage benötigt wurde. Die Latenz war nominal. Die Fehlerrate war null. Der Agent produzierte weiterhin flüssige, überzeugende Antworten, indem er über schwach fundierten Kontext reasoning betrieb, und lieferte Antworten, die korrekt aussahen, aber die falschen Zahlen zitierten. Es gab keinen Infrastruktur-Alarm. Der Canary erkannte es im ersten 30-minütigen Fenster: Grounding-Rate und Retrieval-Präzision sanken beim Tool-level-Sentinel, was einen CloudWatch-Alarm auslöste, bevor Verkäufer auf die verschlechterten Antworten reagierten. Der niedrige Evaluator-Score markierte genau den Trace, der dafür verantwortlich war. Von dort aus öffnete der On-Call-Ingenieur diesen Trace in AgentCore und verfolgte den verschlechterten Kontext innerhalb von Minuten zum Retrieval-Tool zurück.
Stage 6: The Adversary. Schutz vor Missbrauch
Nicht jede schlechte Ausgabe stammt von einem verschlechterten Modell. Abfragen, die darauf abzielen, unbefugt Kontodaten zu extrahieren, und Prompt Injections, die in abgerufenen Dokumenten eingebettet sind, sind vorhersehbare Muster in einem System, das tausenden Nutzern Zugriff auf sensible Geschäftsdaten bietet.
Sicherheit ist keine Stage. Sie durchzieht alle neun Stages. Wir setzen Amazon Bedrock Guardrails an zwei Punkten in jeder Interaktion ein. Am Eingang validieren wir den Abfrageumfang und prüfen auf Prompt Injection. Am Ausgang verifizieren wir, dass keine sensiblen Daten an unbefugte Nutzer gelangen und dass der Agent nicht zu einer Richtlinienverletzung manipuliert wurde. Diese Prüfungen laufen bei 100 Prozent des Datenverkehrs, synchron, bevor eine Antwort den Nutzer erreicht.
Wir konfigurieren zwei Guardrail-Ebenen, die jeweils eine eigene Bedrohungsklasse abdecken:
Inhaltsfilter erkennen und blockieren schädliche oder unangemessene Inhalte sowohl in Eingaben als auch in Ausgaben. Wir erzwingen Filter über Kategorien hinweg, einschließlich VIOLENCE, HATE, SEXUAL, MISCONDUCT, und INSULTS. Eine Anfrage oder Antwort, die diese Filter auslöst, wird blockiert, bevor sie den Verkäufer erreicht oder dem Nutzer angezeigt wird.
Prompt-Sicherheitsfilter schützen den Agenten vor adversarialer Manipulation innerhalb einer einzigen PROMPT_ATTACK Guardrail-Kategorie, die drei Subtypen abdeckt: JAILBREAK (Versuche, die Systemanweisungen des Agenten zu überschreiben oder seine operativen Grenzen zu umgehen), PROMPT_INJECTION (unbeabsichtigte Anweisungen, die in abgerufenen Dokumenten, Tool-Ausgaben oder Nutzerabfragen eingebettet sind) und PROMPT_LEAKAGE (Versuche, den System-Prompt oder die interne Konfiguration zu extrahieren). In einem Multi-Agenten-System, das Retrieval Augmented Generation (RAG) verwendet, ist Prompt Injection durch abgerufene Inhalte ein echtes Risiko. Ein unbeabsichtigtes Dokument in den Kontodaten eines Verkäufers könnte versuchen, das Verhalten des Agenten während des Reasoning umzuleiten.
Sicherheitsregeln werden in Stage 1 definiert, in den Stages 3 und 4 auf Regressionen geprüft und in der Produktion kontinuierlich durchgesetzt.
Stage 7: The Drift. Qualität aufrechterhalten und mit echtem Datenverkehr validieren
Die Qualität verschlechtert sich aus mehreren Richtungen: Upstream-Daten ändern sich, ohne ein Deployment auszulösen, Modelle veralten, und Nutzer testen die Grenzen mit Abfragen, die kein Golden Set vollständig antizipiert. Stage 7 erkennt dies, bevor die Verkäufer es tun, und validiert Kandidaten vor dem vollständigen Rollout gegen echten Nutzerverkehr.
Drift-Erkennung. Mit AgentCore Online Evaluation stichprobenartig erfassen wir kontinuierlich 10 Prozent des Live-Verkehrs durch die verschiedenen in Stage 1 definierten Evaluator, sodass der Drift sofort als Abweichung von den offline ermittelten Baselines sichtbar wird. Die Scores fließen in einen Quality-State Calculator ein, der Qualität, Latenz und Kosten im selben Zeitfenster überwacht.
Ein Produktionsbeispiel. Unser Golden Set zur Kundenidentifikation wurde aus synthetischen Randfällen aufgebaut: Namensvarianten, Tochtergesellschaft-Suchen, Abkürzungen. Es performte offline gut. Aber im Live-Verkehr fragten Verkäufer mit Börsentickersymbolen („was ist los mit AMZN?“), Kurznamen und Tippfehlern ab, die die synthetischen Fälle nicht abdeckten. Der Quality-State Calculator machte die Drift über drei aufeinanderfolgende 30-Minuten-Fenster sichtbar: 98 Prozent um 1:30 Uhr, 81 Prozent um 2:00 Uhr, 80 Prozent um 2:30 Uhr. CloudWatch benachrichtigte den Bereitschaftsdienst, sobald der rollierende Schwellenwert überschritten wurde. Der Bereitschaftsingenieur befragte den Agenten: „Was ist mit der Genauigkeit der Kundenidentifikation zwischen 1 Uhr und 3 Uhr passiert?“ und erhielt eine Trendzusammenfassung, die Tickersymbol-Suchen und Kurznamen als Ursache der Fehler identifizierte. Die Trace des Agenten machte die Grundursache sofort sichtbar. Die Lösung: das Golden Set um die schwach bewerteten Live-Sitzungen erweitern und das Disambiguierungswerkzeug aktualisieren, um Eingabeformate vor der Auflösung zu normalisieren. Die Genauigkeit erreichte im nächsten Bewertungszyklus wieder den Baseline-Wert.
Der Live-Verkehr speist zwei kontinuierliche Verbesserungsschleifen: schwach bewertete Sitzungen werden als neue Randfälle in das Golden Set übernommen, und Cluster schwach bewerteter Traces informieren Prompt-Revisionen, Tool-Updates und Routing-Anpassungen.
A/B-Tests: Nachdem ein Kandidat eine Qualitätsprüfung bestanden hat, routet der AgentCore Gateway, eine Funktion von Amazon Bedrock AgentCore, einen Teil des echten Verkehrs zwischen dem aktuellen und dem Kandidaten-Agenten. On-demand bestätigt, dass es keine Regression bei bekannten Fällen gibt. Online bestätigt, dass er gegen die Long-Tail-Eingaben und neuartigen Formulierungen standhält, die nur echte Nutzer hervorbringen. Ein Kandidat muss über alle Evaluator-Dimensionen hinweg gewinnen oder unentschieden spielen, bevor er vollständig ausgerollt wird.
Stufe 8: Der Puls. Echtzeit-Sichtbarkeit der Qualität
Ein einzelner Aufruf eines Agenten kann drei Sub-Agenten, fünf Tools und zwei Retrieval-Pfade berühren. Wenn ein Qualitätsalarm ausgelöst wird, ist „etwas in der Agenten-Pipeline“ kein Runbook. Stufe 8 ist der Ort, an dem die Signale aus den Stufen 5, 6 und 7 in einer Observability-Schicht mit ausreichender Auflösung zusammenlaufen, um handeln zu können.
AgentCore Observability, eine Funktion von Amazon Bedrock AgentCore, ist die Grundlage. Für Agenten, die auf der AgentCore runtime gehostet werden, einer Funktion von Amazon Bedrock AgentCore, wird jede Ausführung automatisch über OpenTelemetry instrumentiert, wobei strukturierte Telemetrie für jeden Reasoning-Schritt ausgegeben wird: aufgerufene Tools, Reihenfolge, Ein- und Ausgaben, Latenz und Token-Verbrauch, veröffentlicht direkt in CloudWatch als benutzerdefinierte Metriken und Logs, nachdem CloudWatch Transaction Search aktiviert wurde (ein einmaliger Einrichtungsschritt). Evaluator-Scores sind eine separate Pipeline: Sie stammen aus Evaluierungskonfigurationen, nicht aus der Ausführungsinstrumentierung, und landen in einer eigenen CloudWatch-Log-Gruppe. Jeder Evaluierungslauf speichert auch seine vollständigen Ausgaben in S3 und unserem Data Lake und speist zwei Dashboards:
- Ein konversationelles Dashboard zur Abfrage von Evaluierungs- und Observability-Ergebnissen.
- Ein Amazon Quick Dashboard für Trendanalyse, Scorecard-Verfolgung und agentenübergreifende Vergleiche über den gesamten Verlauf.
Rollenangepasste Ansichten sitzen darüber. Bereitschaftsingenieure erhalten eine Trace-first-Ansicht: ein Klick von einem CloudWatch-Alarm zur AgentCore Observability-Trace, die ihn ausgelöst hat. Die Trace zeigt jedes aufgerufene Tool, in welcher Reihenfolge, mit Latenz pro Schritt, Token-Verbrauch, Kosten und den vollständigen Reasoning-Kontext: alles, was nötig ist, um von „Alarm ausgelöst“ zu „Grundursache identifiziert“ zu gelangen, ohne ein zweites Tool öffnen zu müssen, wie in Abbildung 5 gezeigt.
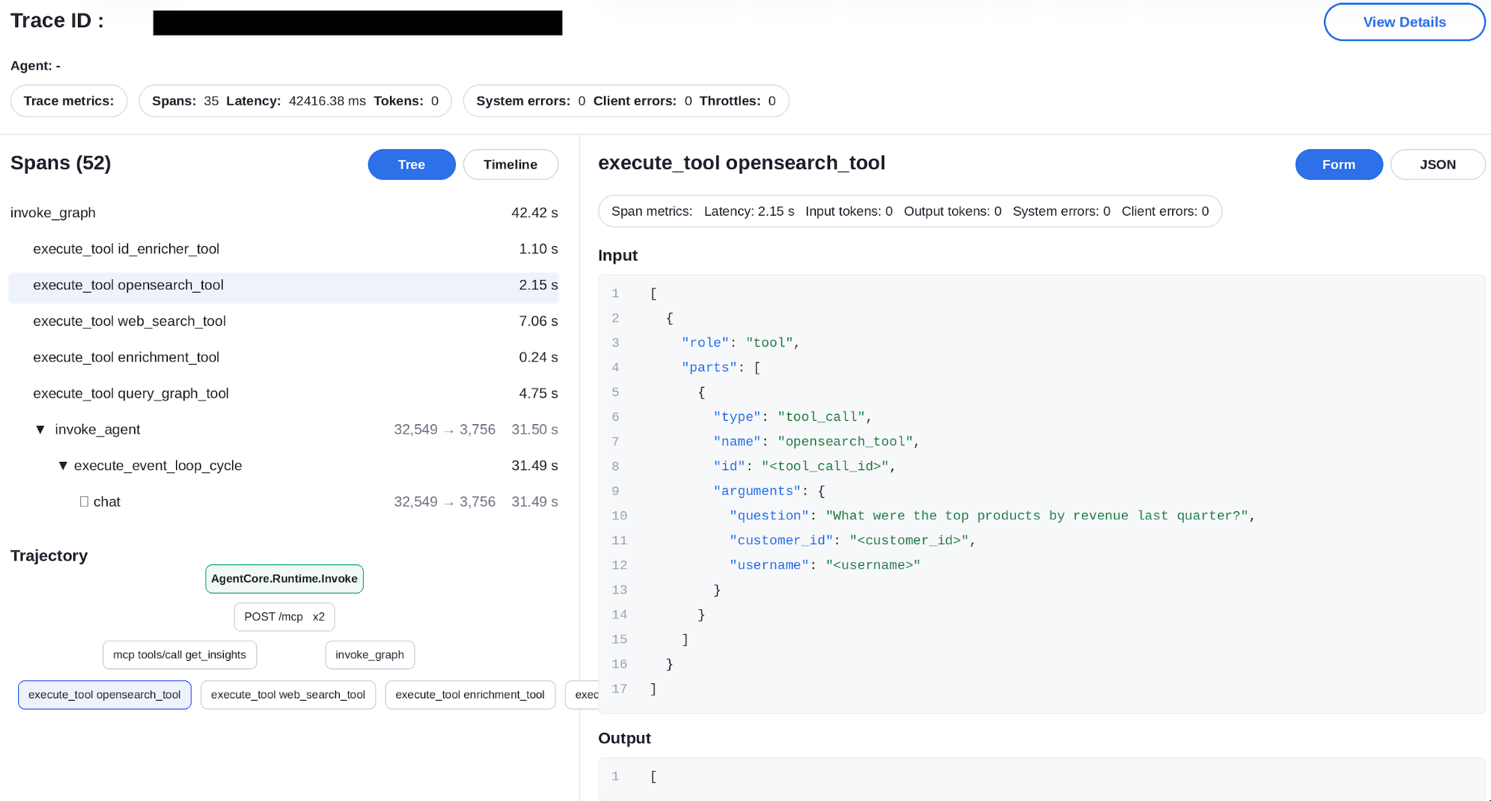
Abbildung 5: AgentCore-Ausführungs-Trace für den Customer Insights Agent, mit Span-Baum, Trajektorie und Span-Level-Metriken. Die Zahlen und Werte in der Abbildung sind illustrativ.
Produktmanager erhalten Amazon Quick Trend-Dashboards: Qualitäts-Scores nach Sub-Agent und Feature, Release über Release. Die Führungsebene erhält eine einseitige Zusammenfassung des Zustands, ausgerichtet auf wöchentliche und unternehmensübergreifende Reviews über alle fünf Dimensionen, ein einminütiger kurzer Check, der die Frage „wie performen unsere Agenten?“ beantwortet.
Abbildung 6 zeigt die Top-Level-Ansicht unseres wöchentlichen Evaluierungs-Dashboards: eine kombinierte Bestehensquote aus sowohl benutzerdefinierten Evaluatoren als auch AgentCore integrierten Evaluatoren, neben der Latenz, für den Wochenlauf. Die Zahlen und Werte in der Abbildung sind illustrativ.
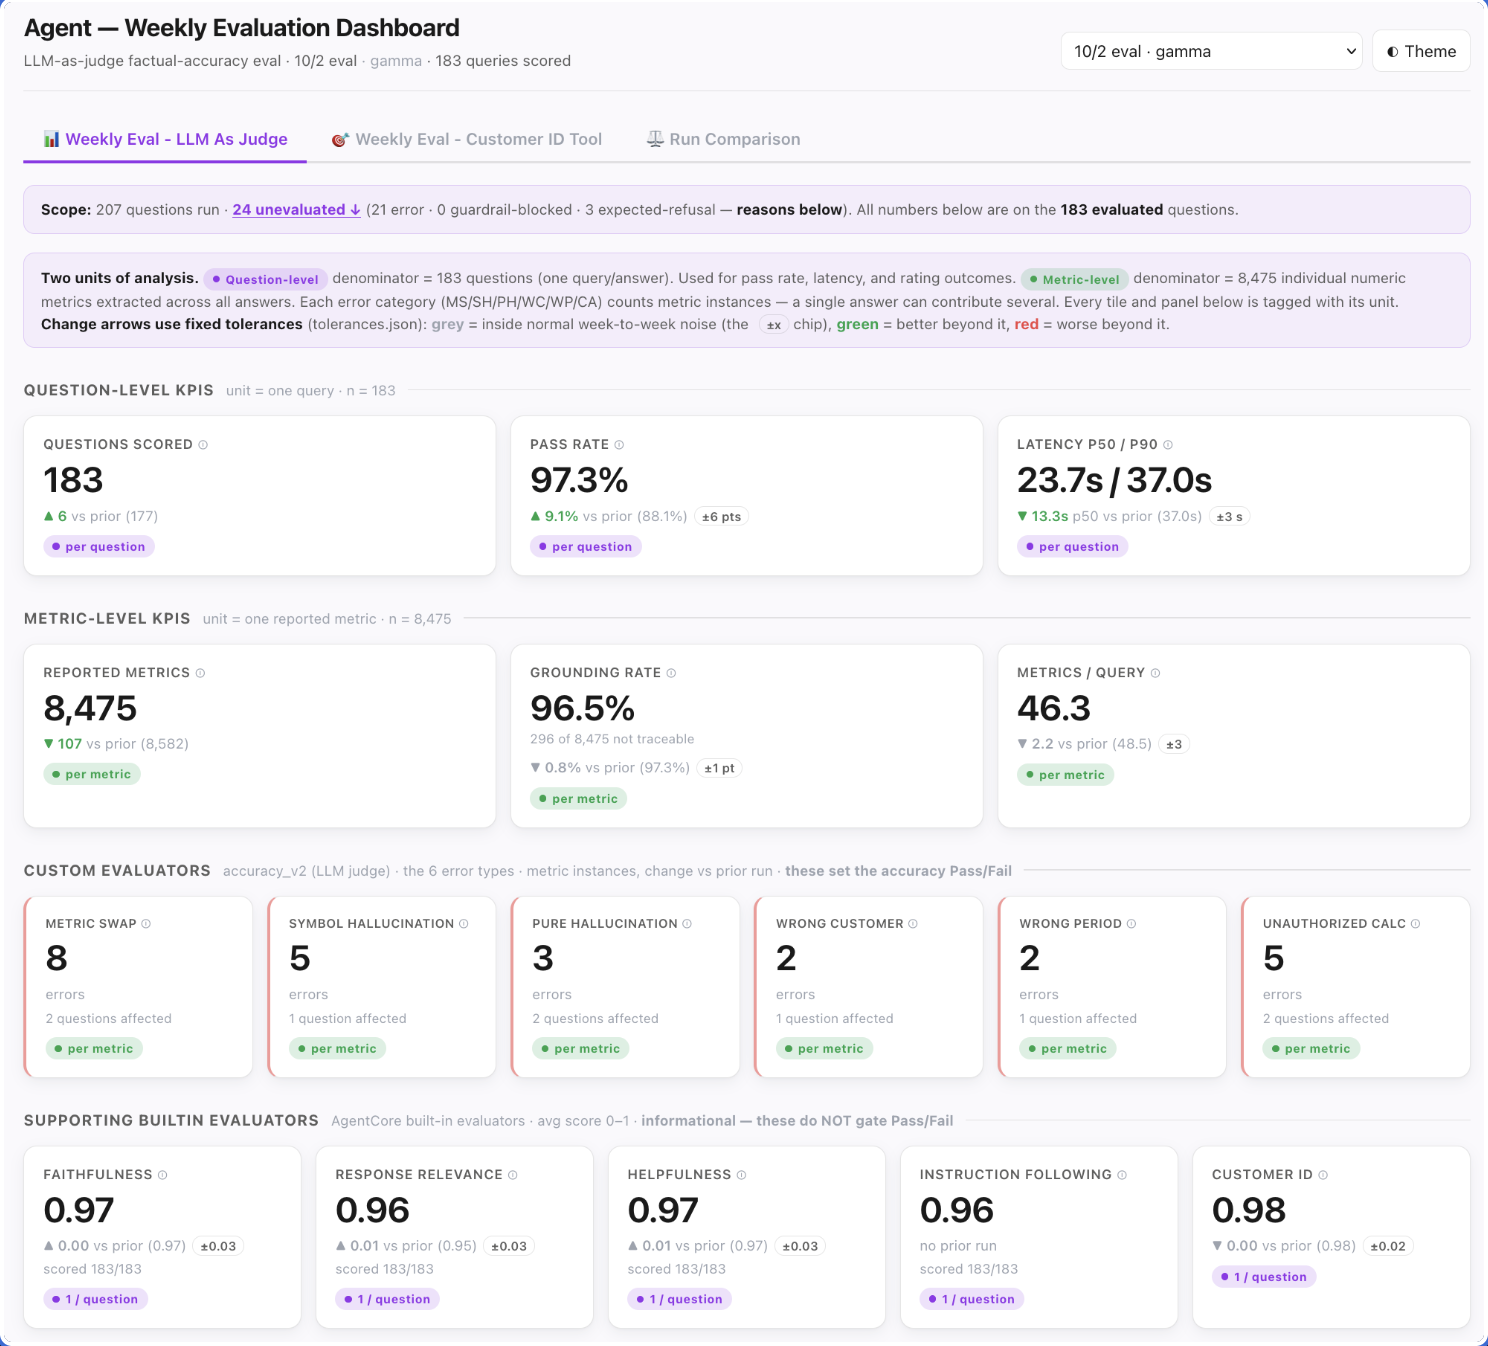
Abbildung 6: Top-Level wöchentliches Evaluierungs-Dashboard mit kombinierter Bestehensquote und Latenz. Die Zahlen und Werte in der Abbildung sind illustrativ.
Abbildung 7 bohrt sich in denselben Lauf auf der Ebene der benutzerdefinierten Evaluatoren und Fehlerkategorien hinein und zeigt genau, welche Fehlertypen (Metrik-Vertauschungen, Halluzinationen, verfehlte Kunden-IDs und andere) die Lücke verursachen und wie viele Fragen jede davon betrifft. Die Zahlen und Werte in der Abbildung sind illustrativ.
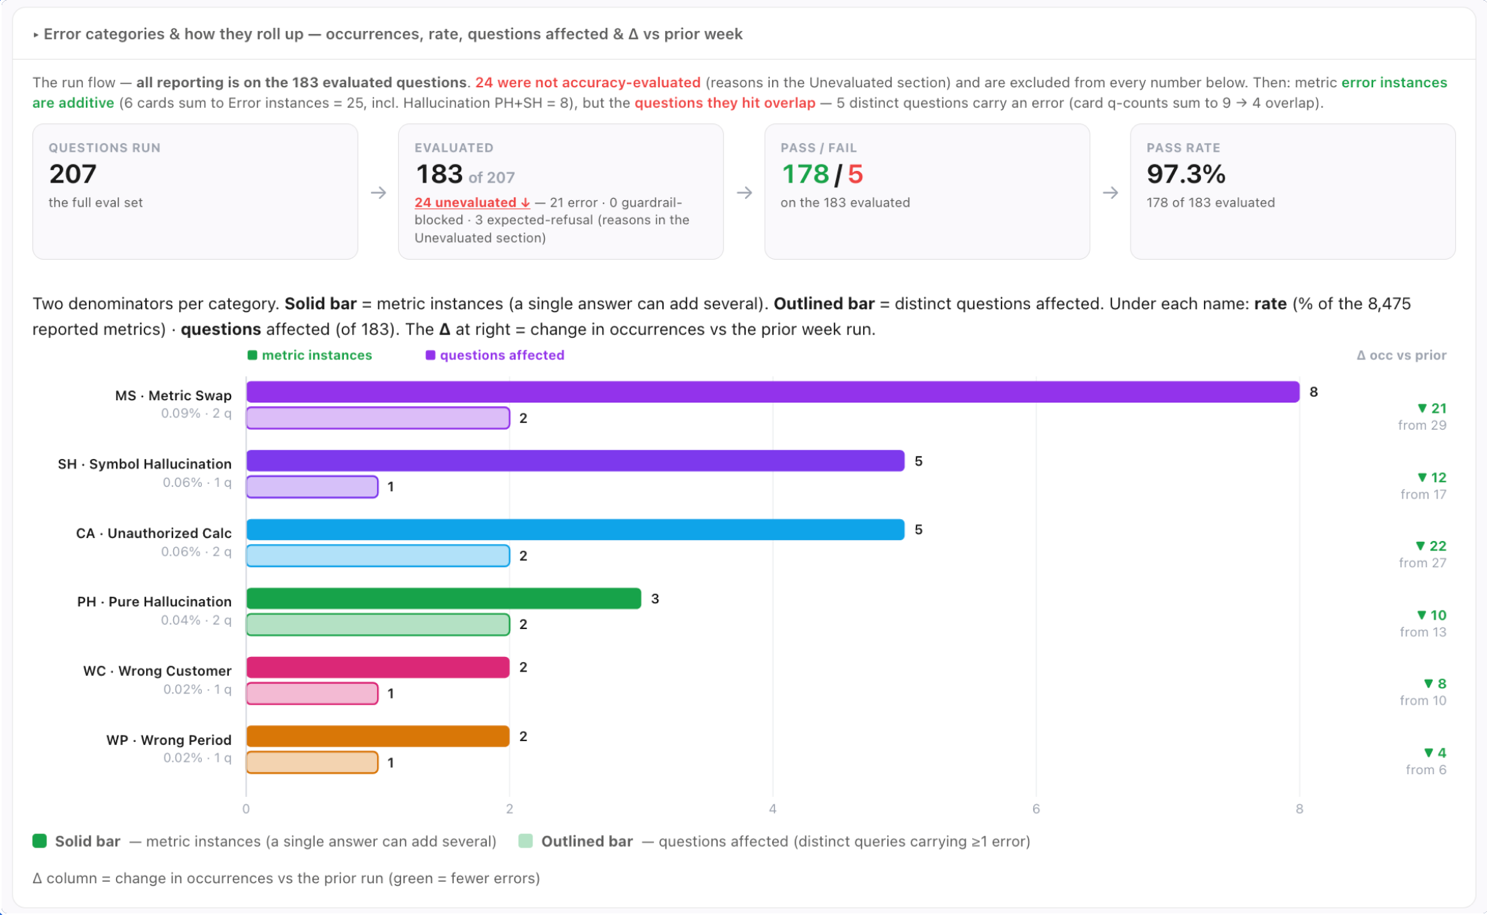
Abbildung 7: Wöchentliches Fehlerbericht-Dashboard, das Fehler nach Kategorie aufschlüsselt. Die Zahlen und Werte in der Abbildung sind illustrativ.
Vor Stufe 8 lag die mittlere Zeit zur Erkennung (MTTD) bei Tagen bis Wochen. Nach Stufe 8 liegt sie unter vier Stunden, und das erste Signal ist ein CloudWatch-Alarm mit einer angehängten AgentCore-Trace.
Stufe 9: Die Feedback-Schleife. Kontinuierliche Verbesserung
Diese Stufe macht aus Beobachtungen Aktionen. Das System steigert die Qualität im Laufe der Zeit. Wir verwenden AgentCore optimization, eine Funktion von Amazon Bedrock AgentCore, um die Schleife zu schließen.
- System-Prompt-Empfehlung: Analysiert Agenten-Traces und generiert einen datengetriebenen, optimierten System-Prompt, der die Leistung beim Ziel-Evaluator verbessert. Die Lösung nutzt Fehlermuster und fügt spezifische Verhaltensanweisungen hinzu.
- Tool-Beschreibungs-Empfehlung: Analysiert Agenten-Traces und generiert geschärfte Tool-Beschreibungen, die Verwirrung bei der Tool-Auswahl reduzieren. Besonders wenn ein Agent für mehrdeutige Anfragen das falsche Tool auswählt.
Sehen wir uns ein Beispiel an:
AgentCore optimization in Aktion
Was soll verbessert werden:
Ziel-Evaluator: hallucination: Modell reproduziert fest codierte Werte aus Few-Shot-Beispielen wörtlich in nicht zusammenhängenden Kontexten.Warum das passiert ist: Few-shot-Beispiele enthalten echte Dollarbeträge und Kundennamen (zum Beispiel „$4.2M“, „Acme Corp“), die das Modell auswendig lernt und in nicht zusammenhängende Anfragen einschleust.
So wurde es behoben: Hartkodierte Werte in Few-shot-Beispielen wurden durch generische Platzhalter ersetzt (zum Beispiel
$[AMOUNT],[CUSTOMER_NAME]), damit das Modell die Antwortstruktur lernt, ohne sich auf spezifische Datenpunkte einzuprägen.Auswirkung und Ergebnis: Fix angewendet. Reine Halluzinationen gingen von 138 auf unter 52 pro 10,000 Antworten zurück, und die allgemeine Grounding-Rate verbesserte sich von 93 Prozent auf 96 Prozent.
Die AgentCore-Optimierung nutzt Empfehlungen, um datengestützte Änderungen an System-Prompts und Tool-Beschreibungen auf Basis echter Agent-Traces und eines Ziel-Evaluators zu erzeugen. Die AgentCore-Optimierung baut auf AgentCore Evaluations auf. Traces mit niedrigen Bewertungen werden als permanente Regressionswächter in den Golden Set überführt, damit jeder Fehler die Nutzer nicht zweimal erreicht.
Kennzahlen der Agent-Evaluation auf einen Blick
Die Evaluationsmetriken werden in Stage 1 definiert, über die neun Stufen hinweg durchgesetzt und in der Produktion kontinuierlich überwacht. Dieser Satz ist nicht statisch. Während wir vom Agenten in der Produktion lernen, treten neue Fehlermuster auf, neue Dimensionen werden messbar, und die Metriken entwickeln sich entsprechend weiter. Nachfolgend steht, womit wir begonnen haben und was wir heute verfolgen.
| Ebene | Metrik | Was gemessen wird | Erfasst als |
| Qualität: Agent | Gesamte Bestehensquote der Genauigkeit | % der Antworten ohne Taxonomiefehler | Zentrale Scorecard-Metrik |
| Qualität: Agent | Metrik-Verwechslungsrate | Richtiger Kunde und richtiger Zeitraum, falsche zurückgegebene Metrik | Vorkommnisse pro 100 Antworten |
| Qualität: Agent | Falscher-Zeitraum-Rate | Daten aus dem falschen Zeitfenster | % mit Nennung des korrekten Zeitfensters |
| Qualität: Agent | Falscher-Kunde-Rate | Verwechselte Kontonamen oder Tochtergesellschaften | Genauigkeit der Entity-Auflösung % |
| Qualität: Agent | Grounding-Quote | Zahlen, die auf eine abgerufene Quelle zurückführbar sind | % der berichteten Zahlen mit Fundstelle belegt |
| Qualität: Agent | Einhaltungsrate des Umfangs | Antworten, die die gestellte Frage beantworten | % themenrelevanten Antworten |
| Qualität: Agent | Nicht autorisierte Berechnungsrate | Nicht sanktionierte abgeleitete Zahlen | Vorkommen pro 100 Antworten |
| Qualität: Agent | Relevanz / Treue / Hilfsbereitschaft | Antwortqualität über die integrierten AgentCore-Dimensionen | Integrierter AgentCore-Evaluatorscore (0–1) |
| Qualität: Tool | Genauigkeit der Kundenidentifikation | Tool löst auf die exakte kanonische Entität auf | % korrekter Auflösungen (deterministisch) |
| Qualität: Tool | Genauigkeit der Tool-Auswahl | Agent wählt das richtige Tool für die Anfrage | Integrierter AgentCore-Evaluatorscore (0–1) |
| Qualität: Tool | Abrufpräzision | Abgerufener Kontext enthält die benötigten Informationen | % Abrufe mit relevantem Kontext |
| Qualität: Tool | Genauigkeit der SQL-Generierung | Data Insights Agent generiert korrektes SQL | % korrekter Ergebnissätze (deterministisch) |
| Qualität: Tool | Tool-Erfolgsquote | % der Tool-Aufrufe mit gültiger Antwort | % Erfolg pro Tool |
| Qualität: Multi-Agent | End-to-End-Genauigkeits-Erfolgsquote | Vollständiger Orchestrierungspfad erzeugt eine korrekte Antwort | % der Szenarien, die alle Evaluatoren bestehen |
| Qualität: Multi-Agent | Routing-Genauigkeit | Orchestrator leitet an die richtigen Sub-Agenten weiter | % korrektes Routing (deterministisch) |
| Qualität: Multi-Agent | Synthese-Treue | Sub-Agent-Ausgaben werden ohne Verzerrung kombiniert | LLM-as-judge-Score über Agentengrenzen hinweg |
| Qualität: Multi-Agent | Kontextweitergabe-Genauigkeit | Zwischen Agenten übergebener Kontext ist korrekt und vollständig | % der Traces ohne Kontextverlust |
| Sicherheit | Guardrail-Blockierungsrate | % der Anfragen, die am Eingang oder Ausgang blockiert werden | Pro 1,000 Anfragen |
| Sicherheit | Verletzungsrate Eingang / Ausgang | % der Abfragen oder Antworten, die als Richtlinienverstoß markiert werden | % der Gesamtanfragen / -antworten |
| Sicherheit | Guardrail-Latenz | Von Guardrail-Prüfungen verursachter Latenz-Overhead | p99 (Ziel: unter 50ms) |
| Leistung | End-to-End-Latenz | Vom Erhalt der Abfrage bis zur Auslieferung der Antwort | p50, p90, p99 |
| Leistung | Latenz pro Sub-Agent / Tool | Pro Sub-Agent und pro Tool-Ausführung | p50, p90, p99 unabhängig voneinander |
| Leistung | Latenz-Regressionsrate | CI-Läufe, die den Stage-1-Latenzschwellenwert überschreiten | % der CI-Läufe |
| Kosten | Kosten pro Abfrage | Gesamte Token-Kosten pro End-to-End-Benutzeranfrage | Input- + Output-Tokens × Preis |
| Kosten | Kosten pro erfolgreicher Antwort | Kosten pro Abfrage geteilt durch die Pass-Rate | Bestraft teure Fehlschläge |
| Kosten | Durchschn. Tool-Aufrufe pro Abfrage | Reasoning-Effizienz. Steigende Aufrufzahlen signalisieren eine Verschlechterung | Durchschnitt pro Abfrage |
| Ops-Kontrolle | MTTD / MTTR | Zeit bis zur Erkennung und Behebung, pro Fehlerklasse | Stunden (MTTD-Ziel: unter 4h) |
| Ops-Kontrolle | Automations-Erkennungsrate | Durch Evaluation erkannte Vorfälle im Vergleich zu Benutzerbeschwerden | % (Ziel: über 95%) |
| Ops-Kontrolle | Fehlalarmrate | Alarme, die keiner realen Verschlechterung entsprechen | % aller Alarme |
Fazit
Die Wirkung des neunstufigen Agent-Evaluation-Frameworks war konkret und messbar. Qualitätsregressionen, die zuvor Tage oder Wochen brauchten, um sichtbar zu werden, und meist durch eine Verkäuferbeschwerde bekannt wurden, werden jetzt in weniger als vier Stunden durch automatisierte Evaluation erkannt. Deployment-Entscheidungen, die einst auf subjektivem Urteil beruhten, erfordern nun, dass jeder Evaluator einen quantitativen Schwellenwert erfüllt. Prompt-Iterationszyklen sanken von Tagen auf Minuten. Sicherheit wechselte von periodischen Audits zu einer Guardrail-Abdeckung von 100 Prozent bei jeder Anfrage. Latenz-Regressionen werden an der CI-Schwelle erkannt, bevor sie in die Produktion gelangen. Kosteneffekte, die früher erst Wochen später in der Abrechnung auftauchten, werden jetzt in Stage two bewertet und vom Quality Gate erzwungen, bevor eine Änderung ausgeliefert wird. Und aus „irgendetwas im Agent-Pipeline-Verlauf“ wurde ein einziger Klick von einem CloudWatch-Alarm zu einer vollständigen Agent-Execution-Trace mit jedem sichtbaren Reasoning-Schritt.
Die übergeordnete Lektion ist eine, die die Branche bereits gelernt hat. DevOps hat uns gelehrt, dass das Ausliefern von Code ohne automatisierte Tests leichtsinnig ist. MLOps hat uns gelehrt, dass das Bereitstellen von Modellen ohne Monitoring gefährlich ist. AgentOps lehrt uns dasselbe über KI-Agenten: Sie ohne kontinuierliche, mehrstufige Evaluation zu betreiben, bedeutet, blind zu fliegen.
Das hier beschriebene neunstufige Framework ist nicht spezifisch für Sales-Intelligence-Agenten. Teams, die Multi-Agenten-Systeme einsetzen, die_reasoning durchführen, Sub-Agenten und Tools aufrufen und Antworten synthetisieren, werden sich denselben Fragen über denselben Lebenszyklus stellen. Ihre Fehler-Taxonomie wird anders aussehen. Ihr Golden Set wird Ihre Domäne widerspiegeln. Ihr Evaluator-Stack wird auf Ihre Nutzer abgestimmt sein. Konstant bleibt das Prinzip: Evaluation ist kein abschließender QA-Schritt. Sie ist das Betriebssystem des Agenten selbst, kontinuierlich gemessen, automatisch abgesichert und mit jeder Interaktion verbessert.
Wenn Sie Produktions-Agenten entwickeln und diese Art von Evaluationsdisziplin in Ihr System bringen möchten, bietet Ihnen Amazon Bedrock AgentCore Evaluations die Plattform dafür: On-Demand-Evaluation für Experimente, Batch-Evaluation für kontinuierliches Monitoring, Online-Evaluation für Live-Traffic, integrierte und benutzerdefinierte Evaluator(en), Dataset-Evaluation (in der öffentlichen Vorschau), CloudWatch-Integration sowie die AgentCore-Optimierungsfunktionen Empfehlungen und A/B-Tests, um die Feedback-Schleife zu schließen. Beginnen Sie mit Stufe eins, definieren Sie, was „gut“ für Ihren Agenten bedeutet, und lassen Sie das Framework den Rest erledigen.
Bereit loszulegen? Siehe Evaluate agent performance in der Amazon-Bedrock-AgentCore-Dokumentation. Und wenn Sie Produktions-Agenten entwickeln und besprechen möchten, wie Sie dieses Framework auf Ihr System anwenden können, helfen wir Ihnen gerne weiter. Wenden Sie sich direkt an uns oder über Ihr AWS-Account-Team.
Um mehr über Amazon Bedrock AgentCore Evaluations zu erfahren, siehe Evaluate agent performance in der AWS-Dokumentation. Für eine technische Einführung lesen Sie Build reliable AI agents with AgentCore Evaluations. Um zu sehen, wie wir den Performance Insights Agent gebaut haben, lesen Sie Wie AWS SMGS mit einem KI-gestützten Konversationsassistenten und Amazon Bedrock AgentCore das Geschäftsmanagement transformiert. Um mehr über AgentCore-Empfehlungen und -Optimierung zu erfahren, lesen Sie AgentCore-Optimierung: Verbesserung der Agenten-Qualitätsschleife mit Empfehlungen und A/B-Tests
Danksagung
Wir danken unseren Führungskräfte-Sponsoren und Mentoren aufrichtig, deren Vision und Anleitung diese Initiative ermöglicht haben: Damien Forthomme, Manager III, Applied Science; Akhand Singh, Head of Data Engineering; Sujit Narapareddy, Director AWS Insights; Monica Jain, Sr. Product Manager – Tech, und Norman Braddock, Senior Manager of AI Product Management bei AWS; Muhammad Umar Javed, Applied Scientist III, L6.