
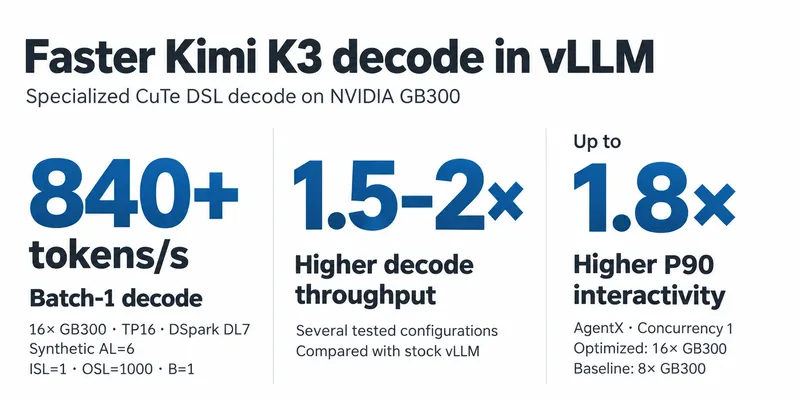
Die Codieragenten können nun bei einigen der schwierigsten Aspekte der Modelloptimierung helfen: die Erstellung komplexer GPU-Kerne, die Durchführung von Kombinationen zwischen verschiedenen Operatorn, die Überlaufung von Berechnungen mit Kommunikation sowie die Anpassung der Ausführung unter unterschiedlichen Batch-Größen und GPU-Konfigurationen. Für Kimi K3 verwendeten wir agentunterstützte Entwicklung, um eine einheitliche CuTe-DSL-Dekodierroute auf dem NVIDIA GB300 zu bauen, die Aufmerksamkeit, MoE und Kommunikation über 8 oder 16 GPUs abdeckt. Die Optimierungen liefern mehr als 840 Tokens/s beim Batch 1 auf 16 NVIDIA GB300-GPUs mit DSpark (synthetischer AL=6), eine 1,5–2× höherere Dekodierleistung in mehreren getesteten Konfigurationen und bis zu 1,8× höherere P90-Interaktivität bei der AgentX-Arbeitslast.
Der agentoptimierte Inferenzcode übertrifft unseren Überprüfungs- und Wartungsprozess. Der manuelle Überprüfungsprozess, bei dem jede Zeile jedes Kernels verstanden wird, potenzielle Probleme identifiziert werden und jede unterstützte Konfiguration getestet wird, ist eine sehr zeitaufwändige Arbeit. Andererseits besteht die Gefahr, dass wir fehlerhaftes Softwarematerial liefern, das in der Produktion fehlschlägt.
Es gibt eine klare Linie für die Erreichung beider Ziele: Wir müssen den Ablauf der Leistungsarbeit verändern. Neben der agentischen Optimierung müssen wir Systeme entwerfen, die die automatische Überprüfung von Zuverlässigkeit und Leistung ermöglichen, und wir müssen das Softwaredesign so gestalten, dass Isolation und Risikominimierung von Anfang an gewährleistet sind.
Der vorgeschlagene Fast-Track-Modell-Optimierung-RFC bildet eine Grundlage für diese Herangehensweise. Unser Leitprinzip ist es, die Überprüfungsbelastung zu reduzieren, während das Risiko verwaltet wird. Um dies zu erreichen, tun wir Folgendes:
- Isolieren Sie die Änderungen. Halten Sie die Optimierungen im Code des Modells.
- Begrenzen Sie den Bereich und bewahren Sie die Kernfunktionen. Definieren Sie das unterstützte Hardware- und Arbeitslastmodell, aber bewahren Sie die unverzichtbaren Funktionen für den Einsatz von Produktions-LLM.
- Überprüfen Sie die Richtigkeit systematisch. Führen Sie eine etablierte Reihe von Leistung- und Richtigkeit-Benchmarken durch, um Integrität und Zuverlässigkeit zu gewährleisten, und erreichen Sie in allen unterstützten Konfigurationen eine deutlich bessere Leistung.
- Skalierungsvalidierung. Lassen Sie die Mitwirkenden standardisierte Tests auf ihren eigenen GPUs durchführen und reproduzierbare Ergebnisse teilen, bevor sie die Aufmerksamkeit des Betreibers anfordern.
Kimi K3 ist unsere erste Leistung nach diesem Ansatz. Dieser Artikel beschreibt, wie wir Kimi K3 optimiert haben, wie wir das nötige Vertrauen entwickelt haben, um diese Optimierungen zu veröffentlichen und zu pflegen, sowie die Leistungsergebnisse.
Inhaltsverzeichnis
- Teil 1: Optimierung von Kimi K3
- Teil 2: Schnell und verantwortungsvoll bewegen
- Teil 3: Tiefenuntersuchung der Leistung
- Was kommt als Nächstes
- Danksagungen
Teil 1: Optimierung von Kimi K3
Dieser Beitrag führt einen neuen Decodierungspfad für Kimi K3 ein, der fast alle Operationen durch angepasste CuTe-DSL-Kerne ersetzt und für bestimmte Unterprobleme angepasst wird. Er richtet sich an NVIDIA Blackwell-GPUs mit 8 oder 16 GPUs, decodiert Batches von 1 bis 64 und bietet optional den Parallelismus des Decodierungskontexts für lange Kontexte. Die GPUs teilen einen NVLink-Domänen mit Multicast-Unterstützung. Für weitere Details siehe den PR.
1. Anpassen der Formen für die Arbeitslast
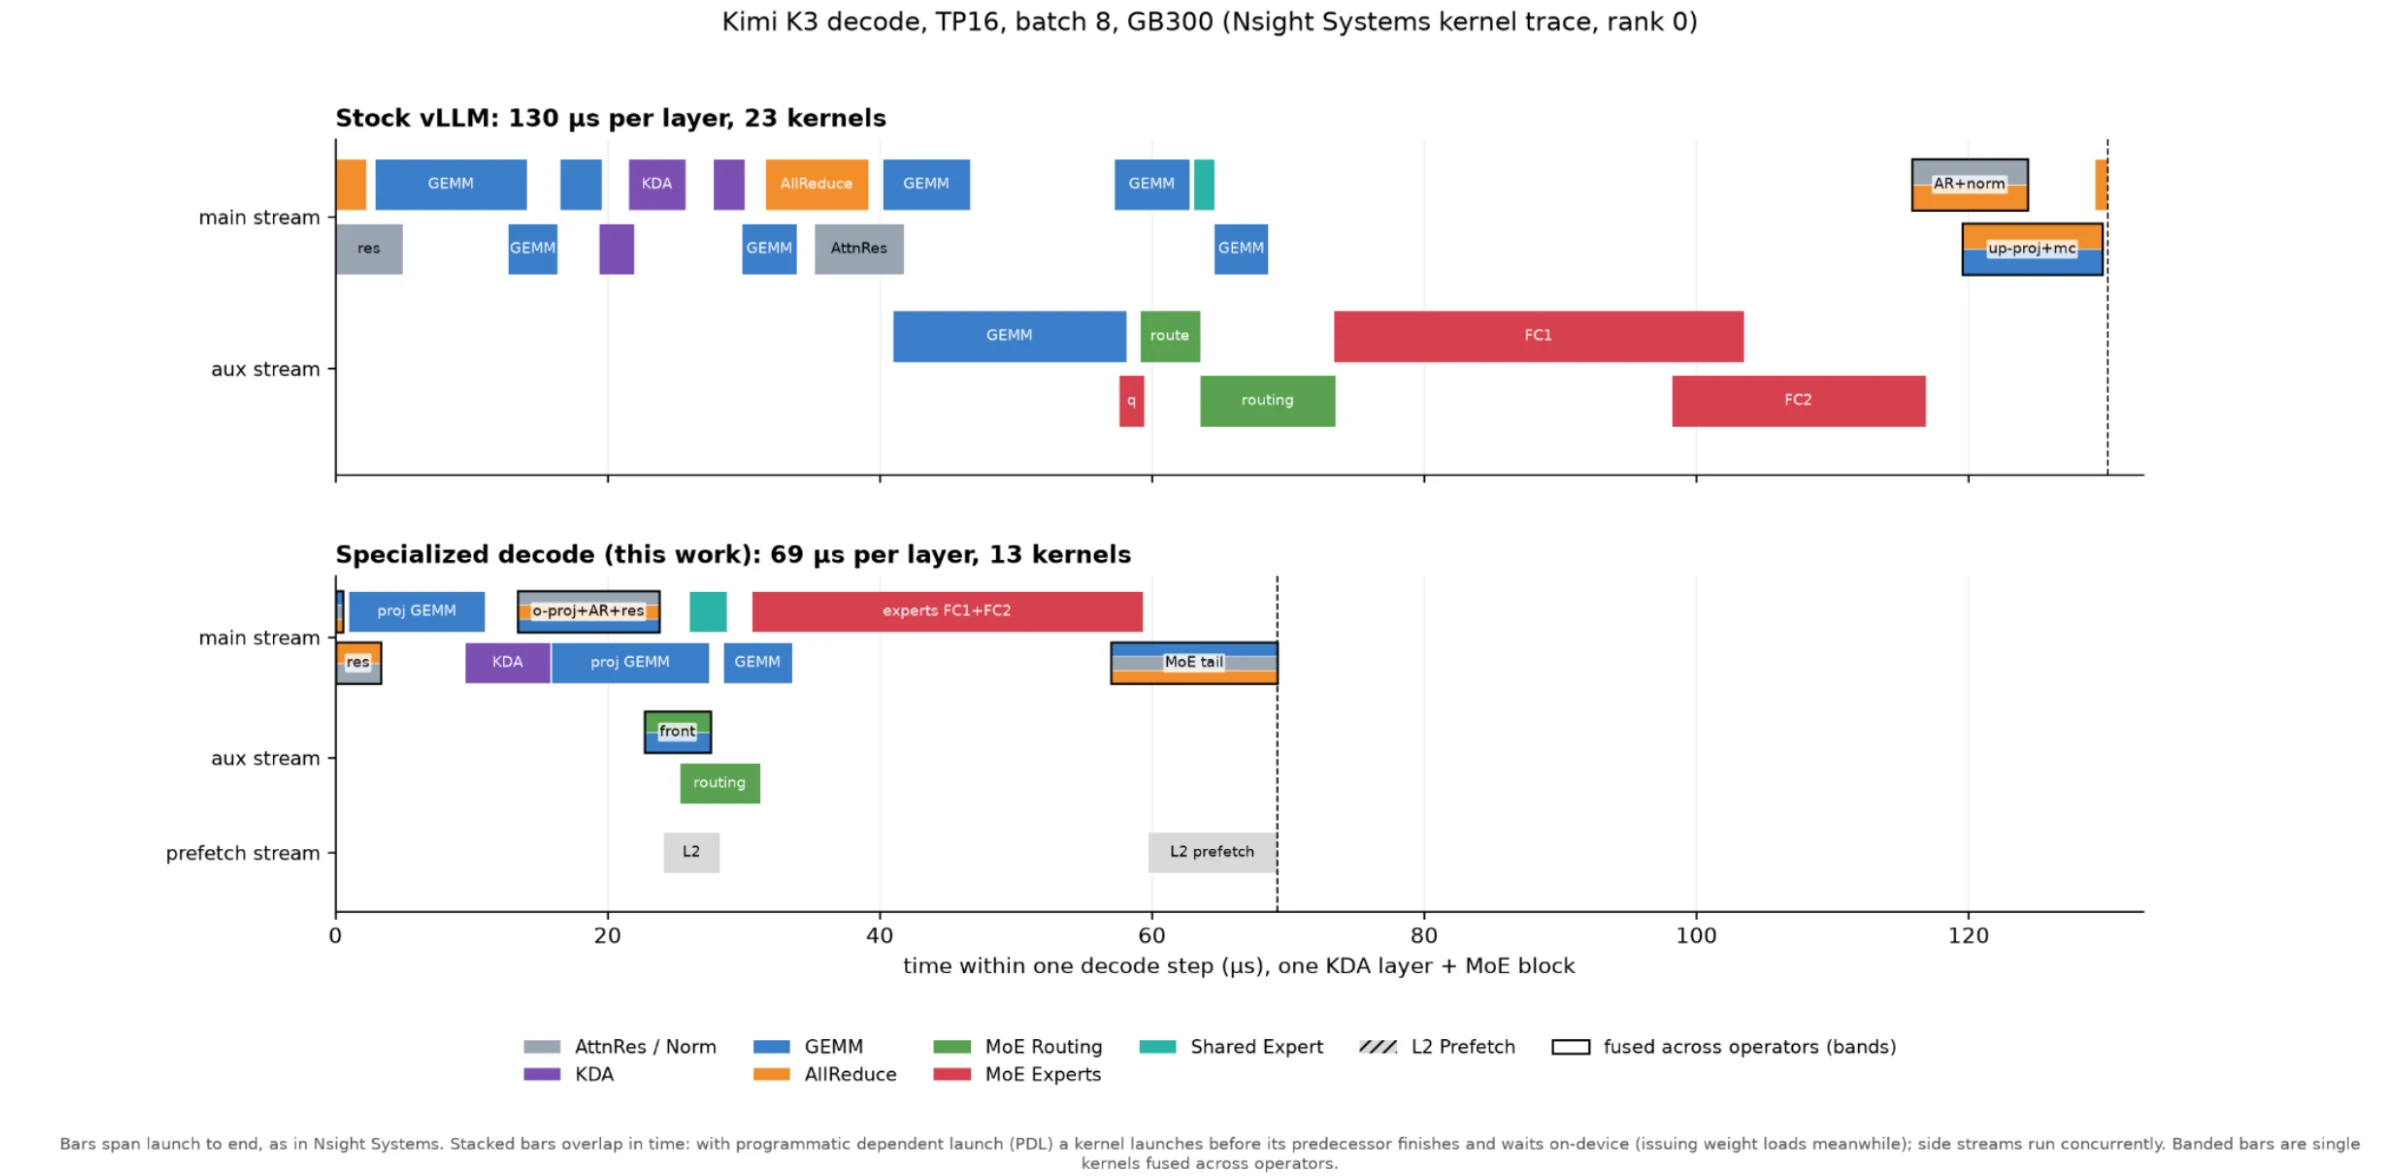
Unterschiedliche Batchgrößen erfordern unterschiedliche Kernel-Wahl. Für Eingabeprojektionen erhalten wir spezialisierte kleine-Matrix-Kerne bei Batchgrößen 1–2 und Split-Kerne bei größeren Batches, wodurch die Matrixmultiplikation auf mehr GPU-Worker verteilt wird. Alle solchen Projektionen wurden sorgfältig angepasst, um gut dimensionierte Kerne zu starten, die die GPU-Ressourcen voll ausnutzen und die Speicherlese/ Kommunikation sowie die Rechenarbeit so weit wie möglich überlappen.
KDA verwendet ebenfalls einen optimierten CuTe-DSL-Dekodier-Kernel, dessen Planung auf den Batchgröße und die Anzahl der Attention-Heads auf jedem GPU abgestimmt ist.
Für lange Kontexte splitt die Dekodierung des Kontextparallellismus (DCP) den KV-Cache auf GPUs auf. Jeder GPU berechnet die Aufmerksamkeit über seinen lokalen Bereich, und ein angepaster gefuserer Kernel kombiniert die teilweise Ergebnisse mit v-Projekt und Gating.
2. Überlappung von Berechnung und Kommunikation
Wir fügen die Aufmerksamkeitsausgabeprojektion direkt mit ihrer All-Reduzierung und der anschließenden Aufmerksamkeitsresiduenberechnung zusammen. Die GPU-Kerne veröffentlichen Teilergebnisse in NVLink-zugänglichen Buffers, und die Empfangskerne kombinieren diese und setzen die Berechnung fort. Einige kleine-Batch-Konfigurationen fügen den Produzenten und dem Konsumenten zu einem einzigen Kernel zusammen. Die Datenaustausch erfolgt mit einer fence-losen Methode mit minimalem Overhead.
Bei größeren Batch-Größen wechselt die Implementierung zu einer zweistufigen Reduktion: GPUs kombinieren zunächst die zugewiesenen Teile des Outputs und verteilen anschließend die Ergebnisse. Dadurch wird der Datenverkehr zwischen den GPUs reduziert.
3. Verbessern des MoE-Scheduling und Überlauf
Obwohl die Experten bereits Tensor-Parallellität verwenden, berechnet der Baseline die vollständigen Router-Scores und die latenten Eingangsprojektionen auf jedem GPU. Wir teilen diese Berechnungen auf die TP-Ränge auf und kombinieren das Ergebnis jeder Ränge in eine Matrixmultiplikation. Die GPUs tauschen die Ergebnisse über NVLink aus. Dadurch wird die wiederholte Berechnung, die Gewichtlesung und die Kernel-Launchs vor dem Beginn der Experten- Ausführung reduziert.
Der geteilte Experte läuft auf einer separaten Stream. Seine Arbeit überschneidet sich mit der Routing- oder routed-expert-Computation, abhängig von der Konfiguration. Die Schedule bestimmt, wie viele GPU-Ressourcen jede Operation verwendet, und wird sorgfältig angepasst, um ein ausgewogene Parallelismus ohne Konkurrenz zu gewährleisten. Die Details finden sich in experts_runtime.
4. Vorspannen der kommenden Gewichte in den Cache
In kleinen Batch-Inferenzen sind wir oft an die Speicherkapazität gebunden: durch die Geschwindigkeit, mit der wir die Gewichte aus dem Speicher laden können. Einige Phasen können das verfügbare Speicherbandbreitenverhältnis nicht vollständig nutzen, wie beispielsweise die Kommunikation: Während dieses Prozess stattfindet, kann ein dedizierter Kernel auf einer Nebenströmung ausgeführt werden, um sicherzustellen, dass nach Abschluss der Kommunikation die Gewichte für die nächste Operation eine deutlich höhere Cache-Hit-Rate haben.
Teil 2: Schnell und verantwortungsvoll handeln
Kimi K3 ist nur eines der ersten Beispiele. Wir glauben, dass die Community dies gemeinsam aufbauen kann, um mehr Modelle, GPUs und Workloads auf das Niveau des Lichts zu bringen.
Unterschiedliche Mitwirkende/Agenten finden unterschiedliche Möglichkeiten: einen besseren Kommunikationsplan oder eine Integration, die eine bestimmte Einrichtung unterstützt. Doch wenn jede Beitragung mit unterschiedlichen Annahmen, unvollständigen Tests und einem schwer reproduzierbaren Benchmark einhergeht, wird die Validierung und Wartung schnell zum Engpass – oder wir riskieren, beschädigtes Code zu veröffentlichen. Wir brauchen eine gemeinsame Methode, um diese Ideen in Verbesserungen zu verwandeln, auf den die Benutzer für ihre langfristigen Produktionsanwendungen zählen können.
Dies ändert, was wir den Agenten fordern, dass sie liefern. Wir sollten klare Erwartungen hinsichtlich der Tests, Validierungen und Anforderungen für den Code festlegen, den die Agenten erbringen. Die Agenten werden Tests erstellen, umfassende Bewertungen und Benchmarks durchführen, Fehler untersuchen und die Bedingungen dokumentieren, unter denen die Optimierung funktioniert. Menschliche Überprüfer beurteilen weiterhin das Design und die Beweise, aber sie können von einer hohen Ebene der Abstraktion ausgehen, anstatt einer Zeile für Zeile-Code-Überprüfung.
Auf der Grundlage des vorgeschlagenen schnellen Track-RFC strukturiert wir diese Arbeit nach vier Prinzipien.
1. Isolieren die Änderungen
Bewahren Sie die spezifischen Optimierungen des Modells im Code des Modells auf. Dadurch sind die betroffenen Pfade einfacher zu identifizieren und die Reichweite der Überprüfung erleichtert wird.
Die Isolierung muss auch während der Ausführung aufrechterhalten werden. Die Überprüfer sollten in der Lage sein zu verfolgen, wann der optimierte Pfad gewählt wird, in welcher Zustand er sich verändert und wie die Ausführung wieder zum Standardpfad zurückkehrt.
Diese Einschränkung entscheidet über bestimmte Optimierungen: die Vorbereitung der Eingaben, das Sampling und die Verwaltung des KV-Caches können Überlauf verursachen, den die Isolierung ausschließt. Dies ist eine Folge des Designs und ist größtenteils beabsichtigt: diese Komponenten werden in den meisten vLLM-Implementierungen gemeinsam genutzt, und das Anpassen dieser Komponenten zur Optimierung für ein bestimmtes Arbeitslastrisiko kann Dutzende weitere stabilen vLLM-Konfigurationen zerstören. Die Arbeit an diesen Komponenten ist wichtig und sollte von den Kern-Entwicklern viel enger betrieben werden, als es der schnelle Prozess zulässt.
2. Beschränke den Bereich, aber bewahre die Funktionen des Benutzers
Eine Optimierung muss nicht in allen Bereitstellungen verbessert werden, um nützlich zu sein. Sie kann sich auf einen bestimmten GPU, eine Parallelitätseinstellung oder ein Bereich von Batch-Größen konzentrieren. Klare Grenzen machen das Arbeiten einfacher und geben uns eine definierte Anzahl von Konfigurationen zur Validierung.
Für K3 umfasst die anfängliche Hardwarevalidierung den GB300 mit TP8 und TP16, die Decodierung von Batchs bis zu 64, die spekulative Decodierung mit verschiedenen Entwurfslängen sowie die Decodierung von Konfigurationen im Kontextparallelverfahren innerhalb eines NVLink-Domains.
Diese Grenzen beschreiben die Bereiche, in denen die Optimierung angewandt wird, aber sie schließen die „Feature-Abdeckung“ nicht aus. Die Produktionsdeployment erfordert grundlegende Funktionen, die das Endpunkt nützlich machen. Funktionen wie der vollständige Kontextdienst, Temperatur-Sampling und strukturierte Ausgabe können nicht „optimiert oder ausgeschlossen“ werden; sie sind erstklassige Dienste und gehören zum Validierungsplan zusammen mit den Kernel-Formen und numerischen Überprüfungen.
3. Überprüfen Sie die Richtigkeit
Kerntests und Modellbewertungen beantworten unterschiedliche Fragen. Kerntests prüfen die numerischen Ergebnisse unter verschiedenen Formen und Eingabewerten. Modellbewertungen überprüfen, ob der gesamte Ausführungspfad die Antworten des Modells erhält. Wir benötigen beides.
Die Tests müssen tatsächlich den veränderten Code ausführen. Eine kleine-batch-Optimierung muss bei kleinen Batch-Größen bewertet werden. Eine Änderung des Aufmerksenkels erfordert eine lange-kontextuelle Abdeckung. Tests, die stillschweigend den Standardpfad verwenden, liefern wenig Hinweise auf die Optimierung und sind eine häufige Falle.
Die Entwicklung von K3 zeigt, warum das wichtig ist. Unsere Überprüfung hat ergeben, dass der Compiler die Aktivierungsoperationen vor die Synchronisierungswarteschlange versetzte. Die Lösung beschränkte diesen Lasttyp auf statische Gewichte. Solche Fehler können durch einfache funktionale Tests übersehen werden und erfordern eine gezielte Untersuchung.
Außerdem zeigten lange-Kontext- und lange-Generationsbewertungen wie MRCR und AIME25 sensible numerische Probleme im Aufmerksamkeits- und Kommunikationskern, die nicht wiederholbar waren, wenn man den Kernaln mit simulierten Eingaben und/oder konsistenten Startzeiten testete.
4. Überprüfen Sie die Leistung im Allgemeinen
Eine Beschleunigung der Übersetzungsgeschwindigkeit ist ein Ausgangspunkt. Wir müssen auch wissen, wie sich die Veränderung im Hinblick auf die betroffenen Arbeitslasten verhält. Das bedeutet umfassende Batch-Größen, Kontextlängen und unterstützte Parallelitätskonfigurationen. Die MoE-Messungen sollten reale Prompts enthalten, da die Auswahl von Experten die Art und Weise beeinflusst, wie die Gewichte gelesen werden und wie viel Arbeit wieder verwendet werden kann. Die Ergebnisse der reinen Dekodierung sollten ebenfalls von den Arbeitslasten unterschieden werden, die sowohl Präfilling als auch Dekodierung umfassen.
Eine zuverlässige Validierung erfordert auch Zeit auf der GPU. Der zugehörige Bring-Your-Own-GPU-Evaluation-RFC schlägt standardisierte Evaluation-Bilder vor, die von Mitwirkenden auf eigener Hardware ausgeführt werden können. Reproduzierbare Ergebnispakete und Aufgaben, die zu GitHub-PRs verlinkt sind, würden die Beweise viel zugänglicher machen. Unterschiedliche Evaluationstypen und gemeinschaftliches Computing würden die Abdeckung erweitern, während die GPU-Nutzung vermieden wird und der Druck auf das CI, das von dem Projekt finanziert wird, verringert wird.
Teil 3: Tiefenanalyse der Leistung
Decodierungsleistung mit DSpark
Mit DSpark erreicht Kimi K3 842 Tokens pro Sekunde auf 16 NVIDIA GB300 GPUs im kontrollierten AL=6-Benchmark. Das ist 1,73× schneller als vLLM ohne Optimierung unter derselben Decodierungsanlage. Siehe die PR, um eine vollständige Ergebnistabelle zu sehen.
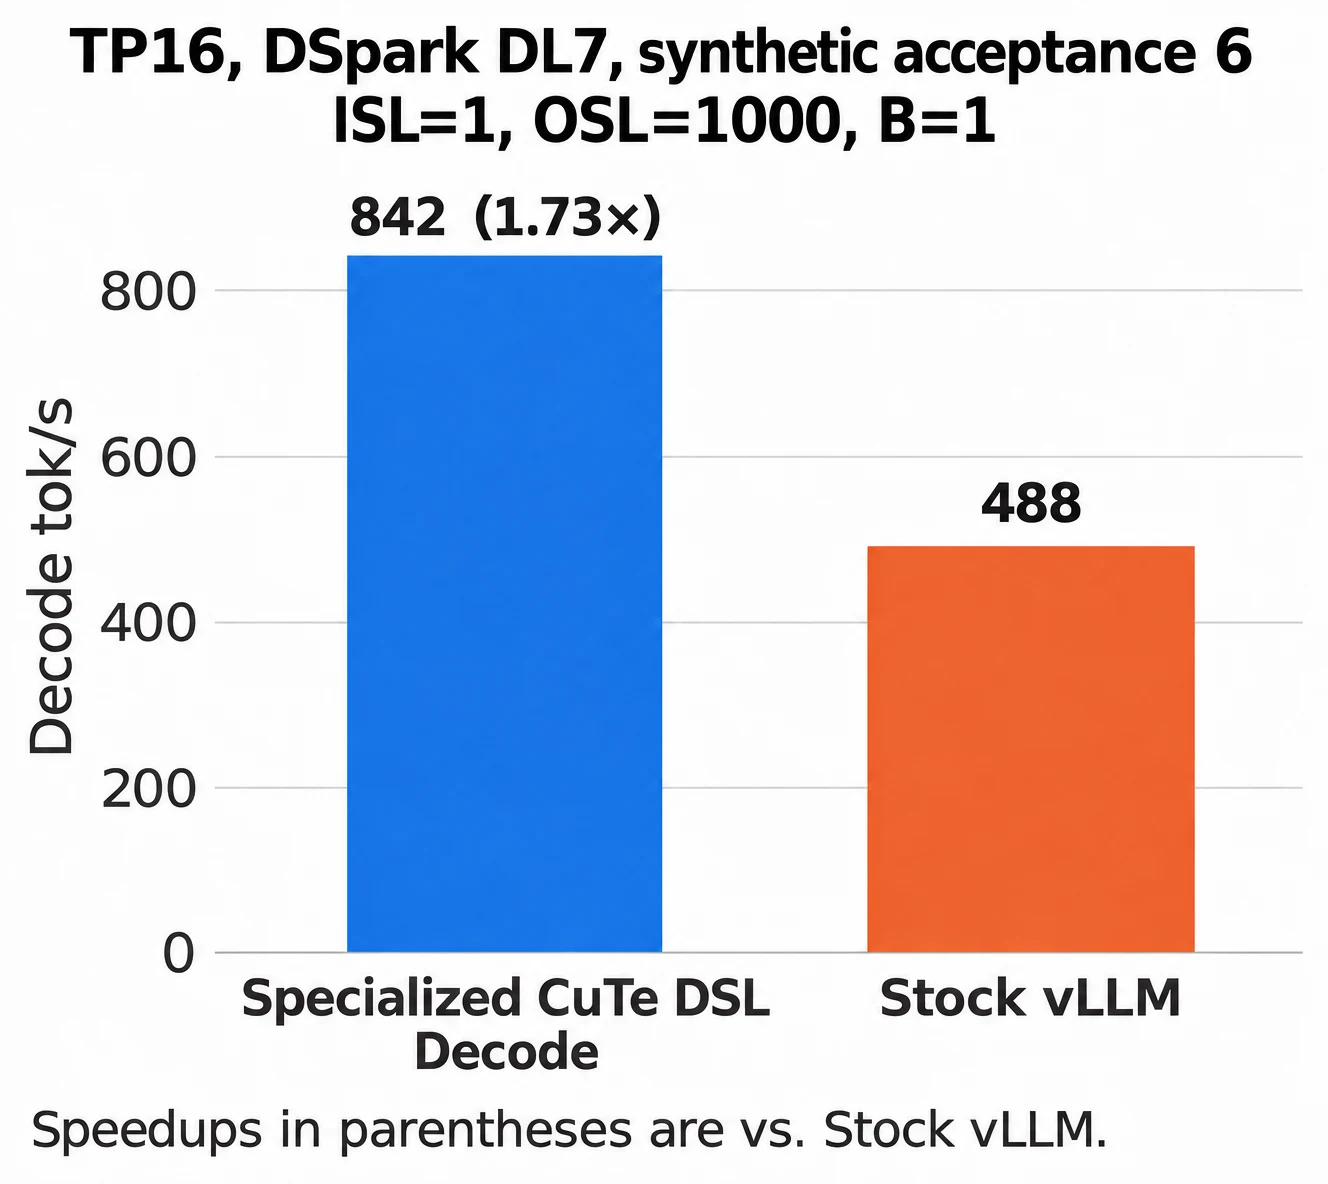
Setup: TP16, DSpark mit sieben Entwurfs-Tokens, synthetische Akzeptanzlänge von 6, DL=7, ISL=1, OSL=1k, Batchgröße 1. TPS misst die Gesamtzahl der Dekodierungsleistung und entfernt den Vorschlag.
Decodierungsleistung ohne Spekulation
Die Verbesserungen erstrecken sich über den getesteten Batchbereich. TP16 behält bei den Batches 16–64 ein 1,62–1,71×-Ergebnis, während TP8 im gleichen Bereich ein 1,31–1,43×-Ergebnis liefert.
| Batchgröße | TP8 Tokens/s | TP8-Speedup | TP16 Tokens/s | TP16-Speedup |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
Keine spekulative Dekodierung. Der Durchsatz gilt für die gesamte TP-Gruppe.
Verbesserung von AgentX
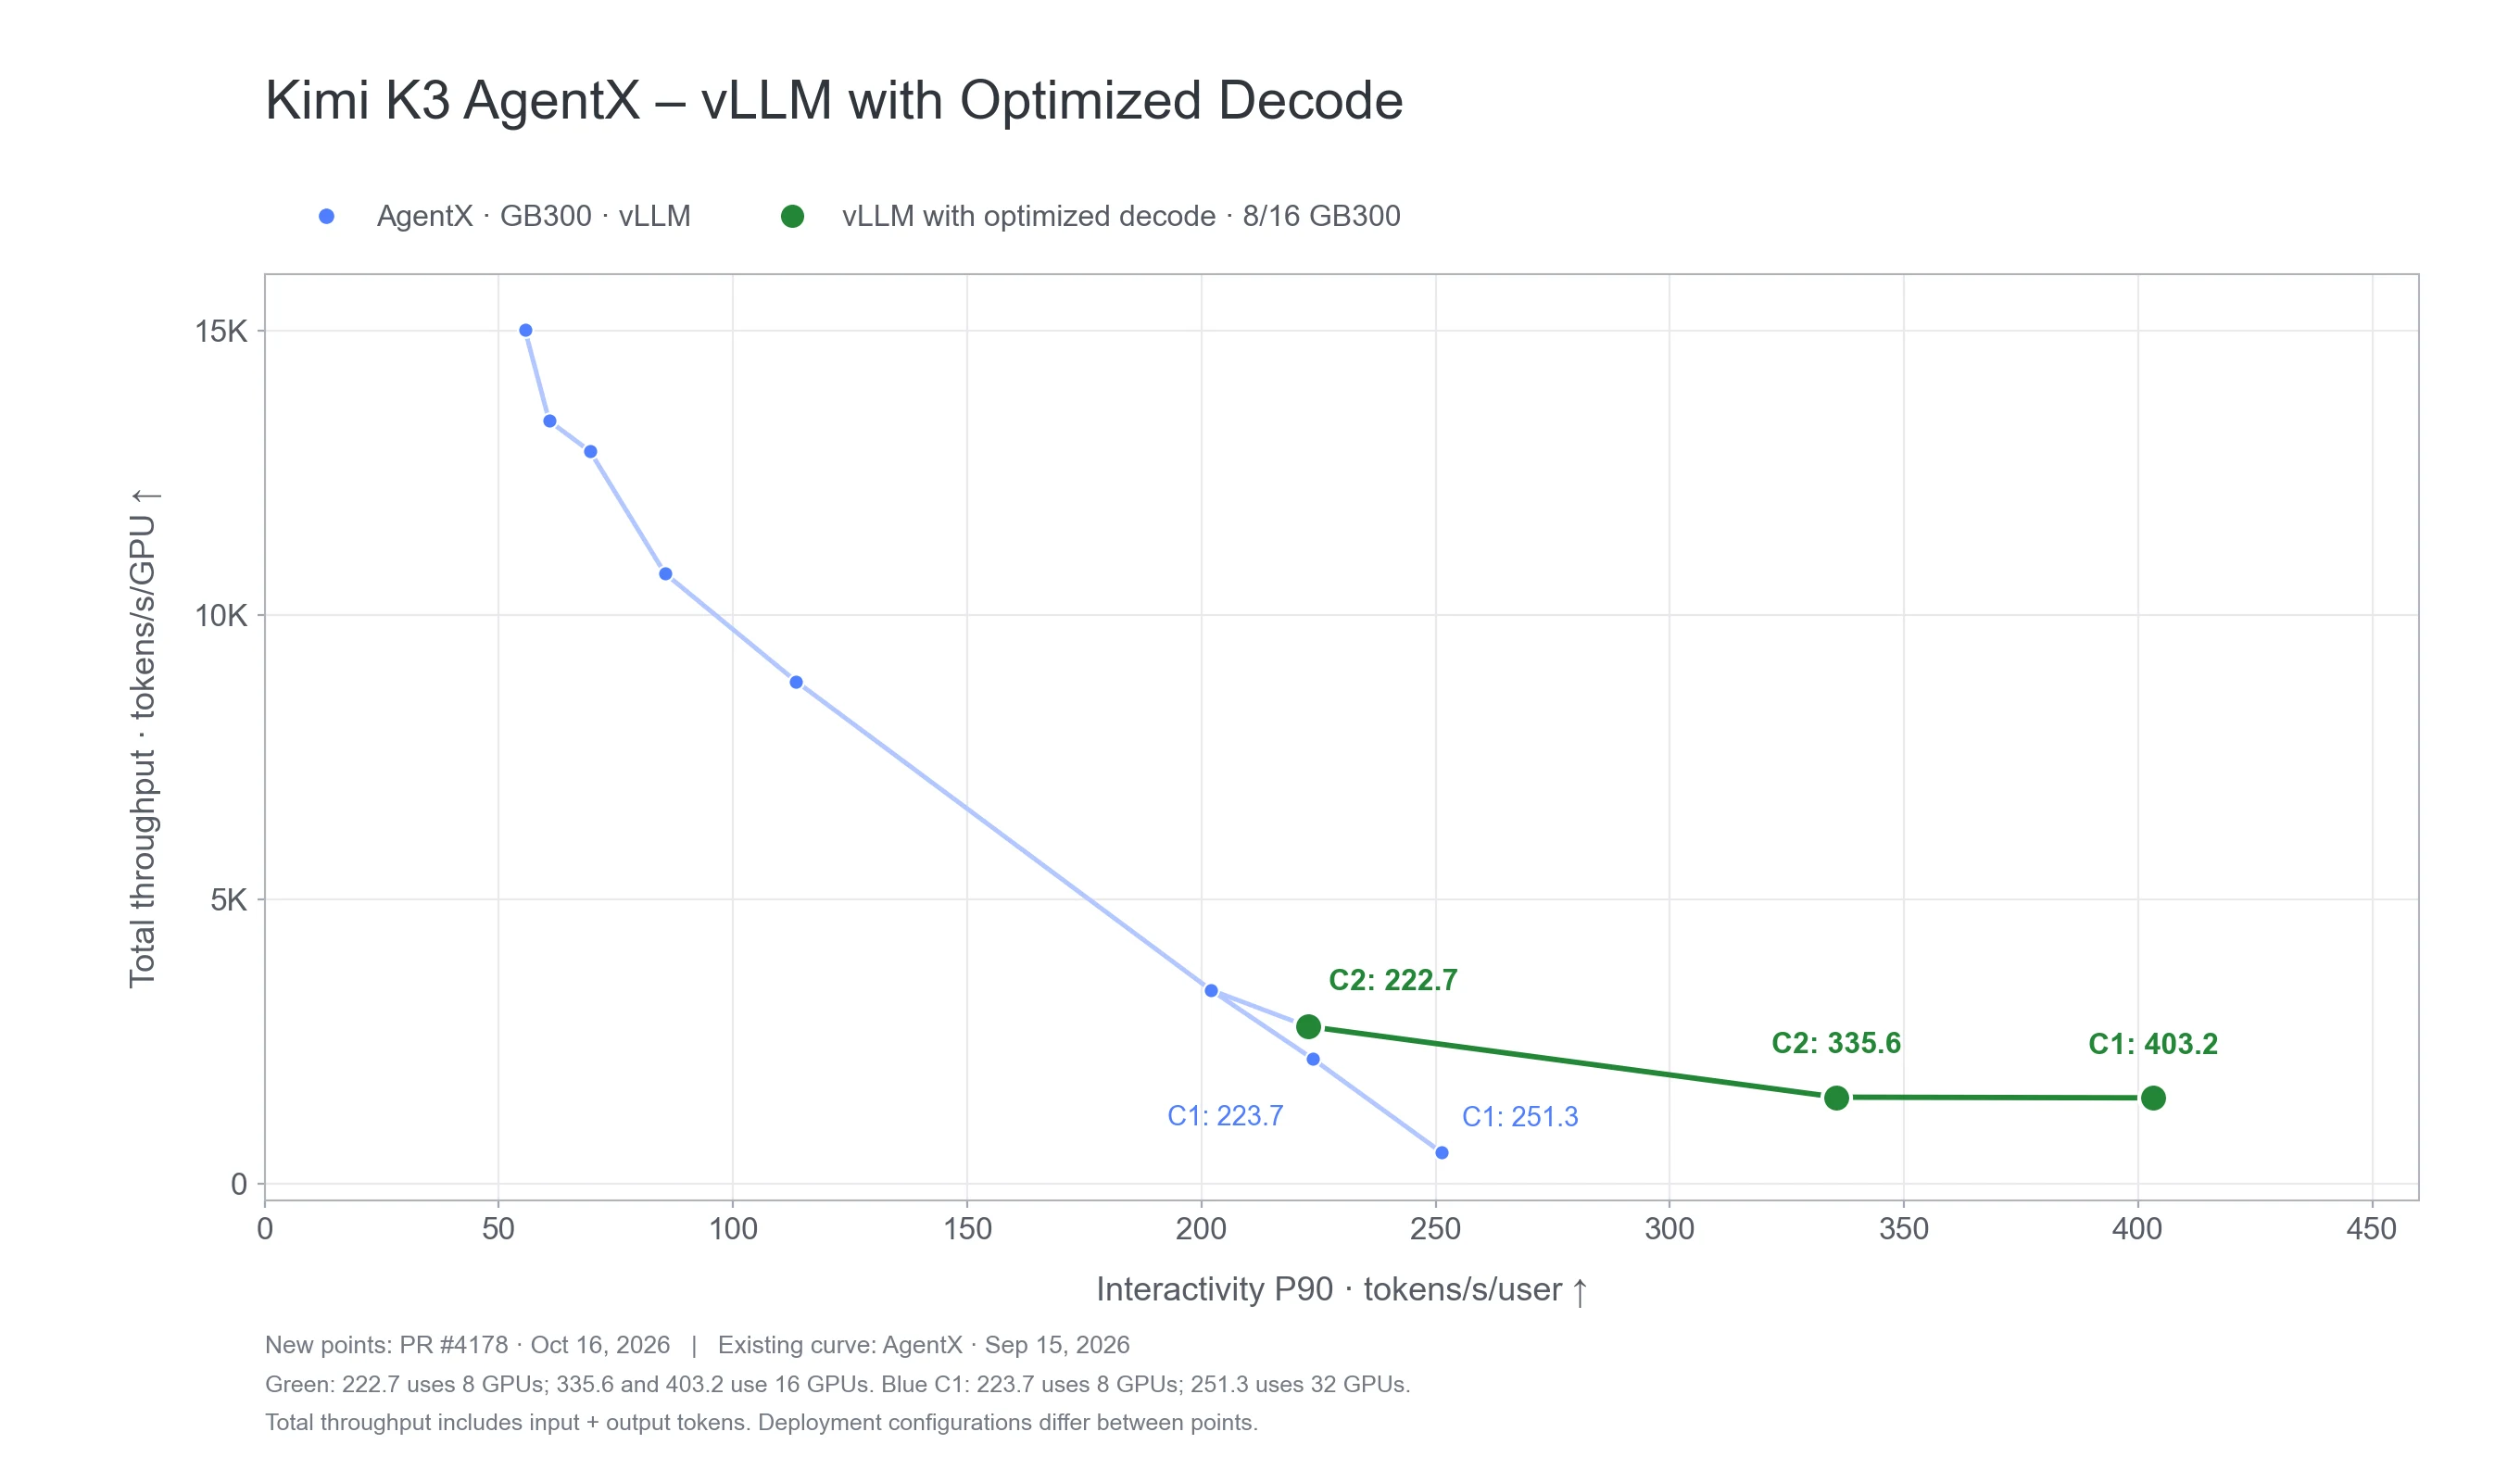
Unsere optimierte Implementierung von Kimi K3 liefert außerdem 1,8× höhere P90-Interaktivität bei Konkurrenz 1 auf AgentX: 403,2 versus 223,7 Tokens/s/User. Dies vergleicht die optimierte Ausführung mit 16 GB300 GPUs mit dem früheren vLLM-Ergebnis mit 8 GB300 GPUs.
AgentX wiederholt Verkehrsmuster aus echten Coding-Agent-Sessions, einschließlich langen Kontexten, mehreren Gesprächssituationen, Toolpausen, parallelen Subagenten und der Wiederbenutzung von KV-Cache. Es bewahrt diese Arbeitslastmuster bei gleichzeitiger Ersetzung des privaten Inhalts durch synthetisches Text, um das Servicensystem unter realistischem Agentverkehr zu testen. AgentX-Methodik.
Was kommt als Nächstes?
Für DeepSeek-V4.1-Flash folgt #61868 den K3-Designmustern: hinter demselben opt-in-Switch decode_backend: latency_specialized unterstützt die Implementierung auch bis zu 64 gleichzeitige Anfragen, einen nahtlosen Fallback für Prefills und gemischte Batches sowie spekulatives Decodieren. Anstatt einen einzelnen Hotspot zu verfolgen, trennt der Executor Kerne und Host-Arbeit: Er fusioniert alle Reduzier- und mHC-Aufgaben an jeder Sublayer-Grenze, ersetzt große-Batch-MoE- und GEMMs durch CuTe-DSL-Kerne, die für niedrige Latenz entwickelt sind, reduziert die Duplikationen und teilt die Arbeit des Indexers auf, und übernimmt die Schritt-für-Schritt-Arbeit, die vLLM standardmäßig auf dem CPU ausführt, und repliziert sie stattdessen als CUDA-Graph.
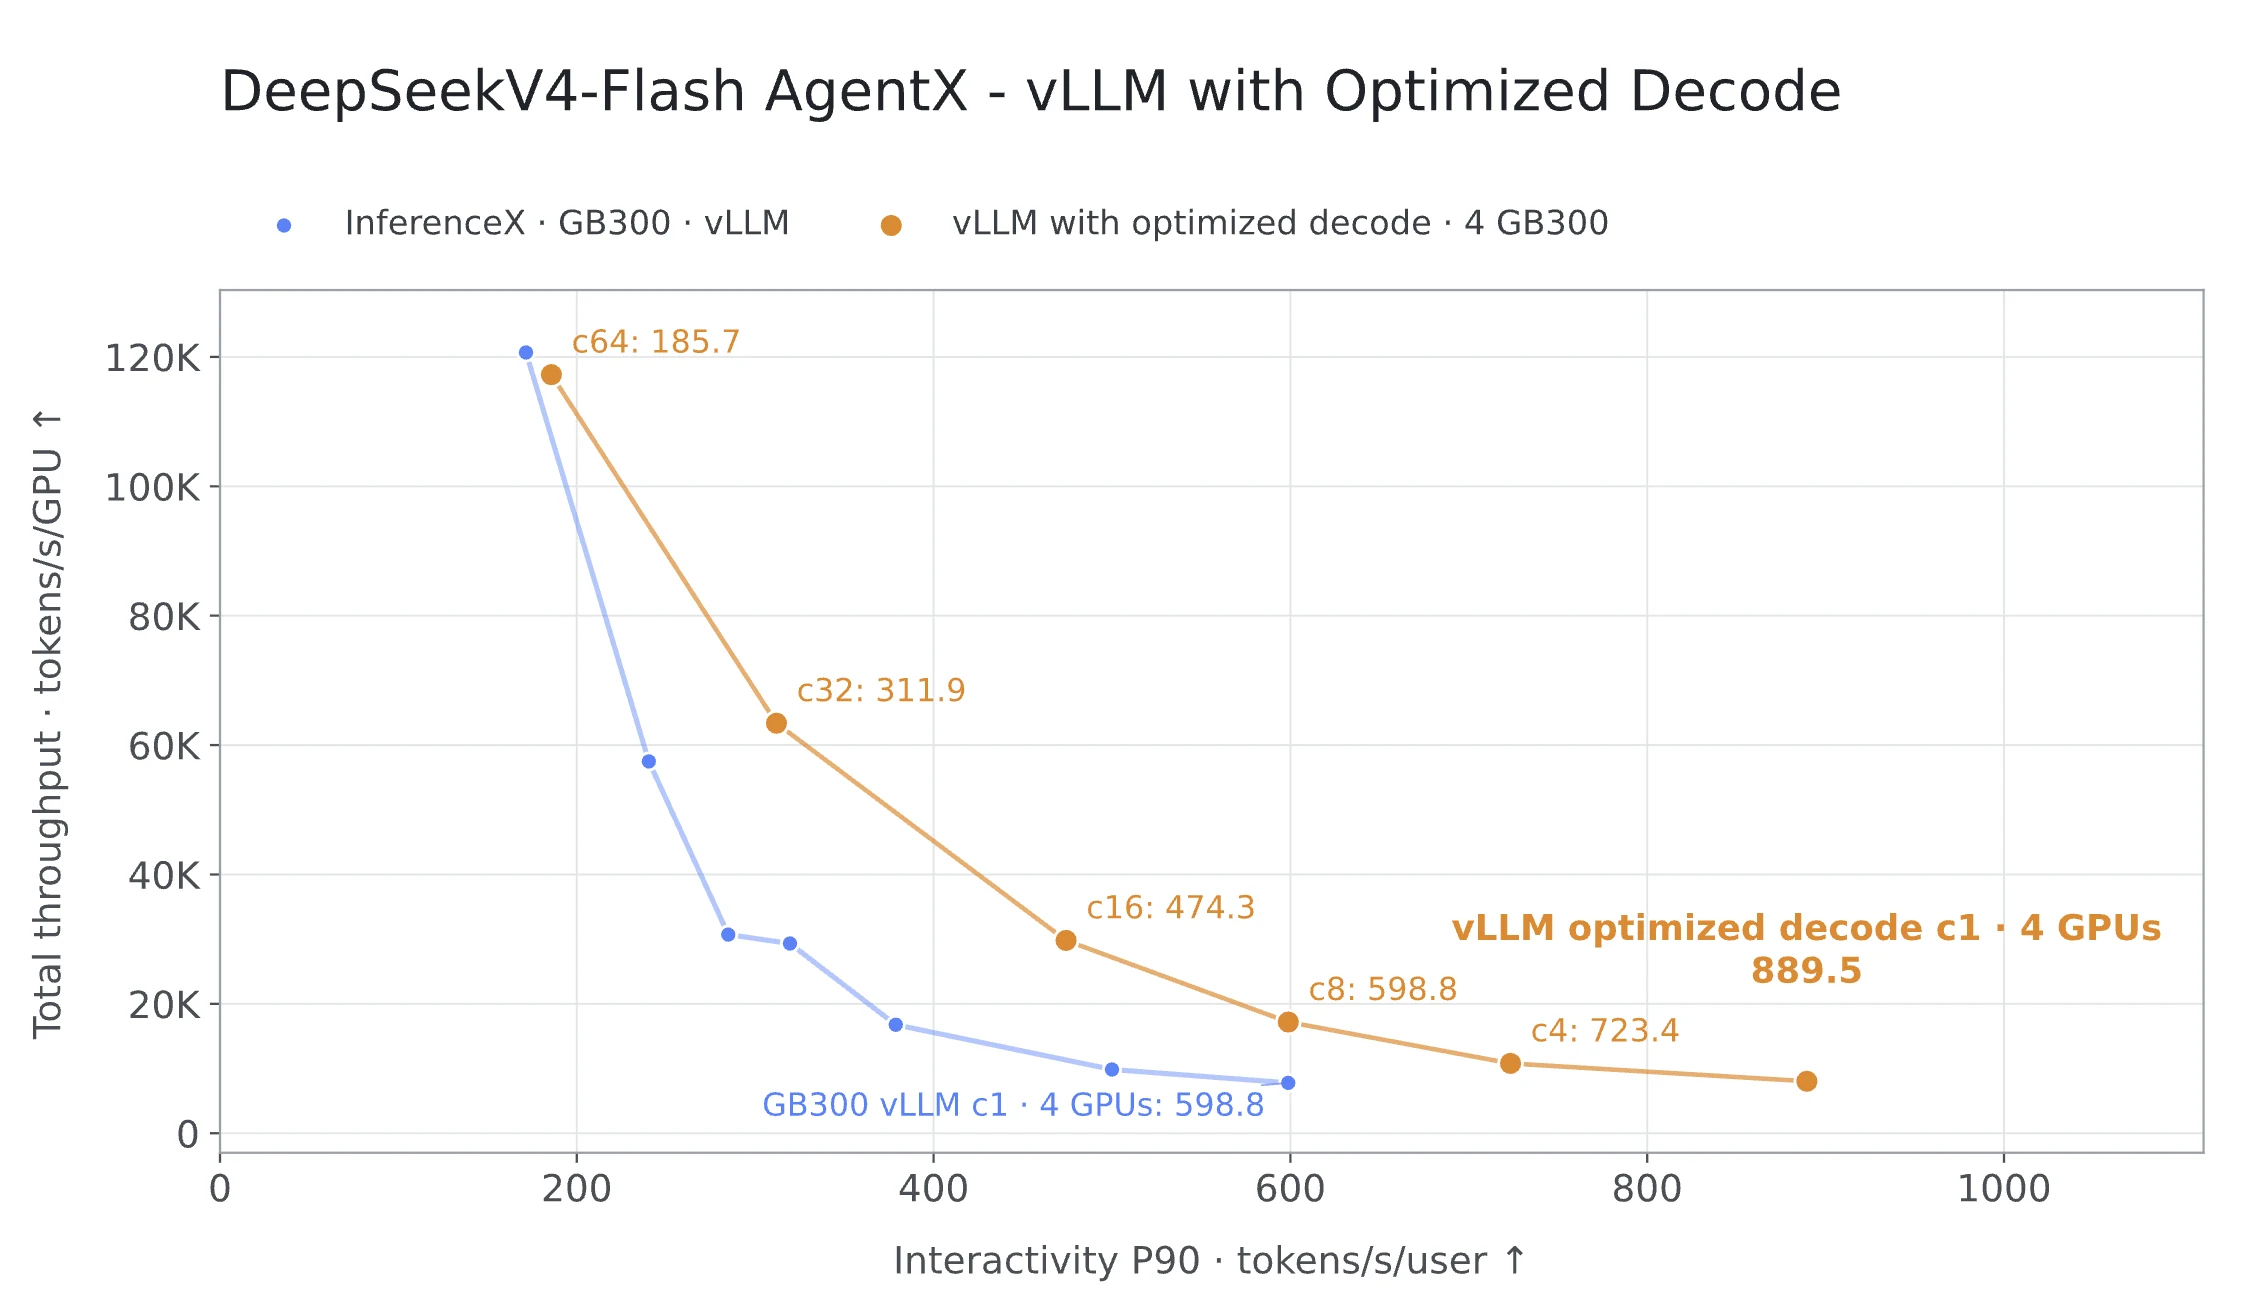
Innerhalb von zwei Tagen nach der Veröffentlichung von Metas Muse Spark Open haben unsere frühen Ergebnisse bereits 950 Tokens pro Sekunde pro Benutzer überschritten, wobei sieben Entwurfs-Tokens (K=7) und eine Akzeptanzlänge von sechs (AL=6) betragen. Weitere Optimierungen sind im Gange.
Wir veröffentlichen auch ein ähnliches Verfahren zur Optimierung der Dekodierlatenz für GLM5.3 unter einem niedrigen Konkurrenzkontext. Wir werden die Details der Optimierung und die Leistungsergebnisse in einer weiteren Publikation teilen.
Für jede Beitragsleistung werden wir weiterhin auf konkrete Leistungsverbesserungen, die Unterstützung von Produktfunktionen sowie wiederholbare Prüfungen der Korrektheit und Leistung konzentrieren.
Danksagungen
Wir möchten Rohan Varma (NVIDIA) und Alex Steiner (NVIDIA) für ihre Beiträge zu dieser Arbeit danken.
Wir möchten auch Woosuk Kwon (Inferact), sowie Michael Goin und Lucas Wilkinson (Red Hat) dafür danken, dass sie die Modellrefactoring sowie wertvolle Rückmeldungen und Unterstützung geleistet haben.