

Deepseek V4.1 Flash 1017 übertrifft größere Rivalen in agentischen Aufgaben und senkt erneut die Kosten pro Aufgabe massiv
 Matthias Bastian
Das LinkedIn-Profil von Matthias Bastian ansehen
Oct 17, 2026
 Nano Banana Pro wird von THE DECODER angefordert
Schlüsselpunkte
- Die chinesische KI-Firma Deepseek hat Deepseek-V4.1-Flash-1017 auf seinen Plattformen sowie als offenes Modell auf Hugging Face und ModelScope veröffentlicht.
- Laut der Firma läuft das Modell mit Verstärkungslernen unter Verwendung von Selbstfeedback schneller, erzeugt kürzere Ausgaben und zeigt gute Leistungen bei End-to-End-Softwareentwicklung und Agentaufgaben.
- In internen Benchmarknissen übertrumpft die Aktualisierung größere Rivalen wie Claude Opus 5 und GPT 5.6-Sol bei den Code- und Agent-Benchmarknissen. Deepseek öffnet außerdem seinen inhouse-Suchmaschinen-Engine für Entwickler durch neue Search- und Fetch-APIs.
Die chinesische KI-Firma Deepseek hat eine aktualisierte Version ihres Flash-Modells mit wichtigen Fortschritten in agentischen und Programmieraufgaben veröffentlicht. Die Firma öffnet außerdem zum ersten Mal ihren internen Suchmaschinen-Service für externe Entwickler.
Deepseek-V4.1-Flash-1017 ist jetzt über die Website, die App und die API der Firma verfügbar. Deepseek hat außerdem die Modelgewichte als Open Source auf Hugging Face und ModelScope veröffentlicht. Im Vergleich zu seinem direkten Vorgänger erzielt das Modell bessere Benchmark-Ergebnisse, erledigt Aufgaben schneller und liefert kürzere Ergebnisse. Die Firma bezeichnet diese Aktualisierung als eine Pareto-Verbesserung im Verhältnis zwischen Leistung und Kosten.
Für die Erstellung vollständiger Softwareprojekte von Grund auf verwendet Deepseek das Verstärkungslernen mit Selbstfehlermelding (RLSF). Diese nach Trainingsmethode ermöglicht es dem Modell, seine eigenen internen Vertrauenswerte oder selbst erzeugten Kritiken als Belohnungssignal zu verwenden. Dadurch entfällt die Notwendigkeit von menschlichen Bewertern oder externen Belohnungsmodellen. Deepseek behauptet, dass dieser Ansatz die Entwicklung von Projekten aus dem Endpunkt bis zu Aufgaben wie Spielprogrammierung bis 3D-Modellierung und Designarbeit verbessert. Das Modell kann auch kompakte Erklärvideos animieren, ähnlich wie das kürzlich veröffentlichte Opus 5.5.
Video via FeiZAnzeige
Das Modell wurde für Entwicklungsumgebungen wie Deepseek Harness (Version v0.2.1-rc.1 oder neuer empfohlen), Tencent CodeBuddy und WorkBuddy angepasst.
Das kleinere Flash-Modell übertrifft die größeren Konkurrenten in Bezug auf Programmierung und Agentaufgaben
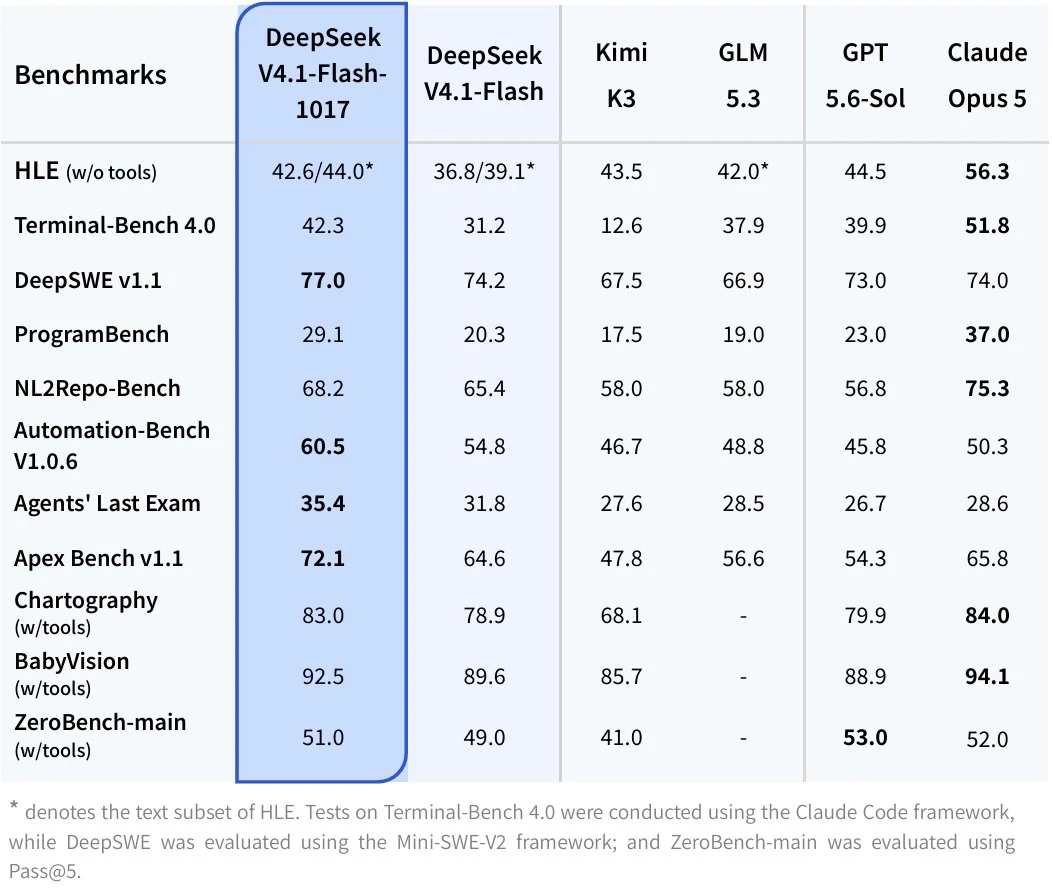
In Deepseek’s eigenen Benchmarks übertrifft V4.1-Flash-1017 sein Vorgänger V4.1-Flash. Es schlägt auch größere Konkurrenzmodelle wie Claude Opus 5, GPT 5.6-Sol, Kimi K3 und GLM 5.3 in mehreren Kategorien für Programmierung und AI-Agenten.
Eine Kostenkarte für den DeepSWE-Benchmark zeigt, wie wichtig kürzere Ausgaben für die Effizienz sind. V4.1-Flash-1017 erreicht einen Höchstwert von 77,0 Prozent bei einer durchschnittlichen Kostenstelle von knapp unter $0,20 pro Aufgabe. Bei niedriger Einstellung erreicht es immer noch 72 Prozent für etwa $0,10. Der Vorgänger erreichte 74,2 Prozent, aber kostete etwa $0,50 pro Durchlauf.
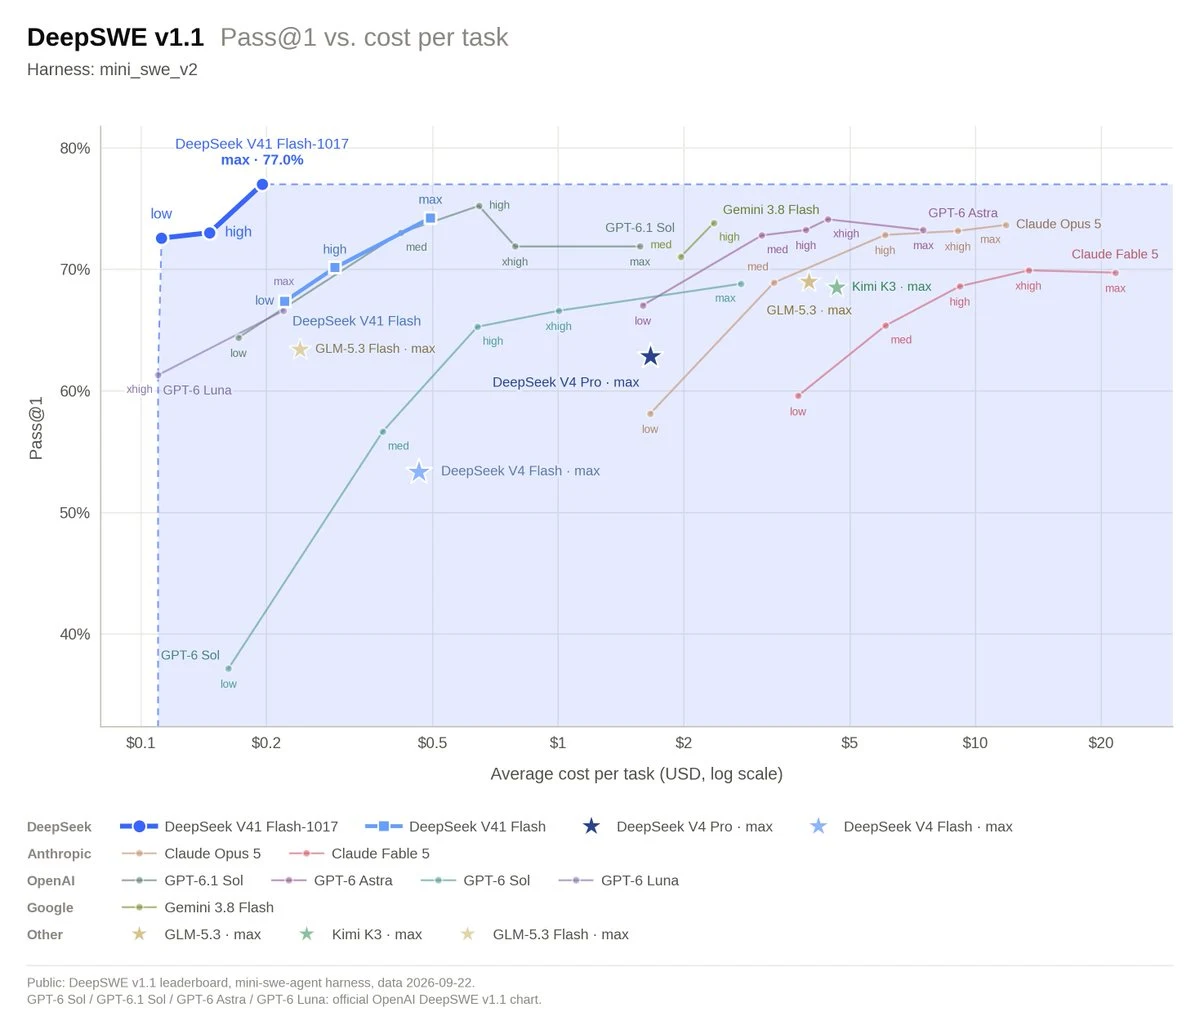
Rivalmodelle wie GPT-6 Astra, Gemini 3.8 Flash und Claude Opus 5 liegen in diesem Diagramm zwischen 2 und über 10 Dollar pro Aufgabe, und keines von ihnen erreicht die Genauigkeit des kleineren Deepseek-Modells. Unabhängige Benchmarke sind noch nicht verfügbar, und die Benchmarke erzählen ohnehin nur die halbe Geschichte. Die Eindrücke der Entwickler bezüglich der Codequalität können sich beispielsweise stark von den Benchmarkergebnissen unterscheiden.
Deepseek verwandelt seinen internen Suchmotor in eine öffentliche API
Neben dem Sprachmodell stellt Deepseek seine Web-Suchwerkzeuge (Search & Fetch APIs) allen Entwicklern zur Verfügung. Das Unternehmen sagt, dass diese Dienste auf einem intern entwickelten Suchsystem laufen, das bereits täglich Hunderte von Millionen Anfragen weltweit verarbeitet. Die Einrichtungsdetails finden sich in der API-Dokumentation.
Jeder Endpunkt kostet 0,75 $ pro 1.000 Anrufe. Benutzer der Deepseek API können die Funktionen kostenlos über Serverseitige Tools in Deepseek Harness, Claude Code und Codex nutzen, bis zum 31. Oktober 2026 (4:00 PM UTC).
Die tiefe Integration chinesischer KI-Modelle in Arbeitsprozesse war gestern zwar etwas weniger attraktiv. Die chinesische Regierung plant angeblich, die Regeln für die Veröffentlichung offener Gewichtsmodelle zu verschärfen oder sogar deren Veröffentlichung vollständig zu blockieren. Ein entscheidender Faktor ist, ob ein bestimmtes System unter die Top 10 der leistungsstärksten Modelle gehört.
AI-News ohne Hype – von Menschen zusammengestellt
Abonnieren Sie THE DECODER, um eine Werbefreie Lektüre, einen wöchentlichen AI-Newsletter, unseren exklusiven „AI Radar“ Frontier-Report sechsmal pro Jahr, den vollen Archivzugang sowie Zugang zur Kommentarspalte zu erhalten.
Quelle: Deepseek