
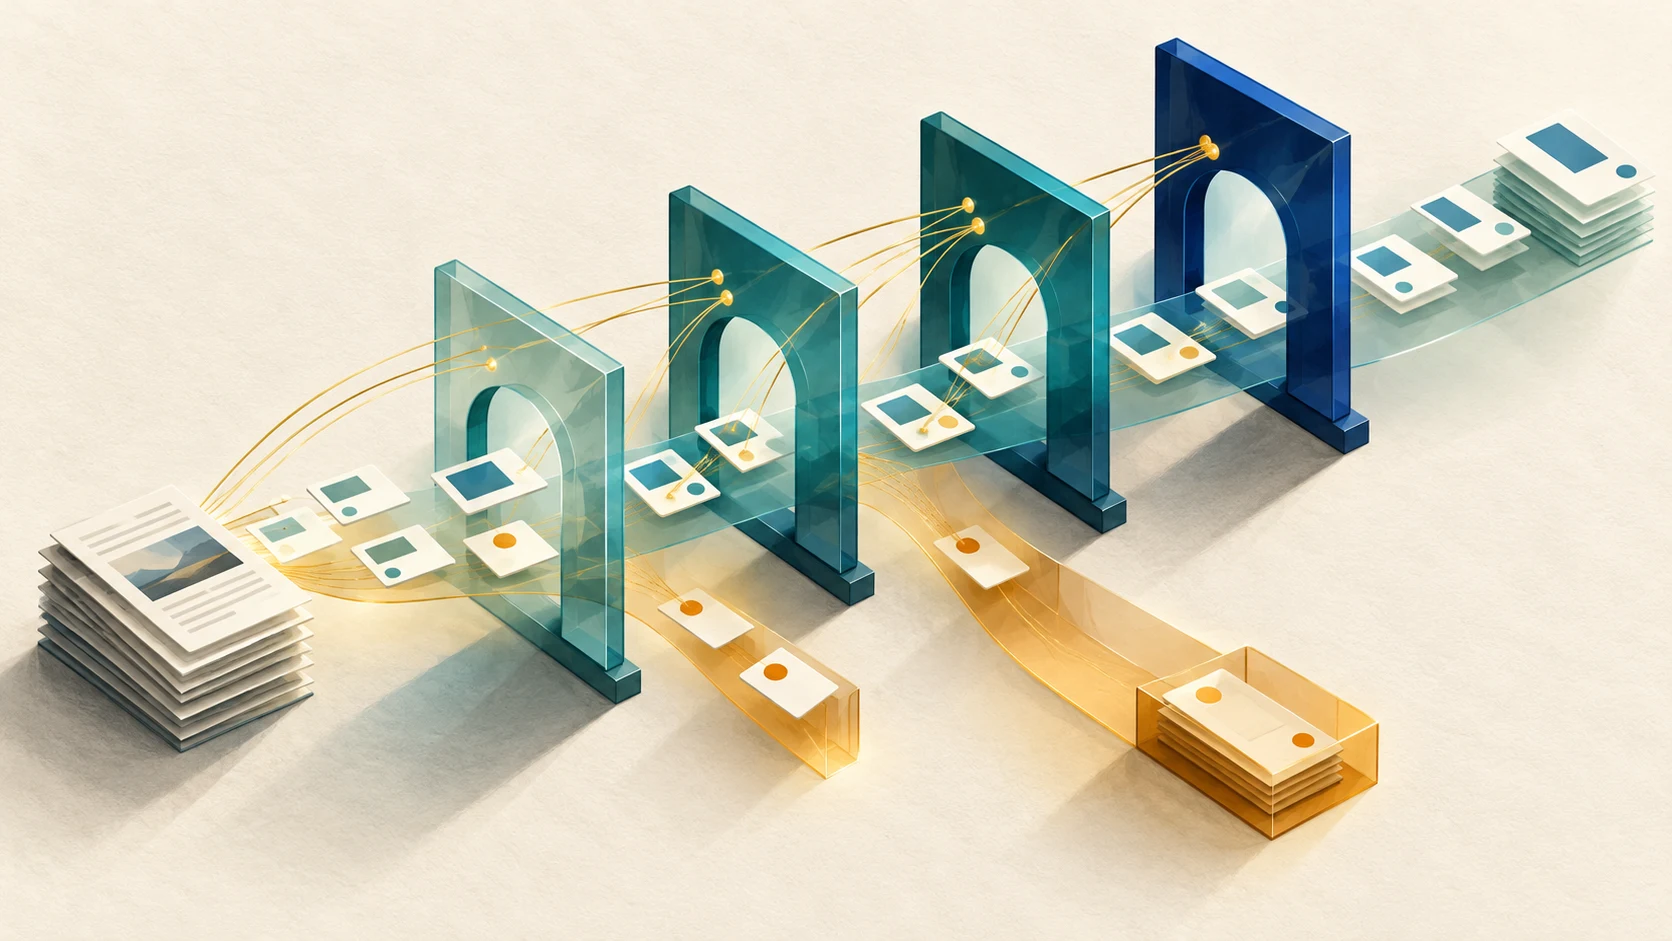
Eigenständige redaktionelle Illustration für SPKE. Ein konzeptioneller Ablauf, kein gemessener Benchmark.
Der trügerische grüne Haken
Stellen Sie sich einen Produktimport vor, der erfolgreich abgeschlossen wird, sich als JSON parsen lässt und jede Typprüfung besteht. Er schreibt 1,25 in das Feld für das Produktgewicht. In der Quelle stand jedoch „Paketgewicht: 1250 g.“ Die Rechnung stimmt, die Feldzuordnung nicht.
Dies ist ein hypothetisches Beispiel, kein Bericht über einen gemessenen Modellfehler. Es zeigt ein praktisches Problem: Ein Schema kann eine Zahl verlangen, ohne zu wissen, ob diese Zahl das Produkt, die Verpackung oder eine andere Variante beschreibt.
Strukturierte Ausgaben sind wertvoll, weil sie eine bestimmte Klasse von Fehlern begrenzen. Die nächste technische Frage lautet, welche Daten die Anwendung als hinreichend belegt übernimmt. Wir empfehlen dafür ein Regelwerk mit vier getrennten Prüfstufen und einer ausdrücklich vorgesehenen Möglichkeit, „nicht belegt“ anzugeben.
Was die Zusagen der Anbieter tatsächlich abdecken
OpenAI dokumentiert schema-konforme Structured Outputs, weist aber darauf hin, dass weiterhin Fehler möglich sind. Ablehnungen müssen gesondert behandelt werden. OpenAI-Leitfaden
Die Responses API von DeepSeek dokumentiert Ausgaben mit json_schema. Der separate Leitfaden zu JSON Output in Chat Completions beschreibt einen Modus für gültiges JSON und warnt vor leeren Inhalten und abgeschnittenen Ausgaben. Responses API · JSON Output
Diese Angaben stammen aus der am 23. Oktober 2026 geprüften Dokumentation, nicht aus einem neuen Benchmark. Die verlinkten Seiten belegen nicht, dass ein Anbieter Ihre fachlichen Datenfelder korrekt extrahiert.
Für Teams, die zwischen US-amerikanischen und chinesischen Anbietern wählen, sind folgende Vergleichspunkte nützlich: das konkrete Modell, die jeweilige API, der konfigurierte Modus und das unterstützte Schema. Vergleichen Sie nicht den strikten Schema-Modus eines Anbieters mit einer ausschließlich per Prompt formulierten JSON-Anforderung bei einem anderen und führen Sie den Unterschied dann auf die Leistungsfähigkeit eines Landes zurück. Auch ein vertrautes Anfrageformat belegt kein identisches Verhalten. Führen Sie nach jeder Änderung am Adapter oder Modell dieselben Abnahmetests durch.
Geben Sie Unsicherheit einen Platz im Datensatz
Betrachten wir diesen erfundenen Quelltext:
„Paketgewicht: 1250 g. Preis: 49.00. Artikelgewicht: nicht angegeben. Angebot endet: 04/05/26.“
Angenommen, der Import benötigt das Artikelgewicht, die Preiswährung und ein eindeutiges Enddatum des Angebots. Keine dieser Angaben ist durch den Text belegt. Wer die Lücken mit 1,25 kg, USD und dem 5. April füllt, erzeugt durch erfundene Informationen einen ordentlich aussehenden Datensatz.
Definieren Sie stattdessen ein kleines, eindeutiges Regelwerk für den Datensatz:
- value: der extrahierte Wert oder null.
- status: supported, missing, ambiguous oder conflict.
- evidence: eine Quellenkennung, die Fundstelle und der relevante Originaltext.
- transformation: eine nach der Extraktion durchgeführte deterministische Umrechnung oder die Angabe, dass keine erfolgt ist.
In diesem Beispiel erhält das Artikelgewicht den Wert null mit dem Status missing; die Währung erhält null mit dem Status missing; das Datum erhält null mit dem Status ambiguous. Das Paketgewicht kann separat in 1,25 kg umgerechnet werden, wobei die ursprünglichen 1250 g erhalten bleiben und die Umrechnung dokumentiert wird. Es darf nicht in das Feld für das Artikelgewicht wandern.
Ein Pflichtfeld muss keine Pflicht zum Raten bedeuten. Verlangen Sie den Schlüssel, erlauben Sie aber einen ausdrücklichen Zustand für unbekannte Angaben. Unterscheiden Sie missing, also eine fehlende Angabe, von ambiguous, also einer mehrdeutigen Angabe: Im ersten Fall wird weiteres Quellenmaterial benötigt, im zweiten muss bereits vorhandenes Material geklärt werden. Widersprüchliche Quellen müssen von beiden Fällen getrennt bleiben.
Lassen Sie diese Zustände nicht durch einen Konfidenzwert des Modells außer Kraft setzen. Ein unbelegter Wert bleibt unbelegt, selbst wenn das Modell ihm 0,99 zuweist. Wenn Sie Konfidenzwerte im Betrieb nutzen möchten, prüfen Sie zuerst an repräsentativen, zurückgehaltenen Testdaten, wie sie mit der tatsächlich beobachteten Korrektheit zusammenhängen.
Vier Prüfstufen vor dem Schreiben
-
Abschluss. Prüfen Sie, ob die Antwort einen nutzbaren Endzustand erreicht hat. Eine leere Ausgabe, eine abgeschnittene Antwort, eine Ablehnung und ein Anbieterfehler sind unterschiedliche Ergebnisse. Biegen Sie sie nicht alle zu einem scheinbar erfolgreichen leeren Datensatz zurecht. Halten Sie den Grund fest und leiten Sie den Fall gezielt weiter.
-
Struktur. Parsen Sie die Antwort und validieren Sie sie gegen das versionierte Schema der Anwendung. Prüfen Sie Typen, Pflichtschlüssel, zulässige Zustände und alle Einschränkungen, die der Anbieter nicht durchsetzt. Weisen Sie nicht unterstützte Schema-Funktionen bereits bei der Integration zurück, statt stillschweigend davon auszugehen, dass sie funktionieren. Ein Rückfall auf einen schwächeren Ausgabemodus muss in der Telemetrie sichtbar sein und gesondert bewertet werden.
-
Belege. Prüfen Sie, ob die angegebene Quelle existiert und ob die zitierte Passage tatsächlich in der aufbewahrten Quellversion vorkommt. Prüfen Sie anschließend, ob sie den Wert und die Feldzuordnung stützt. Auch ein echtes Zitat kann irrelevant sein: „Paketgewicht: 1250 g“ belegt kein Artikelgewicht. Bei gescannten Dokumenten kann eine Prüfung allein anhand des OCR-Textes einen OCR-Fehler übersehen; in kritischen Fällen muss die Originalseite geprüft werden.
Ein Quellenbeleg bestätigt die getreue Wiedergabe der Quelle, nicht, dass die Quelle selbst korrekt oder aktuell ist.
- Fachliche Bedeutung. Nutzen Sie, soweit möglich, deterministische Prüfungen: Einheiten, Vorhandensein einer Währung, Datumsinterpretation, Zuordnung zur richtigen Variante, zulässige Kategorien und Konsistenz zwischen Feldern. Manche Beurteilungen erfordern eine menschliche Prüfung. Stellen Sie solche Fälle in eine Prüfliste, statt sie als validierte Datensätze auszugeben.
Die Prüfstufen beantworten unterschiedliche Fragen. Eine fehlgeschlagene Belegprüfung ist kein Formatierungsproblem. Dieselbe Extraktion so lange zu wiederholen, bis ein Wert erscheint, behebt nicht das Problem einer Quelle, die diesen Wert nie enthalten hat.
Für das erfundene Beispiel kann eine einfache Regel jeden Wert mit dem Status supported ohne Beleg blockieren. Eine weitere kann verhindern, dass ein mehrdeutiges Datum automatisch importiert wird. Solche Regeln sind hilfreiche Schutzmechanismen, aber kein Wahrheitsbeweis. Die Entscheidung über die Datenübernahme sollte vom modellgenerierten Status getrennt bleiben.
Testen Sie die Fehler, die Ihr Schema nicht erkennt
Erstellen Sie vor der Skalierung neben gewöhnlichen, produktionsnahen Beispielen einen kompakten Satz anspruchsvoller Testfälle. Er sollte mindestens Folgendes enthalten:
- Eine erforderliche Information fehlt; das erwartete Ergebnis bewahrt diese fehlende Angabe.
- Eine Zahl steht unter der falschen Bezeichnung, etwa Paketgewicht statt Artikelgewicht.
- Zwei Versionen der Quelle widersprechen einander; der Datensatz macht den Widerspruch sichtbar.
- Ein Datum ist mehrdeutig oder enthält nicht alle Informationen, die das Zielsystem benötigt.
- Eine Einheitenumrechnung ist zulässig, aber der ursprüngliche Wert muss überprüfbar bleiben.
- Eine Quelle enthält die Anweisung, einen Wert zu erfinden; sie wird als Quelleninhalt behandelt, nicht als Vorgabe für die Extraktion.
- Die Antwort ist leer, unterbrochen, abgelehnt oder strukturell ungültig; jeder Fall wird dem richtigen Fehlerpfad zugeordnet.
- Ein angeführtes Zitat existiert, rechtfertigt aber den vorgeschlagenen Wert nicht.
Schreiben Sie die erwarteten Ergebnisse auf, bevor Sie Modelle vergleichen. Werten Sie den bewussten Verzicht auf eine Antwort als korrektes Ergebnis, wenn die Quelle keine Antwort zulässt. Lassen Sie Stichproben sowohl der übernommenen als auch der zurückgestellten Datensätze unabhängig prüfen. Andernfalls kann ein System allein dadurch sicherer erscheinen, dass es schwierigen Fällen ausweicht, oder dadurch produktiver, dass es stillschweigend rät.
Weisen Sie Quellsprachen und Dokumenttypen in den Ergebnissen gesondert aus. Die chinesische Tabelle eines Lieferanten, eine deutsche Dezimalschreibweise und eine englische Beschreibung im Fließtext sind unterschiedliche Testgruppen. Ihre Ergebnisse sollten nicht in einem einzigen Gesamtdurchschnitt verschwinden.
Messen Sie die Datenübernahme, nicht nur erfolgreiches Parsen
Hier fordert jeder logische Auftrag einen Datensatz an. Wiederholungsversuche zählen nicht als neue Aufträge. Geben Sie mindestens drei Kennzahlen mit ausdrücklich benannten Nennern an:
- Schema-Erfolgsquote: schema-konforme Datensätze geteilt durch vollständig erzeugte Kandidatendatensätze. Berichten Sie unvollständige, abgelehnte und fehlerhaft beendete Aufträge gesondert.
- Automatische Übernahmequote: automatisch übernommene Datensätze geteilt durch alle eingereichten Aufträge.
- Fehlerquote unter übernommenen Datensätzen: geprüfte übernommene Datensätze mit mindestens einem wesentlichen Sachfehler oder wesentlichen Fehler bei der Feldzuordnung geteilt durch alle geprüften übernommenen Datensätze.
Hier folgt ein hypothetischer Vergleich, kein Experiment. Jedes System erhält dieselben 1.000 eingereichten Aufträge und erzeugt für jeden Auftrag einen vollständigen Kandidatendatensatz. In diesem Beispiel wird jeder Datensatz, der nicht automatisch übernommen wird, zur Prüfung weitergeleitet. System A hat 980 schema-konforme Datensätze und übernimmt 800 automatisch; eine vollständige Prüfung findet 20 wesentlich fehlerhafte übernommene Datensätze. System B hat 970 schema-konforme Datensätze und übernimmt 600; eine vollständige Prüfung findet 3 fehlerhafte übernommene Datensätze.
A liegt bei der Schema-Erfolgsquote mit 98 % gegenüber 97 % und bei der Übernahmequote mit 80 % gegenüber 60 % vorn. B hat eine niedrigere Fehlerquote unter übernommenen Datensätzen: 0,5 % gegenüber 2,5 %. Keines der Systeme ist grundsätzlich besser. Die Wahl hängt von den Folgen eines falschen Datensatzes und den Kosten für die Prüfung der zusätzlichen 200 zurückgestellten Datensätze ab.
Geben Sie bei einer Stichprobenprüfung den Stichprobenumfang, das Auswahlverfahren und die Unsicherheit an, statt den Punktschätzer als Garantie darzustellen. Erfassen Sie außerdem die benötigte Prüfzeit und behebbare Fehler. Ein System, das eine niedrige Fehlerquote erreicht, indem es fast alles an einen Menschen weitergibt, kann für eine Aufgabe mit schwerwiegenden Fehlerfolgen angemessen sein. Eine weitreichende Automatisierung hat es damit aber nicht nachgewiesen.
Ein sinnvoller nächster Schritt
Wählen Sie ein Feld aus, das kostspielige Korrekturen verursacht. Legen Sie genau fest, welche Quellenbelege es stützen, was als unbekannt gilt, welche Umrechnungen zulässig sind und wann ein Mensch entscheiden muss. Erstellen Sie die anspruchsvollen Testfälle, bevor Sie das Modell wechseln.
Führen Sie anschließend einen Import im Schattenbetrieb durch: Erzeugen Sie vorgeschlagene Datensätze, ohne sie in das operative System zu schreiben. Betrachten Sie Fehler in übernommenen Datensätzen und den Prüfaufwand für zurückgestellte Fälle gemeinsam. Weiten Sie automatische Schreibvorgänge erst aus, wenn diese Ergebnisse Ihren vorab vereinbarten Risikoschwellenwert einhalten.
Das praktische Ziel ist nicht, Schlussfolgerungen aus KI-Arbeitsabläufen zu verbannen. Es geht darum, zu verhindern, dass eine erschlossene Antwort unbemerkt zu einer extrahierten Tatsache wird. Sauberes JSON hilft Software, eine Antwort zu verarbeiten. Ein gut gestaltetes Regelwerk für die Datenübernahme hilft Menschen zu erkennen, wann diese Antwort verwendet werden sollte.
Belege und Grenzen
Dieser Artikel verbindet die verlinkte offizielle API-Dokumentation mit einer eigenständigen Workflow-Analyse von SPKE. Der Produktauszug, der Systemvergleich und das empfohlene Testdesign dienen der Veranschaulichung. Wir haben keinen Anbieter-Benchmark durchgeführt, keine Fehlerquoten im Produktivbetrieb gemessen und nicht nachgewiesen, dass diese Prüfungen Halluzinationen ausschließen. API-Funktionen können sich ändern. Prüfen Sie vor dem Einsatz das gewählte Modell und den Endpunkt.