
Vom Abakus über Zahnräder, Papierstreifen und Chips zu neuronalen Netzen und einem offenen Horizont. Eine eigens mit KI erzeugte Konzeptillustration, keine Aufnahme eines historischen Geschehens.
Legt man einen Abakus neben einen heutigen Computer, scheinen die beiden wenig gemeinsam zu haben. Bei dem einen bewegen Finger kleine Kugeln, der andere schreibt Code, erkennt Fotos und bedient sogar Software für uns. Trotzdem antworten beide auf dieselbe Frage: Lässt sich Arbeit aus dem Kopf nach außen verlagern?
Der Abakus machte den Stellenwert von Zahlen zum Bestandteil eines Gegenstands. Der Computer übernahm die Ausführung von Regeln. Maschinelles Lernen ging noch einen Schritt weiter: Menschen müssen nicht mehr sämtliche Regeln aufschreiben, die Maschine kann aus Beispielen lernen. Mit großen Sprachmodellen und Agenten beginnen wir, auch ganze Aufgaben abzugeben. Wir fragen nicht mehr nur nach einer Antwort, sondern lassen Informationen suchen, Programme schreiben und Fehler beheben, bis ein Ergebnis vorliegt.
Diese Entwicklung verlief nicht geradlinig. Es gab übertriebene Versprechen, versiegende Fördermittel und lange Phasen des Stillstands. Weiter ging es auch dank weniger fotogener Arbeit: besserer statistischer Methoden, größerer Datensätze, billigerer Chips und verlässlicherer Software. Die heutige plötzliche Beschleunigung entsteht, weil diese Vorarbeiten zusammenkommen.
Dieser Artikel wurde am 9/10/2026 geschrieben. Die erste Hälfte erzählt bereits geschehene Geschichte. Die zweite blickt auf die Zukunft der AGI, für deren Ankunft es kein allgemein anerkanntes Datum gibt. Wir werden eine Jahreszahl wagen, sie aber als Wette behandeln und nicht als Tatsache.
Zuerst lernte der Mensch, Zahlen auszulagern
Der Abakus ist ein guter Anfang für diese Geschichte. Als „erste Erfindung eines Stellenwertsystems durch die Menschheit“ sollte man ihn jedoch nicht bezeichnen. Antike Rechenbretter, Rechenstäbchen und Kugelabakusse gehören zu einer großen Familie; ihre Entstehung und Weiterentwicklung sind unterschiedliche Vorgänge. In China verdrängte der Kugelabakus die Rechenstäbchen etwa um das Jahr 1300 allmählich. Einer, Zehner und Hunderter bekamen jeweils ihren Platz, und Überträge mussten nicht mehr allein im Gedächtnis stattfinden. Darin liegt seine Bedeutung: Stellenwertrechnung wurde zu einer sichtbaren, greifbaren Handlung.[1]
Das Binärsystem löste ein anderes Problem: Lassen sich alle Zahlen mit nur zwei Zuständen darstellen? Leibniz erläuterte diese Arithmetik 1703 systematisch. Spätere elektronische Schaltungen konnten zwei stabile Zustände besonders gut unterscheiden, und so wurde das Binärsystem zur Grundlage moderner Computer. Denken kann es deshalb nicht. Es bietet eine Darstellung, die Maschinen gut speichern und verarbeiten können.[2]
Babbage begann 1834 mit dem Entwurf der Analytical Engine. Rechnen, Speichern und Programmsteuerung sollten in einer Maschine zusammenfinden. Zu seinen Lebzeiten wurde sie nicht vollständig gebaut, doch die Idee blieb. Ada Lovelace erörterte in ihren 1843 veröffentlichten Anmerkungen weiter, wie eine Maschine Symbole Schritt für Schritt verarbeiten könnte. Was eine Maschine leisten kann, hängt nicht nur von Zahnrädern oder Schaltungen ab, sondern auch davon, ob wir ein Problem als Programm ausdrücken können.[3] CHM
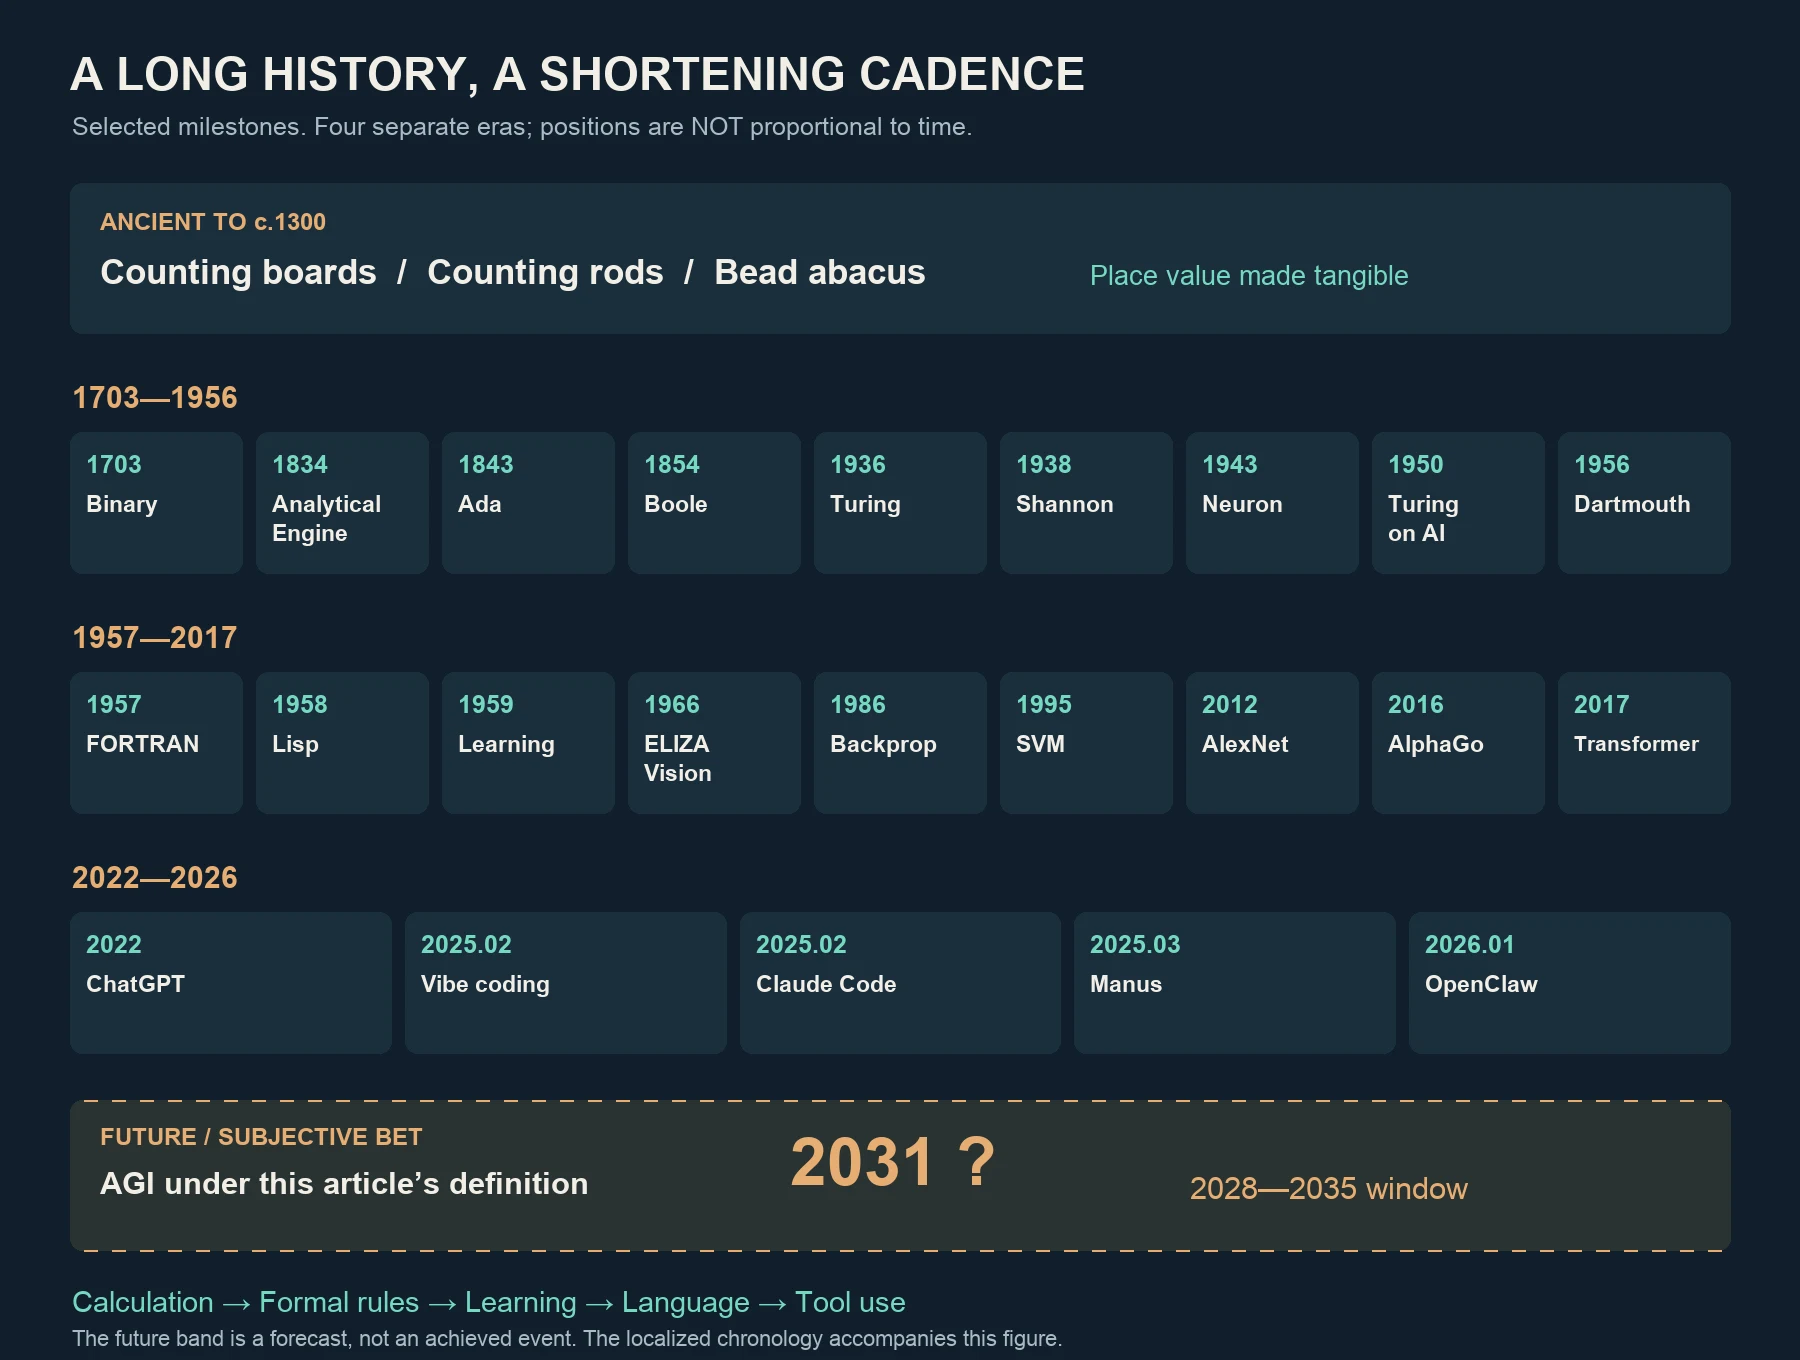
Die Geschichte des Rechnens erscheint in vier Epochen: Antike, 1703–1956, 1957–2017 und 2022–2026. Die Ereignisse stehen chronologisch, doch die Abstände bilden keine Zeitdauer ab. Das gestrichelte Feld zeigt eine subjektive Wette auf 2031 im Zeitfenster 2028–2035, kein bereits eingetretenes Ereignis. Die Bezeichnungen entsprechen der folgenden Chronologie.
| Zeit | Meilenstein | Was davon blieb |
|---|---|---|
| Antike; um 1300 | Rechenbretter, Rechenstäbchen und Kugelabakusse | Rechnen lässt sich auf äußere Hilfsmittel übertragen; Stellenwerte und Überträge werden zu Handlungen.[1] |
| 1703 | Leibniz erläutert das Binärsystem systematisch | Zwei Zeichen stellen Zahlen dar und liefern eine geeignete Repräsentation für spätere digitale Schaltungen.[2] |
| 1834; 1843 | Entwurf der Analytical Engine; Lovelaces Anmerkungen | Rechnen, Speichern und Programmsteuerung beginnen zusammenzufinden; die Vorstellung eines Programms reicht über einzelne Rechenoperationen hinaus.[3] CHM |
| 1854 | Boolesche Algebra | Logik lässt sich algebraisch ausdrücken und wird später zu einem wichtigen Denkwerkzeug bei der Analyse digitaler Schaltungen.[4] |
| 1936 | Turing stellt ein abstraktes Rechenmodell vor | Die Turingmaschine formalisiert regelgeleitetes Rechnen und zeigt zugleich dessen Grenzen.[5] |
| 1938 | Shannons Arbeit über Schaltkreise | Boolesche Logik wird mit Relaisschaltungen verbunden.Originalarbeit |
| 1943 | Modell künstlicher Neuronen von McCulloch und Pitts | Eine einflussreiche mathematische Verbindung zwischen neuronaler Aktivität und logischen Operationen entsteht.Originalarbeit |
| 1950 | Turing veröffentlicht „Computing Machinery and Intelligence“ | Die Frage, ob Maschinen denken können, wird auf ihr beobachtbares Verhalten in einer Interaktion gelenkt.Originaltext |
| 1955; 1956 | Dartmouth-Vorschlag; Sommerforschungsprojekt | „Künstliche Intelligenz“ wird zum Namen eines Forschungsprogramms und anschließend eines ganzen Fachgebiets.[6] |
| 1957; 1958 | FORTRAN; Lisp | Die erste Sprache treibt wissenschaftliches Rechnen voran, die zweite wird für die frühe KI wichtig.[7][8] |
Die Turingmaschine ist kein fertiger intelligenter Computer. Sie ist ein abstraktes Modell, das beschreibt, was Rechnen nach endlichen Regeln bedeutet. Turings Arbeit von 1936 versprach auch nicht, dass „jedes Problem irgendwann berechnet werden kann“. Dieser Unterschied ist wesentlich: Kein späterer Erfolg der KI hat die Grenzen der Probleme selbst aufgehoben.[5]
In den 1950er Jahren begannen Forscher, Maschinen nicht mehr nur „schnell rechnen“, sondern „intelligent handeln“ zu lassen. Der Dartmouth-Vorschlag entstand 1955, das Forschungsprojekt fand im Sommer 1956 statt. Hier liegt ein wichtiger Ausgangspunkt der modernen KI, nicht aber die erste menschliche Vorstellung einer künstlichen Intelligenz. Programmiersprachen machten es danach möglich, sich weniger mit einzelnen Maschinenbefehlen und stärker mit Symbolen, Suche und Schlussfolgerungen zu beschäftigen.[6][7][8]
Maschinen lernen zu sehen, zu hören und zu schätzen
Die frühe KI setzte großes Vertrauen in Regeln. Wenn man das Wissen von Experten nur aufschrieb, schien eine Maschine Krankheiten beurteilen, Sätze verstehen oder Geräte steuern zu können. Die Schwierigkeiten zeigten sich rasch: Die Wirklichkeit hat zu viele Ausnahmen, und gesunder Menschenverstand lässt sich kaum vollständig formulieren. Regelsysteme verschwanden nicht, doch der Schwerpunkt der Forschung verlagerte sich allmählich auf einen pragmatischeren Weg: ausreichend Beispiele liefern, damit die Maschine lernt, mit Unsicherheit umzugehen.
Die Bilderkennung untersucht, wie sich Objekte aus Pixeln erkennen lassen; die Spracherkennung, wie aus Lauten Text wird; die Verarbeitung natürlicher Sprache, kurz NLP, beschäftigt sich mit Struktur, Bedeutung und Gebrauch von Sprache. Lange verfolgten diese Gebiete eigene Wege. Erst mit Deep Learning und multimodalen Modellen fanden sie zunehmend zusammen.
| Zeit | Meilenstein | Was davon blieb |
|---|---|---|
| 1952 | Audrey, das Ziffern-Spracherkennungssystem der Bell Labs | Unter eingeschränkten Bedingungen kann eine Maschine gesprochene Ziffern erkennen; von einem freien Gespräch ist das weit entfernt.Historischer Bericht des CHM |
| 1958 | Rosenblatts Perzeptron-Arbeit | Parameter werden anhand von Trainingsbeispielen angepasst; daraus entsteht eine wichtige Richtung des frühen maschinellen Lernens.[10] |
| 1959 | Samuels Arbeit über maschinelles Lernen beim Damespiel | Eine Maschine kann durch Erfahrung besser werden; Algorithmus und Lernziel müssen weiterhin Menschen entwerfen.[9] |
| 1966 | ELIZA | Schon einfache Textregeln können das Gefühl erzeugen, verstanden zu werden; flüssige Gespräche sind kein Beweis für echtes Verständnis.[11] |
| 1966 | MIT-Sommerprojekt zur Bildverarbeitung | Forscher versuchen, Bildstrukturen in maschinenlesbare Beschreibungen zu übersetzen; die Aufgabe erweist sich später als viel schwieriger als erwartet.Originaldokument |
| 1970—1980er Jahre | KI-Winter sowie Aufstieg und Rückgang der Expertensysteme | Erwartungen, Rechenleistung und tatsächliche Fähigkeiten passen nicht zusammen; KI hat sich nie in einer stetig steigenden Kurve entwickelt.[12] CHM |
| 1986 | Eine prägende Arbeit zur Backpropagation | Eine einflussreichere Trainingsmethode erleichtert das wirksame Lernen mehrschichtiger Netze; verwandte Ideen entstehen nicht erst in diesem Jahr.[13] |
| 1980—1990er Jahre | Statistische Spracherkennung und statistisches NLP | Wahrscheinlichkeiten helfen bei Mehrdeutigkeit und Rauschen und verdrängen allmählich die Hoffnung, sämtliche Regeln aufschreiben zu können.Überblick zur Spracherkennung; Arbeit zur statistischen Übersetzung |
| 1995 | Cortes und Vapnik veröffentlichen ihre Arbeit zu Support Vector Machines | Auch bei wenigen Beispielen lassen sich robuste Klassengrenzen bilden; SVM werden zu einem wichtigen Werkzeug des maschinellen Lernens.[14] |
| 1997 | Deep Blue schlägt Kasparow | Ein spezialisiertes System kann Spitzenspieler übertreffen; seine Schachstärke wird dadurch nicht automatisch zu allgemeiner Fähigkeit.[15] |
| 1998 | Eine prägende Arbeit zu LeNet | Faltungsnetze zeigen praktischen Nutzen, etwa bei handschriftlichen Ziffern und der Dokumentenerkennung.[16] |
| 2000—2010er Jahre; 2013 | Klickprognosen im großen Maßstab; eine prägende Google-Arbeit | Maschinelles Lernen erreicht kommerzielle Entscheidungen in Echtzeit und verbessert Vorhersagen anhand riesiger Mengen von Rückmeldungen.[19] |
| 2009; 2012 | ImageNet-Datensatz; AlexNet | Große Datenmengen, GPUs und tiefe Netze kommen zusammen; die Bilderkennung erzielt einen deutlichen Durchbruch.[17][18] |
| 2012 | Überblick zu tiefen neuronalen Netzen in der Spracherkennung | Deep Learning verändert die akustische Modellierung und eröffnet eine neue Verbesserungsphase für Sprachsysteme.Forschungsüberblick |
| 2014 | GAN | Adversarielles Training erweitert die Wege für generative Modelle.Originalarbeit |
| 2016; 2017 | AlphaGo schlägt Lee Sedol und anschließend Ke Jie | Tiefe Netze, Suche und bestärkendes Lernen werden kombiniert und bewältigen die zuvor äußerst schwierige Go-Aufgabe.[20] BGA |
| 2017 | Transformer | Der Aufmerksamkeitsmechanismus ermöglicht eine Architektur, die sich besser parallel trainieren lässt, und wird zur wesentlichen Grundlage späterer großer Sprachmodelle.[21] |
| 2018 | BERT | Bidirektionales Vortraining bringt Aufgaben des Sprachverständnisses voran; Modelle beginnen, allgemeinere Sprachrepräsentationen zu teilen.Originalarbeit |
| 2020 | GPT-3 | Prompts mit wenigen Beispielen zeigen, dass große Modelle über den Kontext unterschiedliche Aufgaben lösen können; die Verlässlichkeit bleibt begrenzt.[22] |
| 2020 | DDPM | Entrauschende Diffusionsmodelle bringen die Bilderzeugung voran; sie markieren nicht den Beginn sämtlicher Diffusionsideen.Originalarbeit |
| 2020; 2021 | AlphaFolds Durchbruch bei CASP14; Methodenarbeit | Die Vorhersage von Proteinstrukturen macht große Fortschritte; eine Strukturvorhersage bedeutet nicht, dass ein neues Medikament bereits geprüft ist.Originalarbeit |
Support Vector Machines, kurz SVM, verkörpern den Geist dieser Zeit besonders gut: Auch ohne heutige Chatfenster konnte maschinelles Lernen ernsthafte, konkrete Probleme lösen. Spam erkennen oder ein Bild einer Kategorie zuordnen war oft nützlicher, als einer Maschine Gedanken zuzuschreiben.[14]
Die Vorhersage von Werbeklicks brachte diese Fähigkeit auf industriellen Maßstab. Das System schätzt „die Wahrscheinlichkeit, dass diese Werbeeinblendung in diesem Kontext angeklickt wird“, gewöhnlich als CTR bezeichnet. Das ist kein Gedankenlesen und keine Garantie, dass ein bestimmter Nutzer klicken wird. Wahrscheinlichkeiten müssen kalibriert werden; zudem begegnen den Systemen veränderte Datenverteilungen, Datenschutzanforderungen und verzerrte Rückmeldungen. Entscheidend ist, dass maschinelles Lernen hier in einen fortlaufenden Kreislauf gelangt, der Einnahmen und die Verteilung von Informationen beeinflusst.[19]
Der Durchbruch bei der Bilderkennung 2012 ließ viele Menschen wieder an neuronale Netze glauben. AlphaGo trug diesen Wandel 2016 in die Öffentlichkeit. Das 4:1 war das Ergebnis einer Herausforderung über fünf Partien gegen Lee Sedol, kein Titelgewinn bei einer Weltmeisterschaft; die Begegnung über drei Partien gegen Ke Jie endete 2017 mit 3:0. Die Siege waren erstaunlich genug, ohne ihnen einen unzutreffenden „Weltmeistertitel“ anzuhängen.[18][20] BGA
Nach ChatGPT geht es nicht mehr nur um Antworten, sondern um Ergebnisse
Am 30/11/2022 wurde ChatGPT öffentlich zugänglich. Seine Bedeutung lag nicht nur im stärkeren Modell. Erstmals bekamen Menschen ohne Fachkenntnisse einen ausgesprochen einfachen Zugang: Sie mussten nicht programmieren können, sondern konnten direkt um Erklärungen, Überarbeitungen, Übersetzungen und Programme bitten. KI wurde von einer Fähigkeit im Hintergrund vieler Produkte zu etwas, das Menschen gezielt selbst verwendeten.[23]
Die nächste Entwicklung reichte bald über das Chatfenster hinaus. Modelle konnten mehr Material lesen und wurden mit Suche, Dateien, Codeausführung und Browsern verbunden. Ein Agent ist hier ein Ausführungssystem, das um ein Modell herum aufgebaut ist: Es hält den Aufgabenstand fest, ruft Werkzeuge auf, prüft Ergebnisse und entscheidet über den nächsten Schritt. Das Modell zieht Schlüsse, das Ausführungssystem verbindet diese mit der Welt. Beide können Fehler machen.
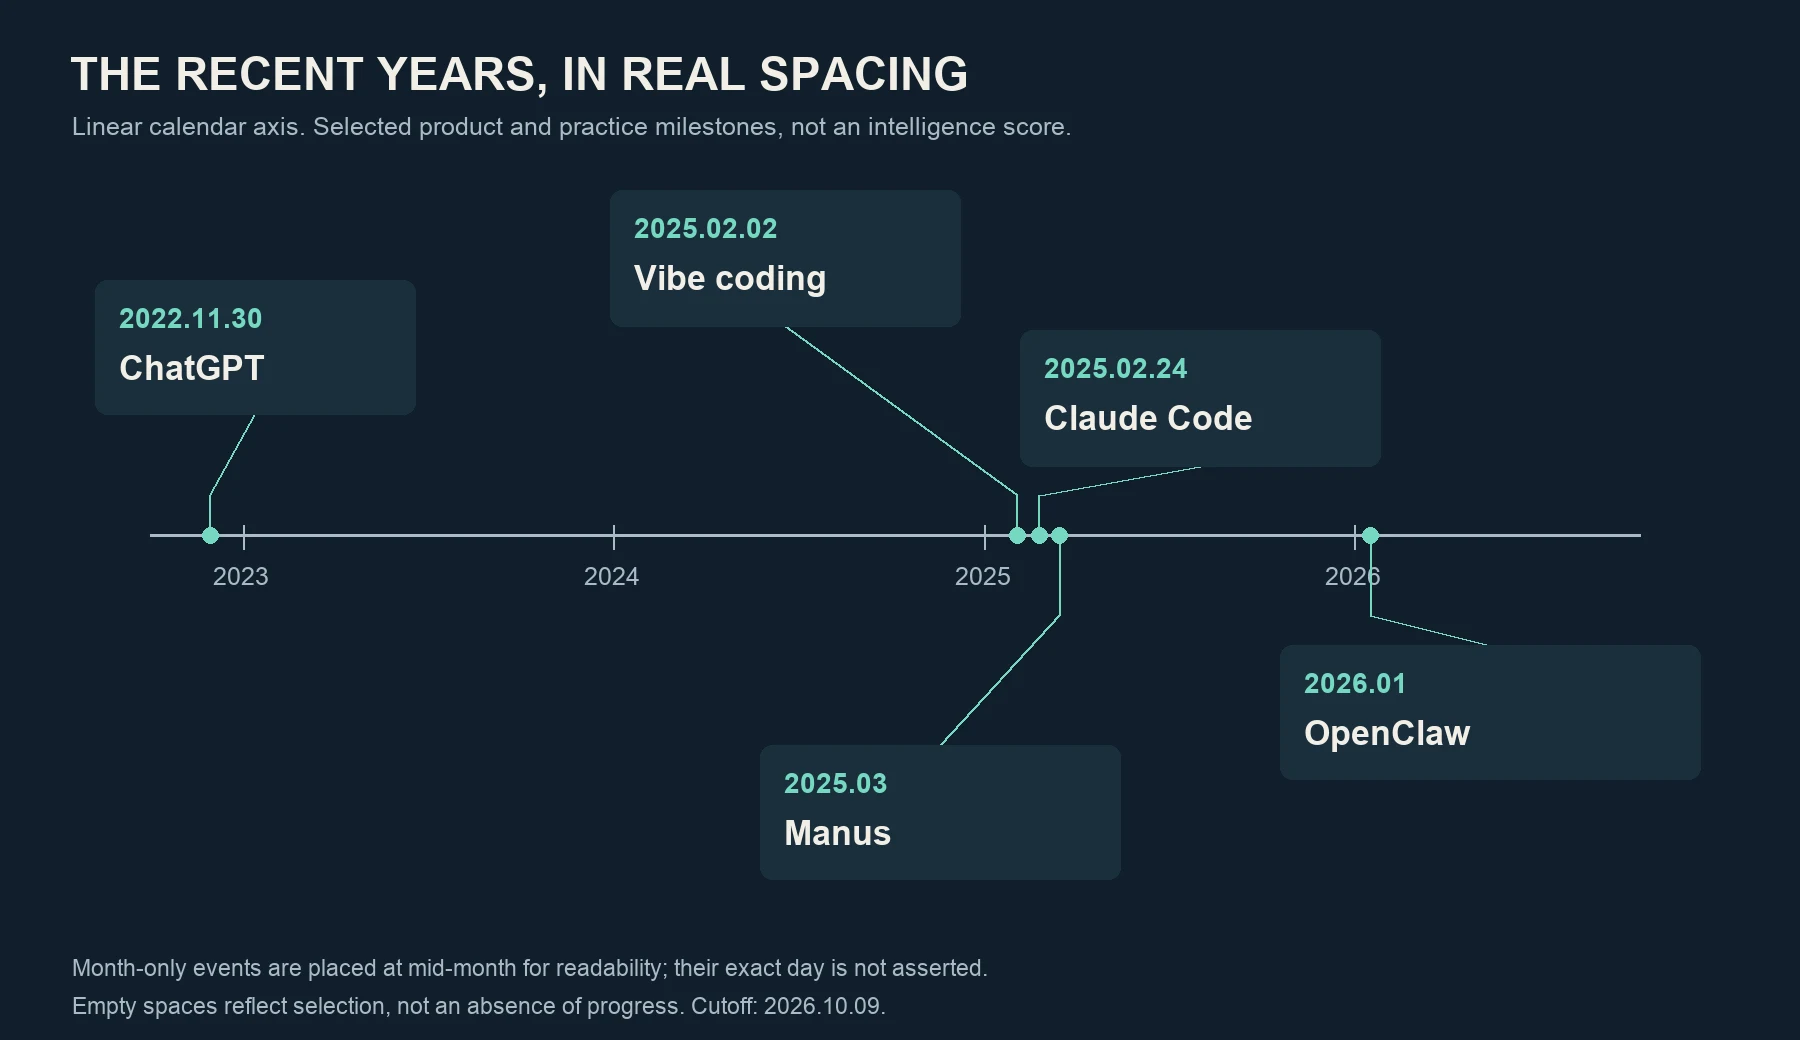
Die jüngere Zeitleiste für 2022—2026 verwendet eine lineare Jahresachse: Die Punkte für ChatGPT, vibe coding, Claude Code, Manus und OpenClaw liegen deutlich näher beieinander. Aufgenommen sind nur die für diesen Artikel ausgewählten Ereignisse; ihre Anzahl ist kein Maß für allgemeine Intelligenz. Nur monatsgenau bekannte Ereignisse stehen in der Monatsmitte; damit wird kein konkreter Tag behauptet.
| Zeit | Meilenstein | Wie er einzuordnen ist |
|---|---|---|
| 30/11/2022 | ChatGPT wird öffentlich vorgestellt | Natürliche Sprache wird für die breite Öffentlichkeit zum Zugang zu generativer KI.[23] |
| 2/2025 | Der Ausdruck „vibe coding“ verbreitet sich | Karpathy beschreibt eine Praxis, die stark auf generierten Code setzt und das zeilenweise Verständnis zurücknimmt; der Begriff bezeichnet nicht jede KI-gestützte Entwicklung.Spiegel des Originalbeitrags |
| 24/2/2025 | Claude Code erscheint als Forschungsvorschau | Der Programmierassistent kommt ins Terminal und kann mit Codebeständen und Werkzeugen arbeiten.[24] |
| 3/2025 | Manus wird erstmals öffentlich vorgestellt | Das Agentenprodukt für mehrstufige Aufgaben rückt „Erledige das für mich“ in den Vordergrund.[25] |
| 1/2026 | OpenClaw erhält seinen Namen und verbreitet sich öffentlich | Nachrichtenzugänge, dauerhafter Zustand und Werkzeugverbindungen eines selbst verwalteten persönlichen Agenten finden Aufmerksamkeit; es handelt sich um ein Ausführungssystem, nicht um ein neues Basismodell.[26] |
Claude Code und vibe coding stehen oft im selben Satz, sind aber nicht gleichzusetzen. Das eine ist ein Werkzeug, das andere eine Art, es zu nutzen. Professionelle Entwickler können dasselbe Werkzeug verwenden und trotzdem den Code sorgfältig lesen, Änderungen prüfen und Tests ausführen. Dass die Maschine schneller schreibt, nimmt niemandem automatisch die Verantwortung ab.[24] Spiegel von Karpathys Originalbeitrag
Manus und OpenClaw stehen für zwei charakteristische Produktentscheidungen: mehrstufige Aufgaben an einen Dienst abgeben oder einen ständig verfügbaren Assistenten mit der eigenen Umgebung verbinden. Sie zeigen das Potenzial selbstständiger Ausführung und bringen zugleich neue Schwierigkeiten ans Licht: Wie weit dürfen Befugnisse reichen? Wie entdeckt man Fehlschläge? Wie macht man bereits falsch ausgeführte Schritte rückgängig? Diese Fragen sind nicht weniger wichtig als die Antwortfähigkeit des Modells.[25][26]
Die Beschleunigung ist real – nur was beschleunigt sich?
Wissen festzuhalten und weiterzugeben brauchte eine lange Menschheitsgeschichte. Regeln an elektronische Maschinen zu übertragen dauerte Jahrzehnte. Vom Chatassistenten für jedermann zur Ausführung mit alltäglichen Werkzeugen vergingen dann nur noch wenige Jahre. Innerhalb eines Menschenlebens ist diese Verdichtung stark zu spüren. Früher konnte man nach dem Erwachsenwerden mit derselben Arbeitsweise durch ein ganzes Berufsleben kommen; heute können sich Zugänge und Fähigkeitsgrenzen innerhalb weniger Jahre wiederholt verschieben.
Man kann sagen: Bei vielen kognitiven Werkzeugen hat sich der Erneuerungszyklus von mehreren Generationen auf ein Menschenleben verkürzt, dann von Jahrzehnten auf wenige Jahre. Daraus folgt aber nicht, dass die letzten Jahre insgesamt „mehr Fortschritt“ gebracht hätten als die Jahrzehnte zuvor oder diese Jahrzehnte mehr als die gesamte biologische Evolution des Menschen. Für solche Vergleiche fehlt ein gemeinsamer Maßstab. Steinwerkzeuge, Schrift, Landwirtschaft, industrielle Revolution und Sprachmodelle sind keine Punktwerte, die sich einfach addieren lassen.
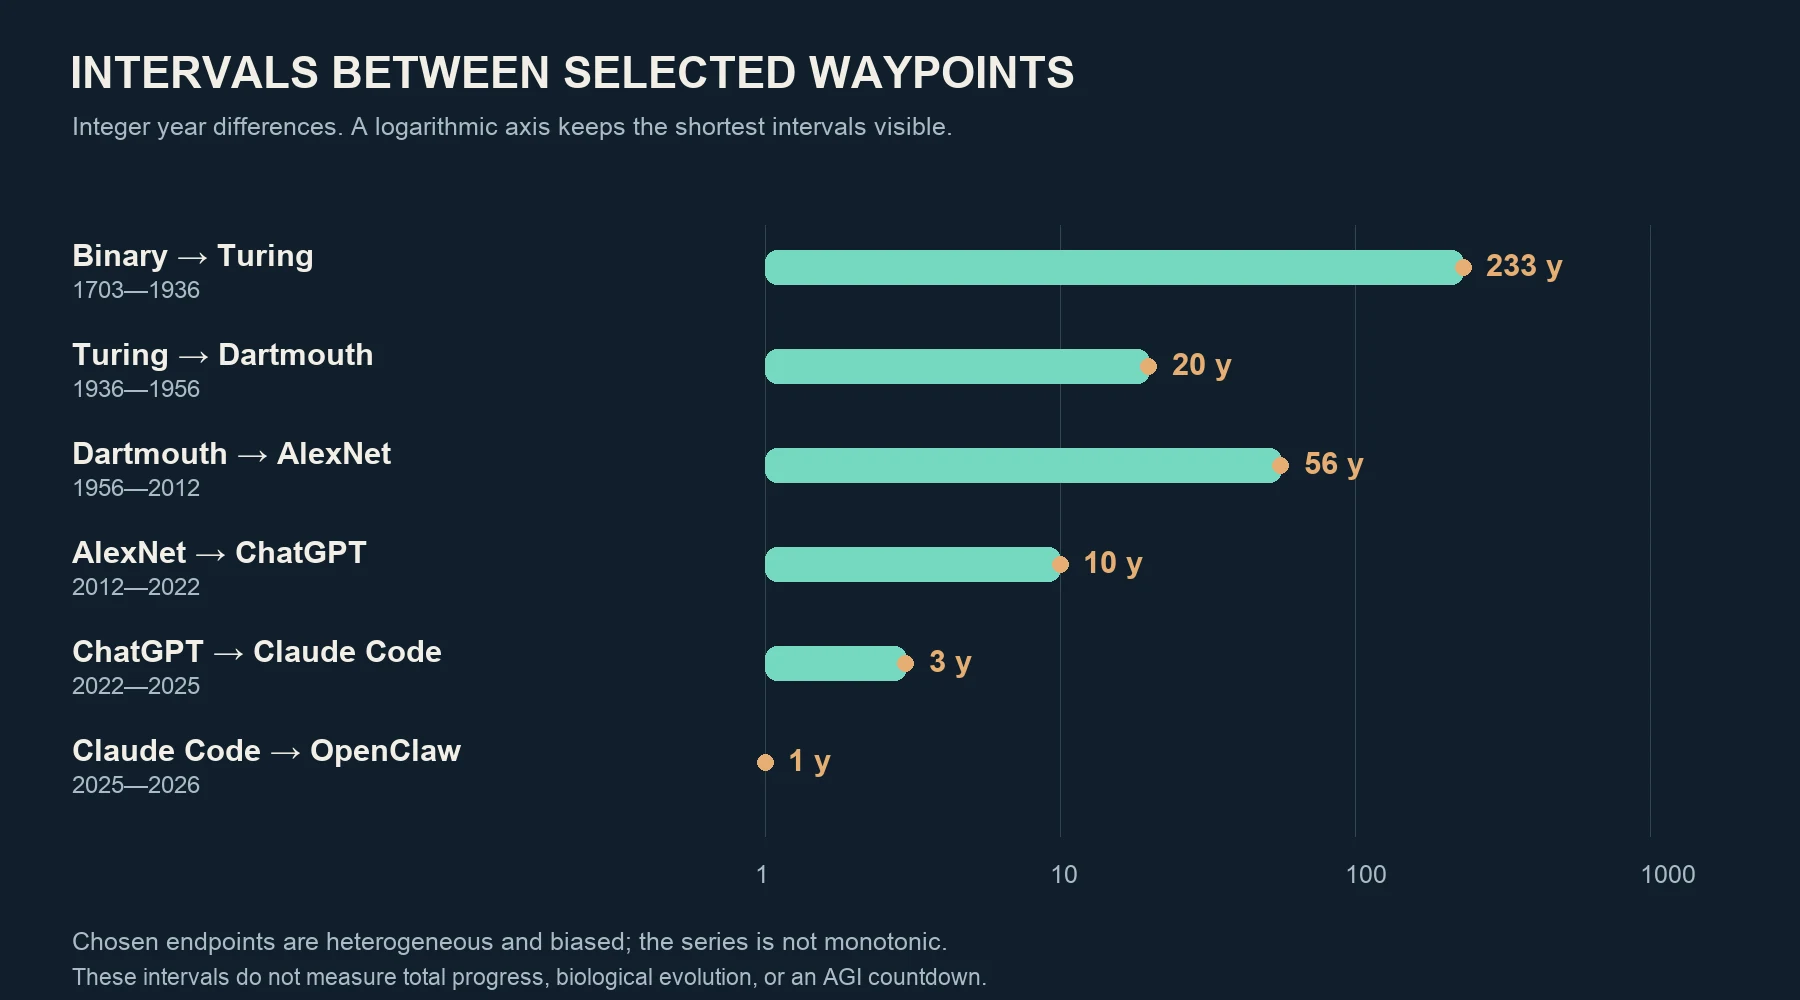
Abstände zwischen ausgewählten Ereignissen: 1703—1936 sind 233 Jahre, 1936—1956 sind 20 Jahre, 1956—2012 sind 56 Jahre, 2012—2022 sind 10 Jahre, 2022—2025 sind 3 Jahre und 2025—2026 ist 1 Jahr. Die Balkenlängen folgen einem logarithmischen Maßstab; die Werte sind Differenzen ganzer Jahreszahlen. Die Auswahl ist verzerrt und die Abstände sinken nicht durchgehend. Daraus lässt sich keine Wachstumsrate der Intelligenz ableiten.
Belastbarere Belege für Beschleunigung liefern konkrete Kennzahlen. Stanfords AI Index 2025 hält fest: Für eine MMLU-Leistung auf dem Niveau von GPT-3.5 sanken die Inferenzkosten von 20 Dollar je Million Token in 11/2022 auf 0.07 Dollar in 10/2024, also um mehr als den Faktor 280. Verglichen werden Kosten bei einer bestimmten Fähigkeitsschwelle. Das bedeutet nicht, dass sämtliche Modelle im gleichen Verhältnis günstiger wurden.[28]
Eine 2025 veröffentlichte METR-Studie beobachtete eine Veränderung, die näher an der Frage „Wie lange Aufgaben kann das System bewältigen?“ liegt. In ihrem Datensatz aus Software- und Denkaufgaben verdoppelte sich die menschliche Expertenarbeitszeit, die Aufgaben mit einer Erfolgsquote von 50% bei führenden KI-Systemen entspricht, seit 2019 ungefähr alle 7 Monate. Gemeint ist die Zeit, die ein Mensch für die Aufgabe benötigt; jede zweite Aufgabe zu schaffen ist noch keine verlässliche Lieferung. Die Untersuchung gibt Anlass zur Extrapolation, setzt ihrer Übertragung auf die Wirklichkeit aber zugleich enge Grenzen.[27]
Beschleunigung kann ihre eigenen Voraussetzungen schaffen. Bessere KI hilft beim Schreiben von Software, bei Experimenten und bei der Optimierung von Systemen; das wiederum kann die nächste KI-Generation verbessern. Doch eine Rückkopplung ist nicht zwangsläufig unbegrenzt. Datenqualität, Energie, Chips, Experimentiergeschwindigkeit, Verlässlichkeit und Einführung in Organisationen können bremsen. Die früheren Flauten erinnern daran: Eine Kurve kann eine Zeit lang steigen und trotzdem später Stufen und Rückschläge enthalten.
Ich tippe auf 2031 – aber zuerst muss die AGI-Schwelle feststehen
AGI wird gewöhnlich als allgemeine künstliche Intelligenz verstanden. Wie allgemein sie sein muss, ist jedoch nicht einheitlich beantwortet. Manche erwarten die Abdeckung der meisten wirtschaftlichen Aufgaben, andere betonen das Erlernen unbekannter Fähigkeiten, wieder andere rechnen Autonomie hinzu. Forschung zu AGI-Stufen trennt Leistungsniveau, Breite und Selbstständigkeit. Das hilft mehr, als über ein Schlagwort zu streiten.[29]
Dieser Artikel betrachtet nur eine praktische AGI: In einer digitalen Umgebung mit ausdrücklich festgelegten Befugnissen kann sie neue Aufgaben erlernen und ein breites Spektrum professioneller kognitiver Arbeit dauerhaft zu vertretbaren Kosten erledigen. Dafür braucht sie weder Bewusstsein noch einen menschlichen Körper. Gemeint ist auch keine Superintelligenz, die auf allen Gebieten jeden Menschen übertrifft.
Damit sich die Prognose später prüfen lässt, legen wir eine künstlich gesetzte Schwelle fest. Das ist die Arbeitsdefinition dieses Artikels, kein Branchenstandard und keine Sicherheitszertifizierung:
| Prüfkriterium | Schwelle dieses Artikels |
|---|---|
| Breite | In mindestens 5 von 6 Aufgabenfeldern – Softwareentwicklung, Informationsanalyse, Forschungsunterstützung, multimodales Verständnis, Planung und Erlernen neuer Werkzeuge – das mediane Leistungsniveau qualifizierter Menschen erreichen. |
| Unbekannte Aufgaben | Je Feld mindestens 100 nicht öffentliche Aufgaben; Lecks aus Trainingsdaten kontrollieren, angemessene Werkzeugnutzung und das Erlernen neuer Aufgaben zulassen. |
| Verlässlichkeit | In jedem Feld, das die Schwelle erreicht, mindestens 90% Aufgabenerfolg; bewertet wird anhand vorab festgelegter, überprüfbarer Kriterien. |
| Lange Aufgaben | Die Tests umfassen Aufgaben, für die menschliche Experten mindestens 8 Stunden benötigen; pro Aufgabe höchstens 2 menschliche Klarstellungen, ohne fortwährende Rettung durch Menschen. |
| Kosten | Inferenz, Werkzeuge, Prüfung und Nacharbeit zählen mit; die Kosten je Aufgabe liegen nicht über denen menschlicher Arbeit nach demselben Abnahmestandard. |
| Wiederholbarkeit | Mindestens 2 unabhängige Bewertungsstellen reproduzieren die Ergebnisse; das System hält diese Leistung über 90 Tage fortlaufender Prüfung, statt nur eine beeindruckende Vorführung abzuliefern. |
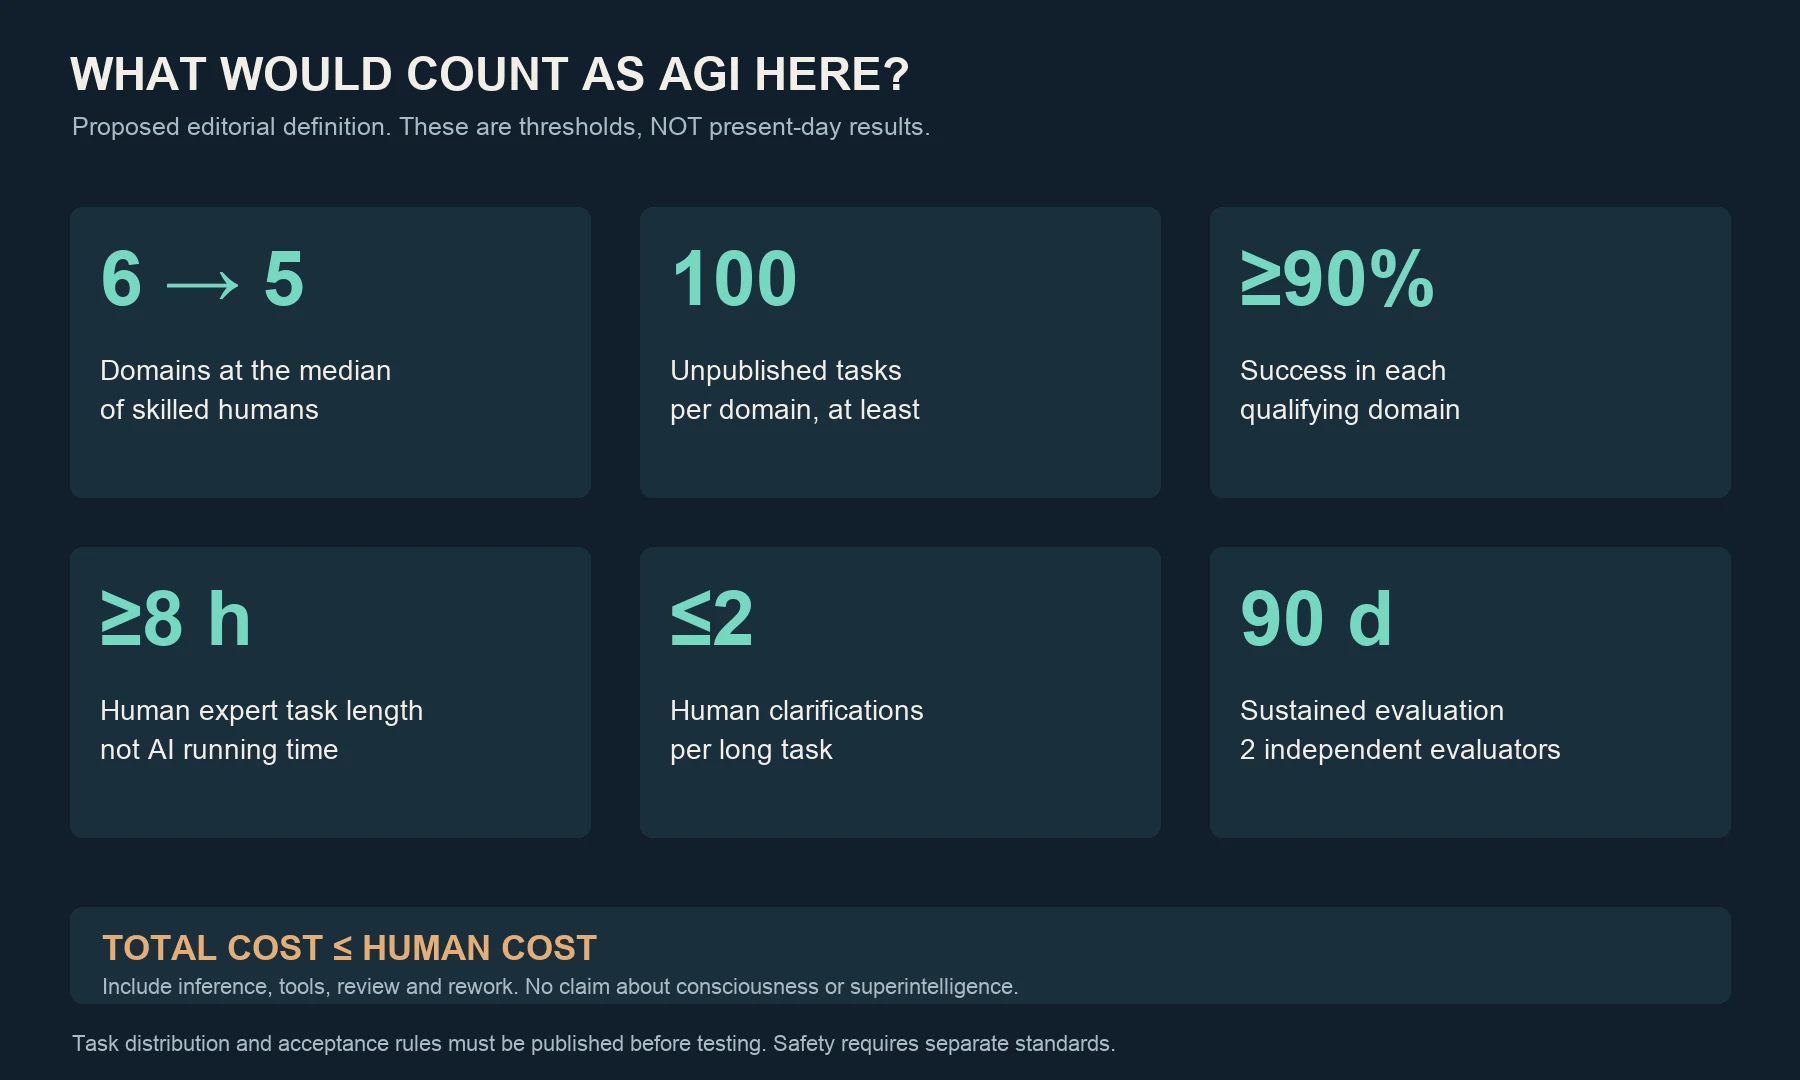
Die hier gesetzte AGI-Schwelle: mindestens 5 von 6 Aufgabenfeldern, 100 nicht öffentliche Aufgaben, 90% Erfolgsquote, lange Aufgaben von 8 menschlichen Arbeitsstunden, höchstens 2 Klarstellungen und Wiederholung über 90 Tage. Diese Zahlen sind gesetzte Abnahmeanforderungen, keine Messwerte heutiger Systeme und kein allgemein anerkannter AGI-Standard.
Auch diese Kriterien sind umstritten. Aufgabenauswahl, Rekrutierung qualifizierter Menschen und Bewertung von Forschungsunterstützung müssen vorab veröffentlicht werden. Bei Aufgaben, die die körperliche Sicherheit betreffen, kommen gesonderte fachliche und regulatorische Maßstäbe hinzu. Die Kriterien sollen das Gefühl „Wir sind wohl schon da“ durch ein Urteil ersetzen, das sich hinterfragen, erneut prüfen und widerlegen lässt.
Wenn ich eine Jahreszahl setzen muss, tippe ich auf 2031. Lieber beobachte ich das Fenster 2028—2035, als einen Monat oder Tag zu erraten. Die folgenden subjektiven kumulierten Wahrscheinlichkeiten gelten zum Datum dieses Artikels und beziehen sich auf die erste unabhängige Bestätigung nach den genannten Kriterien. Sie sind nicht durch ein statistisches Modell kalibriert und bilden keinen Expertenkonsens ab:
| Erste Bestätigung | Meine subjektive kumulierte Wahrscheinlichkeit |
|---|---|
| Bis Ende 2028 | 20% |
| Bis Ende 2031 | 50% |
| Bis Ende 2035 | 75% |
| Nach 2035 oder falls die heutigen Ansätze diese Schwelle letztlich nicht erreichen | Die übrigen 25% |
2031 ist der Median dieser subjektiven Verteilung, keine technische Frist. Die 75% bis 2035 enthalten bereits die früheren Wahrscheinlichkeiten; die Zeilen dürfen nicht addiert werden. Die übrigen 25% bedeuten auch nicht, dass AGI niemals kommt. Sie umfassen sowohl eine spätere Ankunft als auch das Scheitern der heutigen Ansätze.
Ich setze darauf, weil Sprache, Bildverarbeitung, Programmierung und Werkzeugnutzung zusammenfinden und auch Fähigkeiten bei langen Aufgaben und Kosten ernst zu nehmende Trends zeigen. Der schwierigste Teil könnte allerdings gerade am Ende warten: dauerhaft neue Fertigkeiten erlernen, eigene Fehler erkennen, in unbekannten Umgebungen verlässlich bleiben und Arbeiten bewältigen, die Rückmeldung aus Experimenten brauchen. Sind diese Hürden hartnäckiger als gedacht, muss die Jahreszahl nach hinten rücken.[27][28][29]
Was würde meine Einschätzung verändern? Verbessern sich die Erfolgsquoten langer Aufgaben mit wenig menschlichem Eingriff, die Übertragung auf unbekannte Aufgaben und die Gesamtkosten stetig und unabhängig reproduzierbar, würde ich eine frühere Ankunft wahrscheinlicher finden. Steigen Ranglisten dagegen hauptsächlich durch vertraute Fragen, werden lange Aufgaben weiterhin von Menschen weitergereicht oder stockt der Kostenrückgang, würde ich die Wahrscheinlichkeit senken. Mehr Produktveranstaltungen und immer mehr Vorführungen allein reichen nicht aus.
Die Ankunft von AGI könnte auch ohne einen klaren Glockenschlag geschehen. Manche Menschen merken zuerst bei der Arbeit, dass sie ihnen bereits genügt; andere erleben weiterhin Fehlschläge. Bewertungsstellen bestätigen die Fähigkeiten, und die Gesellschaft verändert sich erst danach allmählich. Eine technische Schwelle zu überschreiten, ein Produkt einzuführen und Institutionen anzupassen sind verschiedene Zeitpunkte.
Die optimistische Zukunft: Menschliche Fähigkeiten werden weniger knapp
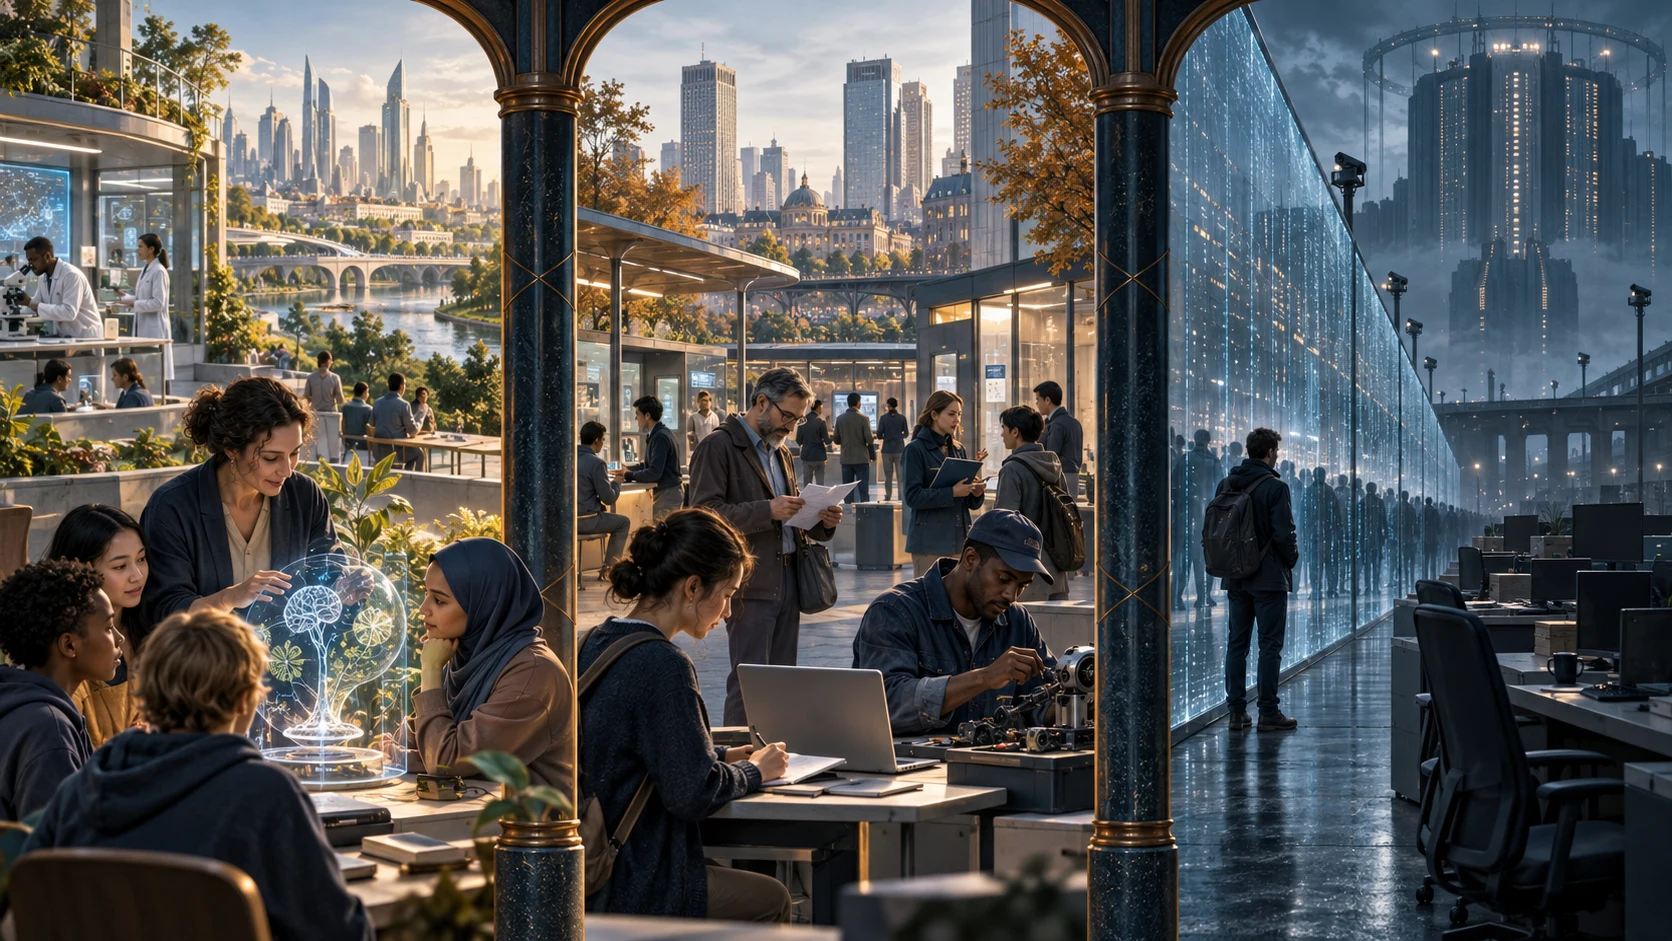
Links gemeinsames Wissen und medizinischer Fortschritt, in der Mitte beruflicher Wandel und alltägliche Anpassung, rechts Machtkonzentration und Arbeitslosigkeitsdruck. Eine eigens mit KI erzeugte Konzeptillustration bedingter Zukunftsbilder, keine Darstellung ihrer Eintrittswahrscheinlichkeiten.
Die optimistische Zukunft setzt voraus, dass Fähigkeiten breit zugänglich sind, Systeme verlässlich eingesetzt werden und die Gesellschaft Produktivitätsgewinne mit mehr Menschen teilt. Können sich nur wenige Institutionen die besten Systeme leisten, verändert sich die Geschichte schon am Anfang.
In der Wissenschaft könnte AGI bei Literaturrecherche, dem Entwurf möglicher Experimente und der Auswertung helfen und wiederkehrende Arbeit beim Ausprobieren verringern. Ein kleines Team hätte womöglich die Rechen- und Analysefähigkeiten, für die früher ein großes Team nötig war. Forschung an Medikamenten, Werkstoffen und Energie könnte sich beschleunigen. Kandidatenmoleküle müssen dennoch geprüft werden, klinische Studien brauchen weiterhin Zeit, und Laborausrüstung lässt sich nicht durch Textgenerierung herstellen. Die optimistische Veränderung besteht darin, verlässliche Ergebnisse schneller zu finden – nicht darin, das Verschwinden von Krankheiten über Nacht zu versprechen.
In Bildung und Gesundheitsversorgung könnten Menschen günstiger dauerhafte, geduldige Hilfe bekommen. Lehrer hätten mehr Zeit für Unterschiede zwischen Schülern, Ärzte mehr Zeit, die Lebenslage ihrer Patienten zu verstehen. Abgelegene Regionen erhielten vielleicht zunächst eine verlässlichere Aufbereitung von Informationen, erste Untersuchungen und Unterstützung aus der Ferne. Damit daraus eine gerechte Verbesserung wird, braucht es erreichbare Netze, örtliche Sprachen, Datenschutz und Menschen, die für die letzte Entscheidung verantwortlich bleiben.
Auch Arbeit könnte mehr Spielraum lassen. Viele wiederkehrende Schreib-, Prüf- und Koordinationsaufgaben würden wegfallen; Menschen hätten mehr Zeit für Austausch, Urteilsbildung, Fürsorge und Gestaltung. Kleine Unternehmen könnten tun, wofür sie sich bislang kein Fachteam leisten konnten, und gewöhnliche Menschen könnten leichter aus einer Idee ein Produkt machen. Werden Produktivitätsgewinne zu niedrigeren Lebenshaltungskosten, kürzerer Arbeitszeit und besseren öffentlichen Leistungen, verbessert sich das Leben der meisten.
Das geschieht nicht von selbst. Löhne, Steuersystem, Wettbewerbspolitik und öffentliche Investitionen bestimmen, wie die Gewinne verteilt werden. Bessere Technik vergrößert nur das, was sich verteilen lässt; sie entscheidet nicht für die Gesellschaft, wie es verteilt wird. In dieser Zukunft verschiebt sich menschlicher Wert allmählich von „Wie viel standardisierte Arbeit kann ich erledigen?“ zu „Was möchte ich tun, welche Verantwortung will ich tragen und wie möchte ich mit anderen leben?“.
Optimismus verlangt auch nicht, dass Menschen aufhören zu lernen. Grundlagenwissen hilft zu erkennen, ob eine Maschine Unsinn erzählt; Berufserfahrung zeigt, ob sich ein Ergebnis verwenden lässt. Lernen dient dann nicht mehr nur dazu, jedem neuen Werkzeug hinterherzukommen, sondern dazu, bessere Fragen zu stellen und ein eigenes Urteil zu behalten.
Die pessimistische Zukunft: Starke Maschinen treffen auf eine überforderte Gesellschaft
Die pessimistische Zukunft braucht keine böswilligen Maschinen. Es genügt, dass Arbeit schneller ersetzt wird, als Menschen neue Aufgaben finden, und dass die Gewinne bei den Eigentümern von Rechenleistung, Kapital, Daten und Vertriebszugängen landen. Viele könnten erst ihr Einkommen verlieren und später den Produktivitätsanstieg in gesamtwirtschaftlichen Statistiken sehen.
Zuerst geraten womöglich Stellen unter Druck, deren Aufgaben sich leicht digitalisieren und deren Ergebnisse sich leicht abnehmen lassen. Damit lässt sich kein ganzer Beruf abschreiben: Jeder Beruf enthält unterschiedliche Aufgaben. Sinkt aber der Bedarf an einfacher Texterstellung, grundlegender Analyse, einfacher Entwicklung und gewöhnlichem Kundendienst stark, entsteht für junge Menschen ein besonders schwieriges Problem. Die Einstiegsarbeiten, mit denen man Erfahrung sammelte, verschwinden, während anspruchsvollere Urteile weiterhin Erfahrung voraussetzen. Wenn Unternehmen weniger Berufseinsteiger einstellen, verliert die Gesellschaft allmählich die Leiter, über die Experten heranwachsen.
Machtkonzentration würde den Druck verstärken. Kontrollieren wenige Organisationen die besten Modelle, Rechenleistung und Ausführungszugänge, bestimmen sie nicht nur Preise. Sie können auch beeinflussen, wer Wissen bekommt, wie Menschen bewertet werden und welche Inhalte sichtbar sind. Überwachung, Betrug und gezielte Überredung können durch billigere Intelligenz größere Ausmaße annehmen. Die Informationsmenge wächst, und zugleich wird es für öffentliche Debatten womöglich schwieriger festzustellen, was wahr ist.
Sicherheitsrisiken haben noch eine andere Ebene. Bei falsch gesetzten Zielen, zu weitreichenden Befugnissen oder fehlenden Prüfungen kann ein leistungsfähiges System Fehler fortlaufend ausführen. Es kann Nachrichten falsch versenden, Daten offenlegen, fehlerhafte Software herstellen und in riskanten Umgebungen sogar tatsächlichen Schaden anrichten. Extremere Kontrollverlustszenarien umfassen Täuschung, Umgehung von Aufsicht oder die Beschaffung weiterer Ressourcen. Das sind mögliche Mechanismen, die erforscht und verhindert werden müssen; aus einer historischen Zeitleiste lassen sich dafür keine glaubwürdigen Wahrscheinlichkeiten gewinnen.
Staaten könnten fortgeschrittene KI ebenfalls als strategische Ressource betrachten, bei der sie nicht zurückfallen dürfen. Der Wettbewerbsdruck könnte Institutionen zu kürzeren Prüfungen, verschwiegenen Fehlschlägen oder der Anbindung an kritische Infrastruktur bewegen. Dann liegt die Gefahr nicht in einer falschen Antwort, sondern darin, dass viele Organisationen gleichzeitig zu große Risiken akzeptieren. Gerade bei Rüstung, Cyberangriffen und kritischen Systemen müssen Befugnisse, Prüfung, Isolation und menschliche Verantwortung institutionell verankert werden.
Persönliche Verluste wären stiller. Wer Entscheidungen dauerhaft der Maschine überlässt, könnte Fähigkeiten im Schreiben, Denken, Orientieren und sozialen Umgang verlieren. Bequemlichkeit untergräbt allmählich die Eigenständigkeit; erst wenn ein Dienst ausfällt, teurer wird oder Antworten manipuliert, bemerkt man, dass Alternativen fehlen. In dieser Zukunft wird die Technik immer stärker, der Mensch aber nicht zwangsläufig freier.
Das neutrale Szenario: Große Veränderungen, langsame Anpassung
Am leichtesten kann ich mir einen Alltag vorstellen, in dem sich alle drei Szenarien mischen. Manche Aufgaben werden rasch billiger, manche Berufe wandeln sich langsam, und einige Bereiche bleiben aus Sicherheits- und Haftungsgründen unter menschlicher Führung. Es gibt erfolgreiche Unternehmen und gescheiterte Einsätze; manche gewinnen Zeit, andere verlieren Verhandlungsmacht.
Erreicht AGI die Schwelle dieses Artikels zunächst bei digitaler Arbeit, kann sie deshalb nicht sofort Wasserleitungen reparieren, ältere Menschen betreuen oder Stromnetze bauen. Die wirkliche Welt hat Körper, Materialien, Orte und Verantwortungsketten. Roboterbau, Erneuerung von Infrastruktur, Genehmigungen und organisatorische Abläufe benötigen zusätzliche Zeit. Die Kosten kognitiver Arbeit könnten sich zuerst verändern, ohne dass Wohnen, Energie und Medizin im gleichen Tempo günstiger werden.
Die Folgen für Beschäftigung dürften sich zunächst in einer Neuaufteilung von Aufgaben zeigen. Ein Team beschäftigt weniger Menschen für erste Entwürfe und braucht mehr Arbeit für Abnahme und Koordination. Eine Person betreut mehr Projekte und trägt gleichzeitig mehr Verantwortung für Fehler. Produktivität und Arbeitsintensität könnten sogar zugleich steigen. Auch die ILO-Studie zur beruflichen Betroffenheit durch generative KI erinnert daran, dass veränderte Aufgaben nicht zwingend vollständig ersetzte Stellen bedeuten. Diese Feststellung lässt sich nicht direkt zur Prognose der AGI-Folgen für Beschäftigung ausweiten; die Unterscheidung sollte aber jede Analyse begleiten.[30]
Institutionen werden der Wirklichkeit hinterherlernen. Schulen ändern Prüfungen, Unternehmen ordnen Befugnisse neu, Gerichte und Aufsichtsstellen bearbeiten Verantwortung, Versicherungen und Prüfer beginnen Risiken zu bepreisen. Vielerorts könnte der Übergang nach dem Muster verlaufen: „Grundsätzlich darf das System handeln, an entscheidenden Punkten unterschreibt ein Mensch.“ Das sieht wahrscheinlich weniger nach einer gemeinsamen Aktualisierung der Gesellschaft aus als nach einer Reihe umstrittener Reparaturen.
Auch psychische Anpassung wird langsamer sein als technischer Wandel. Wenn eine mühsam erworbene Fähigkeit plötzlich nicht mehr knapp ist, kann das Ärger und Unsicherheit auslösen. Neue Möglichkeiten begeistern, können aber auch müde machen, wenn man ständig hinterherlaufen muss. Mehr Effizienz gibt dem eigenen Selbstverständnis nicht automatisch einen Halt. Fürsorge, Freundschaft, körperliche Erfahrung, Ästhetik und öffentliche Beteiligung bleiben wichtig dafür, wie Menschen ihr Leben gestalten.
Auch wenn ich auf 2031 tippe, setze ich deshalb weder auf „ab diesem Jahr sind alle arbeitslos“ noch auf „ab diesem Jahr sind alle wohlhabend“. Technische Durchbrüche können sich zeitlich bündeln, ihre gesellschaftlichen Folgen aber entfalten sich je nach Region, Branche und Bevölkerungsgruppe. Die neutrale Zukunft heißt nicht, dass wenig geschieht. Sie heißt: viel Veränderung, ungleiche Ergebnisse und langsame Anpassung.
Vorbereiten müssen wir unser Urteil und unsere Entscheidungen
Diese Geschichte begeistert und macht ein wenig schwindlig. Ein Abakus rechnet nur, wenn Finger die Kugeln bewegen. Heutige Maschinen können bereits einen vagen Wunsch aufnehmen und nach Wegen suchen, ihn zu erfüllen. Wir verlagern immer mehr kognitive Arbeit nach außen und lernen noch, wie wir Ergebnisse abnehmen, Verantwortung tragen und Gewinne verteilen sollen.
Für Einzelne lohnt es sich, fachliche Grundlagen, Prüfgewohnheiten, übertragbare Fähigkeiten und Arbeitsweisen zu bewahren, die nicht von einem einzigen Dienst abhängen. Unternehmen sollten in überprüfbare Abläufe, Tests an wirklichen Aufgaben, klare Befugnisse und wiederherstellbare Vorgänge investieren. Für die Gesellschaft ist am schwierigsten, Produktivitätsgewinne nicht allein zum Vorteil weniger werden zu lassen und Sicherheitsanforderungen über bloße Erklärungen hinauszubringen.
Mit der AGI-Jahreszahl kann man falsch liegen. Noch weniger sollte man darauf setzen, dass hinreichend kluge Maschinen der Menschheit automatisch eine gute Zukunft schenken. Seit dem Abakus erweitern Werkzeuge die menschliche Macht. Als Nächstes müssen wir beantworten, wer diese Macht erhält, wie sie eingesetzt wird und welches Leben wir mit ihr führen möchten.