
Manchmal wirkt diese Welt wirklich wie ein einziger improvisierter Laden.
Wer die KI-Branche verfolgt, hat leicht das Gefühl, schon an der Schwelle zur Zukunft zu stehen. Modelle schreiben Code und lösen schwierige Aufgaben. Agenten sollen ganze Arbeitsabläufe übernehmen. Die Debatte darüber, wie viel Arbeit für Menschen übrig bleibt, wird von Tag zu Tag lauter. Dann soll die Technik tatsächlich etwas erledigen, und auf dem Bildschirm erscheint einfach keine Antwort.
Selbst DeepSeek, für viele ein Maßstab in der KI-Branche, kann im entscheidenden Moment ausfallen.
Laut einer Mitteilung von DeepSeek kam es am 15. Oktober 2026 von 8:11 bis 13:04 Uhr Pekinger Zeit, UTC+8, zu einer Störung des Dienstes. In diesem Zeitraum ließ sich die API nicht regulär nutzen. Aus den angegebenen Uhrzeiten ergeben sich vier Stunden und 53 Minuten, also fast fünf Stunden. „Einen halben Tag offline“ ist vielleicht der Ärger, der aus einem spricht. Dass der größte Teil des Vormittags verloren ging, ist trotzdem sehr real.[1][2]
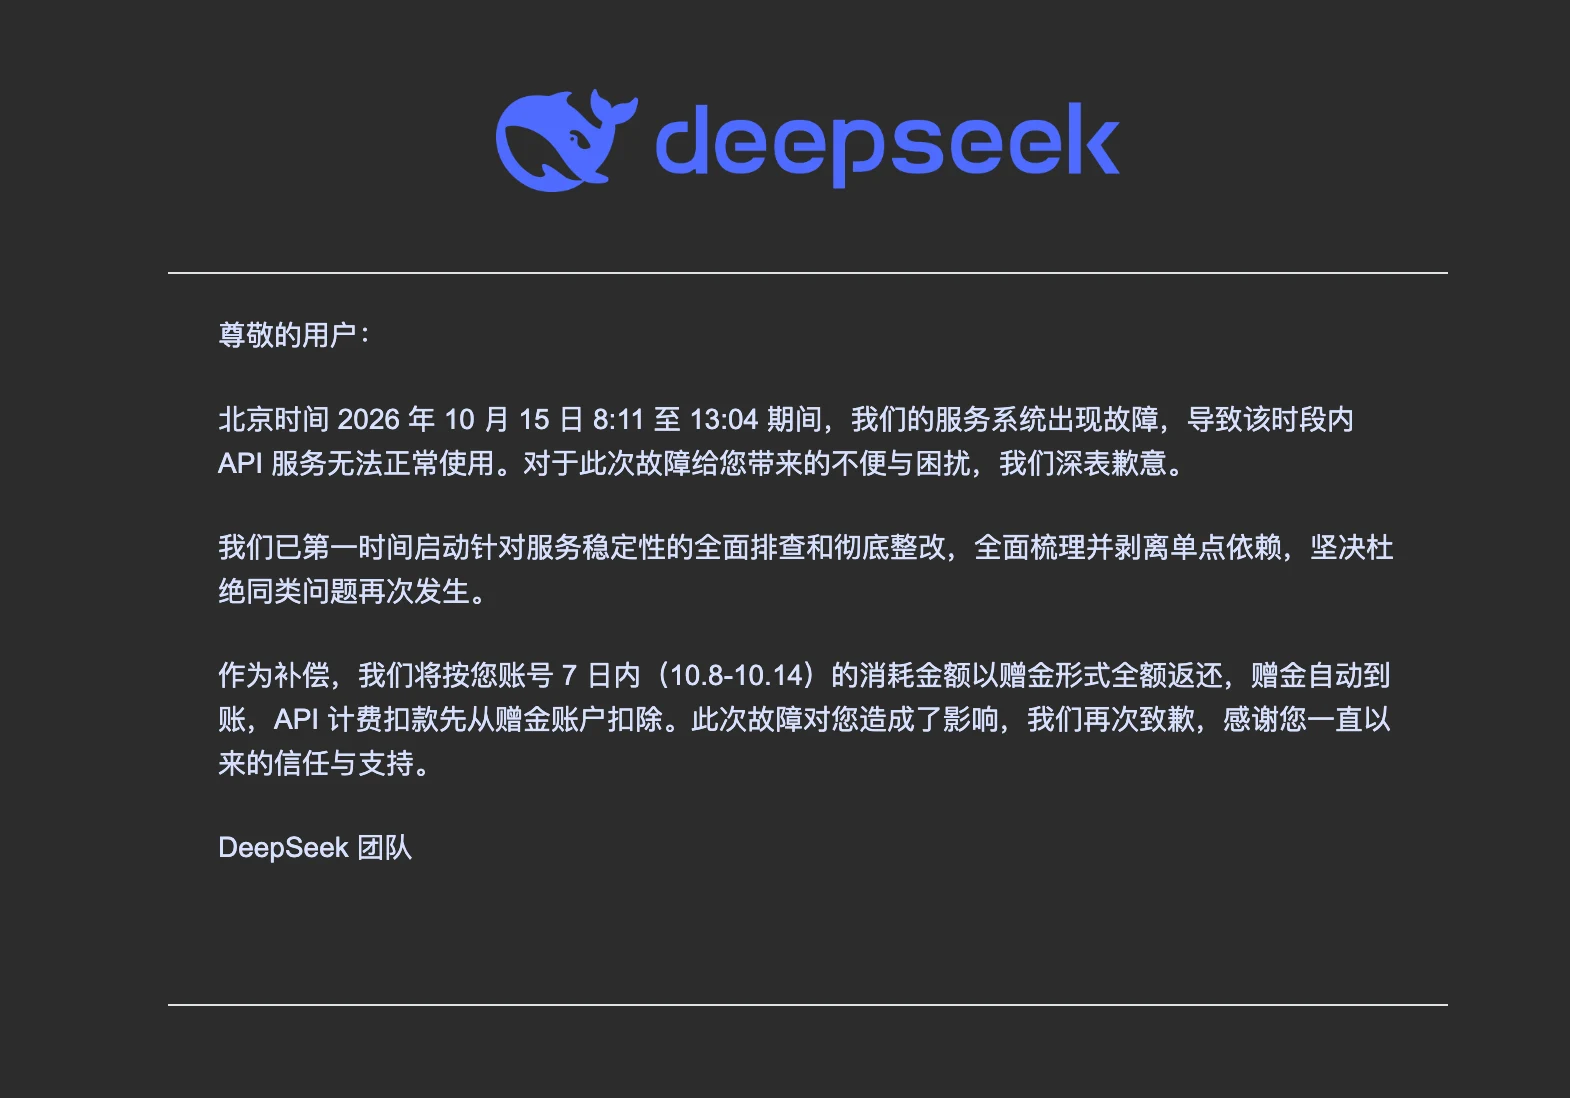
Mitteilung von DeepSeek zur Wiederherstellung des Dienstes und zur Entschädigung, von einem Leser bereitgestellt. Die genannten Zeiten und Entschädigungsbedingungen stimmen mit der Berichterstattung desselben Tages überein.
Wer nur ein wenig plaudern wollte, konnte eine Pause machen. Doch eine API kann bereits Teil eines Produkts, des Kundendienstes, der Inhaltsverarbeitung oder eines internen Geschäftsprozesses sein. Fällt der vorgelagerte Dienst aus, muss womöglich alles dahinter warten. Nutzer verlangen die zugesagte Leistung von Ihnen, Kunden wenden sich an Ihr Team. Dass ein Modell normalerweise beeindruckende Antworten liefert, macht mehrere Stunden Funkstille nicht automatisch hinnehmbar.
Der Ausfall führt uns vor allem eines vor Augen: Modellleistung und Dienstzuverlässigkeit müssen jeweils für sich bestehen.
Kann das Modell eine Frage richtig beantworten? Und kann es die Antwort dann liefern, wenn der Betrieb sie braucht? Die erste Frage taucht auf Bestenlisten und bei Produktvorstellungen auf. Die zweite wird meist erst ernsthaft diskutiert, wenn etwas kaputtgeht. Wer bei der Arbeit wirklich auf KI angewiesen ist, braucht auf beide eine überzeugende Antwort.
Aus dieser Kluft entsteht das Gefühl, dass am Ende doch alles irgendwie zusammengeschustert ist. Wir sehen eine Intelligenz, die über das Universum spricht und Programme schreibt. Getragen wird sie von Maschinen, Software und Menschen, die Fehler machen können. Auch der größte technische Glanz erspart niemandem die konkrete Arbeit an Überwachung, Redundanz und Wiederherstellung.
Bei aller berechtigten Kritik verdient die Entschädigung von DeepSeek allerdings eine faire Würdigung.
Der Mitteilung zufolge erhalten die Konten ein Guthaben in voller Höhe ihres tatsächlichen Verbrauchs in den vorherigen sieben Tagen, also vom 8. bis zum 14. Oktober. Das Guthaben wird automatisch gutgeschrieben. Künftige API-Gebühren werden vorrangig davon abgezogen.[1][2]
Hat ein Konto in diesen sieben Tagen beispielsweise 100 Yuan verbraucht, erhält es nach den angekündigten Bedingungen 100 Yuan Guthaben. DeepSeek beschränkt die Entschädigung also nicht auf die Gebühren, die den wenigen Ausfallstunden entsprechen würden. Als Grundlage dient der Verbrauch einer ganzen vorangegangenen Woche. Das ist ein ernst zu nehmendes Entgegenkommen.
Natürlich ist ein Guthaben keine Rückzahlung in Geld. Ebenso wenig bedeutet das Angebot, dass sich die API in den kommenden sieben Tagen beliebig und unbegrenzt nutzen lässt. Die Höhe richtet sich nach dem tatsächlichen Verbrauch im festgelegten früheren Zeitraum und wird mit künftigen API-Gebühren verrechnet. Diese Unterschiede klar zu benennen, schmälert die Anerkennung für die Entschädigung kein bisschen.
Verantwortungsbewusst wirkt die Entscheidung, weil das Unternehmen für den Ausfall einen klar bezifferten Aufwand übernimmt. Zugleich erspart es den Nutzern, einzeln Belege zusammenzutragen und wiederholt Anträge zu stellen. Für Entwickler, die den Dienst weiter nutzen wollen, hat ein automatisch gewährtes und direkt verrechnetes Guthaben einen praktischen Wert.
Der Wert dieser Entschädigung hängt nicht davon ab, dem Unternehmen das Etikett „hat Geld im Überfluss“ anzuheften. Dass aus der Entschuldigung ein Guthaben wird, das Kunden tatsächlich nutzen können, verdient hier Anerkennung.
Lob für die Entschädigung macht den Ausfall allerdings noch nicht zu einer guten Nachricht.
Neben der API-Rechnung stehen die Risiken unterbrochener Abläufe, verspäteter Lieferungen und verlorener Kunden. Ein Guthaben muss die Verluste eines einzelnen Teams nicht annähernd decken. Geld lässt sich ersetzen; verlorene Zeit und beschädigtes Vertrauen brauchen oft länger. DeepSeek verdient Anerkennung für diese Reaktion und muss sich zugleich weiter Fragen zur Zuverlässigkeit stellen lassen.
In der Mitteilung heißt es auch, DeepSeek wolle Abhängigkeiten erfassen und auflösen, die einzelne Ausfallpunkte bilden.[1] Woran könnte der Dienst eines so leistungsfähigen Modells hängen bleiben? Die Störung begann um 8:11 Uhr Pekinger Zeit. Das lässt an eine Möglichkeit denken, die eine Prüfung wert ist: Eine nächtliche Änderung zeigte ihre Schwäche erst unter dem morgendlichen Andrang.
Die Grenze des Wissens vorweg: DeepSeek nennt in dieser Mitteilung keine technische Ursache. Ob nachts etwas bereitgestellt wurde und ob der morgendliche Datenverkehr deutlich zunahm, muss erst anhand von Protokollen und Überwachung bestätigt werden. Folgen wir hier nur dieser einen Möglichkeit und schauen, wie sie ablaufen könnte.
Angenommen, nachts wurde ein gemeinsam genutzter Dienst aktualisiert. Er prüft API-Schlüssel und verfügbares Guthaben, bevor Anfragen zum Modell gelangen. Die neue Version läuft und besteht ihre Prüfungen. Nur wird eine Prüfung, die zuvor aus dem Cache lesen konnte, nun bei jeder Anfrage als Datenbankabfrage ausgeführt. Dieser Dienst und diese Änderung sind Beispiele, keine festgestellten Details der Infrastruktur von DeepSeek.
Nachts kommen wenige Anfragen. Eine zusätzliche Abfrage scheint kaum ins Gewicht zu fallen. Die Schnittstelle antwortet noch, die Tests melden keine Fehler, und die Überwachung zeigt womöglich weiterhin Grün. Trotzdem hat das System bereits unbemerkt einen Teil seiner Verarbeitungskapazität verloren.
Am Morgen beginnen die Menschen zu arbeiten. Aufrufe aus Produkten und Hintergrundaufgaben strömen nach und nach herein. Irgendwann kommen die Anfragen schneller an, als der gemeinsame Dienst sie abarbeiten kann. Anfragen reihen sich in eine Warteschlange ein, um eine Datenbankverbindung zu bekommen. Wartende Anfragen halten weitere Ressourcen fest, und spätere Anfragen müssen noch länger warten.
Das ist wie in einem Frühstückslokal, in dem nur eine Kasse geöffnet ist. Die Küche funktioniert, die Köche sind da. Aber alle müssen zuerst an derselben Kasse vorbei. Wenn sich dort alles staut, hilft auch die größte Küche dahinter wenig.
Dann beginnt das Problem, sich selbst zu vergrößern. Aufrufer warten vergeblich auf ein Ergebnis, erreichen ihr Zeitlimit und versuchen es erneut. Manche nachgelagerten Produkte wiederholen Anfragen zusätzlich im Namen ihrer Nutzer. Werden die vorherigen Anfragen nicht rechtzeitig abgebrochen, drängt neue Arbeit herein, bevor die alte erledigt ist. Das tatsächlich neue Geschäftsvolumen muss gar nicht sprunghaft gestiegen sein. Trotzdem kann die Zahl der Anfragen, die das System tragen muss, immer weiter anwachsen.
Selbst ein Zurücksetzen auf die vorige Version stellt den Dienst dann nicht unbedingt sofort wieder her. Der Rückstau bleibt, die Verbindungspools haben sich nicht erholt, und von außen klopfen weitere Wiederholungsversuche an. Kaum holt der Dienst Luft, drückt ihn die Last wieder zu Boden. Für die Erholung könnte es nötig sein, den Zufluss zu begrenzen, nutzlose Wiederholungen zu stoppen, abgelaufene Aufgaben zu verwerfen und den Verkehr schrittweise wieder zuzulassen. Den Code zu reparieren und das System wieder auf die Beine zu bringen, können zwei verschiedene Kämpfe sein.
In dieser Kette legt die Änderung das Problem an, der Datenverkehr bringt es zum Vorschein, und Rückstau und Wiederholungen verstärken es. Die teuren Inferenzcluster müssen nicht gemeinsam ausgefallen sein. Vielleicht stecken die Anfragen nur an einem schmalen Eingang davor fest. Der einzelne Ausfallpunkt muss auch kein einsamer Server sein. Es kann eine gemeinsame Abhängigkeit sein, an der keine der vielen Repliken vorbeikommt.
Für eine ähnliche Verstärkung gibt es ein öffentlich dokumentiertes Beispiel. Im Bericht zum Vorfall bei Google Cloud im Juni 2025 steht, dass Daten einer Kontingentrichtlinie Abstürze von Service Control auslösten. Während der Wiederherstellung belasteten geballte Neustarts dann die darunterliegende Datenbank und verzögerten die Erholung in einigen Regionen.[3] Das zeigt, warum ein System nach Beseitigung des ursprünglichen Auslösers weiter überlastet sein kann. Es belegt nicht, dass bei DeepSeek dasselbe passiert ist.
Um dieses Szenario zu prüfen, müsste man mehrere Zeitverläufe übereinanderlegen: Was wurde vor dem Ausfall geändert? Wann nahm der Verkehr zu? Ab wann wurden Latenz, Warteschlangen und Verbindungsbelegung des gemeinsamen Dienstes auffällig? Nahmen die Wiederholungsversuche daraufhin zu? Und was geschah nach dem Zurücksetzen der Version oder der Begrenzung des Verkehrs? Erst wenn diese Schritte zeitlich zusammenpassen, gewinnt die Vermutung Gewicht. Der Beginn um 8:11 Uhr reicht für eine Frage, aber noch nicht, um den Fall für gelöst zu erklären.
„Gleichartige Probleme verhindern“ ist ein Versprechen. Ob es eingelöst wird, zeigt die künftige Bilanz des Dienstes.
Der Vorfall erinnert auch alle, die KI in ihre Geschäftsprozesse einbauen, an eine Pflicht: einen Weg vorzubereiten, auf dem es bei einem Ausfall weitergeht.
Bei wichtigen Abläufen sollte vorab klar sein, ob Aufgaben bei einem vorübergehenden Ausfall des vorgelagerten Modells in eine Warteschlange kommen können. Lässt sich auf einen geprüften Ersatzdienst wechseln oder die Aufgabe an einen Menschen zurückgeben? Sind Wiederholungsversuche nötig, sollten ihre Anzahl begrenzt, die Abstände schrittweise verlängert und die Zeitpunkte verteilt werden, damit sie den Ausfall nicht zusätzlich anheizen. Gerade Abläufe, die Zahlungen auslösen, Nachrichten versenden oder Daten ändern, brauchen nach der Wiederherstellung außerdem Schutz vor doppelter Ausführung.
Solche Vorbereitungen haben wenig futuristischen Glanz. Sie können aber beim nächsten Ausfall das heutige Geschäft schützen. Je ernsthafter man KI nutzt, desto weniger darf man alles auf die Annahme setzen, dass einem so leistungsfähigen Unternehmen schon nichts passieren werde.
Ein Ausfall von fast fünf Stunden verdient Kritik, auch bei DeepSeek. Ein KI-Dienst, an den hohe Erwartungen gestellt werden, muss seine Zuverlässigkeit ebenfalls unter Beweis stellen. Auch die Entschädigung in Höhe von sieben Tagen vorherigen Verbrauchs verdient Anerkennung. Ein Problem einzugestehen, Kosten zu übernehmen und anschließend durch einen dauerhaft verlässlichen Dienst wieder Vertrauen zu gewinnen: Diese Haltung sollte ermutigt werden.
Vielleicht ist die Welt tatsächlich improvisierter, als uns lieb ist. Wir haben gute Gründe, weniger Fehler zu verlangen. Und wir haben ebenso gute Gründe, wenn jemand Verantwortung übernimmt, zu sagen: Diesmal war die Reaktion fair und anständig.