
Supongamos que estás construyendo un agente que responde preguntas sobre un CSV que subió un cliente. El modelo necesita ejecutar Python para obtener la respuesta. ¿Dónde se ejecuta ese código?
Una opción es ejecutarlo tú mismo. Eso significa una plataforma de sandbox como E2B o Modal, o tu propio contenedor en Docker, además del trabajo de mantenerlo alejado de tu base de datos y de internet, limitar su tiempo de ejecución y actualizar la imagen.
Una herramienta de ejecución de código del lado del servidor es la otra opción. Añades la herramienta a tu solicitud a la API, el modelo decide cuándo necesita ejecutar algo, y el proveedor ejecuta los comandos en su propio sandbox y devuelve la salida al modelo dentro de la misma solicitud. Un sandbox aquí significa un contenedor Linux aislado con su propio sistema de archivos, un límite de tiempo y sin acceso a la red por defecto.
Este artículo cubre cuatro proveedores que ofrecen ejecución de código del lado del servidor hoy en día, lo que cada sandbox puede y no puede hacer, lo que cuesta en latencia y dinero, y los trabajos que todavía necesitan un sandbox que operes tú mismo.
Resumen
- Una herramienta de ejecución de código del lado del servidor ejecuta los comandos del modelo en el sandbox del proveedor durante tu solicitud a la API. No tienes que aprovisionar, actualizar ni proteger un contenedor.
- OpenAI, Anthropic y Google ejecutan código cada uno para sus propios modelos. Nuestra herramienta openrouter:shell ejecuta comandos para cualquier modelo en las API de Responses y Messages, y nuestra herramienta openrouter:bash hace lo mismo solo en la API de Messages. Ambas herramientas están en beta.
- Nuestro sandbox es un contenedor aislado con alcance a tu cuenta y espacio de trabajo, con acceso de red saliente desactivado por defecto y límites por comando en el tiempo de ejecución y el tamaño de la salida. El tiempo de sandbox se factura a $0.0001 por segundo con un mínimo de 30 segundos para un contenedor nuevo o en reposo.
- Una plataforma de sandbox que operas tú mismo sigue siendo la elección correcta para una imagen base personalizada, trabajo con GPU o una sesión que dura horas.
Qué significa la ejecución de código del lado del servidor
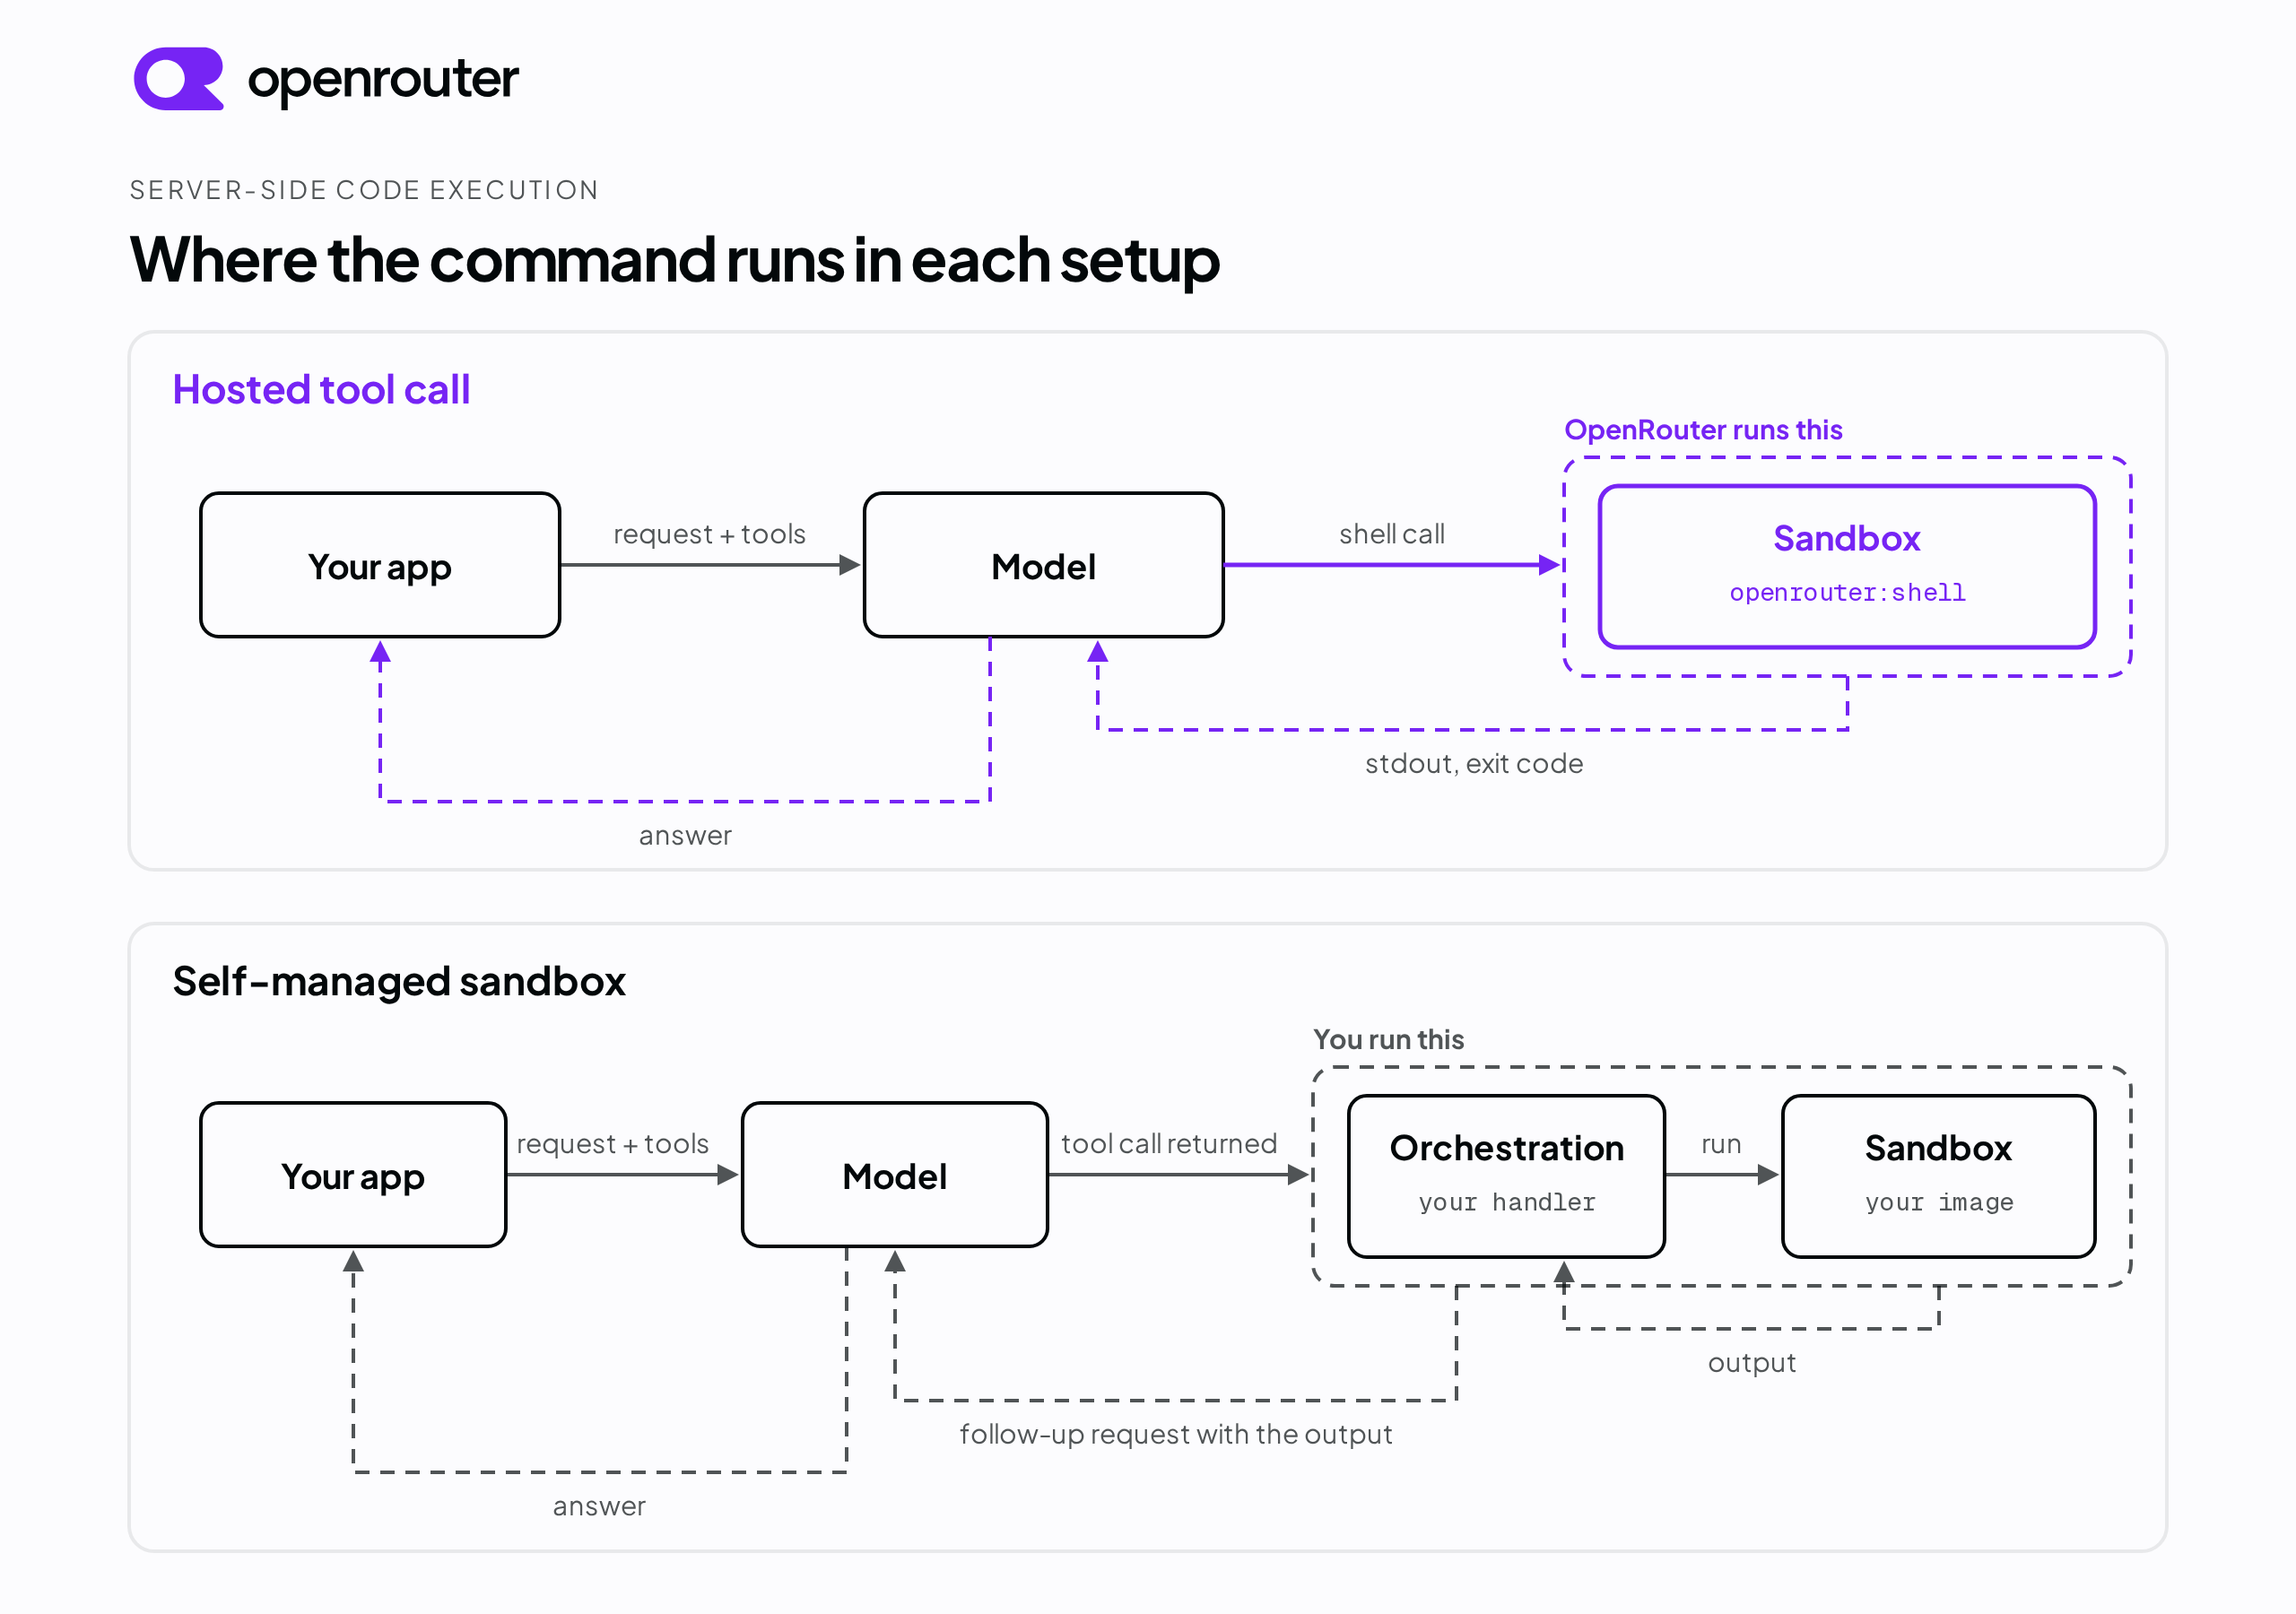
Un modelo nunca ejecuta nada por sí mismo. Cuando llama a una herramienta, emite una solicitud que nombra la herramienta y los argumentos, y algo tiene que llevarlo a cabo. Con una herramienta del lado del cliente, ese algo es el código de tu aplicación o el framework de agentes sobre el que construyes. Tu aplicación recibe la llamada, la ejecuta y envía el resultado de vuelta en una solicitud posterior. Con una herramienta del lado del servidor, el proveedor ejecuta la llamada en su propia infraestructura y devuelve el resultado al modelo en la misma solicitud, de modo que tu aplicación no tiene un manejador para ello. La ejecución de código del lado del servidor es del segundo tipo.
Es posible que ya uses herramientas que funcionan de esta manera. Web search permite a un modelo buscar algo en la web en vivo, y web fetch le permite leer el contenido de una URL. En ambos casos añades una entrada a la solicitud y el proveedor hace el resto. La ejecución de código aplica el mismo patrón a la ejecución de comandos.
Cómo una llamada a una herramienta se convierte en un comando que se ejecuta
Estos pasos aplican a cualquier herramienta de ejecución de código del lado del servidor. Cuando aparece un nombre de campo, es el que usa nuestra herramienta de shell.
- Incluyes la herramienta en el array
toolsde la solicitud. - El modelo decide que necesita ejecutar algo y emite una llamada que lleva uno o más comandos de shell.
- El proveedor ejecuta esos comandos en orden dentro de un contenedor aislado (sandbox).
- La salida estándar, el error estándar y el resultado de cada comando regresan al modelo. El resultado es un código de salida o un tiempo de espera agotado.
- El modelo lee los resultados y ya sea te responde o ejecuta más comandos en la misma solicitud.
Los pasos dos a cinco se repiten hasta que el modelo responde. El modelo ejecuta algo, lee la salida, decide si necesita otro comando y vuelve a intentarlo. Ese bucle es donde una herramienta de ejecución de código gana su lugar, porque el modelo puede verificar su trabajo contra una salida real en lugar de adivinar.
Limitamos ese bucle. El campo max_tool_calls establece cuántos pasos de herramientas de servidor puede tomar una solicitud. Nuestra referencia de herramientas de servidor fija tanto el valor predeterminado como el máximo en 30.
Cómo se diferencia un sandbox alojado de uno que ejecutas tú mismo
Ejecutar tu propio sandbox significa ser dueño de las partes que de otro modo poseería el proveedor. Tú eliges una imagen base, aprovisionas la computación, conectas un SDK para iniciar ejecuciones y leer la salida, y gestionas el ciclo de vida de cada ejecución. También eres responsable del límite de seguridad.
Una herramienta alojada cambia ese control por una entrada en un arreglo JSON. No dimensionas el contenedor, no lo parchas ni lo operas. Construimos openrouter:shell para el caso en que el trabajo consiste en un puñado de comandos cortos por solicitud.
Quién ofrece hoy ejecución de código alojada
Este artículo cubre OpenAI, Anthropic, Google y OpenRouter. Los SDK de agentes y las plataformas de sandbox dedicadas son categorías separadas, y ambas se tratan más adelante en el artículo. Lo que distingue a los cuatro proveedores es qué modelos ejecutan código para cada uno.
OpenAI ejecuta un shell alojado para los modelos de OpenAI
De OpenAI la herramienta de shell ejecuta comandos en un contenedor gestionado por OpenAI, en la Responses API. OpenAI documenta el runtime alojado como Debian 12 con un directorio de trabajo predeterminado de /mnt/data. Los comandos se ejecutan sin sudo, y las sesiones TTY interactivas no son compatibles. Los lenguajes preinstalados enumerados en la documentación incluyen Python 3.11, Node.js 22.16, Java 17, PHP 8.2, Ruby 3.1 y Go 1.23.
Los contenedores alojados no tienen acceso de red saliente de forma predeterminada. Para habilitarlo, un administrador de la organización configura una lista de permitidos en el panel de OpenAI y tú estableces network_policy en el entorno del contenedor en la solicitud. Un contenedor puede reutilizarse entre solicitudes pasando su id en un container_reference entorno, y su caducidad se establece cuando se crea el contenedor. OpenAI también tiene una herramienta de intérprete de código separada para Python.
Anthropic ejecuta Python y Bash para los modelos de Claude
La herramienta de ejecución de código de Anthropic ejecuta Python y Bash en un sandbox gestionado por Anthropic, en la Messages API. El entorno documentado es un contenedor Linux x86_64 con Python 3.11, 5 GiB de RAM, 5 GiB de almacenamiento de espacio de trabajo y una CPU. El acceso a Internet está deshabilitado y no se permiten conexiones salientes, por lo que Claude trabaja con las bibliotecas preinstaladas y no puede instalar un paquete durante una ejecución.
Existen tres versiones de la herramienta , y todos los modelos compatibles aceptan las tres. code_execution_20250825 admite comandos Bash y operaciones con archivos. code_execution_20260120 añade un estado del intérprete de Python que persiste entre solicitudes, lo cual depende del programmatic tool calling de Anthropic y no está disponible en Claude Haiku 4.5. Los contenedores caducan 30 días después de su creación. Tras unos 5 minutos de inactividad, un contenedor se guarda en un checkpoint, y una solicitud con su id dentro de la ventana de 30 días lo restaura.
Google ejecuta Python para los modelos de Gemini
La herramienta de ejecución de código de Google ejecuta Python en un sandbox gestionado por Google, que se habilita con una code_execution entrada en las tools de la solicitud. La documentación indica que el modelo solo puede generar y ejecutar Python, que el entorno de código tiene un tiempo máximo de ejecución de 30 segundos y que no puedes instalar tus propias bibliotecas. Google publica la lista de bibliotecas que incluye el entorno.
Nosotros ejecutamos un shell alojado para cualquier modelo
Las tres herramientas anteriores funcionan cada una con los modelos de una sola empresa. La nuestra funciona con cualquier modelo en las APIs Responses y Messages, porque ejecutamos el sandbox en la capa de enrutamiento en lugar de dentro de un proveedor de modelos.
Ofrecemos dos herramientas de ejecución de código. openrouter:shell replica la forma de la herramienta de shell alojado de OpenAI y funciona tanto en la Responses API y la API de Messages. openrouter:bash refleja la forma de la herramienta bash de Anthropic y funciona solo en la API de Messages.
Ambas herramientas están en beta, por lo que la API puede cambiar. La ejecución en sandbox corre solo en el endpoint global openrouter.ai . El endpoints regionales no ofrecen la herramienta de shell, y Chat Completions rechaza ambas herramientas con un 400 que nombra las API que sí las admiten.
Establezca engine en openrouter en cualquiera de las herramientas y los comandos se ejecutarán en nuestro sandbox. El valor predeterminado de engine es auto. Para openrouter:shell, auto mantiene el shell alojado nativo de un proveedor cuando existe y se dirige a nuestro sandbox en caso contrario. Para openrouter:bash, auto devuelve la llamada a la herramienta a su aplicación para que se ejecute en el lado del cliente, y nada se ejecuta en nuestros servidores.
Ejecutar un comando en nuestro sandbox
Aquí hay una solicitud completa que ejecuta dos comandos y lee los resultados de vuelta.
import os
import requests

response = requests.post(
    "https://openrouter.ai/api/v1/responses",
    headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},
    json={
        "model": "anthropic/claude-sonnet-4.5",
        "input": "Run `cat /etc/os-release` and `python3 --version`, then tell me the OS and Python version in one sentence.",
        "tools": [
            {"type": "openrouter:shell", "parameters": {"engine": "openrouter"}}
        ],
    },
)

for item in response.json()["output"]:
    if item["type"] == "openrouter:shell":
        print(item["container_id"], item["action"]["commands"])
        for result in item["output"]:
            print(result["stdout"], result["outcome"])
Ejecutamos esta solicitud el 22 de septiembre de 2026. El modelo envió ambos comandos en una sola llamada de shell, y cada comando regresó con su propio resultado. La salida completa de os-release se extiende por varias líneas y aquí se recorta a sus dos primeras.
{
  "type": "openrouter:shell",
  "container_id": "sess_art10-418b8597e044",
  "action": { "commands": ["cat /etc/os-release", "python3 --version"] },
  "output": [
    {
      "stdout": "PRETTY_NAME=\"Ubuntu 22.04.5 LTS\"\nNAME=\"Ubuntu\"\n",
      "stderr": "",
      "outcome": { "type": "exit", "exit_code": 0 }
    },
    {
      "stdout": "Python 3.11.14",
      "stderr": "",
      "outcome": { "type": "exit", "exit_code": 0 }
    }
  ]
}
El sandbox informó Ubuntu 22.04.5 LTS con Python 3.11.14 en esa fecha. La imagen del entorno de ejecución puede cambiar, así que lea la versión del contenedor en lugar de codificarla de forma fija. La referencia de herramientas de servidor cubre los parámetros restantes.
SDK de agentes que envuelven un sandbox por usted
Si desarrolla sobre un SDK de agente en lugar de llamar a una API directamente, algunos SDK envuelven una de estas herramientas.
El OpenAI Agents SDK incluye CodeInterpreterTool, que ejecuta código en el sandbox de OpenAI, y ShellTool, que se ejecuta ya sea en tu entorno local o en un contenedor alojado por OpenAI dependiendo de cómo configures su entorno. Comprueba qué modo configuraste antes de asumir que un comando se ejecutó de forma remota. Por nuestra parte, openrouter:shell es una entrada en el tools array como cualquier otra, así que entra en un OpenRouter Agent SDK loop de la misma manera que entra en una solicitud directa.
Lo que todavía necesita un sandbox propio
Una herramienta alojada se adapta a trabajos cortos y acotados, como ejecutar un script, transformar un archivo o verificar un resultado. Cualquier cosa que necesite una imagen base específica o una GPU queda fuera de las cuatro herramientas alojadas y necesita una plataforma de sandbox que tú operes.
Comparación
Cada celda de herramienta alojada proviene de la documentación del propio proveedor enlazada arriba, excepto la celda del runtime de OpenRouter, que es lo que el sandbox reportó cuando ejecutamos la solicitud anterior. La columna autogestionada describe un sandbox que tú ejecutas tú mismo, no una plataforma en particular.
| OpenRouter | OpenAI | Anthropic | Autogestionado | ||
|---|---|---|---|---|---|
| Quién lo ejecuta | Nosotros | OpenAI | Anthropic | Tú | |
| Modelos | Cualquier modelo en las APIs Responses y Messages | Modelos de OpenAI | Modelos Claude | Modelos Gemini | Cualquier modelo |
| APIs | Responses y Messages. openrouter:bash es solo Messages | Responses | Mensajes | Gemini API | Cualquiera |
| Idiomas | Cualquier comando de shell. Ubuntu 22.04.5 con Python 3.11.14 reportado el 22 de septiembre de 2026 | Comandos de shell en Debian 12. Python, Node.js, Java, PHP, Ruby y Go preinstalados | Python y Bash | Solo Python | Lo que sea que construyas |
| Sistema de archivos | Sistema de archivos de contenedor propio, con alcance a tu cuenta y espacio de trabajo. Los archivos bajo el directorio home se guardan después de cada comando | Sistema de archivos de contenedor propio con un directorio de trabajo predeterminado de /mnt/data. Los datos se eliminan cuando el contenedor expira | Contenedor aislado con 5 GiB de almacenamiento de espacio de trabajo. Los contenedores expiran 30 días después de su creación | No documentado | Lo que tu imagen y tus montajes definan |
| Red saliente | Desactivada de forma predeterminada. Lista de permitidos de hasta 50 nombres de host en los puertos 80 y 443 | Desactivada de forma predeterminada. Lista de permitidos de la organización más un por solicitud network_policy | Desactivado | No documentado | A tu configuración |
| Instalar paquetes en tiempo de ejecución | Sí, con los hosts de paquetes en la lista de permitidos | Sí, con los hosts de paquetes en la lista de permitidos | No | No | Sí |
| Persistencia de sesión | Contenedor asociado a un id de contenedor. Entra en suspensión tras 5 minutos de inactividad. Los archivos guardados se conservan 30 días después del último uso | Contenedor reutilizado por id a través de container_reference. La caducidad se establece en el contenedor | Contenedor restaurado por id dentro de los 30 días posteriores a su creación. El estado del intérprete persiste en code_execution_20260120 y posteriores con llamadas programáticas de herramientas | Tiempo máximo de ejecución de 30 segundos por ejecución. Persistencia de estado entre solicitudes no documentada | Hasta el límite de cada plataforma |
| Modelo de costos | Tokens de inferencia más tiempo de sandbox a $0.0001 por segundo, con un mínimo de 30 segundos para un contenedor nuevo o en suspensión | No se indica en la documentación de la herramienta de shell | 1,550 horas gratuitas por organización al mes, luego $0.05 por hora por contenedor, con un mínimo de 5 minutos por ejecución | Sin cargo adicional. El código generado y la salida se facturan como tokens | Tiempo de cómputo mientras el sandbox está en ejecución |
Lo que aplica nuestro sandbox
El objetivo de un sandbox es que no tenga que confiar en el modelo. Un comando que nunca tuvo la intención de ejecutar no puede llegar a la red ni al contenedor de nadie más, y se detiene en un límite estricto de cuánto tiempo puede ejecutarse y cuánto puede imprimir. Todo lo que se describe en esta sección corresponde a nuestro sandbox. La tabla anterior muestra en qué se diferencian los otros tres.
Los límites que se aplican a cada comando
Ejecutamos cada comando en un contenedor aislado, separado de la infraestructura que atiende su solicitud y de su máquina, y con alcance limitado a su cuenta y workspace. Usted establece sus propios topes con timeout_ms para cuánto tiempo puede ejecutarse un comando y max_output_length para cuánto puede imprimir. timeout_ms tiene un valor predeterminado de 120,000 ms y no puede exceder 300,000 ms. max_output_length tiene un valor predeterminado de 16,384 caracteres por flujo y no puede exceder 65,536. Una llamada de shell con más de 100 comandos se rechaza.
El acceso de red saliente está desactivado a menos que usted lo active. Lo verificamos el 22 de septiembre de 2026 enviando una solicitud sin network_policy y pidiendo al modelo que obtuviera https://example.com con curl, imprimiendo solo el código de estado HTTP y abandonando después de 5 segundos. El comando imprimió 000, que es lo que curl imprime cuando no llega ninguna respuesta, y salió con el código 28, un curl timeout.
{ "stdout": "000", "stderr": "curl: (28) Failed to connect to example.com port 443 after 5206 ms: Connection timed out", "outcome": { "type": "exit", "exit_code": 28 } }Para abrir la red, configure una network_policy allowlist de hasta 50 nombres de host o patrones glob. Solo los puertos 80 y 443 son alcanzables, y la política queda fija cuando el contenedor arranca. pip install necesita tanto pypi.org como files.pythonhosted.org en la allowlist.
La inyección de prompts y lo que limita el sandbox
Darle un shell a un modelo lo expone a la inyección de prompts. Si su agente lee una página web, un ticket de soporte o un archivo que alguien subió, un atacante puede ocultar instrucciones en ese texto que le ordenen al modelo ignorar su prompt y ejecutar otra cosa.
Los límites anteriores se aplican tanto si el modelo sigue su prompt como el de un atacante. Un comando ejecutado bajo una instrucción inyectada no puede alcanzar ningún host fuera de la network_policy que usted configuró, y no tiene ningún acceso de red cuando deja la política desactivada. No puede alcanzar el contenedor de otro inquilino, y se detiene en el mismo timeout. Una allowlist amplía lo que un comando inyectado puede alcanzar, y allowed_domains: ["*"] permite una salida de red sin restricciones, así que mantenga la allowlist limitada a los hosts que el trabajo necesita.
También puede detectar un intento que llega dentro de la propia solicitud. Detección de inyección de prompts en una regla de workspace comprueba el contenido del mensaje proporcionado por el usuario en cada solicitud entrante contra patrones regex de técnicas de inyección comunes, antes de reenviar la solicitud al modelo. No inspecciona lo que una herramienta de servidor recupera después de ese punto, por lo que una página, archivo o salida de comando que el modelo lea a través de una herramienta necesita un control propio, como revisar la salida del sandbox que recibe su aplicación. Una coincidencia hace una de tres cosas, según la acción que configure.
- Flag registra la detección y reenvía la solicitud sin cambios.
- Redact reemplaza el fragmento coincidente con
[PROMPT_INJECTION]y reenvía la solicitud depurada. - Block rechaza la solicitud con un 403 antes de que llegue al modelo.
Cuando se aplica más de una barrera de protección, gana la acción más estricta, en el orden block, redact, flag. La detección no es exhaustiva y puede producir falsos positivos, así que mida la tasa de coincidencias contra su propio tráfico en modo flag antes de aplicar redact o block. Puede reportar un falso positivo desde la página Logs.
Lo que le cuesta en segundos y dólares un sandbox alojado
Un sandbox alojado añade segundos a una solicitud y no le deja infraestructura que ejecutar. También le da un contenedor al que puede volver.
Los archivos sobreviven entre solicitudes
Los comandos se ejecutan en /workspace/home, y guardamos los archivos modificados bajo ese directorio después de cada comando. Envíe un session_idestable, o configure un id de contenedor en la sección environment de la configuración de la herramienta, y cada solicitud con ese id llega al mismo contenedor y a los mismos archivos. Un session_id debe usar solo letras, dígitos, _y -. Un id con cualquier otro carácter se ignora, y elegimos el contenedor como si no hubiera enviado session_id, lo que significa el más reciente container_id en la conversación reproducida si lo hay, y de lo contrario un nuevo contenedor para esa solicitud. Cuando un session_id tiene más de 20 caracteres, usamos solo los últimos 20, por lo que dos ids largos que terminan de la misma forma comparten un contenedor. Un id de container_reference puede tener de 1 a 40 caracteres del mismo conjunto y no se trunca, así que úselo cuando necesite que el id sea exacto. Lo confirmamos el 22 de septiembre de 2026 escribiendo un archivo en una solicitud y leyéndolo de vuelta en una segunda solicitud que compartía el mismo session_id.
Un contenedor se suspende tras 5 minutos de inactividad, y ese tiempo de inactividad no es configurable. La suspensión no borra los archivos. Cuando llega más tarde una petición con el mismo id, se inicia una nueva sandbox y carga primero los archivos guardados. Los procesos abiertos, las variables de entorno y el estado instalado del sistema no se restauran, así que trate un contenedor despertado como una máquina nueva que tiene sus archivos encima. Los archivos guardados se conservan durante 30 días después del último uso del contenedor. Para extraer un artefacto, GET /api/v1/containers/{container_id}/files enumera lo que produjo un contenedor, y el endpoint promote copia un archivo en los documentos de su workspace, donde no caduca.
Lo que puede revisar después
Cada resultado de la herramienta shell en la respuesta incluye los comandos que ejecutó el modelo y, para cada comando, su stdout, stderr y resultado, de modo que su aplicación puede registrarlos de la misma forma en que registra el resto de la respuesta. Input & Output Logging almacena sus prompts y completions en OpenRouter para revisarlos en la página Logs, y las detecciones de guardrail también aparecen allí. Para monitorización en producción, Broadcast envía trazas a una plataforma de observabilidad externa a medida que las peticiones se completan.
Si enruta in-region, la herramienta shell no está disponible y Input & Output Logging se omite, incluso cuando está activado. Broadcast admite el enrutamiento in-region, y cada destino se configura con las regiones de datos de las que recibe trazas.
Lo que le cuesta el ciclo completo
Una petición que ejecuta un comando en sandbox tarda más que la misma petición sin él. En un conjunto de peticiones individuales que enviamos el 22 de septiembre de 2026, una petición sin herramienta shell devolvió en unos 2 segundos, y las peticiones que hicieron una llamada shell devolvieron en 8 a 21 segundos según el modelo. Esas son muestras individuales de una sola sesión, no un benchmark. Presupueste varios segundos de sobrecoste por cada llamada shell.
El tiempo de sandbox se factura a $0.0001 por segundo. El reloj empieza cuando una petición ejecuta por primera vez un comando de sandbox y se detiene cuando la respuesta se completa. Una petición que inicia un contenedor nuevo o suspendido se factura un mínimo de 30 segundos, y las peticiones posteriores que reutilizan el mismo contenedor caliente pagan solo su tiempo medido. La petición anterior inició un contenedor nuevo, y su objeto de uso informó de un server_tool_cost de 0.003, que es el mínimo de 30 segundos. Un contenedor que está inactivo entre peticiones no se factura.
Cambie el modelo sin tocar el código de sus herramientas
Cambie el modelo y la definición de su herramienta permanece igual.
Enviamos un mismo cuerpo de petición seis veces el 22 de septiembre de 2026, cambiando solo el campo model , y pedimos a cada modelo que ejecutara python3 -c "print(sum(range(1, 101)))" en la sandbox. Cada modelo hizo una llamada shell y devolvió 5050.
| Modelo | Resultado |
|---|---|
| openai/gpt-5.4-mini | 5050 |
| google/gemini-3.5-flash | 5050 |
| anthropic/claude-haiku-4.5 | 5050 |
| deepseek/deepseek-v3.2 | 5050 |
| moonshotai/kimi-k2.6 | 5050 |
| qwen/qwen3-coder | 5050 |
Los seis se ejecutaron en la misma sandbox con la misma definición de herramienta, independientemente de lo que su propio proveedor ofrezca de forma nativa, porque la sandbox es nuestra y no del proveedor del modelo. Pruebe el modelo que planea usar antes de construir sobre él, porque la fiabilidad del tool-calling difiere entre modelos. Nuestra guía de tool calling explica cómo las herramientas de servidor y tus propias herramientas de función comparten un tools array.
Cuando quieres una plataforma de sandbox propia
Elige una plataforma de sandbox dedicada cuando necesites algo que una herramienta alojada no te ofrece. Modal documenta sandboxes creados a partir de imágenes personalizadas con un tiempo de vida configurable de hasta 24 horas y recursos de GPU. Daytona documenta sandboxes creados a partir de una imagen de contenedor pública, incluidos sandboxes con GPU. E2B documenta sandboxes que se ejecutan durante hasta 24 horas en su plan Pro y 1 hora en su plan básico, con pausa y reanudación para cargas de trabajo más largas.
Conclusión
Para comandos cortos y acotados dentro de una solicitud de modelo, usa una herramienta alojada. Añades una entrada al tools array y obtienes un contenedor aislado con el acceso de red saliente desactivado, y pagas por la inferencia más los segundos que corre el sandbox. Presupuesta varios segundos de sobrecarga por llamada de shell y reutiliza un contenedor cuando puedas.
Pásate a una plataforma de sandbox que tú operes cuando un trabajo necesite una imagen base personalizada, una GPU, una sesión que dure horas o la propiedad del propio límite de seguridad. En cualquier caso, consulta la documentación actual del proveedor antes de comprometerte, porque nuestras dos herramientas están en beta y las herramientas de los otros tres proveedores también cambian.
Preguntas frecuentes
¿Existe una herramienta de shell aislado alojada que los modelos puedan llamar directamente durante una solicitud?
Sí. Nuestra herramienta de servidor openrouter:shell da a un modelo un shell Linux aislado que se ejecuta en nuestra infraestructura durante la solicitud, tanto en la Responses API como en la Messages API. Configura engine a openrouter y los comandos se ejecutan en un contenedor aislado, con el stdout, stderr y el resultado de salida o timeout de cada comando devueltos al modelo. OpenAI, Anthropic y Google ofrecen cada uno una herramienta de ejecución de código alojada para sus propios modelos.
¿Puedo darle a un modelo un shell aislado donde pueda ejecutar comandos?
Sí. Añade {"type": "openrouter:shell", "parameters": {"engine": "openrouter"}} al array tools de una solicitud de la API de Responses o Messages. El modelo puede entonces emitir llamadas de shell, y nosotros ejecutamos los comandos en un contenedor aislado y devolvemos al modelo la salida de cada comando. El contenedor no tiene acceso de red saliente a menos que configures una network_policy allowlist.
¿Qué SDKs o plataformas ofrecen ejecución de código del lado del servidor de forma predeterminada?
Nuestra herramienta de servidor openrouter:shell ejecuta comandos para cualquier modelo en las API de Responses y Messages, y nuestra herramienta de servidor openrouter:bash hace lo mismo solo en la API de Messages. OpenAI, Anthropic y Google ejecutan cada uno código para sus propios modelos mediante la herramienta shell de la API de Responses, la herramienta de ejecución de código y la herramienta de ejecución de código de la API de Gemini. El OpenAI Agents SDK envuelve las herramientas alojadas de OpenAI como CodeInterpreterTool y ShellTool. E2B, Modal y Daytona son plataformas de sandbox que integras y operas tú mismo, en lugar de herramientas que un proveedor ejecuta dentro de la llamada a la API.
¿Cuál es el mejor sandbox para agentes de IA?
Depende de cuánto tiempo dure el trabajo y de cuánto control necesites sobre el entorno de ejecución. Para comandos cortos dentro de una solicitud, una herramienta alojada como openrouter:shell significa que no gestionas ninguna infraestructura. Para una imagen base personalizada, acceso a GPU o una sesión que dure horas, una plataforma de sandbox que operes tú, como Modal o Daytona, te da esos controles.
¿Cómo se aísla en un sandbox a un agente de IA?
Ejecutas los comandos del agente en un entorno aislado de tus propios sistemas y limitas lo que ese entorno puede alcanzar. Con una herramienta alojada, el proveedor hace esto. En OpenRouter, los contenedores están aislados de nuestra infraestructura y de tu máquina, tienen el alcance de tu cuenta y workspace, el acceso de red saliente está desactivado por defecto, cada comando está limitado a timeout_ms, y la salida está limitada por max_output_length. Las barreras de protección del workspace añaden detección de inyección de prompts frente al modelo.
¿Qué es una herramienta de IA en sandbox?
Es una herramienta cuyos efectos secundarios se confinan a un entorno aislado en lugar de tus sistemas de producción. Para la ejecución de código, los comandos del modelo se ejecutan en un contenedor con su propio sistema de archivos, acceso de red restringido y un límite de tiempo, y solo la salida del comando regresa al modelo. Nuestras herramientas de servidor shell y bash funcionan así.