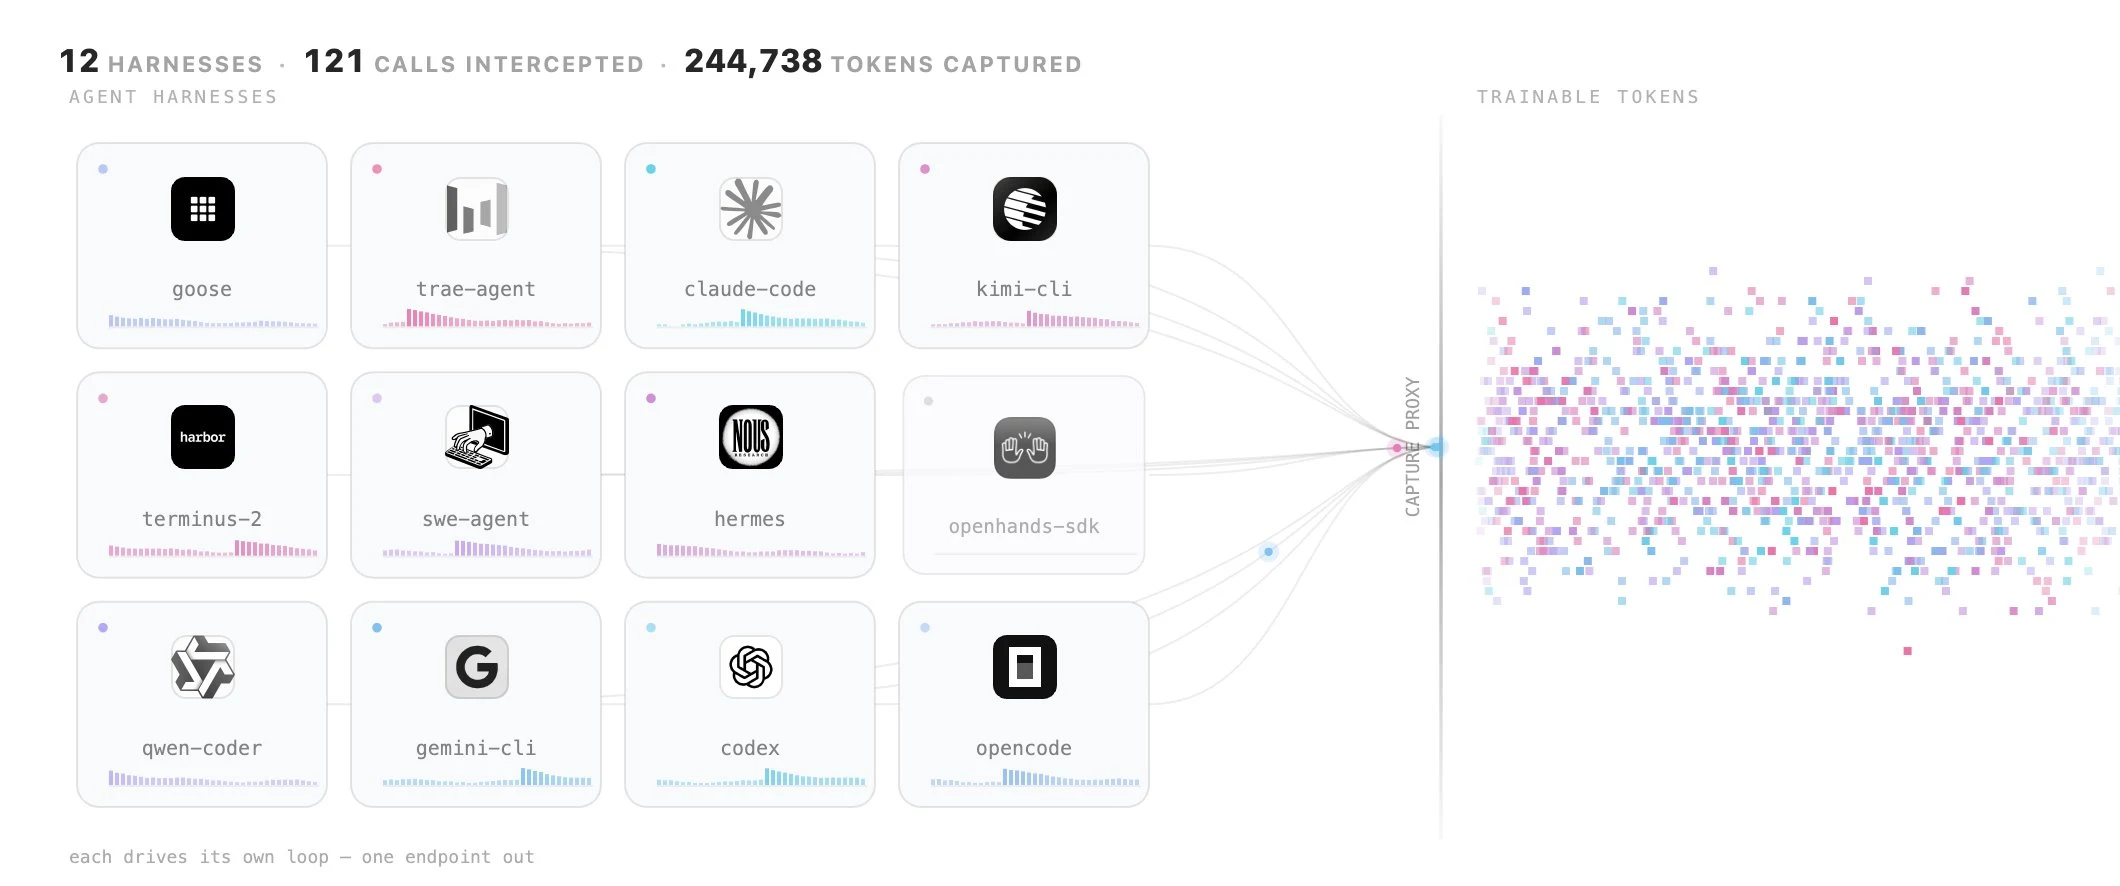
Convertimos Claude Code, Codex, Hermes, Pi, @opencode y otros harnesses de programación en entornos de RL. Sin cambios en los harnesses, sin cambios en el código de entrenamiento. Cualquier modelo abierto, cualquier conjunto de tareas, ¡totalmente open source, amigos!
Mismo modelo, mismos pesos: 62% bajo Mini-SWE-Agent, 33% bajo Claude Code. Pero entrenar dentro de un harness real normalmente significa reimplementarlo como un entorno, así que la mayoría de los modelos se entrenan en un scaffold que nadie publica realmente.
La solución es un proxy, no una reescritura. El harness cree que habla con una API de modelos. En realidad habla con un proxy de captura que entiende los 4 formatos que usan los agentes de programación (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini), reenvía a @vllm_project, registra los token IDs y logprobs exactos que vLLM muestreó, y entrega a TRL secuencias con las que puede entrenar. El harness se convierte en el entorno. Hoy 10 harnesses han pasado por él, ninguno modificado.
Y como tú controlas la recompensa, puedes moldear comportamientos que el harness nunca pidió. Añadimos una pequeña bonificación por resolver una tarea con menos llamadas de herramientas: en tareas que ya resolvía, el modelo ahora usa 31% menos llamadas, en todos los harnesses, y aproximadamente la mitad bajo Codex.
Probado en LFM2.5-2.6B de @liquidai:
→ Entrenar en un harness: mejora sobre todo en ese harness (OpenCode 34% → 58%).
→ Entrenar en 4 a la vez: mejora en los 4 (42% → 54%).
→ SFT sobre 3,189 rollouts de Qwen3.8-27B en su lugar: se estanca en 47.5%, por debajo de ambas ejecuciones de RL.
Todo es abierto y reproducible: el proxy de captura en OpenEnv, el entrenador en TRL, las tareas, los datos de SFT, el código de entrenamiento y los 7 modelos entrenados. Próximamente, modelos más grandes y ejecuciones mayores.
Guía completa: https://huggingface.co/spaces/FineEnvs/multi-harness-RL