
Un desafío crítico que surge a medida que los sistemas multiagente pasan de la experimentación a la producción es asegurarse de que estos sistemas sean consistentemente útiles, precisos y explicables en escenarios del mundo real. Las empresas adoptan cada vez más sistemas multiagente para resolver problemas complejos del mundo real que requieren razonamiento a través de fuentes de datos, herramientas y restricciones del negocio. Desde la planificación de la cadena de suministro hasta el análisis financiero y las operaciones de atención al cliente, estos sistemas van más allá de la simple respuesta a preguntas. Coordinan múltiples agentes especializados para tomar decisiones, ejecutar flujos de trabajo y generar recomendaciones accionables.
Si bien los modelos de lenguaje de gran escala pueden generar respuestas fluidas, las aplicaciones empresariales requieren garantías mucho más profundas, donde los agentes deben seguir las instrucciones de manera confiable, seleccionar las herramientas correctas, respetar las restricciones y proporcionar un razonamiento claro detrás de sus resultados.
Amazon Bedrock AgentCore es una plataforma para construir, conectar y optimizar agentes a escala, con cualquier framework o modelo. Amazon Bedrock AgentCore Evaluations, una capacidad de Amazon Bedrock AgentCore, está diseñado para abordar este desafío como una capacidad completamente administrada para evaluar el rendimiento de los agentes a lo largo del desarrollo y la producción, de modo que los equipos puedan medir la precisión, el éxito de las tareas y el comportamiento en múltiples dimensiones de calidad. Los enfoques tradicionales de evaluación que se centran solo en la calidad de la respuesta del modelo son insuficientes para los sistemas agénticos, donde la corrección depende de la selección de herramientas, la ejecución del flujo de trabajo y el cumplimiento de las restricciones del negocio. Además de la evaluación, la implementación en producción de sistemas agénticos requiere controles de IA responsable. Amazon Bedrock Guardrails proporciona salvaguardas configurables como filtrado de contenido, detección de temas denegados y validación de fundamentación que complementan el marco de evaluación. Mientras que las evaluaciones evalúan la calidad del agente después de la ejecución, Guardrails hace cumplir las restricciones de seguridad durante la ejecución. En esta publicación, nos centramos en operacionalizar este marco de evaluación con el soporte de Amazon Bedrock AgentCore Evaluations tanto para evaluadores integrados como para evaluadores personalizados. Los evaluadores integrados ofrecen evaluaciones predefinidas para dimensiones de calidad comunes como utilidad, éxito de tareas y seguimiento de instrucciones, de modo que los equipos puedan establecer rápidamente una línea base del rendimiento del agente sin configuración adicional. Sin embargo, los casos de uso empresariales requieren una validación más profunda y específica del dominio. Los evaluadores personalizados abordan esto, permitiéndole definir verificaciones conscientes del negocio.
También nos centramos específicamente en la explicabilidad como una dimensión de evaluación de primera clase. Demostramos cómo los evaluadores integrados pueden evaluar la claridad general de las respuestas. Mostramos cómo se utilizan los evaluadores personalizados para verificar que los agentes articulen explícitamente la justificación de sus decisiones, hagan referencia a datos de apoyo o salidas de herramientas, y expliquen compromisos como costo frente a nivel de servicio. Al combinar estos evaluadores, mostramos cómo AgentCore Evaluations puede ir más allá de la calidad superficial de las respuestas y proporcionar información estructurada y medible sobre cómo y por qué los agentes llegan a sus decisiones.
Para hacer concretos estos conceptos, las siguientes secciones recorren una arquitectura de referencia y una implementación que demuestra cómo estos componentes funcionan juntos en la práctica.
Descripción general de la solución
Para esta publicación, usamos una empresa minorista global ficticia llamada AnyCompany Retail, un minorista multinacional que opera canales de comercio electrónico, centros de cumplimiento regionales, centros de distribución y miles de tiendas físicas. AnyCompany experimenta frecuentes desequilibrios de inventario: algunas regiones enfrentan desabastecimiento durante las promociones, mientras que otras tienen inventario en exceso. Los equipos de transporte también deben equilibrar la velocidad de entrega, la capacidad de los transportistas y el costo. La empresa quiere un asistente agéntico que pueda ayudar a los planificadores a optimizar la asignación de inventario, recomendar ajustes de distribución, analizar la salud del inventario y simular escenarios de enrutamiento o cumplimiento.
Construirá y evaluará un sistema de toma de decisiones para la cadena de suministro multiagente utilizando Strands Agents SDK, Amazon Bedrock AgentCore MCP Server y Amazon Bedrock AgentCore Evaluations. La solución utiliza Strands Agents con un agente orquestador y cuatro subagentes especializados: un agente de optimización, un agente de distribución, un agente de enrutamiento y un agente de análisis. Cada agente se ejecuta en Amazon Bedrock AgentCore runtime con Amazon Bedrock AgentCore memory y Amazon Bedrock AgentCore Observability habilitados.
El agente orquestador recibe la solicitud del planificador y delega el trabajo a agentes especializados expuestos como herramientas. El agente de optimización llama a herramientas de MCP respaldadas por interfaces REST simuladas de Amazon API Gateway que devuelven decisiones de optimización. El agente de distribución llama a las API de recomendaciones para sugerir el reequilibrio de inventario en los centros de distribución, las tiendas y los canales digitales. El agente de enrutamiento llama a las API logísticas para recomendar opciones de transportista y ruta, y el agente de análisis responde preguntas de diagnóstico de la cadena de suministro. Esta solución utiliza modelos fundacionales en Amazon Bedrock para el bucle del agente. Para conocer la disponibilidad de los modelos por región, consulte Supported models by AWS Region in Amazon Bedrock.
La solución utiliza evaluadores integrados que evalúan dimensiones generales de calidad, como la utilidad y la finalización de tareas. También proporciona evaluadores personalizados que evalúan comportamientos específicos de la cadena de suministro, como la satisfacción de restricciones, la viabilidad de rutas, la corrección de SQL, la fundamentación del inventario y la calidad de las explicaciones. AnyCompany puede evaluar tanto la calidad del lenguaje de la respuesta como la validez empresarial de la decisión del agente.
La solución es compatible con los modos bajo demanda y en línea con Amazon Bedrock AgentCore Evaluations. El modo bajo demanda está destinado a la evaluación comparativa en desarrollo, las pruebas de regresión y las puertas de integración y entrega continuas (CI/CD). El modo en línea es para la monitorización continua de producción y las alertas. Ambos modos ayudan a cerrar el ciclo y actuar según los comentarios de los usuarios. Los mismos evaluadores personalizados (como los evaluadores de satisfacción de restricciones, viabilidad de rutas, corrección de SQL y explicabilidad de su solución de cadena de suministro) utilizados para las evaluaciones bajo demanda se reutilizan con un objeto OnlineEvaluationConfig que hace referencia a los nombres de recursos de Amazon (ARN) de los evaluadores y especifica una tasa de muestreo (por ejemplo, 1–10% de los rastros de producción) junto con filtros de sesión opcionales. A continuación, el servicio lee automáticamente los rastros de AgentCore Observability, los puntúa y transmite los resultados a los paneles y las alarmas de Amazon CloudWatch . En esta publicación, utilizará el modo bajo demanda para probar la solución.
El siguiente diagrama de arquitectura ilustra los diversos componentes de nuestra solución.
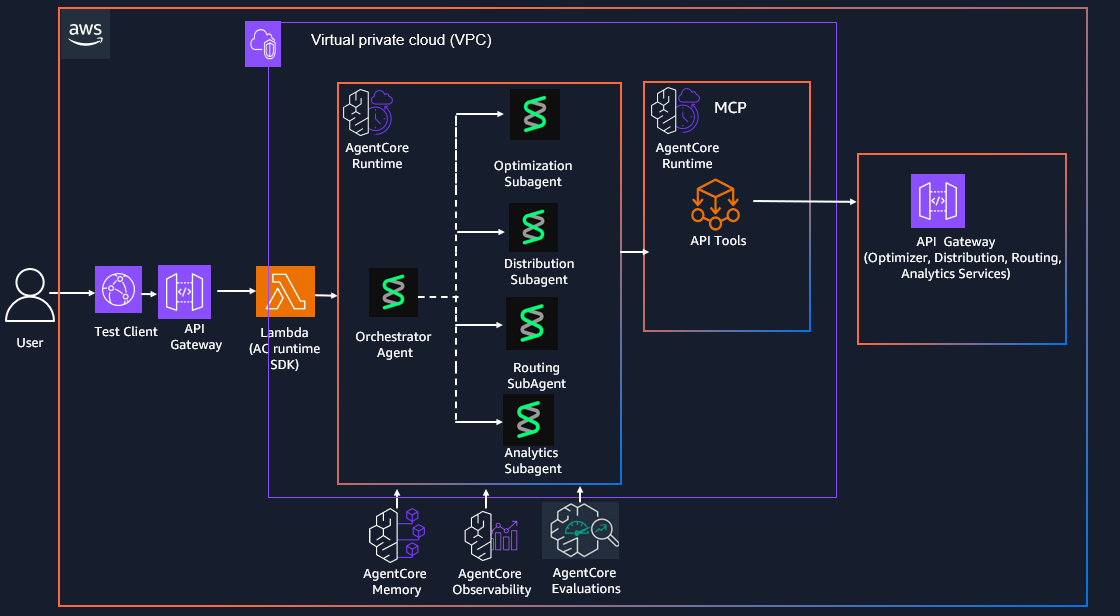
Figura 1: Arquitectura de la solución de toma de decisiones de cadena de suministro multiagente
Marco de evaluación
En esta publicación, utilizará un enfoque de evaluación de tres capas para sistemas multiagente que construye progresivamente la confianza empresarial. El enfoque sigue una progresión clara que comienza con evaluadores integrados para la calidad general, luego agrega evaluadores personalizados para la precisión empresarial y, finalmente, incorpora evaluadores de explicabilidad para la confianza y la auditabilidad.
La primera capa utiliza evaluadores integrados que no requieren configuración. Aplicamos Helpfulness como línea base universal, además de un segundo evaluador específico del agente orientado al modo de fallo principal de cada agente: Tool Selection Accuracy para el orquestador, Response Relevance para optimización y distribución, Instruction Following para enrutamiento y Faithfulness para análisis.
La segunda capa agrega evaluadores personalizados que codifican reglas empresariales específicas del dominio: satisfacción de restricciones para optimización, fundamentación de datos para distribución, viabilidad de rutas para enrutamiento, corrección de SQL para análisis y coherencia del plan para la orquestación. Estos validan la validez empresarial: ¿la recomendación respetó los límites presupuestarios, utilizó datos reales de inventario y produjo resultados operativamente correctos?
La siguiente tabla muestra los dos evaluadores integrados y el evaluador personalizado seleccionados para cada agente que implementará aquí. El segundo evaluador integrado se orienta al modo de fallo principal de cada agente, mientras que el evaluador personalizado codifica reglas empresariales específicas del dominio que validan la corrección operativa.
| Agente | Evaluadores integrados | Evaluadores personalizados |
| Agente orquestador | Helpfulness; Tool Selection Accuracy | Evaluador de coherencia del plan: ¿combinó las salidas de los subagentes en una recomendación válida y sin contradicciones? Evaluador de trayectoria de herramientas: ¿enrutó hacia el subagente correcto? |
| Agente de optimización | Helpfulness; Response Relevance | Evaluador de satisfacción de restricciones: presupuesto, cobertura de inventario (demanda ≤ cantidad ≤ 2× demanda) y restricciones de capacidad del almacén. Evaluador de logro de indicadores clave de rendimiento (KPI): objetivo de mejora de la tasa de servicio/ingresos alcanzado. |
| Agente de distribución | Helpfulness; Response Relevance | Evaluador de fundamentación de recomendaciones: la recomendación se fundamenta en datos actuales de inventario/demanda. Evaluador de impacto del riesgo: la recomendación mejora el riesgo de quiebre de stock/sobreabastecimiento. |
| Agente de enrutamiento | Helpfulness; Instruction Following | Evaluador de viabilidad de rutas: la ruta respeta la ventana de entrega, el costo, la capacidad del transportista y las restricciones de región. Evaluador de acuerdo de nivel de servicio (SLA): la entrega esperada cumple el nivel de servicio objetivo. |
| Agente de análisis | Helpfulness; Faithfulness | Evaluador de corrección de SQL: la consulta coincide con la intención del usuario. Evaluador de fundamentación en datos: la respuesta está respaldada por los resultados de consultas de Amazon Relational Database Service (Amazon RDS). Evaluador de afirmaciones no respaldadas. |
Explicabilidad
La tercera capa de nuestro enfoque de evaluación aplica evaluadores de explicabilidad como comprobaciones transversales e independientes sobre los agentes. Estos evalúan de forma independiente si los agentes articulan la justificación de sus decisiones, citan evidencia de respaldo proveniente de las salidas de las herramientas, explican qué restricciones dieron forma a la respuesta, articulan los compromisos entre objetivos en competencia, aclaran por qué se invocaron sub-agentes específicos y revelan los supuestos cuando los datos están incompletos. Al separar la explicabilidad en su propia capa de evaluación, podemos medir la transparencia de manera independiente. Una recomendación puede ser precisa pero inexplicable (aprobando los evaluadores personalizados pero fallando en la explicabilidad), lo que brinda a los equipos señales accionables sobre si los agentes necesitan una mejor articulación del razonamiento en lugar de una mejor lógica de decisión.
La siguiente tabla define los seis evaluadores de explicabilidad independientes que usted implementa aquí y que se aplican a los agentes como una capa transversal. Estos evalúan si los agentes articulan el razonamiento, citan evidencia, explican restricciones y compromisos, y revelan supuestos. Se miden por separado de la precisión para que los equipos puedan distinguir las respuestas inexplicables pero correctas de las bien explicadas pero incorrectas.
| Evaluador | Agentes | Qué verifica |
| Calidad de la justificación de la decisión | Todos | ¿Explicó el agente por qué hizo la recomendación? |
| Atribución de evidencia | Analytics, Distribution, Routing | ¿Citó los campos de datos, la respuesta de la API o el resultado de SQL utilizados? |
| Razonamiento de restricciones | Optimization, Routing | ¿Explicó qué restricciones dieron forma a la respuesta final? |
| Explicación de compromisos | Optimization, Distribution, Routing | ¿Explicó los compromisos entre el costo, el nivel de servicio y el riesgo de inventario? |
| Explicabilidad del uso de herramientas | Orchestrator | ¿Explicó por qué se invocó cada sub-agente o herramienta de MCP? |
| Revelación de supuestos | Todos los agentes | ¿Indicó claramente los supuestos cuando los datos estaban incompletos? |
Requisitos previos
Antes de implementar esta solución, configure su entorno de desarrollo con las siguientes herramientas.
- Instale la AWS Command Line Interface (AWS CLI)
- Instale la AWS Serverless Application Model (AWS SAM) CLI v1.100.0+
- Instale Docker v20.x+
- Instale Node.js v18.x+
- Instalación Python v3.11+
Dependencias
La implementación de Strands Agents también necesita tener las siguientes dependencias que están empaquetadas en el DockerFile:
- strands-agents # Framework multiagente Strands Agents
- strands-agents-tools # Herramientas y utilidades para agentes Strands
- requests # Biblioteca HTTP para llamadas a API
- bedrock-agentcore # Funcionalidad principal de agentes de Amazon Bedrock
- boto3 # SDK de AWS para Python (Boto3)
Despliegue y ejecución de la solución
La solución está disponible para descargar en nuestro repositorio de GitHub y ofrece un despliegue de un solo paso para desplegar y acceder a la solución en su entorno de AWS:
# Edit terraform.tfvars: set vpc_id and runtime_subnet_azs
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
Las salidas incluyen los ARN de runtime, la URL de la API de AnyCompany Retail, la URL de la API del evaluador y el ARN de memoria.
Ejecución de la solución
Siga estos pasos para ejecutar la solución:
La carpeta test_client/ contiene un script de Python que invoca al agente de Supply Chain desplegado con 20 consultas de ejemplo (5 por subagente) para validar la funcionalidad de extremo a extremo. Cada categoría se ejecuta como una sesión multiturno, y los IDs de sesión se imprimen al final para usarlos con la API de evaluadores.
cd test_client
pip install -r requirements.txt
cd terraform
terraform output supply_chain_arn
Ejecutar todas las consultas (20 en total, 4 sesiones)
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" --region <your_region>
Ejecutar categorías específicas de subagentes
#Only optimization queries (1 session, 5 turns)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
#Only routing and analytics (2 sessions, 5 turns each)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category routing analytics
El cliente de prueba imprime cada consulta y la respuesta completa del agente. Al final imprime los IDs de sesión para usarlos con los evaluadores.
Creación y ejecución de evaluaciones
La carpeta test_evaluators/ contiene scripts para ejecutar evaluaciones sobre sesiones de agentes. Estas evaluaciones se ejecutan de forma asíncrona y los resultados se guardan como archivos markdown en S3.
Debe invocar primero la solución multiagente de toma de decisiones de supply chain como se describió anteriormente para generar sesiones de agente con trazas, y anotar los IDs de sesión impresos al final de la ejecución del cliente de prueba. Finalmente, espere de 3 a 5 minutos después de ejecutar la solución para que las trazas se propaguen a CloudWatch.
cd test_evaluators
pip install -r requirements.txt
cd terraform
terraform output evaluators_api_url
Crear evaluadores personalizados
python test_evaluator.py --api-url "https://<evaluators-api-url>" createEsto registra los evaluadores personalizados e imprime sus IDs. Guárdelos para usarlos con el comando de ejecución.
Ejecutar evaluaciones
Pase una lista de IDs de evaluadores separados por comas (personalizados o integrados). Se requiere al menos 1:
# Run custom + built-in evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<session-id-from-test-client>" \
--evaluators " sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>,Builtin.Correctness,Builtin.GoalSuccessRate"
La API devuelve 202 inmediatamente. Los resultados se guardan de forma asíncrona en S3 en:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<session-id>/<timestamp>/EvaluationResults.mdEliminar evaluadores
python test_evaluator.py --api-url "https://<evaluators-api-url>" delete \
--evaluator-ids "sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>"
Ejecutar una evaluación de optimización
Ahora que comprende el marco de evaluación y ha desplegado la solución, veamos una evaluación integral enfocada del agente de optimización. Este recorrido demuestra cómo combinar un evaluador personalizado de precisión de negocio (Capa 2) con evaluadores de explicabilidad (Capa 3) para evaluar tanto la corrección como la transparencia de las decisiones de optimización.
Paso 1: Ejecutar consultas de optimización
Primero, invoque al cliente de prueba solo con la categoría de optimización para generar una sesión enfocada:
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" \
--category optimization \
--region <your_region>
Esto ejecuta 5 consultas de optimización como una sesión multiturno. El agente procesa solicitudes como «¿Cuál es el nivel óptimo de inventario para prod-001 durante los próximos 30 días?». Cada consulta requiere que el agente de optimización llame a herramientas MCP, recupere pronósticos de demanda y produzca recomendaciones de abastecimiento que respeten las restricciones de presupuesto, cobertura de inventario y capacidad de almacén. Al final de la ejecución, el cliente de prueba imprime el ID de sesión de optimización.
Paso 2: Ejecutar el evaluador de Satisfacción de Restricciones (Capa 2: precisión de negocio)
Con la sesión de optimización generada, ejecute el evaluador personalizado de Satisfacción de Restricciones para validar si las recomendaciones de abastecimiento del agente respetan las reglas de negocio. Este evaluador verifica tres restricciones simultáneamente:
- Presupuesto: ¿El costo incremental de mantenimiento se ajusta al presupuesto restante (budget_limit − budget_used)?
- Cobertura de inventario: ¿El nivel recomendado es ≥ a la previsión de demanda (evita el desabastecimiento) y ≤ 2× la demanda (evita el exceso)?
- Capacidad de almacén: ¿El nivel recomendado cabe dentro del espacio disponible en el almacén?
Ejecute el evaluador junto con los evaluadores integrados de Utilidad (Helpfulness) y Relevancia de la respuesta:
cd test_evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
La API devuelve HTTP 202 de inmediato. Las evaluaciones se ejecutan de forma asíncrona. Los resultados se guardan en S3:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<optimization-session-id>/<timestamp>/EvaluationResults.mdPaso 3: Ejecute los evaluadores de explicabilidad (Capa 3: confianza y auditabilidad)
Después de confirmar que el agente de optimización produce recomendaciones que satisfacen las restricciones, la siguiente pregunta es: ¿explica su razonamiento? Una recomendación puede ser precisa pero opaca. Dicha recomendación pasa el evaluador de restricciones pero no logra articular por qué eligió un nivel de inventario específico.
Usando el mismo ID de sesión de optimización del Paso 1, ejecute ahora los dos evaluadores de explicabilidad que se aplican al agente de optimización:
- Decision Rationale Quality — ¿Explicó el agente por qué hizo la recomendación? (por ejemplo, «Recomendamos 1,500 unidades porque el pronóstico de demanda es 1,200 y apuntamos a un factor de seguridad de 1.25×»)
- Constraint Reasoning — ¿Explicó el agente qué restricciones dieron forma a la respuesta final? (por ejemplo, «El presupuesto permite hasta 1,800 unidades, pero la capacidad del almacén nos limita a 1,600, por lo que recomendamos 1,500»)
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
Estos evaluadores evalúan la transparencia de manera independiente. Se miden por separado de la precisión.
Interpretación de los resultados combinados
Al ejecutar los tres evaluadores contra la misma sesión de optimización, obtiene una imagen completa de la calidad del agente en dos dimensiones:
| Dimensión | Evaluador | Pregunta respondida |
| Precisión empresarial (Capa 2) | Constraint Satisfaction | ¿Son las recomendaciones operativamente correctas? |
| Explicabilidad (Capa 3) | Decision Rationale Quality | ¿Por qué hace el agente esta recomendación? |
| Explicabilidad (Capa 3) | Constraint Reasoning | ¿Qué restricciones dieron forma a la respuesta? |
Tabla 3: Cobertura de evaluación en las dimensiones de calidad
Este enfoque por capas permite mejoras específicas. Si las puntuaciones de satisfacción de restricciones son altas pero las puntuaciones de explicabilidad son bajas, la lógica de decisión del agente es sólida, pero su comunicación necesita trabajo. Por el contrario, si la explicabilidad es alta pero se violan las restricciones, el agente articula bien el razonamiento pero aplica una lógica incorrecta. Cada modo de fallo tiene una ruta de remediación diferente, y el marco de evaluación hace que esta distinción sea medible.
Limpieza
Para evitar cargos recurrentes, limpie su cuenta de AWS en un solo paso después de probar la solución.
terraform destroyConclusión
En esta publicación, demostramos cómo construir y evaluar un sistema de toma de decisiones de cadena de suministro multiagente utilizando Amazon Bedrock AgentCore Evaluations, con un enfoque en verificar que el comportamiento del agente no solo sea funcional, sino también útil, preciso y explicable. Usando el escenario de AnyCompany Retail Group, mostramos cómo un agente orquestador y subagentes especializados colaboran para resolver problemas complejos como la asignación de inventario, la planificación de distribución, la optimización de rutas y el diagnóstico de la cadena de suministro, al tiempo que se integran con fuentes de datos empresariales y API. Como se ilustró a lo largo de la arquitectura, la corrección en los sistemas agénticos va más allá de la calidad de la respuesta. Depende de seleccionar las herramientas adecuadas, ejecutar el flujo de trabajo correcto, respetar las restricciones empresariales y fundamentar los resultados en datos.
Al combinar evaluadores integrados con evaluadores personalizados, los equipos pueden validar sistemáticamente tanto la calidad general de las respuestas como la precisión de las decisiones específicas del dominio. La incorporación de evaluadores centrados en la explicabilidad garantiza además que los agentes articulen claramente su razonamiento, referencien datos de apoyo y expliquen las compensaciones de una manera en la que los usuarios empresariales puedan confiar y actuar. Este enfoque basado en la evaluación permite la mejora continua utilizando datos de ejecución reales, establece puertas de calidad antes del despliegue en producción y proporciona un marco escalable para entregar sistemas multiagente consistentes, transparentes y alineados con el negocio.
Para comenzar, explore Amazon Bedrock AgentCore Evaluations y aplique estos patrones a sus propias aplicaciones multiagente. Encuentre el código fuente completo en el repositorio de ejemplos de Amazon Bedrock AgentCore en GitHub. Comience habilitando la observabilidad, definiendo dimensiones clave de evaluación para su caso de uso e introduciendo de manera incremental evaluadores integrados y personalizados para medir lo que más importa.
Para obtener más información, visite la Amazon Bedrock AgentCore página del servicio o comience directamente en la consola de Amazon Bedrock.
Publicaciones relacionadas:
- Cree agentes de IA confiables con Amazon Bedrock AgentCore Evaluations
- Cree sistemas multiagente LangGraph serverless altamente escalables en AWS con Amazon Bedrock AgentCore
- Evaluación de agentes de IA: lecciones del mundo real de la creación de sistemas agénticos en Amazon