
Cuando un usuario le pide al asistente de soporte, una aplicación de Generación Aumentada por Recuperación (RAG) construida con LangChain, que compare dos productos en tres dimensiones, en realidad está planteando seis preguntas simultáneamente. La búsqueda por similitud usa un solo vector de consulta para encapsular todas las intenciones. El recuperador genera entonces la mejor aproximación del promedio de esas intenciones. La respuesta resultante vuelve concisa. La búsqueda se ejecuta sin errores. Las puntuaciones de relevancia parecen razonables. Sin embargo, los fragmentos recuperados, aunque topicalmente relevantes, solo cubren una fracción de lo que la pregunta realmente pedía.
En esta publicación, mostramos una aplicación RAG en una Amazon Bedrock Managed Knowledge Base con LangChain. Ejecutamos la misma pregunta de varias partes mediante la recuperación estándar y la agéntica, y leemos los eventos de rastreo para ver el plan que produjo el modelo. También cubrimos lo que cuestan las dos rutas de recuperación y cuándo la más barata es la elección correcta.
La recuperación agéntica está disponible en Amazon Bedrock Managed Knowledge Base. En lugar de una sola búsqueda, Amazon Bedrock Managed Knowledge Base planifica la recuperación. Divide la pregunta en subconsultas, las ejecuta, evalúa si tiene suficiente evidencia y vuelve a buscar si no la tiene. El paquete langchain-aws expone tanto la recuperación agéntica como la estándar, de modo que puede usar cualquiera desde una aplicación LangChain.
Descripción general de la solución
Amazon Bedrock Managed Knowledge Base, la capacidad RAG totalmente administrada en Amazon Bedrock, elimina de la arquitectura RAG el almacén vectorial autoadministrado, los modelos de embeddings y de reclasificación. Usted configura una fuente de datos, y Amazon Bedrock Managed Knowledge Bases gestiona la fragmentación, la generación de embeddings, el almacenamiento y la recuperación. Este tutorial usa Amazon Simple Storage Service (Amazon S3).
Amazon Bedrock Managed Knowledge Bases proporciona dos API. Analizamos brevemente esas diferencias en esta publicación. La API Retrieve ejecuta una búsqueda híbrida y devuelve fragmentos con puntuación. La API AgenticRetrieveStream ejecuta un bucle de planificación y le transmite los pasos como eventos de rastreo. En el paquete langchain-aws , la primera es un recuperador estándar de LangChain que puede incorporar en una cadena. La segunda es una función de recuperación directamente desde una base de conocimiento.
El siguiente diagrama muestra la arquitectura de la solución. La aplicación consulta Amazon Bedrock Knowledge Bases usando la API Retrieve (estándar, de una sola pasada) o la API AgenticRetrieveStream (bucle de planificación de varios pasos). Ambas rutas devuelven fragmentos de documentos de la base de conocimiento, que la aplicación luego usa para generar una respuesta fundamentada.
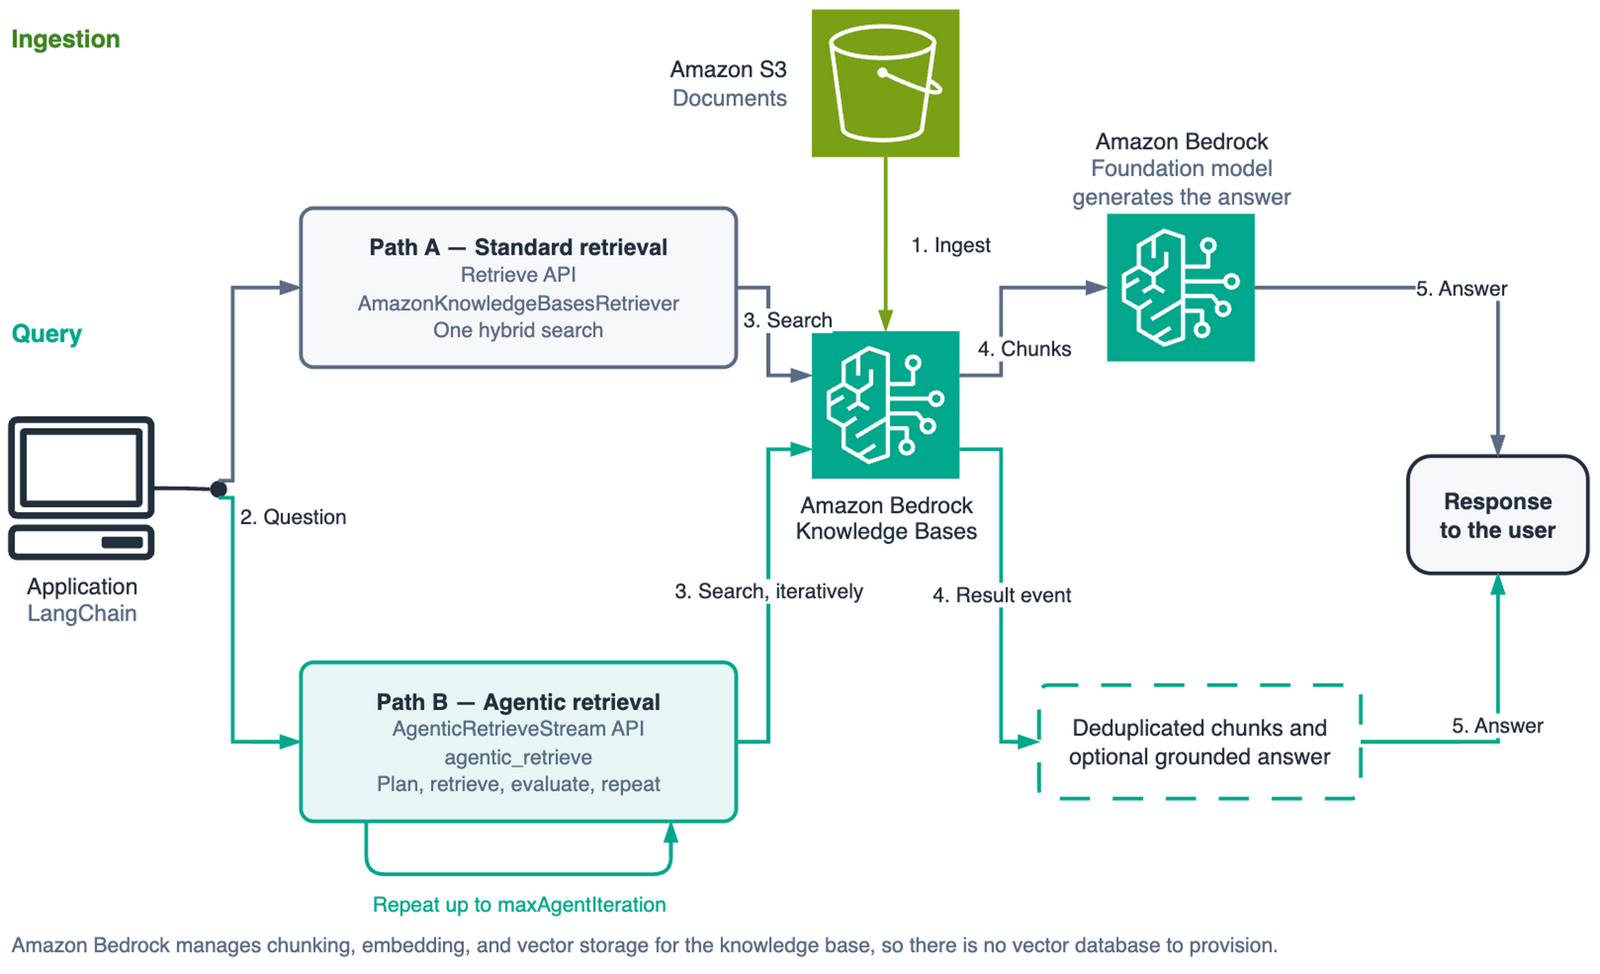
Figura 1: Arquitectura de la solución para consultar Amazon Bedrock Knowledge Bases con las API Retrieve y AgenticRetrieveStream
Recorrido de implementación
Las siguientes secciones le guían a través de la creación de una base de conocimiento, la consulta con ambos métodos de recuperación y la lectura de los eventos de rastreo que produce el planificador agéntico.
Requisitos previos
Para seguir este tutorial necesita:
- Una cuenta de AWS con acceso a Amazon Bedrock en una Región donde Amazon Bedrock Managed Knowledge Bases y la recuperación agéntica estén disponibles. Este tutorial usa la Región US East (N. Virginia) (
us-east-1) y el código lo asume en todo momento. Consulte la documentación de AWS para conocer la disponibilidad y el soporte en otras Regiones. - Dos identidades de AWS Identity and Access Management (IAM), descritas en la siguiente sección: un rol de servicio que asume la base de conocimiento y permisos en la identidad desde la cual llama a las API.
- Python 3.12 o posterior.
- Un bucket de S3 que contiene los documentos de ejemplo. El corpus necesita varios documentos que cubran temas superpuestos para que una pregunta comparativa tenga a dónde ir. Un único documento plano no puede demostrar la planificación de consultas.
Instala los paquetes. La Boto3 versión importa: agentic_retrieve_stream no existía antes de la 1.43.32.
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
Permisos
Hay dos identidades involucradas y conviene separarlas deliberadamente. La base de conocimiento asume un rol de servicio para leer sus documentos y llamar al modelo de embeddings. Su aplicación usa una identidad de llamador de AWS Security Token Service (AWS STS) para consultar. Ninguna necesita los permisos de la otra.
Amazon Bedrock crea el rol de servicio por usted si se lo permite. Para proporcionar el suyo propio, dele una política de confianza que permita a Amazon Bedrock asumirlo. Delimite su alcance con aws:SourceAccount y aws:SourceArn para que otra cuenta no pueda usarlo como un sustituto confundido (confused deputy):
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
El rol de servicio también necesita s3:ListBucket en su bucket y s3:GetObject en su contenido, ambos condicionados a aws:ResourceAccount. Reduzca el alcance del carácter comodín knowledge-base/* a IDs específicos de bases de conocimiento después de crearlos.
La identidad de llamador de AWS STS necesita un conjunto diferente. bedrock:AgenticRetrieveStream y bedrock:InvokeModelWithResponseStream no pueden limitarse al ARN (Amazon Resource Name) de una base de conocimiento. bedrock:Retrieve y bedrock:GetDocumentContent sí pueden:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent a menudo se pasa por alto. La recuperación agéntica lo llama cuando un paso FullDocumentExpansion decide que un pasaje carece del contexto para responder. Una política con solo bedrock:Retrieve funciona hasta que el planificador busca un documento completo y luego falla a mitad de una consulta.
Para crear y administrar la propia base de conocimiento, el rol que llama además necesita bedrock:CreateKnowledgeBase en *, y las acciones GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJoby ListIngestionJobs en knowledge-base/*. Si usa guardrails, agregue bedrock:GetGuardrail y bedrock:ApplyGuardrail.
Ejecutar este tutorial puede generar costos por almacenamiento e ingesta de documentos en la base de conocimiento, llamadas de recuperación e inferencia del modelo fundacional (FM).
Para obtener más información sobre los precios, consulte la sección Knowledge Bases de Amazon Bedrock pricing.
Elimine los recursos cuando complete este experimento.
Creación y llenado de la base de conocimiento
Cree la base de conocimiento con un managedKnowledgeBaseConfiguration. Establecer embeddingModelType a MANAGED utiliza el modelo de embeddings gestionado por el servicio.
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
No hay storageConfiguration en esa solicitud. Para una base de conocimiento autogestionada pasarías uno que describa tu almacén de vectores. Amazon Bedrock Managed Knowledge Base no acepta uno, lo cual es la señal más clara en la API de que Amazon Bedrock es dueño de la capa de almacenamiento.
Adjunta el bucket de S3 como fuente de datos y luego inicia un trabajo de ingesta. La ingesta es asíncrona, así que consulta (poll) hasta que el trabajo alcance un estado terminal en lugar de esperar un intervalo fijo y rezar.
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
La configuración completa de la fuente de datos y el manejo de errores están en el repositorio de ejemplo.
Consulta con el retriever de LangChain
AmazonKnowledgeBasesRetriever envuelve la API Retrieve y se comporta como cualquier otro retriever de LangChain. Para Amazon Bedrock Managed Knowledge Bases, pasa managedSearchConfiguration. Esta es la parte que confunde a la gente: vectorSearchConfiguration es el camino anterior para bases de conocimiento donde ejecutas tu propio almacén de vectores. Es lo que muestran la mayoría de los ejemplos existentes.
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
Cada resultado llega como un Documentde LangChain. La puntuación de relevancia está en metadata["score"], y los metadatos propios del documento fuente están bajo metadata["source_metadata"], renombrados para que no colisionen. Si quieres descartar resultados de baja confianza, establece min_score_confidence en el retriever en lugar de filtrar después.
Para una pregunta con una intención clara, esta es la herramienta adecuada. Es una sola llamada. La latencia es la más baja de las dos opciones y mantienes control total sobre cómo se genera la respuesta. La mayoría de las consultas que ve un asistente en producción tienen esta forma, y recurrir a un bucle de planificación para responderlas desperdicia dinero y tiempo.
Dónde se queda corto la recuperación de una sola pasada
Ahora dale al mismo retriever una pregunta con varias partes:
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
Vuelven cinco chunks, clasificados por puntuación híbrida contra un solo embedding de toda esa pregunta.
Esa pregunta contiene seis intenciones: dos servicios a lo largo de tres dimensiones. Puntuar el texto recuperado en busca de evidencia de cada una da una medida concreta de lo que recupera un solo embedding.
| numberOfResults | Chunks | Porcentaje del corpus | Subintenciones cubiertas | Faltantes |
| 5 | 5 | 10% | 4 de 6 | checkout on-call, inventory restore |
| 10 | 10 | 19% | 6 de 6 | ninguna |
Con cinco resultados, un embedding que representa seis intenciones pierde dos de ellas. Con diez cubre las seis, con un desperdicio visible: dos subintenciones se cubren dos veces y un chunk no aporta ninguna.
El recuperador hizo su trabajo. La limitación es estructural: un solo vector no puede representar seis intenciones, y no hay ningún paso en el proceso que pregunte si la evidencia devuelta es suficiente para responder la pregunta.
Ejecutar la recuperación agéntica
La recuperación agéntica no es un retriever de LangChain, sino una característica de Amazon Bedrock Managed Knowledge Bages. El langchain-aws paquete la expone como una función independiente, agentic_retrieve, porque la API subyacente transmite sus resultados en streaming y no encaja con la interfaz síncrona BaseRetriever . No hay ningún flag en AmazonKnowledgeBasesRetriever que la active.
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
Con generate_response=True, el servicio devuelve una respuesta fundamentada y citas junto con los fragmentos recuperados, de modo que obtienes una respuesta sin tener que cablear una llamada separada a un modelo. La función solo funciona contra un Amazon Bedrock Managed Knowledge Base.
Internamente, el servicio planifica, recupera, evalúa si la evidencia es suficiente e itera si no lo es. La función auxiliar oculta todo eso y devuelve los fragmentos finales, lo cual es conveniente y significa que no puedes ver el plan.
Leer los eventos de traza
Para ver cómo el modelo descompone la pregunta, llama a agentic_retrieve_stream en el cliente bedrock-agent-runtime directamente. Este es el único punto de este tutorial donde rodeamos langchain-aws, porque la función auxiliar descarta los eventos de traza y no expone maxAgentIteration ni un modelo de planificador personalizado.
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
Establece generateResponse a False cuando solo quieras el comportamiento de recuperación. La API genera de forma predeterminada una respuesta fundamentada, lo que cuesta una llamada adicional al modelo que quizás no necesites mientras inspeccionas el plan.
El campo step de un evento de traza te dice dónde está el planificador. SpeculativeRetrieval se ejecuta antes del primer plan para reducir la latencia y no cuenta dentro de tu presupuesto de iteraciones. Planning es donde el modelo lee la pregunta y los resultados previos y emite subconsultas. Retrieval se dispara una vez por subconsulta. FullDocumentExpansion aparece cuando el modelo decide que un pasaje carece del contexto necesario para responder y recupera el documento completo en su lugar. Cada uno lleva un estado de IN_PROGRESS, SUCCEEDED, o FAILED, además de un mensaje legible para humanos.
Los fragmentos finales llegan por separado. El result es su propio tipo de evento en lugar de un quinto paso, y contiene los fragmentos deduplicados de todas las iteraciones junto con la respuesta fundamentada cuando la generación de respuestas está activada. Ramifica según la clave del evento, como demuestra el bucle anterior, en lugar de esperar un valor de paso terminal.
El texto de la subconsulta es la parte que vale la pena registrar. Se encuentra en attributes.actions[].retrieve.inputQuery.text, no en los campos de traza de nivel superior, por lo que un controlador que solo lee step y status le muestra que ocurrió la planificación sin mostrarle qué decidió.
El siguiente diagrama muestra el bucle de planificación de recuperación agéntica, incluidos los pasos de recuperación especulativa, planificación, recuperación de subconsultas, evaluación y replanificación opcional.
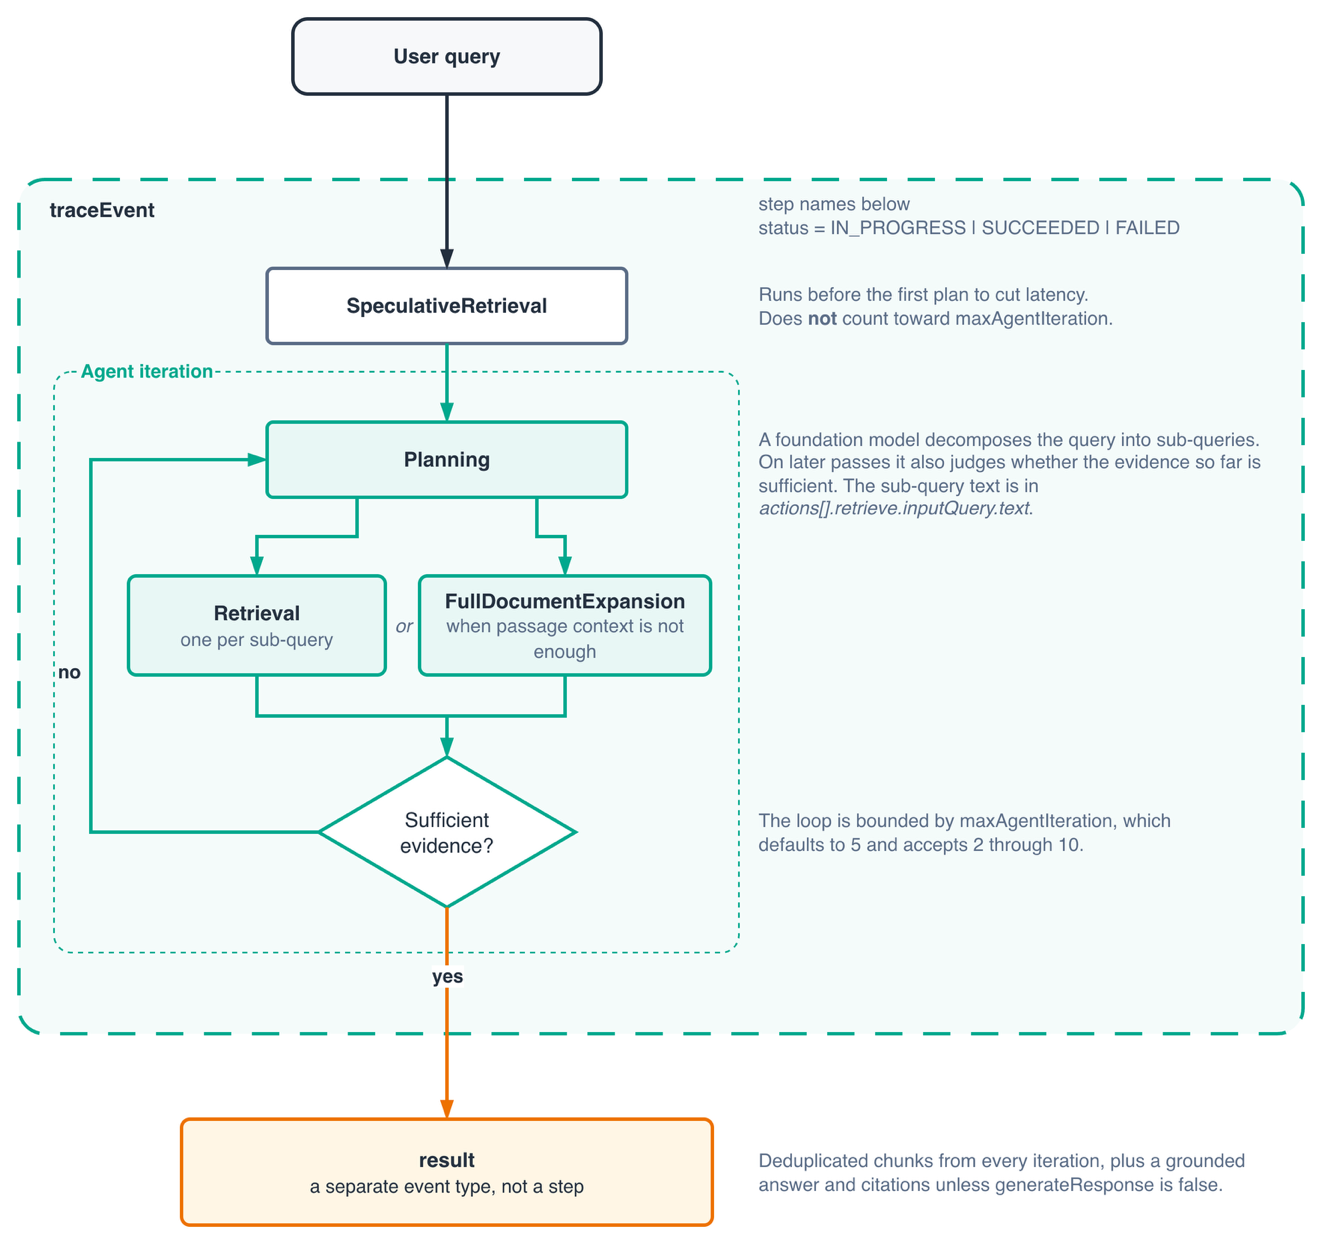
Figura 2: Pasos del bucle de planificación de recuperación agéntica
Hay dos detalles que vale la pena conocer antes de construir sobre esto. La desduplicación se aplica solo al evento result , por lo que un fragmento recuperado por tres subconsultas aparece una vez al final, pero tres veces en las trazas.
El segundo trata sobre las puntuaciones. Una respuesta de Retrieve proporciona a cada fragmento un campo tipado score que contiene su relevancia para la consulta. Los resultados de la recuperación agéntica llevan content, metadata, y sourceRetriever, sin un campo tipado equivalente. El código que lee result["score"] después de cambiar de API no obtiene nada. Si clasifica o filtra por relevancia, planifique teniendo en cuenta esa diferencia.
En producción, use Amazon Bedrock Guardrails para aplicar políticas de contenido y comprobaciones de grounding en las respuestas generadas. Ambas rutas de recuperación admiten guardrails. La recuperación agéntica admite guardrails a través de policyConfiguration.bedrockGuardrailConfiguration en lugar del argumento guardrail_config que toma el retriever de LangChain, y admite solo el modo BLOCK . Si depende del modo MASK , esa es una razón para permanecer en la API Retrieve.
maxAgentIteration acepta de dos a diez y tiene como valor predeterminado cinco. Déjelo en el valor predeterminado. Con dos o tres, el planificador ejecuta un ciclo, no emite subconsultas y devuelve lo que el paso de recuperación especulativa ya encontró. Es un comportamiento de un solo paso al precio agéntico. La descomposición comienza en cuatro. El planificador a menudo se detiene antes cuando considera que la evidencia es suficiente, por lo que el techo es un límite y no un objetivo.
Comparación de las dos rutas de recuperación
Para tener contexto sobre cómo se comporta a escala, AWS evaluó la recuperación agéntica en MuSiQue, un benchmark público multi-hop. La evaluación mostró una mejora en el recall frente a la recuperación de un solo paso, con las mayores ganancias en las preguntas más difíciles. Las preguntas de un solo salto vieron ganancias de menos de cinco puntos. Esa última cifra refleja la forma del compromiso: la descomposición ayuda cuando hay algo que descomponer.
Construcción de la cadena RAG
Para el retriever estándar, la composición habitual de LangChain Expression Language (LCEL) funciona directamente:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs importa más de lo que parece. Pasar Document objetos directamente a un prompt renderiza su repr, y el modelo recibe ruido de metadatos mezclado en el contexto.
Para poner la recuperación agéntica en la misma posición, envuélvela en un RunnableLambda, ya que es una función en lugar de un retriever:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
Ten en cuenta que generate_response está desactivado aquí. El servicio puede generar la respuesta por sí mismo, pero dentro de una cadena normalmente querrás tu propio prompt y modelo, así que tomas los fragmentos y generas aguas abajo. Usa la generación del servicio cuando quieras una sola llamada y menos código, y la versión envuelta cuando quieras controlar el prompt.
Elegir entre la recuperación estándar y la agéntica
Usa Retrieve para preguntas cortas y bien acotadas. Es más económico, más rápido, funciona contra bases de conocimiento autogestionadas y devuelve puntuaciones en los resultados. La mayor parte del tráfico de producción se ve así.
Usa AgenticRetrieveStream cuando las preguntas sean multiparte, comparativas o exploratorias, o cuando la evidencia abarque más de una base de conocimiento. Registra hasta cinco bases de conocimiento en una sola solicitud y enruta las subconsultas utilizando una descripción en lenguaje natural que adjuntas a cada una. La otra API no puede hacer esto en absoluto. Cuesta más por llamada, realiza varias invocaciones al modelo y tiene la latencia más alta de las dos.
Enrutar según la forma de la consulta en lugar de elegir una sola para todo es el patrón que recomendamos. Un clasificador o una heurística sobre la pregunta puede enviar la mayor parte del tráfico por la vía barata y reservar el planificador para las preguntas que lo necesitan.
Limpieza de recursos
Elimina la base de conocimiento, su fuente de datos, los objetos y el bucket de S3, y el rol de IAM que creaste. Una base de conocimiento con documentos sigue generando cargos por almacenamiento.
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
El repositorio incluye un script de limpieza que también vacía el bucket y elimina el rol.
Conclusión
Mostramos cómo construir una aplicación RAG en Amazon Bedrock Knowledge Bases con LangChain, y cómo la recuperación agéntica maneja las preguntas multiparte que la recuperación de una sola pasada responde mal. También mostramos las fricciones de la integración actual. La recuperación agéntica es una función en lugar de un retriever de LangChain, por lo que necesita un RunnableLambda para integrarse en una cadena. Los eventos de traza que muestran el plan de consulta requieren una llamada directa boto3 a.
La recuperación agéntica intercambia un mayor costo por llamada por una mejor recuperación en preguntas de varios saltos, utilizando un modelo integrado para la planificación de consultas. El siguiente paso útil es medir tu propia mezcla de consultas antes de enrutar todo a través de un planificador.
Para empezar, consulta la documentación de Amazon Bedrock Knowledge Bases y el código de ejemplo adjunto. Para obtener ayuda para aplicar esto a tu propia carga de trabajo, contacta a tu equipo de cuenta de AWS.