
La codificación y las cargas de trabajo agenticas exigen más de los modelos de IA que nunca: refactorizar un repositorio que abarca cientos de archivos, mantener un flujo de trabajo agentic de varias horas sin perder el contexto, y razonar sobre problemas complejos de sistemas utilizando herramientas en cada paso. Históricamente, satisfacer estas demandas con modelos de peso abierto significaba proporcionar y operar su propia infraestructura de inferencia.
GLM 5.3 de Z.ai (Zhipu AI) está ahora disponible en Amazon Bedrock. GLM 5.3, publicado en Hugging Face Hub, es un modelo de mezcla de expertos con 753B parámetros, optimizado para codificación y tareas agentic de larga visión. En particular, Z.ai ha informado que el modelo muestra notables capacidades de ciberseguridad. En Amazon Bedrock, ahora se puede utilizar a través de APIs totalmente gestionadas, con inferencia entre regiones, almacenamiento de prompts y niveles de servicio. No se necesita gestionar ninguna infraestructura. El acceso a GLM 5.3 en Bedrock está disponible para clientes empresariales elegibles.
En este artículo, le mostramos cómo ejecutar GLM 5.3 en Amazon Bedrock utilizando las API compatibles con OpenAI y reducir costos y latencia mediante el almacenamiento en caché de prompts. Luego, ponemos el modelo en funcionamiento en un flujo de trabajo agentic realista: realizamos una prueba de seguridad autorizada de su propia aplicación con Strix, un agente de pruebas de penetración de IA de código abierto.
¿Qué novedades hay en comparación con GLM 5?
GLM 5 llegó a Amazon Bedrock a principios de este año. GLM 5.3 se basa en la misma línea de desarrollo, con una serie de mejoras importantes:
- Programación más potente: Z.ai afirma un rendimiento competitivo en una serie de pruebas de programación, incluyendo DeepSWE, Terminal Bench 3.0 y FrontierSWE. También reportan una mejora del 50% sobre GLM 5.2 en su propia prueba de programación interna. No se reportaron comparaciones directas con GLM 5, ya que la magnitud de las mejoras obligó a actualizar los tests de prueba desde el anuncio de GLM 5.1.
- Capacidades emergentes de ciberseguridad: El rendimiento reportado en las tareas de seguridad destaca, lo que hace que el modelo sea una opción natural para los flujos de trabajo de seguridad defensiva. Por ejemplo, Z.ai medió un puntaje líder de 84.5 en el benchmark CyberGym al lanzar.
- Integración más amplia con Amazon Bedrock: Perfiles de inferencia entre regiones, caché implícito y explícito de prompts, y paridad mejorada de funciones en las API de Respuestas y Completaciones de Chat compatibles con OpenAI, junto con Invoke y Converse.
Capacidades clave
- Programación frontier y rendimiento agente. GLM 5.3 está diseñado para la ingeniería de sistemas complejos y tareas agentes de largo alcance. Estos incluyen el razonamiento multietapa, flujos de trabajo mejorados con herramientas y un contexto sostenido en grandes bases de código.
- Acceso flexible a la API. Puede invocar GLM 5.3 a través de las APIs de Respuestas y Completaciones de Chat compatibles con OpenAI, o las APIs Amazon Bedrock Invoke y Converse.
- Caché de prompts. GLM 5.3 soporta el caché implícito (automático) de prompts por defecto, así como controles de caché explícitos (recomendados) en las APIs Responses y Chat Completions. Para cargas de trabajo agenticas que reenvían grandes prompts del sistema o el contexto del repositorio en cada turno, el caché reduce tanto la latencia como el costo de entrada.
- Inferencia entre regiones. GLM 5.3 está disponible a través de perfiles de inferencia entre regiones en EE. UU. (
us.zai.glm-5.3) y globales (global.zai.glm-5.3). Envía solicitudes a la región de AWS “fuente” que elijas, y Amazon Bedrock redirige de forma segura cada solicitud para su procesamiento. Consulta el Guía de usuario de Amazon Bedrock para más detalles. - Niveles de servicio. Elige Flex para optimizar los costos en cargas de trabajo que no requieren una respuesta rápida, Prioridad para priorizar las solicitudes críticas en cuanto a latencia a cambio de un precio más alto, o Estándar para un equilibrio predeterminado entre precio y velocidad.
Requisitos previos
Para los siguientes ejemplos de uso, necesita:
- Un cuenta de AWS con acceso a Amazon Bedrock.
- AWS Identity and Access Management (IAM) permisos para llamar al modelo base y al perfil de inferencia objetivo:
bedrock:InvokeModel,bedrock:InvokeModelWithResponseStreamybedrock:CallWithBearerToken. - (Para las demostraciones basadas en código) Python 3.10 o posterior.
- (Solo para la demostración de prueba de seguridad opcional) instale Docker y Strix con el complemento bedrock.
Prueba GLM 5.3 en la consola Amazon Bedrock
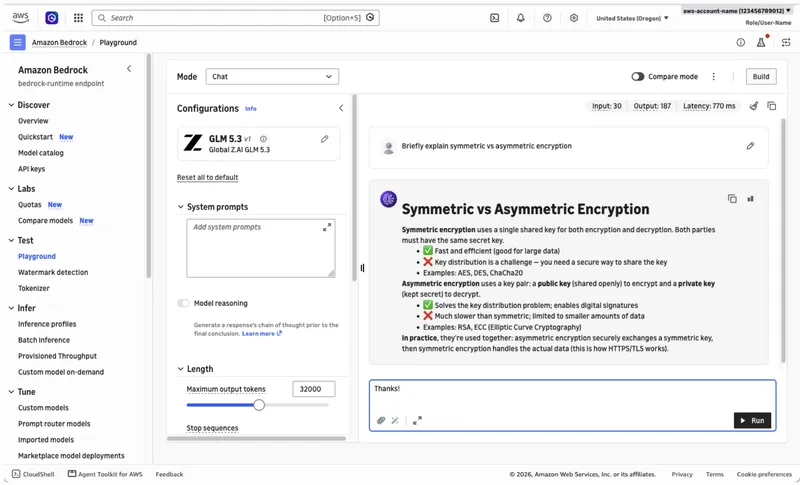
Puede comenzar a enviar prompts a GLM 5.3 en la Consola de Administración de AWS, sin necesidad de escribir código ni instalar herramientas de desarrollador. Para comenzar, navegue a Amazon Bedrock y luego elija Test > Playground en el menú lateral izquierdo.
Desde esta interfaz de juegos, puede seleccionar GLM 5.3 de la lista de modelos y enviar sus primeros prompts a través de la interfaz de chat, como se muestra en la siguiente captura de pantalla:
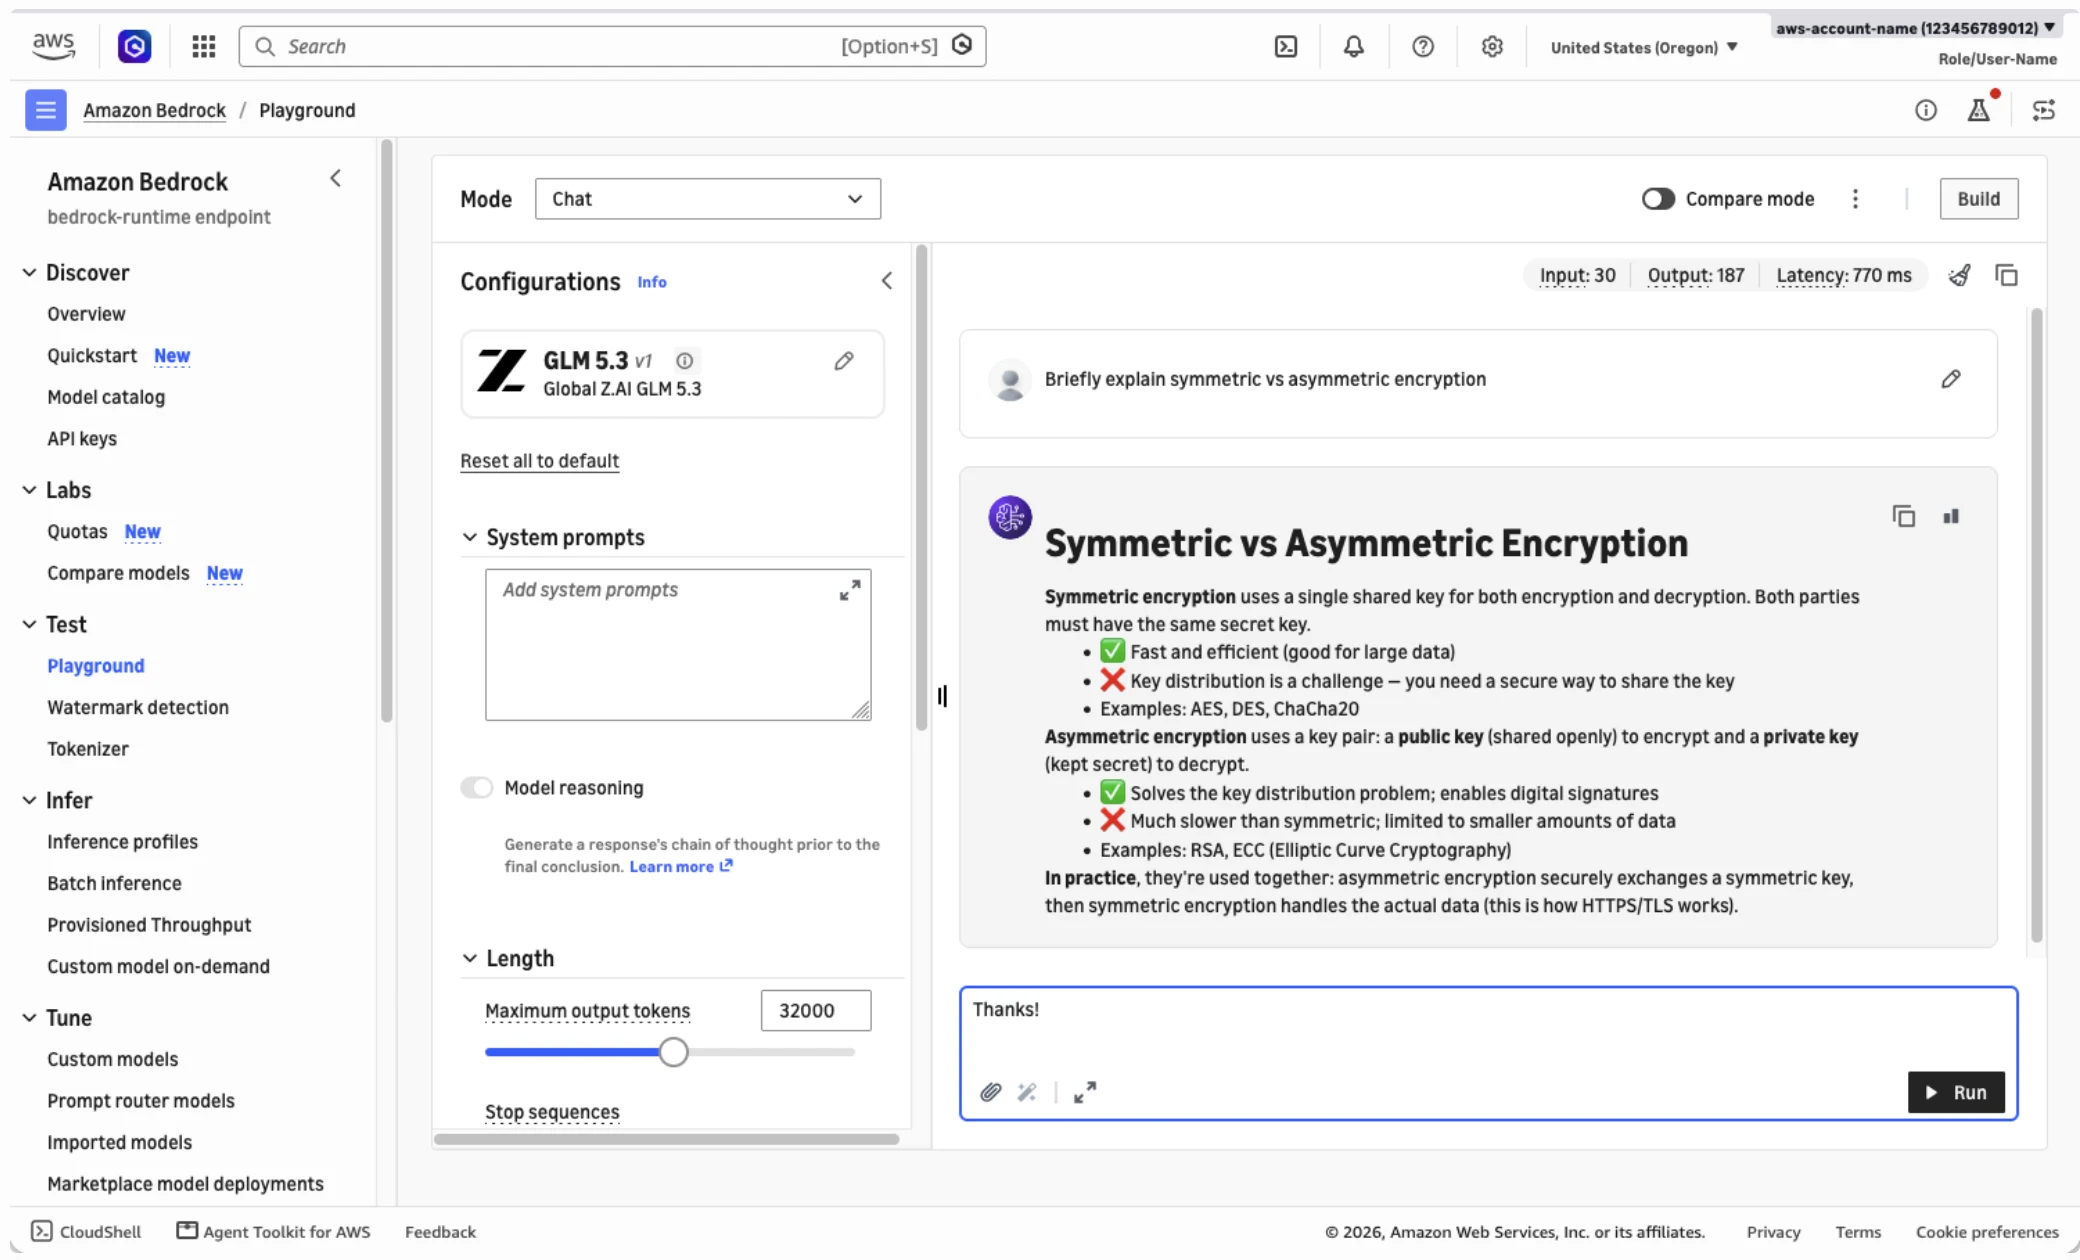
Figura 1: Charla con GLM 5.3 en la consola Amazon Bedrock
Comience con la API de Respuestas
De forma programática, se puede llamar al modelo a través del punto de acceso bedrock-runtime. Esto soporta tanto las Respuestas y Completaciones de Chat compatibles con OpenAI, como las APIs Amazon Bedrock Invoke y Converse para GLM 5.3. Para nuevas aplicaciones, se recomienda utilizar las APIs compatibles con OpenAI, ya que ofrecen un conjunto más completo de funciones.
Amazon Bedrock soporta la generación de claves de API para integraciones compatibles con OpenAI que las requieran. Sin embargo, recomendamos encarecidamente preferir credenciales de corto tiempo de vida en lugar de claves de API de larga duración cuando sea posible.
En el ejemplo siguiente, llamaremos a la API de Responses desde Python utilizando el SDK de Python de OpenAI, y la biblioteca aws-bedrock-token-generator para generar tokens a corto plazo a partir de sus credenciales estándar de AWS Command Line Interface (AWS CLI).
- Instalar los paquetes necesarios.
pip install -U openai aws-bedrock-token-generator - Guarde el siguiente código como
bedrock-request.py.from aws_bedrock_token_generator import provide_token from openai import OpenAI region = "us-west-2" # Your source AWS Region client = OpenAI( api_key=provide_token(region=region), base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1", ) resp = client.responses.create( input="Refactor this Python function to be iterative instead of recursive: ...", model="global.zai.glm-5.3", ) print(resp.output_text) - Ejecuta el script, que mostrará el resultado del modelo.
python bedrock-request.py
Optimizar la inferencia con el almacenamiento explícito del prompt
Los flujos de trabajo de codificación y conocimiento de larga duración a menudo reenvían el contexto estable a través de múltiples turnos de conversación, como los prompts del sistema, las definiciones de herramientas o los archivos del repositorio.
GLM 5.3 en Amazon Bedrock soporta el caché implícito de prompts por defecto, lo que ayuda a reducir la latencia de respuesta y los costos de tokens de entrada para llamadas repetidas que comparten el mismo prefijo de prompt inicial.
Con el modo caché explícito de prompts, se identifican específicamente los prefijos de prompts reutilizables, lo que puede mejorar aún más la tasa de hit en el caché (y, por consiguiente, la latencia y el ahorro de costos) en comparación con el caché implícito.
Para utilizar el caché de prompts explícitos con GLM 5.3, como se muestra en el siguiente ejemplo:
- Seleccione el modo de caché explícito a través de
prompt_cache_optionsen su solicitud. - Agregar uno o más marcadores
prompt_cache_breakpointen los bloques de contenido de entrada para indicar el final (incluido) de los prefijos de prompts reutilizables. Cada punto de interrupción debe contener al menos 1,024 tokens para ser elegible para el caché.
resp = client.responses.create(
    model="global.zai.glm-5.3",
    # Enable explicit caching mode:
    extra_body={"prompt_cache_options": {"mode": "explicit"}},
    input=[
        {
            "type": "message",
            "role": "system",
            "content": [
                {
                    "type": "input_text",
                    "text": SYSTEM_PROMPT,
                    # A long, static system prompt is a great target for caching:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ]
        },
        {
            "type": "message",
            "role": "user",
            "content": [
                {
                    "type": "input_text",
                    "text": USER_INPUT,
                    # Multiple breakpoints can also be defined, for layered cache:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ],
        },
    ],
)

if resp.usage.input_tokens_details.cached_tokens:
    print("Hit cache!")
Para obtener más información, consulte la sección caché de prompts de la Guía de Usuario de Amazon Bedrock.
Ejemplo de carga de trabajo agentica: Pruebas de seguridad autorizadas con Strix
Una carga de trabajo que se beneficia directamente de las ventajas de GLM 5.3 es la prueba de seguridad automatizada de sus propias aplicaciones. Strix es un agente de prueba de penetración de IA de código abierto que ejecuta su código de manera dinámica, encuentra vulnerabilidades y las valida con pruebas de concepto. A partir de esta redacción, la documentación de Strix utiliza GLM 5.3 como su modelo por defecto. Puede configurar a Strix para que use GLM 5.3 en Amazon Bedrock en lugar de un proveedor de inferencia de terceros, de modo que la inferencia del modelo se ejecuta bajo los controles de su cuenta de AWS.
Solo pruebe aplicaciones que usted posee o que tiene permiso escrito explícito para probar. La prueba de seguridad no autorizada de sistemas que no es suyos es ilegal en la mayoría de las jurisdicciones y viola la Política de Uso Aceptable de AWS. En esta guía, el objetivo es OWASP Juice Shop, una aplicación de muestra deliberadamente vulnerable que se ejecuta localmente en su máquina.
Si desea pruebas de seguridad continuas y totalmente gestionadas, además de ejecutar los agentes de código abierto por sí mismo, AWS Continuum ofrece pruebas de penetración bajo demanda y otras análisis de seguridad como un servicio gestionado. Estos dos enfoques son complementarios: los agentes de código abierto como Strix le proporcionan pruebas impulsadas por desarrolladores, en tiempo real y profundamente personalizables contra compilaciones locales, mientras que AWS Continuum ejecuta evaluaciones gestionadas a gran escala.
Para ejecutar una prueba de seguridad autorizada
- Inicie localmente la aplicación objetivo de la tienda de jugos de ejemplo.
docker run --rm -p 3000:3000 bkimminich/juice-shop - Configurar Strix para usar GLM 5.3 en Amazon Bedrock. Strix utiliza LiteLLM bajo la superficie, por lo que (según se describe en su documentación para Amazon Bedrock) sus credenciales de AWS CLI se obtendrán automáticamente. Esto significa que no es necesario utilizar una clave de API, pero puede ser útil establecer variables de entorno como
AWS_PROFILEyAWS_REGIONpara configurar su conexión. En el momento de la redacción de este texto, LiteLLM aún no resuelvebedrock/global.zai.glm-5.3. Hasta que esto se corrija, puede especificar explícitamente la ruta de la API de Converse y el nombre de recurso de Amazon (ARN) del perfil de inferencia, como se muestra en el siguiente fragmento:# Fill in the REGION and ACCOUNT_ID placeholders below before running! export STRIX_LLM="bedrock/converse/arn:aws:bedrock:{AWS_REGION}:{AWS_ACCOUNT_ID}:inference-profile/global.zai.glm-5.3" - Ejecuta Strix contra el objetivo local.
strix --target http://localhost:3000 - Espere a que el agente raíz de Strix se complete, luego revise los hallazgos.
Strix crea un equipo de sub-agentes para mapear la superficie de amenazas, explorar una variedad de categorías de vulnerabilidades potenciales y intentar validar cada hallazgo con un prototipo funcional. Esto ayuda a reducir el tiempo invertido en la clasificación de falsos positivos. Una ejecución exitosa generará un informe que incluye la severidad, las pruebas y las recomendaciones de corrección para cada hallazgo.
El siguiente video muestra el proceso completo de configurar y ejecutar Strix frente a la aplicación de ejemplo, así como explorar los resultados:
Figura 2: Ejecutar un ejemplo de prueba de seguridad con GLM 5.3 y Strix
Limpiar
Detener el contenedor de la Tienda de Jugo Ctrl+C en el terminal donde se está ejecutando, o ejecutar docker ps Para encontrar el ID del contenedor y detenerlo docker stop <container-id>. La inferencia de Amazon Bedrock es de pago por token y no incluye recursos persistentes, por lo que no habrá cargos adicionales después de que se completen los pedidos. Si generó una clave de API de Amazon Bedrock para este tutorial y ya no la necesita, elimínela en la consola de Amazon Bedrock.
Disponibilidad
Pruebe GLM 5.3 en la consola Amazon Bedrock, utilícelo a través de asistentes de programación como OpenCode, como se muestra en nuestro artículo reciente con Kimi K3, o conecte sus aplicaciones personalizadas a través de las API soportadas.
¿Está interesado en cómo Amazon Bedrock puede apoyar a su equipo? Conéctese con nosotros para comenzar la conversación.