
Amazon SageMaker HyperPod brinda a los equipos de machine learning (ML) acceso a grandes grupos de cómputo acelerado para entrenar y ajustar modelos. Cuando varios equipos comparten un clúster, la configuración técnica suele ser sencilla. La parte desafiante es la gobernanza. Debe decidir qué equipos pueden usar el clúster, cuánta capacidad recibe cada equipo, qué sucede cuando la carga de trabajo de un equipo compite con la de otro y quién rinde cuentas cuando el uso se desvía de la política. Amazon SageMaker Unified Studio agrega otra consideración: puede conectar un clúster de SageMaker HyperPod a un proyecto para que los miembros del equipo puedan lanzar cargas de trabajo desde su espacio de trabajo del proyecto. Esa comodidad es valiosa, pero después de que varios equipos comparten visibilidad del mismo clúster, los controles que gobiernan quién puede hacer qué se vuelven aún más importantes. En esta publicación, mostramos cómo administrar SageMaker HyperPod a través de SageMaker Unified Studio mientras se preservan los controles de gobernanza subyacentes. Cubrimos las cuatro capas de control: organización, proyecto, clúster y carga de trabajo. También explicamos cómo diseñar políticas de identidad, capacidad y observabilidad a través de ellas. Al final, tendrá un modelo repetible para ofrecer cómputo de SageMaker HyperPod aprobado a los equipos de ML en el contexto de su proyecto, manteniendo las operaciones del clúster con el equipo de infraestructura.
Amazon SageMaker HyperPod es una capacidad de Amazon SageMaker AI. Amazon SageMaker Unified Studio es el entorno de desarrollo de datos e IA donde los equipos construyen con sus datos y herramientas. Con SageMaker Unified Studio, puede conectar un proyecto a un clúster existente de SageMaker HyperPod. Los miembros pueden entonces lanzar cargas de trabajo de machine learning, revisar información del clúster y de las tareas, y abrir un flujo de trabajo de JupyterLab. Usted continúa gestionando los clústeres a través de las interfaces y API de Amazon SageMaker AI.
Esta separación brinda a los equipos de infraestructura un modelo operativo útil. Puede gestionar la infraestructura del clúster a través de procesos establecidos de operaciones en la nube. Al mismo tiempo, puede presentar cómputo aprobado a los equipos de machine learning en el contexto de su proyecto. En esta publicación, describimos cómo puede diseñar límites de infraestructura, gobernar el acceso, asignar capacidad compartida y operar SageMaker HyperPod de manera consistente a través de SageMaker Unified Studio.
Comprenda los límites administrativos
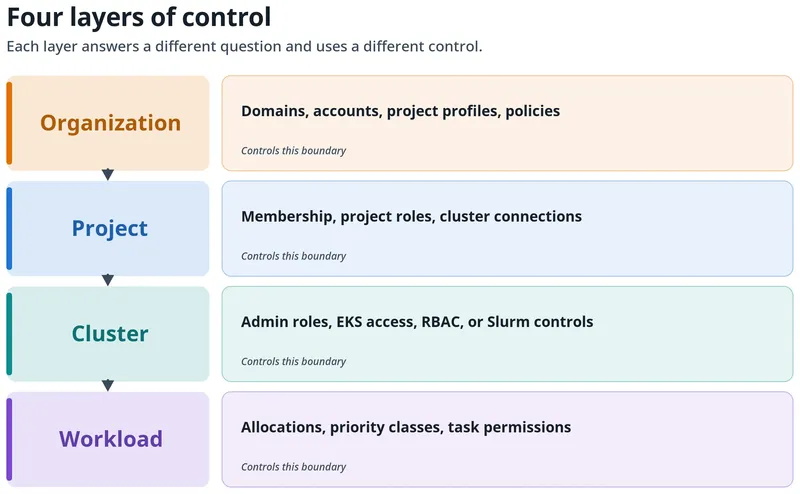
Un entorno bien gobernado separa la administración organizacional, el acceso al proyecto y las operaciones del clúster. Cada capa responde a una pregunta diferente y utiliza un control diferente. La siguiente tabla resume cada límite, sus controles principales y su propósito administrativo.
| Límite | Controles principales | Propósito administrativo |
| Organización | Dominios de SageMaker Unified Studio, unidades de dominio, cuentas asociadas, perfiles de proyecto y políticas de autorización | Determina quién puede crear proyectos, qué cuentas y Regiones pueden usar los proyectos y qué herramientas están disponibles |
| Proyecto | Membresía del proyecto, roles del proyecto y conexiones de SageMaker HyperPod | Define el contexto de colaboración y los recursos de AWS a los que los miembros del proyecto pueden acceder |
| Clúster | Roles de administrador del clúster de SageMaker HyperPod, entradas de acceso de Amazon EKS, control de acceso basado en roles (RBAC) y EKS Pod Identity, o controles de Slurm | Gobierna la configuración del clúster, el acceso al planificador, los espacios de nombres, las tareas y las operaciones de infraestructura |
| Carga de trabajo | Asignaciones de cómputo, clases de prioridad, políticas de préstamo y endeudamiento, y permisos de tareas | Controla quién puede enviar trabajo y cómo se asigna la capacidad compartida |
Trate estos controles como capas. Una conexión de SageMaker HyperPod agrega un clúster aprobado a un proyecto. No reemplaza los controles de AWS Identity and Access Management (IAM), Amazon Elastic Kubernetes Service (Amazon EKS) o Slurm del clúster. Revise el rol del proyecto, el rol de acceso de la conexión, las entradas de acceso de EKS y los controles de RBAC o Slurm, la identidad de la carga de trabajo, los datos y las políticas de clave de AWS Key Management Service (AWS KMS) , la política de red, las restricciones de vista de tareas y la política del planificador en conjunto. Haga disponible el clúster solo después de que esos controles estén alineados.
Estos controles forman cuatro capas, como se muestra en la siguiente figura.
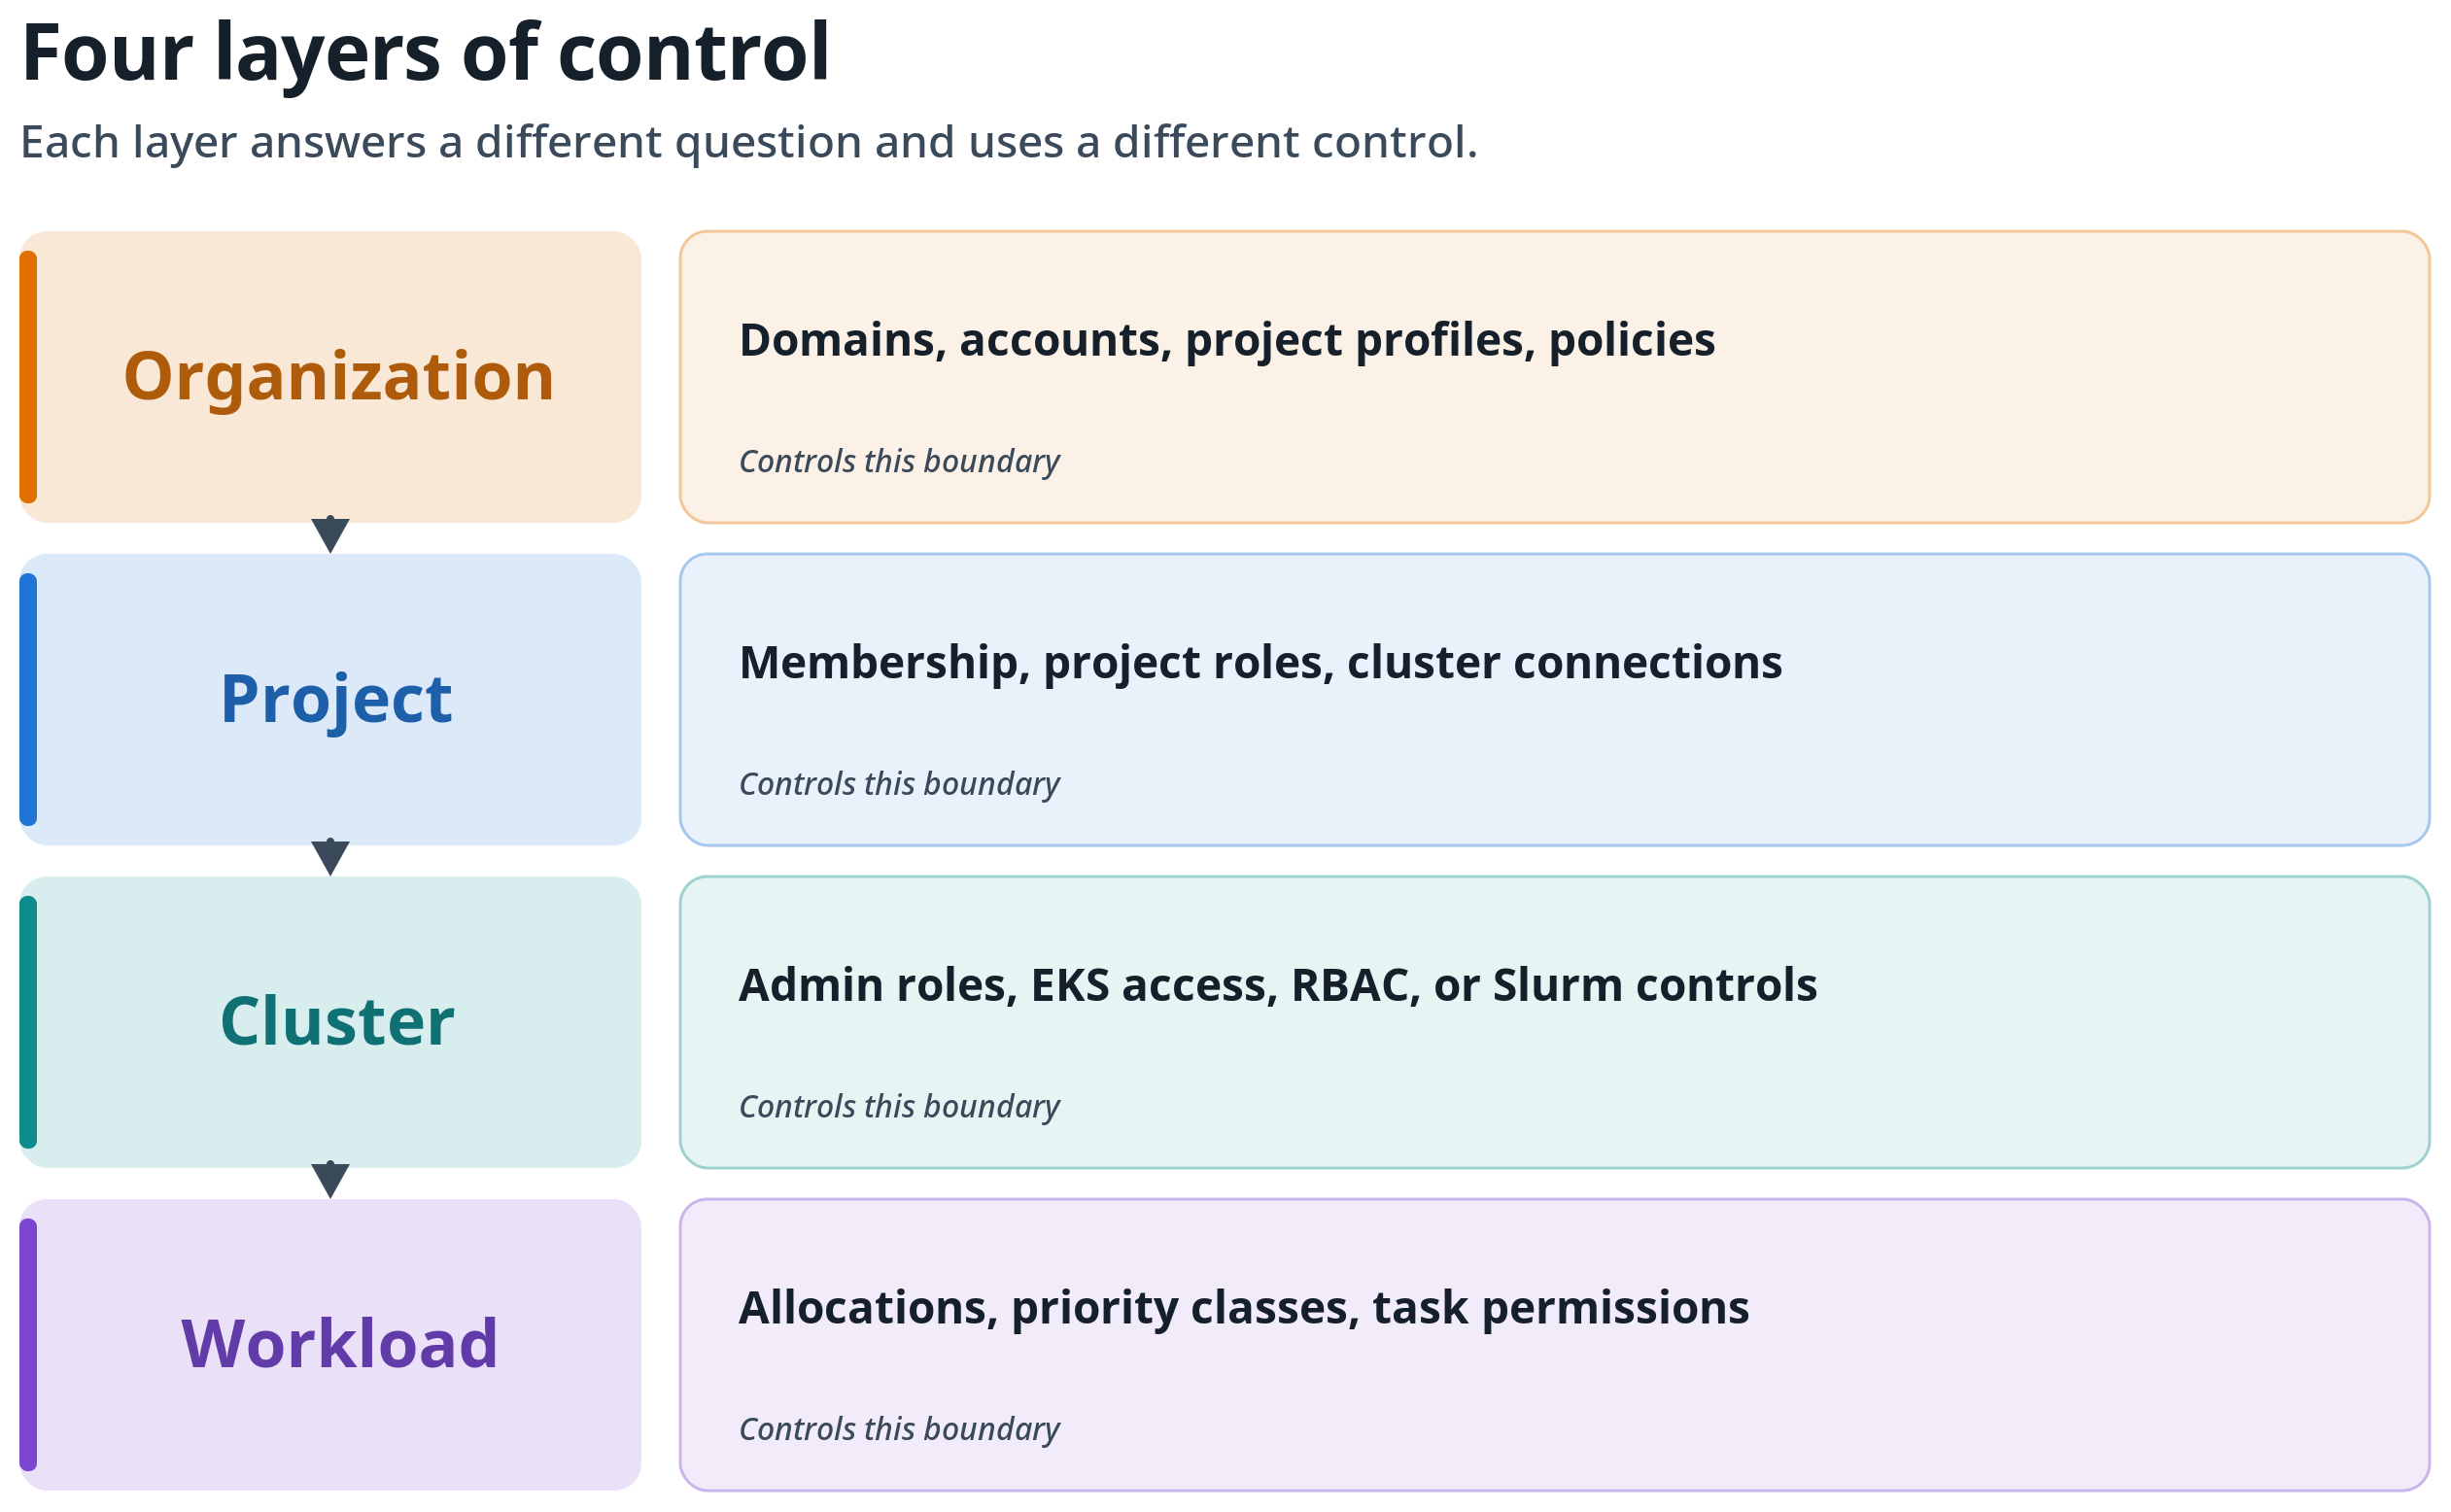
Figura 1: Los cuatro niveles de control: organización, proyecto, clúster y carga de trabajo. Cada nivel responde a una pregunta diferente y utiliza un control diferente, por lo que debe revisarse cada uno en su propio límite.
Los proyectos de SageMaker Unified Studio son límites de colaboración. No son límites fuertes de seguridad en tiempo de ejecución. Mantenga el clúster de SageMaker HyperPod, el planificador y la escasa capacidad de aceleradores bajo una cuenta de capacidad designada. Los usuarios y conjuntos de datos aprobados pueden permanecer en la misma cuenta o en cuentas de consumidor y de datos separadas. AWS documenta la compatibilidad multi-cuenta para la gobernanza de tareas de SageMaker HyperPod en clústeres de Amazon EKS. Aunque las reservas de capacidad On-Demand pueden compartirse entre cuentas, centralice la propiedad del clúster de SageMaker HyperPod y la administración de la capacidad en la cuenta de capacidad. Use el acceso multi-cuenta aprobado en lugar de convertir cada cuenta de consumidor en un administrador de capacidad independiente.
- Para Amazon EKS, utilice un namespace por inquilino junto con RBAC, cuentas de servicio por inquilino y roles de EKS Pod Identity, políticas de red default-deny, y permisos de almacenamiento y de AWS KMS específicos por inquilino. Para Slurm, utilice Slurm accounting con cuentas y asociaciones jerárquicas, calidad de servicio (QoS), políticas de prioridad y fair-share, y particiones. Utilice también identidad y permisos de archivos del sistema operativo, controles de red y rutas de datos específicas por inquilino.
- Utilice roles de IAM y políticas de recursos, en lugar de solo la membresía del proyecto, para controlar el acceso a los buckets de Amazon Simple Storage Service (Amazon S3), las claves de AWS KMS, los secretos, los registros de contenedores y otros servicios de datos. Utilice políticas de proyecto y de unidad de dominio para la colaboración y la delegación.
- Para los clústeres de Amazon EKS, utilice SageMaker HyperPod task governance, incluidas cuotas, clases de prioridad, lending and borrowing y preemption, para compartir de manera justa el grupo central de aceleradores. Para los clústeres de Slurm, utilice controles nativos de particiones, calidad de servicio (QoS), prioridad, fair-share y preemption. Slurm no proporciona el mismo modelo de lending and borrowing. Estos controles de programación determinan cuándo una carga de trabajo autorizada recibe cómputo. No otorgan acceso a namespaces ni a datos.
Para lograr un aislamiento más fuerte dentro de un clúster, utilice nodos dedicados o grupos de nodos y controles de admisión cuando sea apropiado. Utilice un clúster o cuenta separados cuando los requisitos legales, reglamentarios o de seguridad exijan un aislamiento estricto de la infraestructura. El acceso de consumidores entre cuentas puede preservar la propiedad a nivel de cuenta sin duplicar el clúster central de SageMaker HyperPod. Dentro de la cuenta de capacidad, use perfiles de proyecto y unidades de dominio con políticas de autorización de proyecto para delegar la creación y la propiedad de proyectos.
La siguiente figura muestra una capacidad centralizada con controles de carga de trabajo, identidad, datos, red y visibilidad específicos por inquilino.
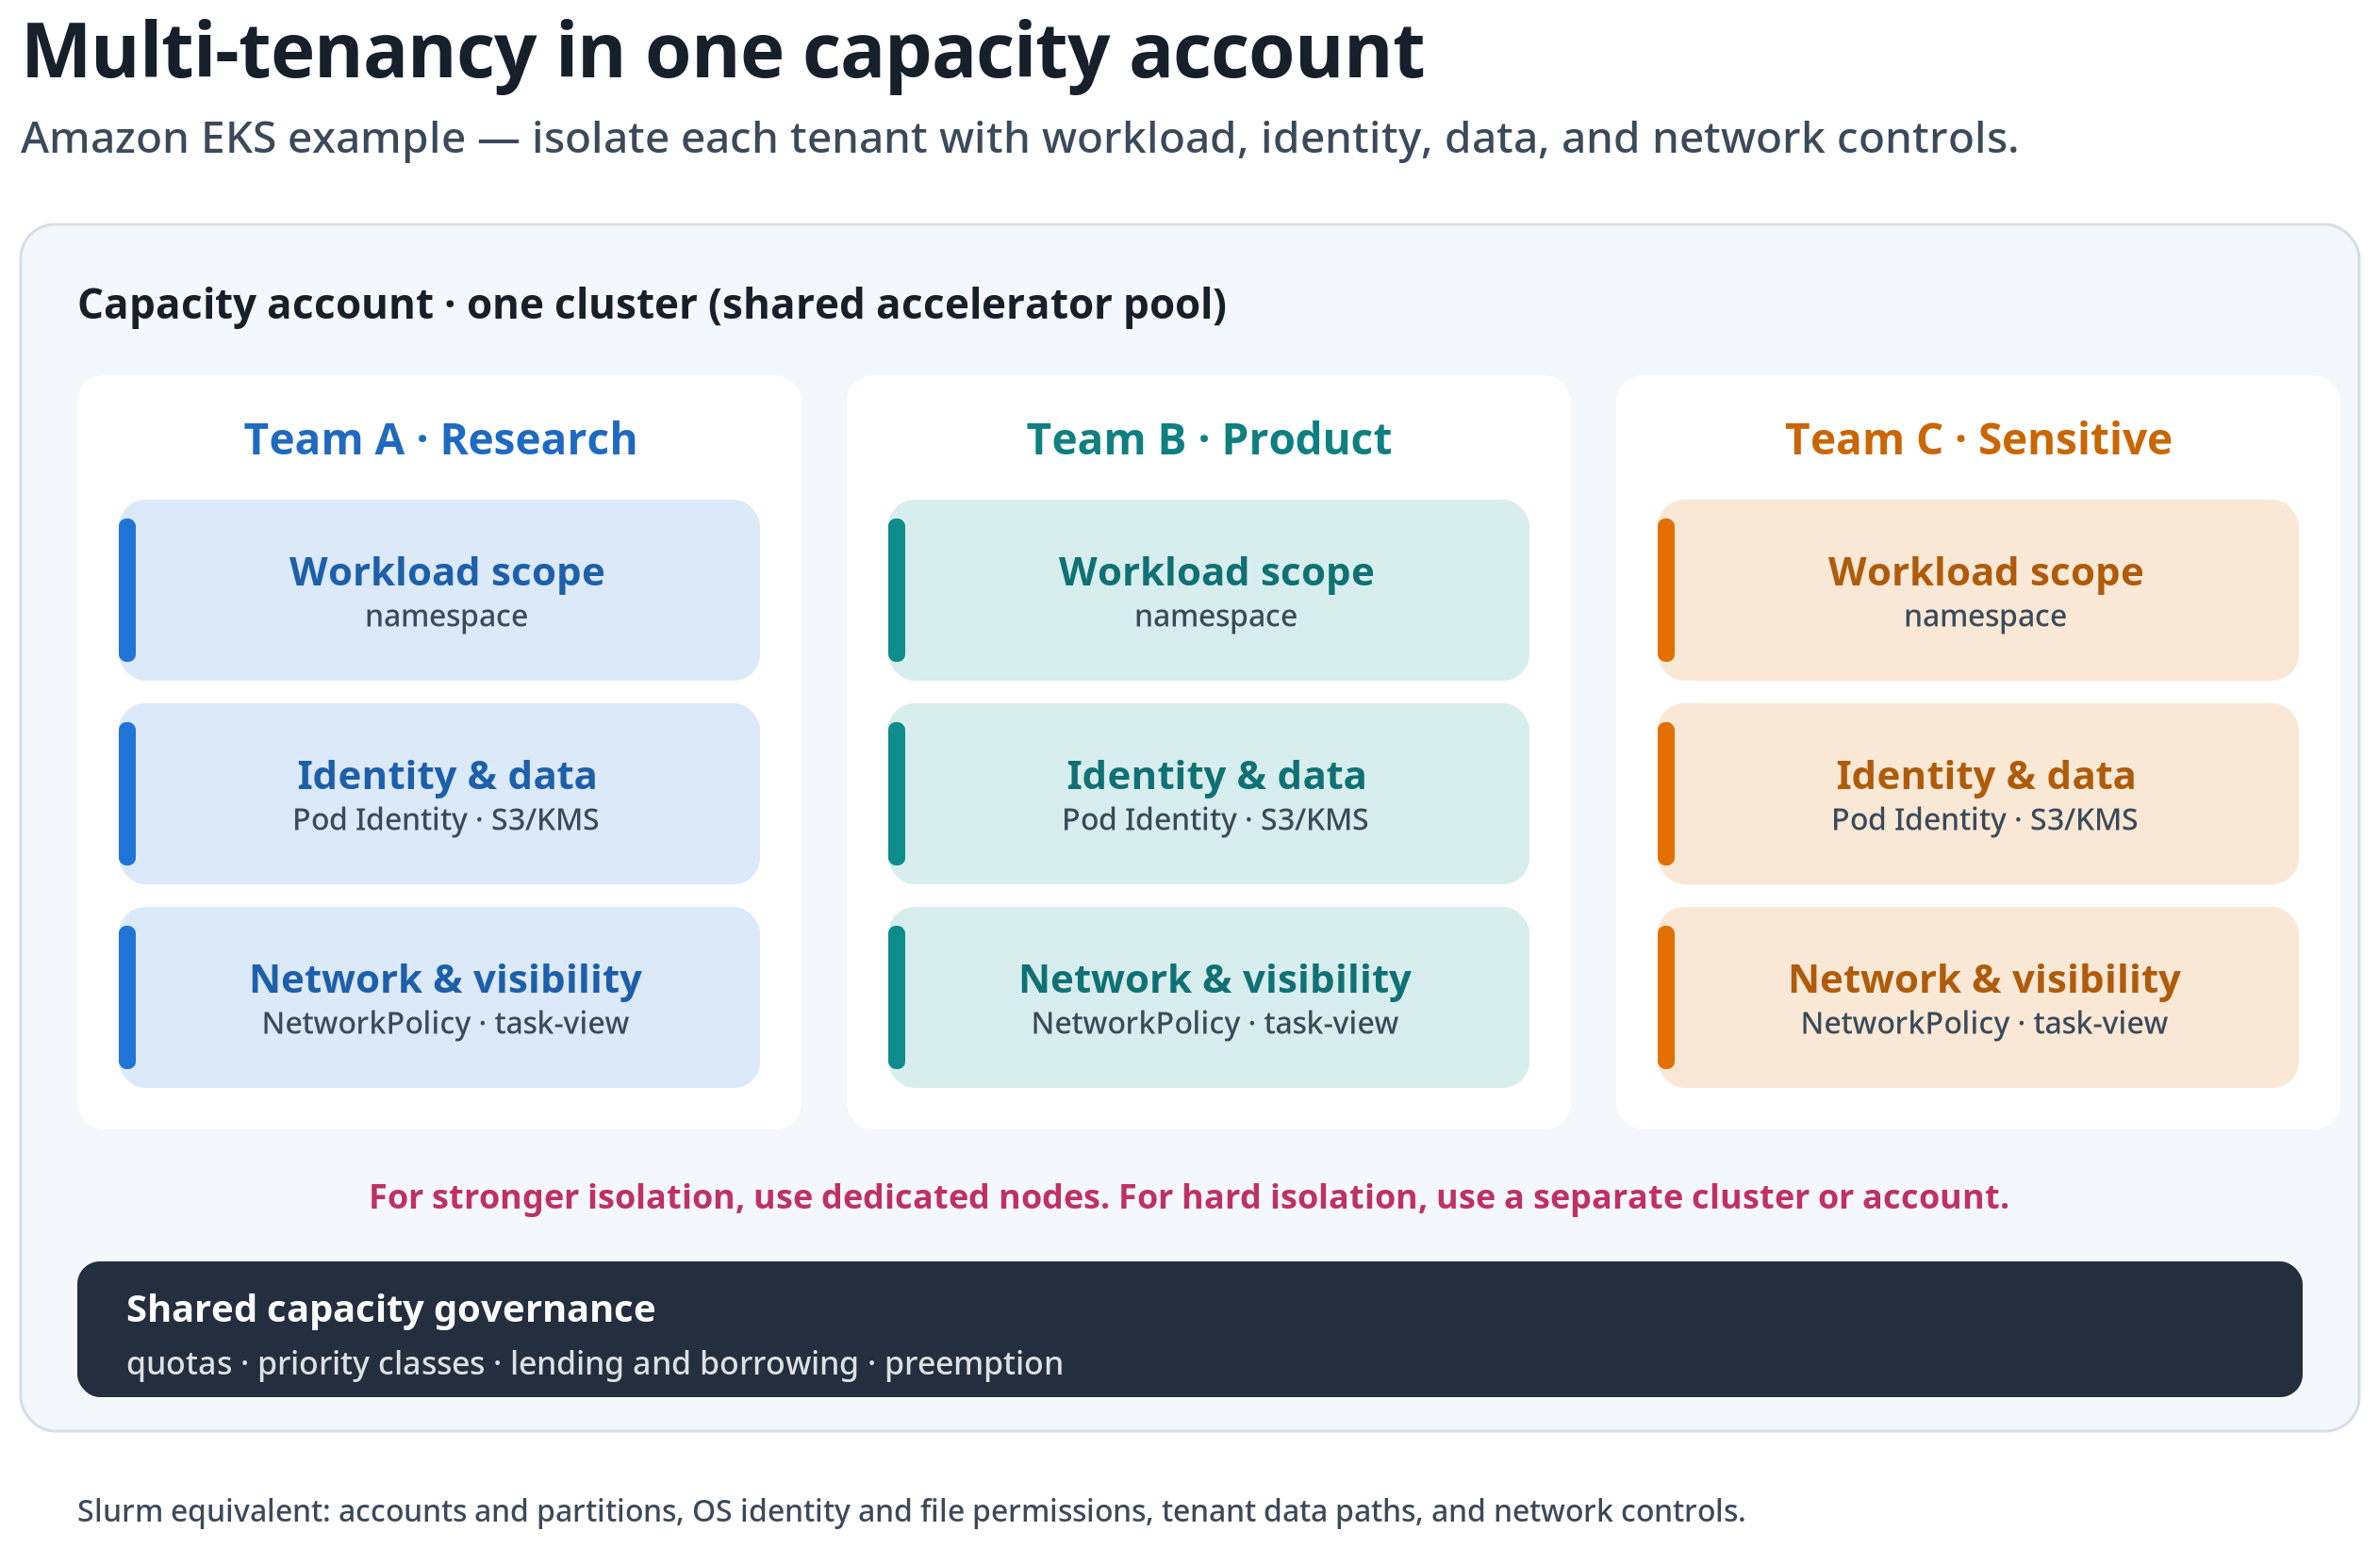
Figura 2: Capacidad centralizada de SageMaker HyperPod. El clúster y el programador permanecen en una sola cuenta de capacidad. Cada inquilino recibe controles de carga de trabajo, identidad, datos, red y visibilidad de tareas. Los requisitos de aislamiento estricto utilizan infraestructura dedicada.
La Figura 3 muestra cómo se conectan esos límites cuando SageMaker Unified Studio expone el cómputo aprobado de SageMaker HyperPod a los miembros del proyecto.
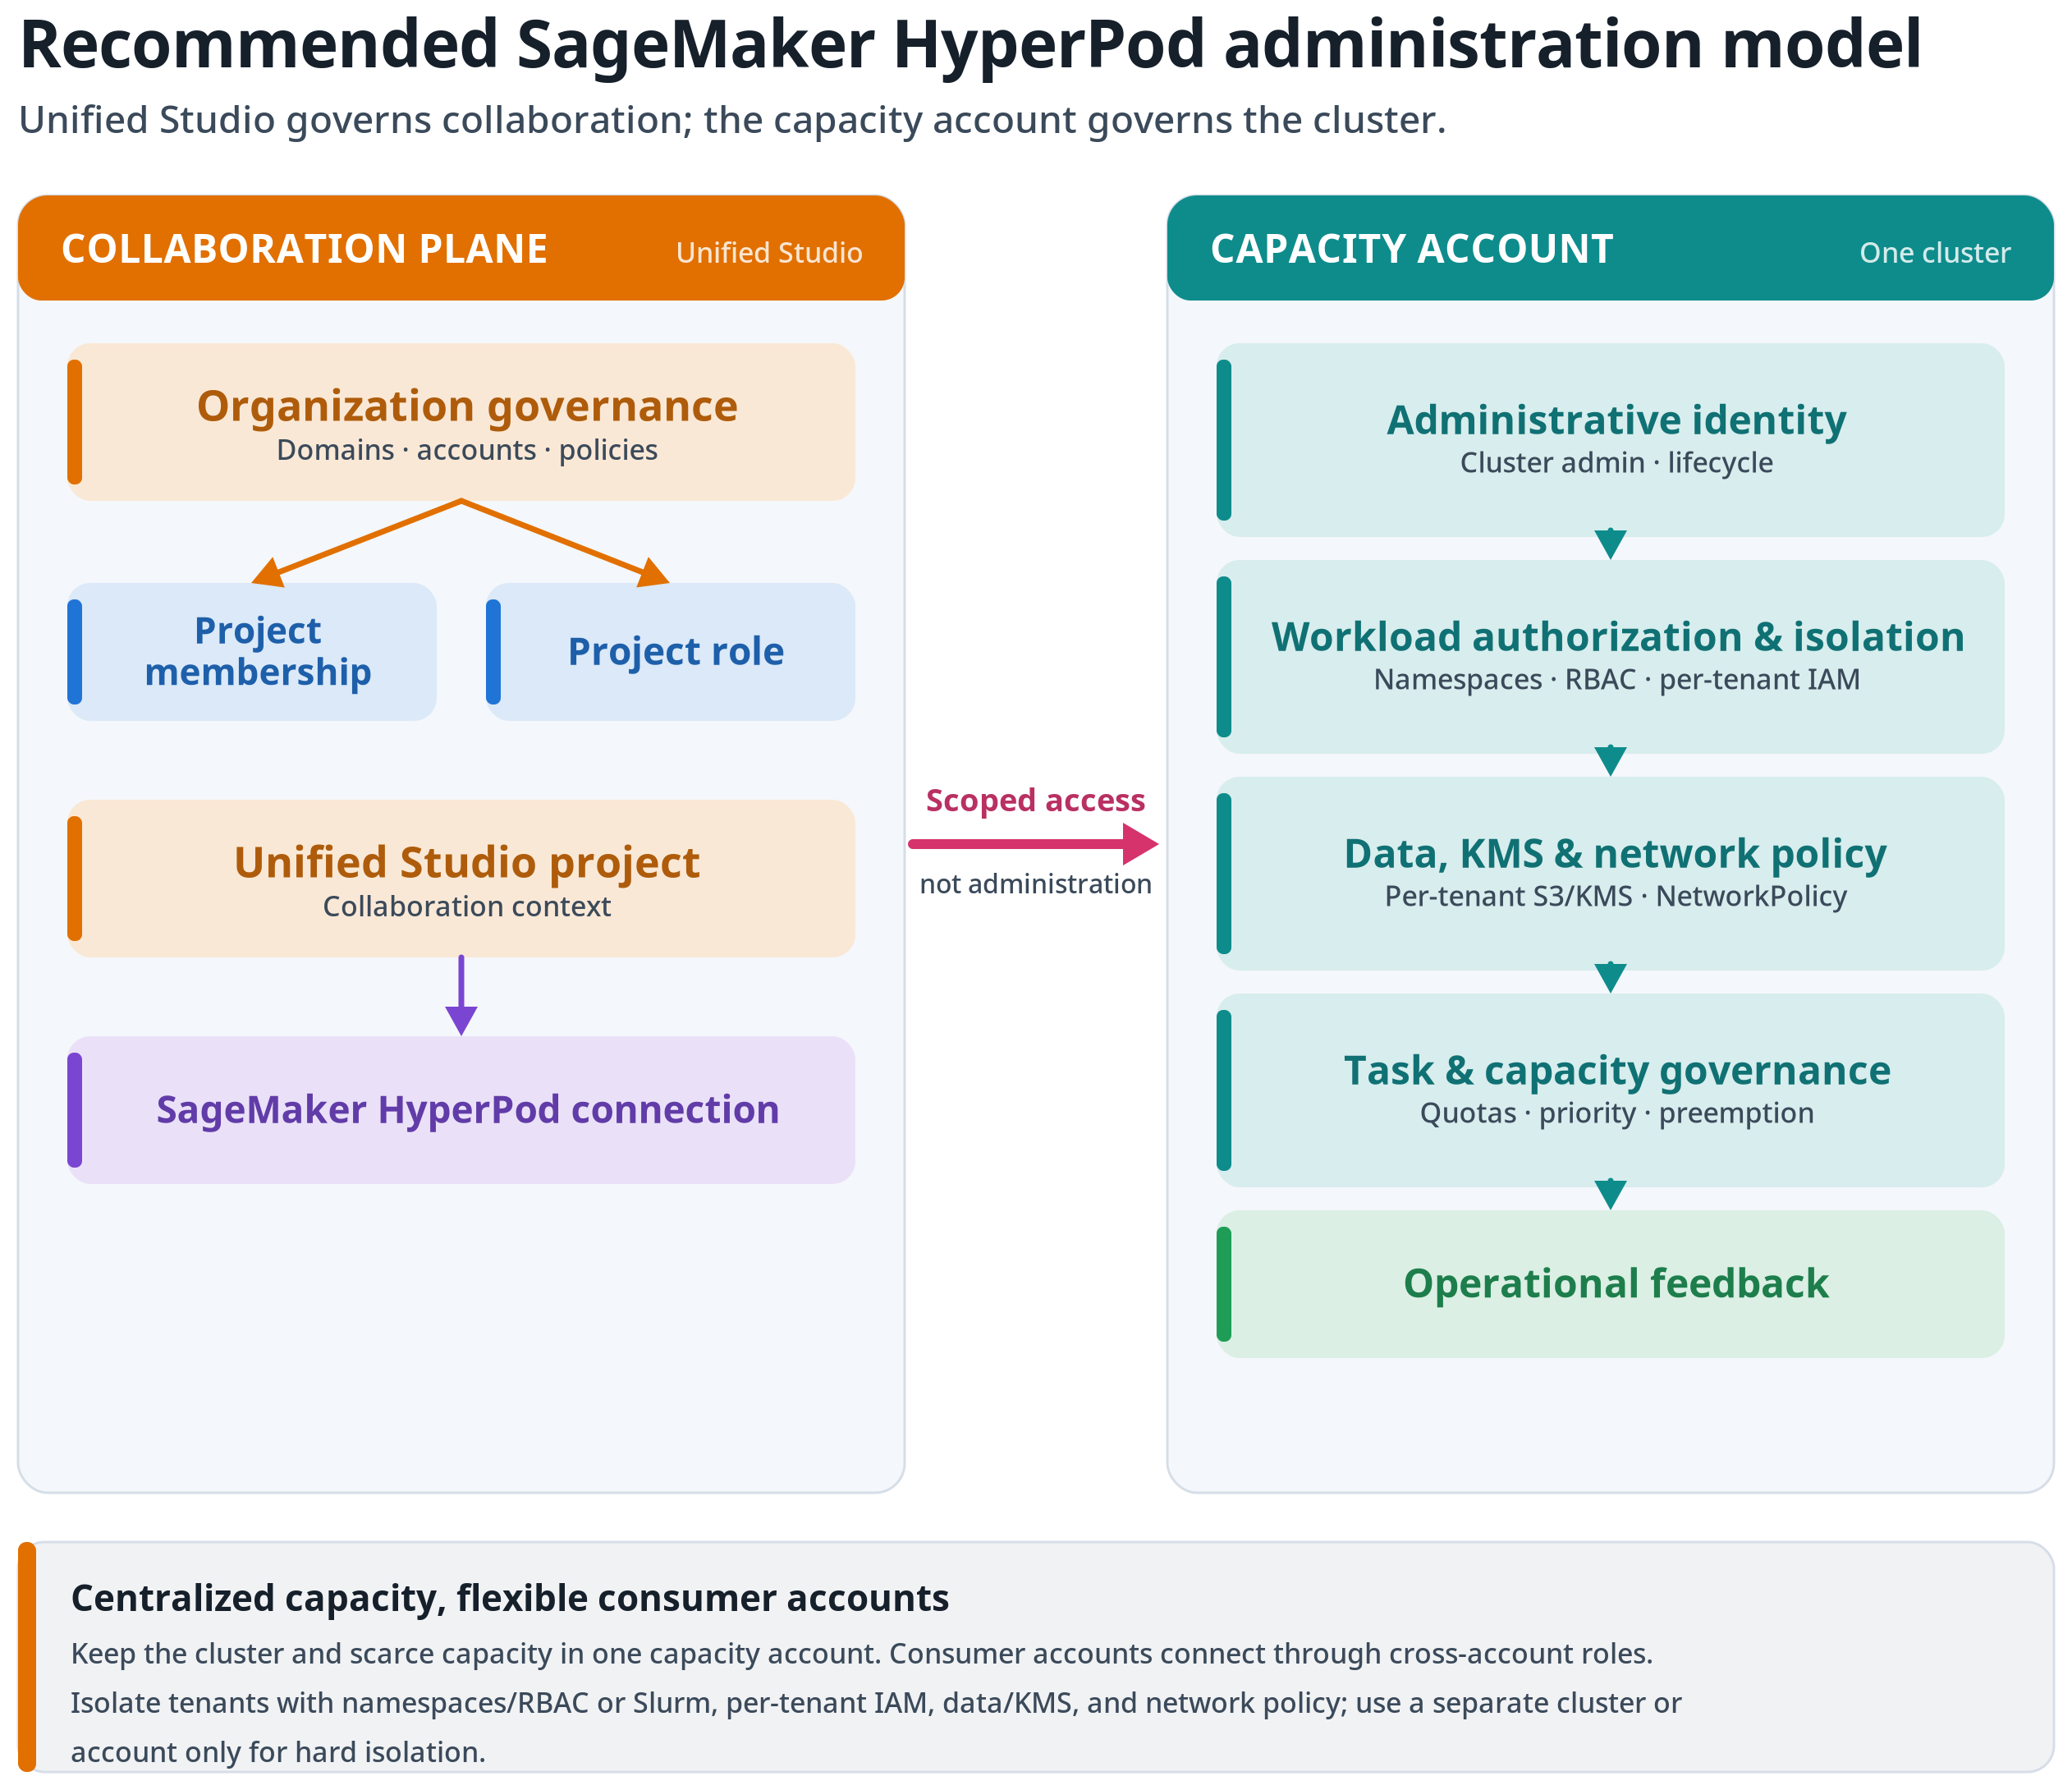
Figura 3: Modelo de administración recomendado de SageMaker HyperPod. SageMaker Unified Studio gobierna el contexto de colaboración, mientras que la identidad del clúster, la autorización de cargas de trabajo, la política del programador y los controles operativos permanecen separados.
Decida cuándo SageMaker Unified Studio es la experiencia administrativa adecuada
Con SageMaker Unified Studio, los equipos de aprendizaje automático que ya trabajan en un proyecto pueden seguir una ruta aprobada hacia el cómputo compartido de SageMaker HyperPod. Los miembros pueden encontrar clústeres conectados, revisar el estado y los metadatos, inspeccionar las tareas y métricas compatibles, y pasar a JupyterLab sin usar un inventario de infraestructura separado.
Esta experiencia no reemplaza la administración del clúster. La siguiente tabla muestra cómo cada perfil debe usar SageMaker Unified Studio junto con las interfaces específicas del servicio.
| Perfil | Usar SageMaker Unified Studio para | Seguir usando herramientas específicas del servicio para |
| Administrador de dominio o de infraestructura | Unidades de dominio, política de creación de proyectos, perfiles de proyecto, política de membresía y ubicación de cuentas | Controles a nivel de organización, aprovisionamiento de cuentas y automatización de infraestructura |
| Administrador del clúster de SageMaker HyperPod | Presentar conexiones de clúster aprobadas y revisar las vistas de clúster, tareas, configuración y metadatos | Creación de clústeres, actualizaciones, configuración de resiliencia, complementos, administración de EKS o Slurm y respuesta a incidentes |
| Propietario del proyecto | Administrar la membresía del proyecto y brindar a los usuarios un contexto de proyecto consistente para el cómputo aprobado | Solicitar cambios de infraestructura y aprobar requisitos de acceso específicos del negocio |
| Ingeniero de ML o científico de datos | Encontrar cómputo aprobado, revisar el estado de las cargas de trabajo y abrir el flujo de trabajo de JupyterLab | Enviar y administrar cargas de trabajo detalladas mediante SageMaker HyperPod CLI, kubectl, o herramientas de Slurm según corresponda |
Use SageMaker Unified Studio cuando la membresía del proyecto, el acceso a los datos, las herramientas de desarrollo y la computación necesiten un contexto común. Para cambios en el clúster y automatización repetible, siga usando las APIs de SageMaker AI, la infraestructura como código y las herramientas de orquestación. Para implementaciones de referencia e integraciones, consulte el AI on SageMaker HyperPod site.
Tome decisiones de infraestructura antes de conectar un clúster
Antes de aprobar una conexión, documente la cuenta de capacidad, cualquier cuenta de consumidor o de datos, la región de AWS, las rutas de red, las identidades, los propietarios, los límites de las cargas de trabajo y los requisitos de aislamiento. Si necesita orientación para crear un clúster, consulte la documentación de Amazon SageMaker HyperPod o el AI on SageMaker HyperPod site.
Separe las identidades administrativas de las identidades de carga de trabajo. Conserve la distinción de SageMaker HyperPod entre administradores de clúster y usuarios científicos de datos al crear roles de proyecto y roles de acceso. Un rol orientado a un proyecto no debería recibir permisos de ciclo de vida del clúster solo porque sus usuarios ejecuten cargas de trabajo. Consulte AWS Identity and Access Management for SageMaker HyperPod para conocer el modelo de permisos admitido.
Trate las redes como un control de extremo a extremo. Restrinja el acceso al endpoint de la API de Kubernetes de Amazon EKS a rutas de red administrativas aprobadas, controle la entrada y salida de los pods, y verifique que el proyecto, el rol de conexión, el rol de carga de trabajo y la red del clúster admitan únicamente las rutas de datos previstas. Para la configuración específica del orquestador, consulte Orchestrating SageMaker HyperPod clusters with Amazon EKS.
Por ejemplo, configure el acceso privado al endpoint de la API de Amazon EKS y permítalo solo desde subredes de administradores o de cargas de trabajo aprobadas. Aplique una política de denegación predeterminada de Kubernetes NetworkPolicy y permita explícitamente las rutas requeridas de servicio a servicio y de salida. Use endpoints de nube virtual privada (VPC) para servicios como Amazon S3, Amazon Elastic Container Registry (Amazon ECR) y Amazon CloudWatch cuando sea apropiado, y asigne a cada arrendatario un rol de carga de trabajo dedicado para el acceso a los datos.
Cree un contrato de conexión. Un contrato de conexión es un registro de gobernanza administrado por el cliente, como una página wiki, un ticket, un registro de catálogo de servicios o un archivo rastreado en un repositorio de infraestructura como código. No es una característica de la plataforma. Registre la siguiente información para cada conexión aprobada entre proyecto y clúster:
- Propietario del negocio, propietario de operaciones y propietario de costos.
- Unidad de dominio y proyecto de SageMaker Unified Studio.
- Cuenta del clúster, Región, nombre y orquestador.
- Rol del proyecto y el Nombre de Recurso de Amazon (ARN) del rol de acceso utilizado por la conexión.
- Tipos de carga de trabajo aprobados y clasificación de datos.
- Espacios de nombres de EKS o alcance de acceso de Slurm.
- Política de programación y propietario de excepciones.
- Expectativas de monitoreo, soporte y retirada.
Este contrato proporciona a los revisores un único registro para evaluar y aprobar la ruta de acceso completa.
Gobierne la identidad y la visibilidad de las tareas
Controle tanto las acciones como la visibilidad. Una configuración incorrecta de los nombres de tareas, espacios de nombres, solicitudes de recursos y patrones de uso puede revelar información sobre el trabajo de otro equipo.
Use grupos en lugar de concesiones individuales para la membresía de proyectos y el acceso al clúster siempre que sea posible. Revise cada rol en su propio límite en lugar de crear un rol amplio que abarque el dominio, el proyecto, el clúster y la política de cargas de trabajo.
El siguiente flujo de trabajo muestra cómo separar lo que un usuario puede ver de lo que un usuario puede hacer.
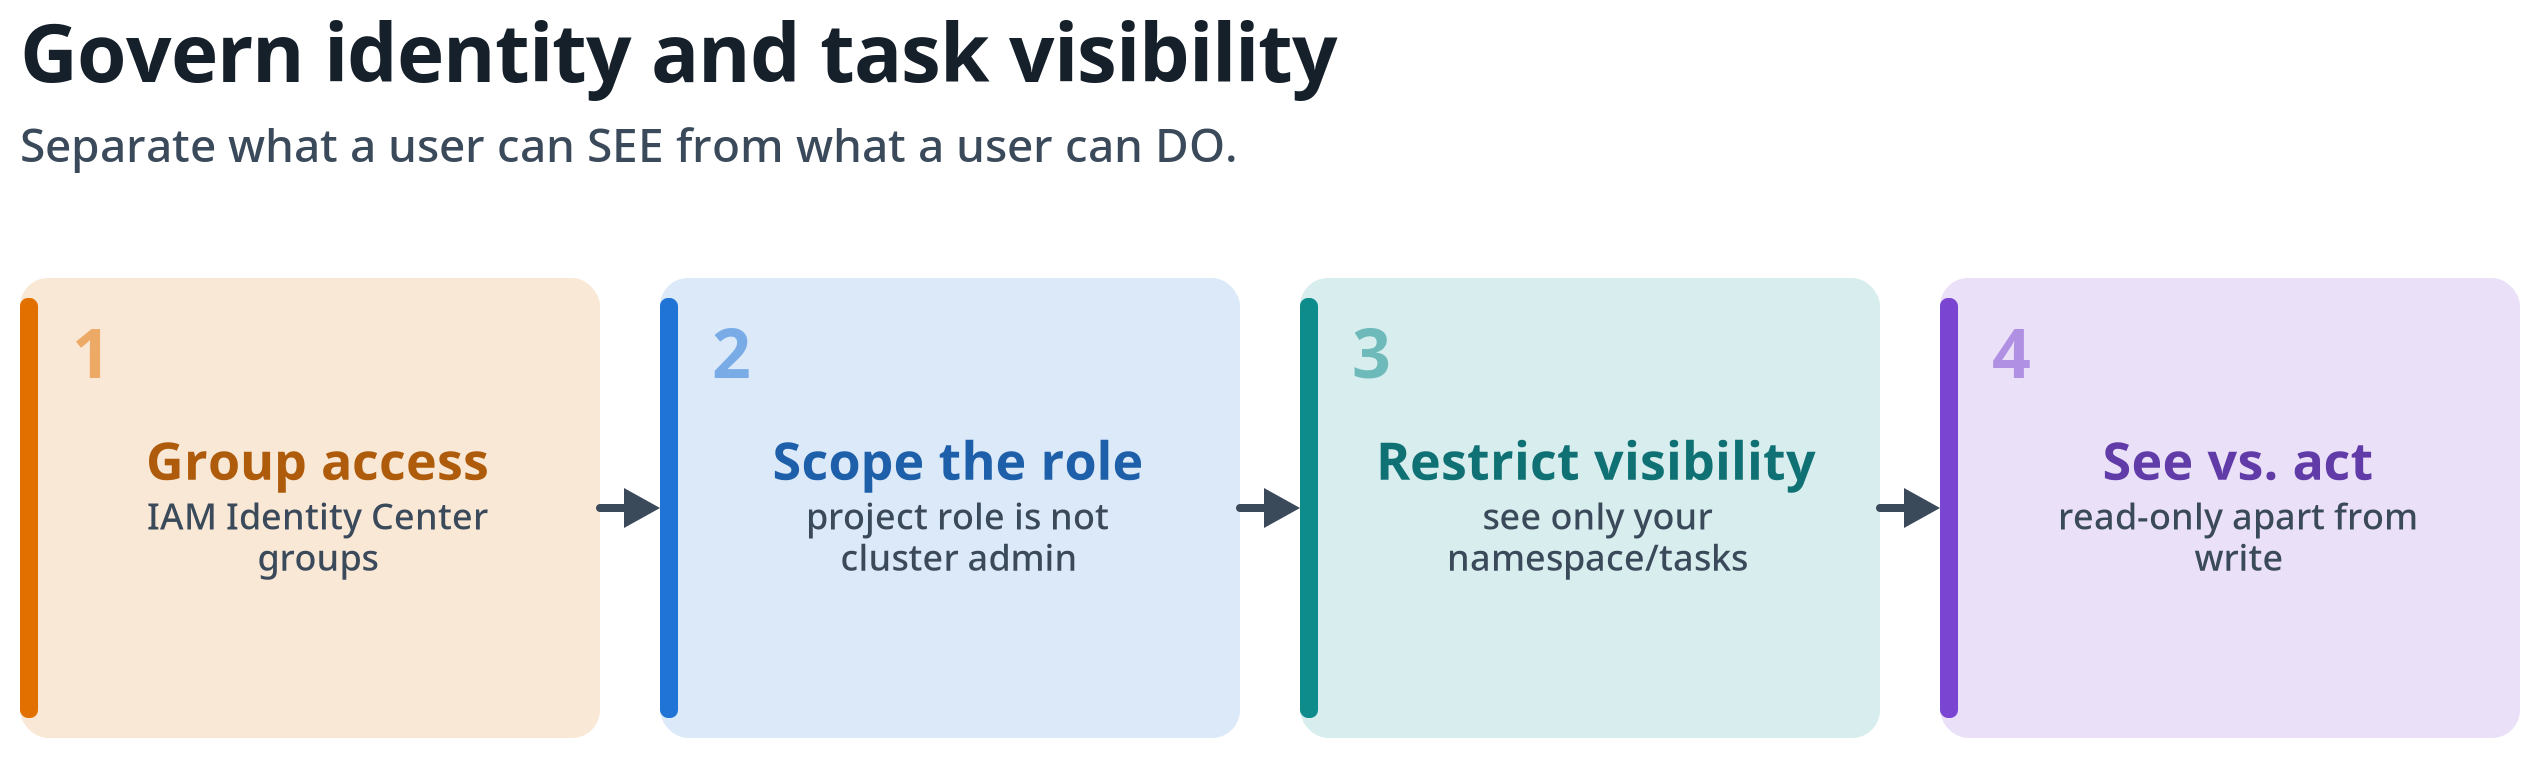
Figura 4: Gobernanza de identidad y visibilidad de tareas. Asigne el acceso mediante grupos, delimite cada rol a su propio límite, restrinja la visibilidad de las tareas y separe la capacidad de ver el trabajo de la capacidad de actuar sobre él.
Revise la visibilidad predeterminada de las tareas antes de incorporar usuarios. La documentación para SageMaker HyperPod en SageMaker AI Studio explica que los usuarios de SageMaker AI Studio pueden ver todas las tareas del clúster de Amazon EKS de forma predeterminada. En el caso de los clústeres de Slurm, cada usuario de SageMaker AI Studio puede ver, administrar e interactuar con las tareas disponibles. Configure las restricciones de visualización de tareas antes de incorporar varios equipos: consulte Restrict task view in Studio for EKS clusters para Amazon EKS y Restrict task view in Studio for Slurm clusters para Slurm. La membresía en un proyecto no es un límite de seguridad a nivel de clúster.
Para los clústeres de Amazon EKS, asigne cada equipo a un espacio de nombres aprobado y permisos RBAC, y asigne cada cuenta de servicio de carga de trabajo a un rol de IAM específico del arrendatario. Para el acceso a datos entre cuentas, asocie la cuenta de servicio con un rol de EKS Pod Identity en la cuenta de capacidad (clúster) y establezca un rol de IAM de destino en la asociación (targetRoleArn). EKS Pod Identity realiza entonces la asunción del rol entre cuentas automáticamente, de modo que el código de la aplicación no necesita llamar a AssumeRole. El rol de destino se encuentra en la cuenta de consumidor o de datos. Mantenga la visibilidad de solo lectura separada de los permisos para crear, actualizar o eliminar cargas de trabajo. Para los clústeres de Slurm, defina controles equivalentes de usuario, cuenta, partición, sistema de archivos y visibilidad de tareas.
Por ejemplo, la siguiente Role de RBAC de Kubernetes otorga a un equipo acceso de solo lectura a los jobs únicamente en su propio namespace. Se requiere un role separado para crear o eliminar workloads, lo que mantiene "ver" separado de "actuar".
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: team-research
  name: research-job-viewer
rules:
  - apiGroups: ["batch"]
    resources: ["jobs"]
    verbs: ["get", "list", "watch"]
  - apiGroups: ["kubeflow.org"]
    resources: ["pytorchjobs"]
    verbs: ["get", "list", "watch"]
Traducir las prioridades de negocio en una política de programación
En el caso de los clústeres de Amazon EKS, aplique la task governance solo después de que los controles de acceso de identidad y de workload estén establecidos.
La siguiente figura separa las dos decisiones que esto implica.
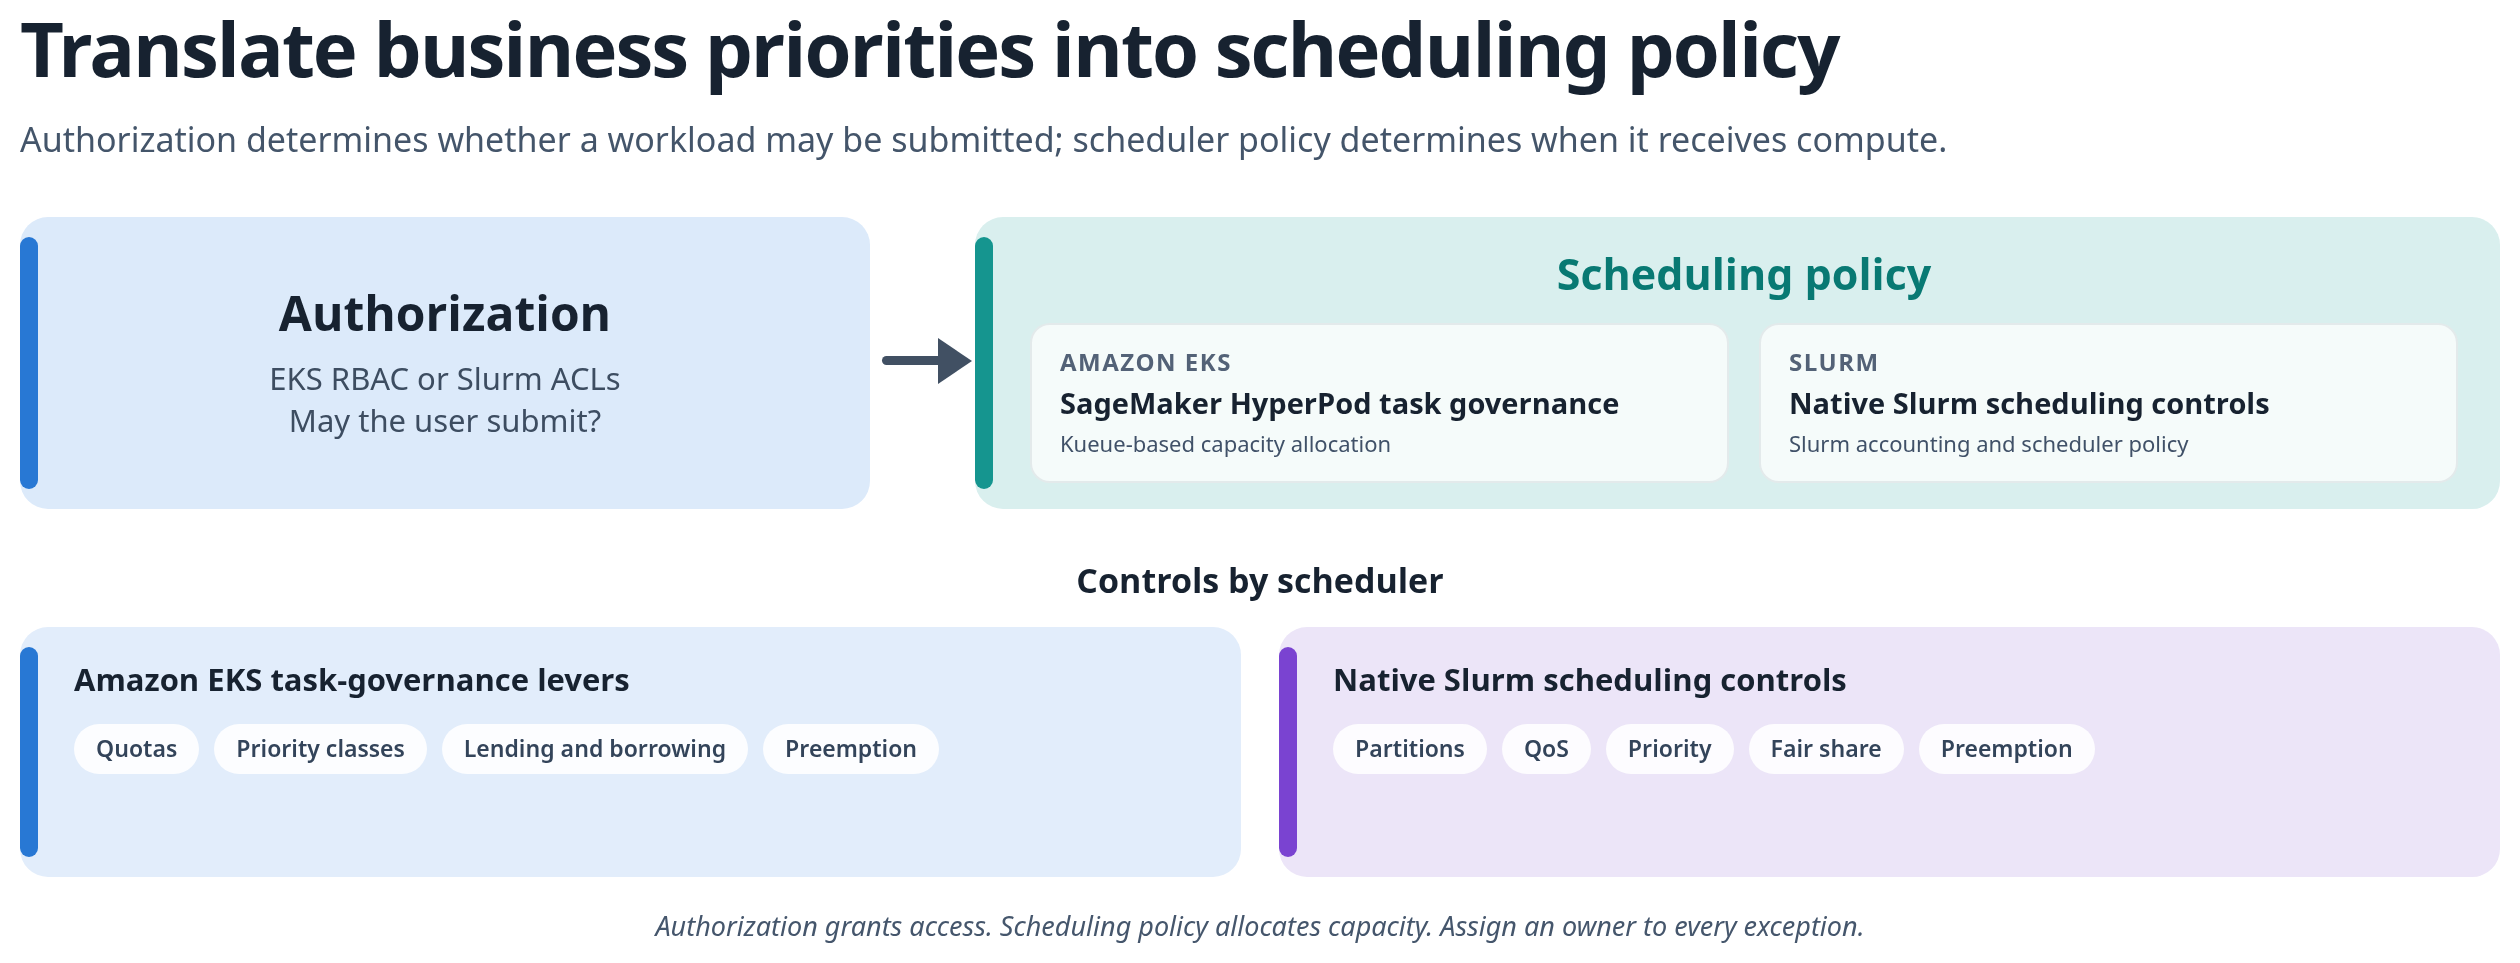
Figura 5: Mantener separadas la autorización y la política de programación. Los RBAC de EKS o las ACL de Slurm determinan si un usuario puede enviar un workload. La task governance de SageMaker HyperPod para Amazon EKS o los controles nativos de programación de Slurm determinan cuándo recibe cómputo.
Documente la capacidad garantizada y compartida, las clases de prioridad y si un equipo puede usar la capacidad inactiva asignada a otro equipo. Asigne un responsable a cada excepción. La gobernanza de tareas también se aplica a SageMaker HyperPod spaces (entornos autónomos de JupyterLab o Code Editor que se ejecutan directamente en el clúster), por lo que debe incluir estas cargas de trabajo de desarrollo interactivo en la política de asignación.
Por ejemplo, en un clúster de Amazon EKS, podría otorgar al equipo de entrenamiento de producción una asignación garantizada del 60 por ciento con una clase de prioridad alta, permitir que el equipo de investigación tome prestada capacidad inactiva con una prioridad menor y permitir la preferencia de esa capacidad prestada cuando el equipo de producción envíe trabajo. Asigne un único responsable para aprobar cualquier excepción a esta política, de modo que las solicitudes puntuales no se conviertan silenciosamente en la norma.
Mantenga separadas la autorización y la política de programación. EKS RBAC o las ACL de Slurm determinan si un usuario puede enviar una carga de trabajo. La gobernanza de tareas de SageMaker HyperPod para Amazon EKS, o los controles de programación nativos de Slurm, determinan cuándo esa carga de trabajo autorizada recibe capacidad de cómputo. Usar la cuota del planificador como control de acceso, o usar los controles de autorización como política de programación, produce un comportamiento poco claro y dificulta el diagnóstico de incidentes.
La publicación Best practices for Amazon SageMaker HyperPod task governance explica los pesos de participación equitativa, las cuotas, el préstamo y endeudamiento de capacidad, las clases de prioridad y escenarios comunes de asignación. Para los clústeres de Amazon EKS, use esos patrones al definir la política de asignación. Para los clústeres de Slurm, use los controles de programación nativos descritos anteriormente.
Use la observabilidad como un ciclo de retroalimentación de gobernanza
Con SageMaker Unified Studio, puede ver los detalles del clúster de SageMaker HyperPod para tareas, métricas, configuraciones y metadatos. Para los clústeres de Amazon EKS, las métricas de gobernanza de tareas incluyen vistas de hardware, de equipo y de tareas. Estas vistas le ayudan a comparar la intención de la política con el consumo real.
Trate la observabilidad como un ciclo, como se muestra en la siguiente figura.
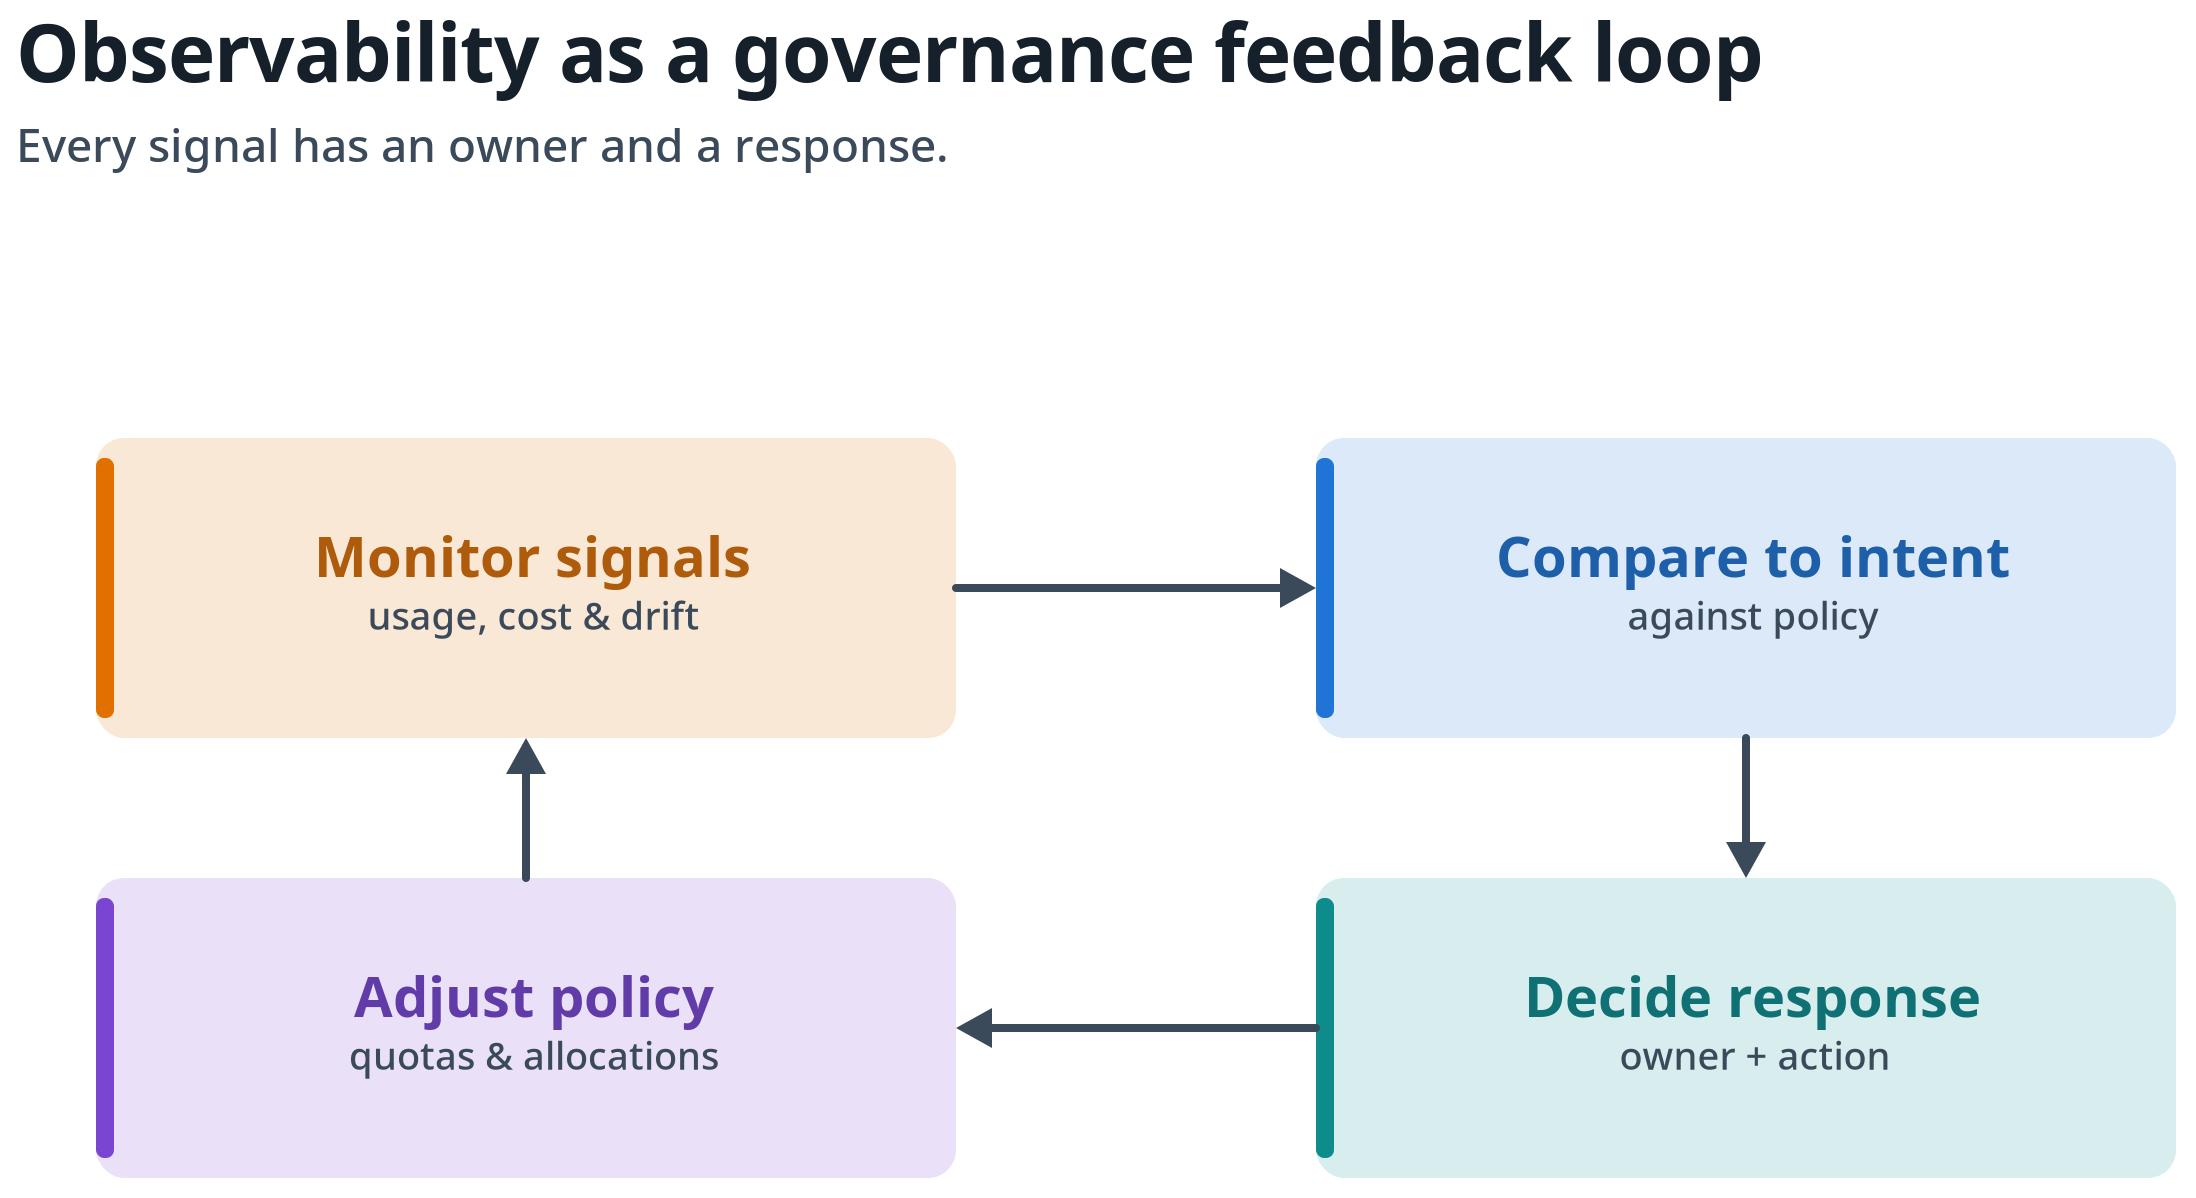
Figura 6: Observabilidad como ciclo de retroalimentación de gobernanza. Supervise las señales, compárelas con la intención de la política, decida una respuesta y ajuste la política y las asignaciones, asignando un responsable y una respuesta a cada señal.
Defina un responsable y una respuesta para cada señal que supervise. Los siguientes ejemplos convierten los datos del panel en decisiones administrativas.
| Señal | Decisión administrativa |
| Capacidad del clúster y utilización de aceleradores | Determinar si la baja utilización es temporal, causada por la política o provocada por restricciones de la carga de trabajo |
| Asignación y utilización por equipo | Revisar si la capacidad reservada y compartida aún refleja la demanda del negocio |
| Tiempo de ejecución y tiempo de espera de las tareas | Investigar la política de prioridad, el dimensionamiento de la carga de trabajo o la contención de capacidad |
| Tareas pendientes y con preferencia | Confirmar que los resultados del planificador coinciden con el modelo de prioridad aprobado |
| Estado de los nodos y eventos de recuperación | Activar el proceso de incidentes del clúster y validar los objetivos de recuperación |
Para los clústeres de Amazon EKS, la tabla de tareas muestra las tareas de Kubeflow (PyTorch, MPI y TensorFlow), y las tareas de PyTorch se muestran de forma predeterminada. Las cargas de trabajo enviadas mediante otros mecanismos podrían no aparecer allí. Para los clústeres de Slurm, las tablas de tareas muestran los trabajos en la cola actual del planificador, mientras que la contabilidad de Slurm proporciona datos históricos de trabajos mediante herramientas como sacct. Defina de dónde obtendrá los datos históricos de tareas, la evidencia de auditoría y los detalles de los incidentes.
El complemento de Amazon CloudWatch Observability para EKS es necesario para las vistas de métricas documentadas. El complemento tiene sus propios requisitos previos: la versión 2.4.0 o posterior, y la CloudWatchAgentServerPolicy política de IAM adjunta al rol del nodo de trabajo de Kubernetes. Las métricas de Kueue, que proporcionan las vistas de gobernanza de tareas, pueden generar cargos por métricas de CloudWatch después de la capa gratuita. Consulte la documentación del panel de SageMaker HyperPod para conocer las consideraciones actuales de configuración y precios.
Revise las conexiones a lo largo de su ciclo de vida
Establezca un calendario de revisiones para cada conexión. También defina revisiones basadas en eventos ante cambios en la propiedad del proyecto, los roles de acceso, la cuenta o la Región, la capacidad del clúster, la versión del orquestador, la clasificación de los datos o la cobertura de monitoreo. Use el contrato de conexión para registrar cada decisión.
La siguiente figura muestra las etapas del ciclo de vida.
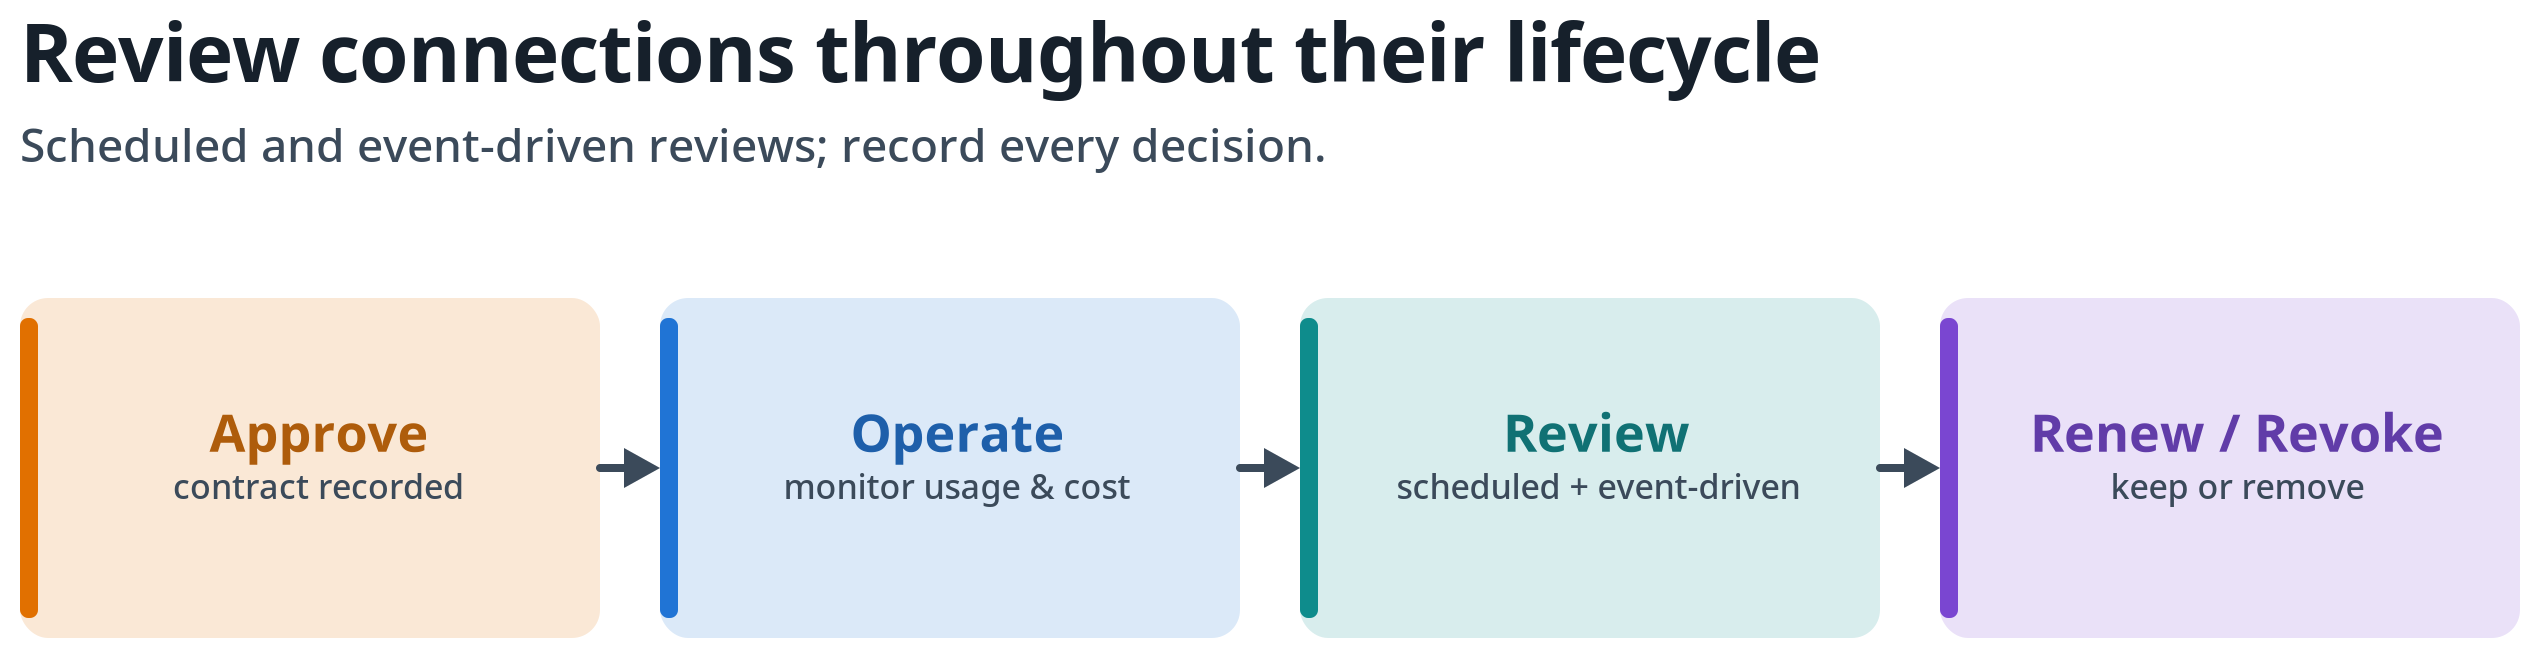
Figura 7: El ciclo de vida de la conexión. Apruebe una conexión con un contrato de conexión registrado, opérele y monitórela, revísela según un calendario y ante eventos definidos, y luego renuévela o revóquela.
Automatice el inventario y la recopilación de evidencias cuando reduzca el trabajo manual, pero mantenga las aprobaciones en manos de administradores responsables. Revogue las conexiones que ya no tengan un propósito comercial ni un responsable.
Conclusión
Con Amazon SageMaker Unified Studio, los equipos de aprendizaje automático pueden seguir una ruta centrada en proyectos hacia el cómputo aprobado de SageMaker HyperPod, mientras que los equipos de infraestructura mantienen el control del clúster centralizado. Comience con un clúster de no producción y un proyecto de prueba. Configure la identidad de carga de trabajo, el ámbito de namespace o Slurm, los permisos de datos, la política de red, las restricciones de vista de tareas y la gobernanza de tareas para Amazon EKS o los controles de programación nativos de Slurm antes de añadir miembros. Instale el complemento de Amazon CloudWatch Observability EKS para que se llenen las vistas de métricas, y registre la aprobación completa en el contrato de conexión. Use roles entre cuentas para las cuentas de consumidor aprobadas, y utilice infraestructura dedicada cuando se requiera un aislamiento estricto. Siga el procedimiento de conexión de SageMaker HyperPod para conocer los pasos de implementación.