
Los asistentes de IA disponibles en el mercado responden bien a las preguntas individuales, pero fallan en otro aspecto: la continuidad. Pregunte a un asistente sin estado sobre su jardín hoy, y no tendrá idea de que hace tres semanas mencionó sus parterres de riego rápido, que solo usa fertilizante orgánico o que sus petunias estaban pasando por una ola de calor. Cada conversación comienza desde cero, y la carga de explicar nuevamente el contexto recae en el usuario.
El problema no es la calidad de las respuestas, sino que la asistente no tiene memoria de ti. Este artículo muestra cómo construir una asistente personal que acumule contexto utilizando OpenClaw, un sistema agentic de código abierto, que se ejecuta en el entorno de ejecución AgentCore, una capacidad de Amazon Bedrock AgentCore. La memoria de AgentCore, una capacidad de Amazon Bedrock AgentCore, convierte los chats desechables en conocimiento duradero. También verás cómo etiquetar esos recuerdos con metadatos estructurados para recuperar los registros que son relevantes para la pregunta en cuestión.
Nuestro ejemplo en funcionamiento es Sprout, un asistente de jardinería, pero la arquitectura es agnóstica al dominio. Cambie la persona y el manifiesto de habilidades, y el mismo pipeline podrá servir a un bot de soporte, un entrenador físico o un servicio de ayuda interno. Todo el sistema reside en una única plantilla de AWS CloudFormation, se despliega con un solo comando y funciona bajo un modelo basado en consumo, que cuesta unos pocos dólares al mes para un uso personal ligero. En el camino, compartimos directrices de diseño que pueden aplicarse a los asistentes que construyen en esta pila.
Descripción general de la solución
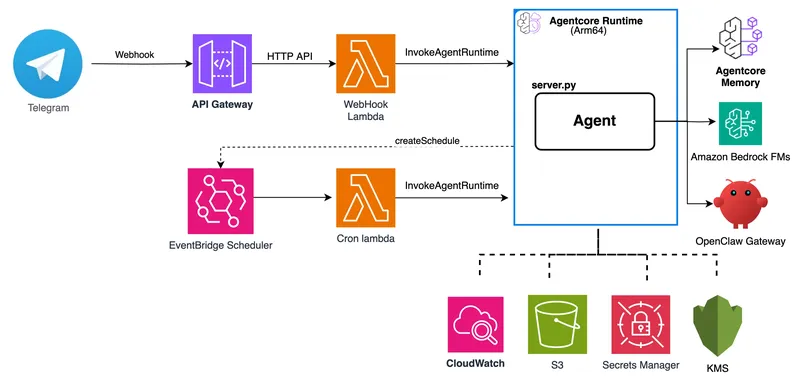
AgentCore es una plataforma para construir, conectar y optimizar agentes a gran escala, utilizando cualquier marco o modelo. El siguiente diagrama muestra el flujo de solicitud end-to-end, desde un webhook de Telegram entrante a través del runtime de AgentCore y los servicios de AWS que lo soportan.
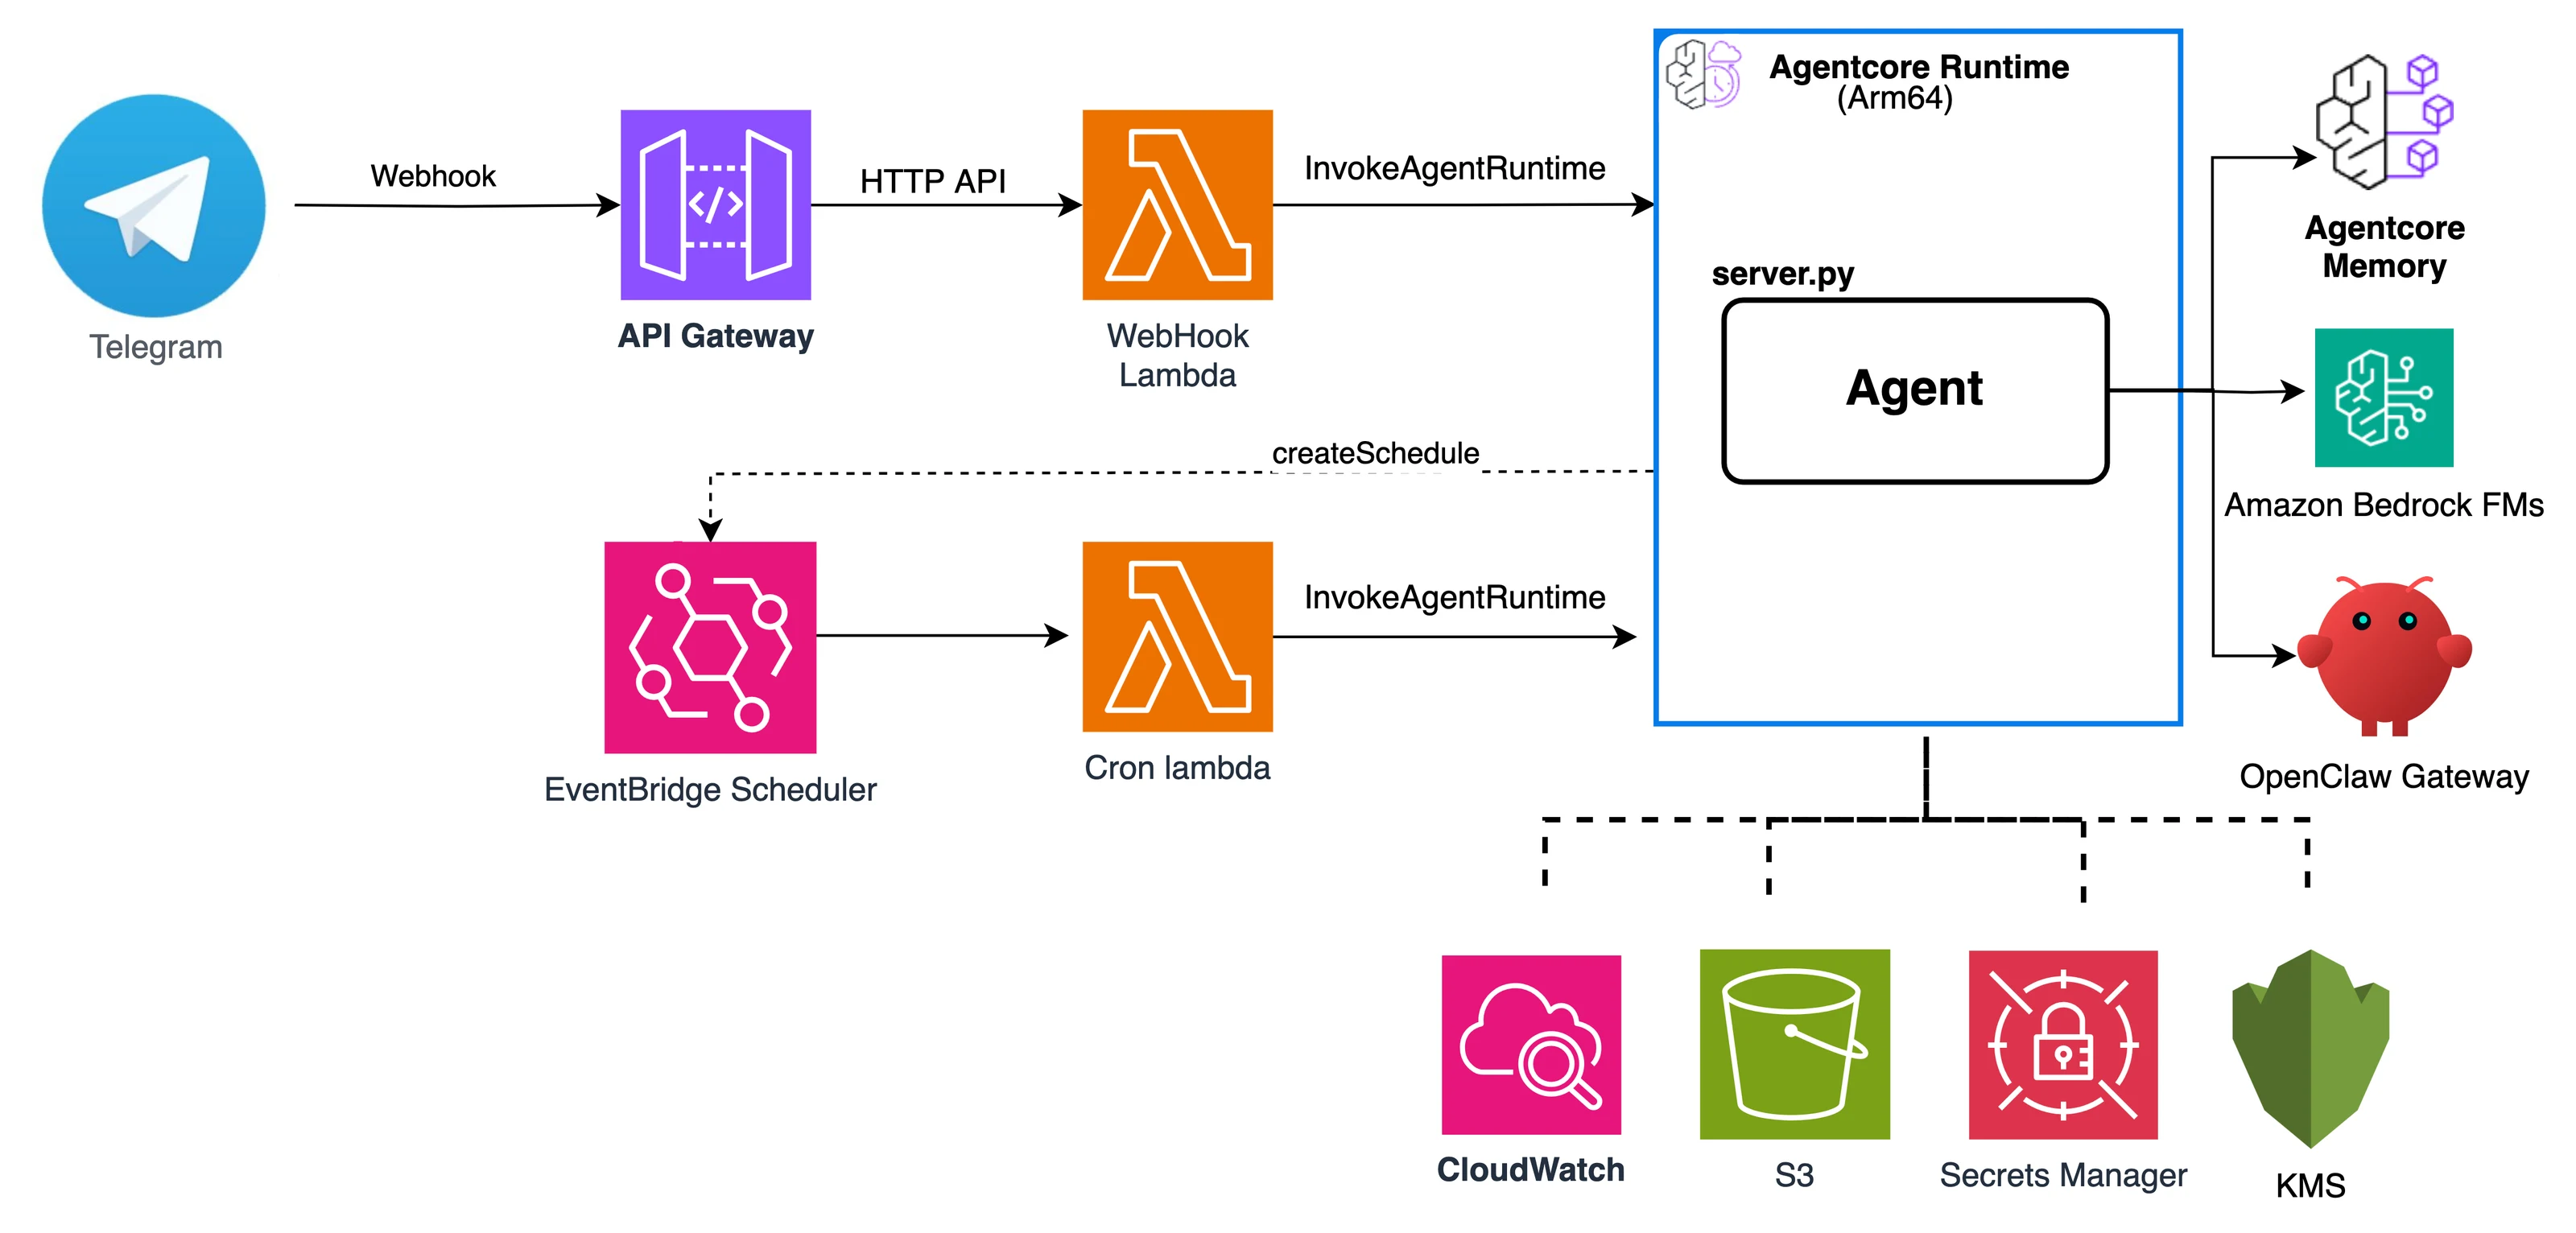
Figura 1: Los webhooks de Telegram y los horarios de Amazon EventBridge invocan el mismo agente de ejecución AgentCore, que coordina la pasarela OpenClaw, la memoria de AgentCore y Amazon Bedrock
Dos puntos de entrada convergen en un agente. Los mensajes de Telegram llegan a través del Amazon API Gateway y una función webhook de AWS Lambda, mientras que trabajos programados como recordatorios de riego por la mañana llegan a través del Amazon EventBridge Scheduler y una función cronjob de Lambda. Ambos llaman a la API InvokeAgentRuntime en el runtime de AgentCore, donde un proceso sencillo server.py coordina el gateway OpenClaw, la memoria de AgentCore y la API Converse de Amazon Bedrock. El Amazon Simple Storage Service (Amazon S3) proporciona almacenamiento para el espacio de trabajo, el AWS Key Management Service (AWS KMS) gestiona la encriptación, el AWS Secrets Manager aloja el token del bot y Amazon CloudWatch captura los logs y métricas.
Requisitos previos
Para desplegar su propia versión utilizando el botón Launch Stack o los scripts deploy.sh (descritos en la sección “Crea tu propia versión”), necesitará:
- Acceso al Amazon Bedrock AgentCore, incluyendo el tiempo de ejecución y la memoria de AgentCore.
- Se concede acceso al modelo para los modelos que se planea enrutar: Claude Haiku 4.5 para texto y Claude Sonnet 4.5 para visión (o los equivalentes disponibles en su cuenta).
- Docker con soporte para la construcción en
linux/arm64, además de la interfaz de línea de comandos de AWS (AWS CLI) configurada. Esto es necesario solo si se planea construir y subir su propia imagen. - Un token de bot de Telegram (de BotFather) que servirá como la puerta principal del asistente.
- Familiaridad básica con los conceptos de orquestación de agentes y CloudFormation.
La arquitectura: un agente sin servidor en el entorno de ejecución de AgentCore
Cada componente reside en una única plantilla de CloudFormation, y no se necesita ningún herramienta de construcción para su inicio. Las secciones siguientes explican las decisiones relacionadas con la carga.
Runtime de AgentCore: Paga solo por el cálculo activo
El agente vive en un contenedor en el entorno de ejecución de AgentCore, que utiliza un sistema de precios basado en el consumo. Se factura por el cálculo de recursos que el agente consume activamente, no por el tiempo de funcionamiento en el reloj de pared, y no se paga por el tiempo que se pasa esperando I/O, como la respuesta del modelo. Para un asistente personal utilizado en breves periodos, esa es la diferencia entre una base aproximada de $1–2 al mes y una instancia siempre activa en Amazon Elastic Compute Cloud (Amazon EC2) por aproximadamente $35 al mes. Estos números son estimaciones para un uso personal ligero a fecha de julio de 2026. Consulte El precio de AgentCore para conocer las tarifas actuales.
El tiempo de ejecución impone un contrato mínimo para el contenedor: escuchar en el puerto 8080, y exponer GET /ping para verificar el estado y POST /invocations como punto de entrada del agente. Nuestro contenedor es linux/arm64, construido en múltiples etapas a partir de la imagen oficial OpenClaw más un capa en Python.
OpenClaw como sustrato del agente
OpenClaw proporciona el bucle del agente, el uso de herramientas y un sistema de habilidades. Ejecuta un envolvente (server.py) que lo adapta al contrato de protocolo HTTP de AgentCore:
- Al iniciar el contenedor,
server.pyiniciaopenclaw gateway runcomo un subproceso y lo verifica en cuanto a su estado. GET /pingdevuelve un estado saludable rápidamente, por lo que la prueba de preparación de AgentCore pasa.POST /invocationsrealiza el trabajo real: analiza el payload, recupera la memoria, construye el contexto, pasa el turno al gateway y persiste el resultado. Una observación: AgentCore puede descongelar un contenedor congelado cuyo subproceso ha terminado. Por lo tanto, el camino de invocación no asume que el gateway esté activo; llama a una ayudaensure_openclaw_ready()que verifica nuevamente la salud (y reinicia el gateway si es necesario) antes de pasar el turno.
Este patrón de envoltorio se puede generalizar para otros casos de uso. Cualquier framework de agente que se ejecuta como un proceso local puede adaptarse al runtime de AgentCore de la misma manera, sin necesidad de modificar el propio framework.
Dos modelos, organizados por tarea
El chateo en texto y la comprensión de imágenes tienen diferentes compromisos de costo y calidad, por lo que el asistente los dirige a diferentes modelos Claude en Bedrock:
- Claude Haiku 4.5 para texto: Rápido y económico para los turnos de conversación de alto volumen que dominan el uso diario.
- Claude Sonnet 4.5 para visión: Un razonamiento multimodal más potente para la tarea menos frecuente pero más difícil de diagnosticar una planta a partir de una foto.
El texto se transmite a través del puerto de OpenClaw, el cual transmite habilidades y estado de sesión. La imagen llama directamente al gran modelo de lenguaje (LLM) de Bedrock desde server.py, pasando los bytes de la imagen como bloques de contenido multimodal. Rutaamos las imágenes alrededor del puerto de forma deliberada: la construcción de OpenClaw dentro del contenedor descartó las partes de contenido image_url antes de que llegaran a Bedrock, por lo que llamar a la API de Converse directamente desde server.py asegura que el modelo vea los píxeles reales. Ambos caminos comparten el mismo prompt del sistema (persona más memoria), por lo que la experiencia sigue siendo consistente.
Los IDs del modelo son variables de entorno (MODEL_ID, VISION_MODEL_ID), por lo que se puede cambiar de modelo en cada despliegue sin reconstruir la imagen.
Habilidades como la unidad de capacidad reutilizable
Las capacidades se declaran como habilidades en un manifiesto community-skills.json. Un script al momento de la implementación las materializa en el contenedor y las registra en la configuración de OpenClaw antes de que se construya la imagen. Sprout incluye habilidades de clima, recordatorios y notas sobre plantas en el momento de publicar este artículo. Cambie el manifiesto y el mismo pipeline servirá para un dominio diferente. Esto hace que todo sea un patrón reutilizable y no solo un único bot.
Telegram como la puerta de entrada sin servidor
Telegram es un canal práctico para un asistente personal, ya que se basa en webhooks, y mantiene todo sin necesidad de servidor. No requiere desarrollo de cliente, funciona en cualquier dispositivo que el usuario posea y soporta texto, imágenes y formato avanzado a través de una API de bot sencilla. BotFather emite un token de bot, que se almacena en Secrets Manager. La implementación registra un webhook que conecta Telegram con el punto de acceso del gateway de API. Cuando el usuario envía un mensaje, Telegram lo entrega a la función Lambda del webhook para validar el payload y llamar a InvokeAgentRuntime. La respuesta regresa por medio de la API de bot de Telegram.
Una lección de formato a tener en cuenta: el modelo de Markdown heredado de Telegram no es tolerante con caracteres sin escapar, y un solo guion suelto en una respuesta del modelo puede hacer que todo el mensaje no se envíe. Renderizar las respuestas como HTML es confiable, por lo que la asistente convierte la salida del modelo en HTML seguro para Telegram antes de enviarlo.
Memoria: Convertir los chats desechables en conocimiento duradero
La arquitectura descrita hasta ahora es un agente capaz y económico sin servidor, pero por sí sola, todavía se olvida de ti entre las conversaciones. Es la memoria lo que cambia eso. Imagina mencionar hace semanas que cultivas en forma orgánica, y hoy el asistente recomienda un tratamiento y añade, por sí solo, que eligió la opción orgánica porque no usas fertilizante sintético. Un modelo sin estado no puede hacer eso.
El modelo mental: eventos a corto plazo, extracción a largo plazo
La memoria de AgentCore tiene dos capas. La memoria a corto plazo almacena cada turno de conversación como un evento a través de CreateEvent, claveado por actorId (el ID de chat de Telegram) y sessionId. Esta es la transcripción bruta. La memoria a largo plazo se genera de forma asincrónica mediante estrategias de extracción gestionadas, en registros duraderos y estructurados. Configuramos tres estrategias:
USER_PREFERENCE: elecciones explícitas que el jardinero indicó (“Solo uso fertilizante orgánico”).SEMANTIC: hechos inferidos (“crece petunias mexicanas en un lecho de acero Corten”).SUMMARIZATION: resúmenes de sesiones episódicas (“se discutió el enrojecimiento de las hojas inferiores durante una ola de calor”).
Espacios de nombres: Un jardín por cada jardinero
Los archivos Sprout se registran en espacios de nombres por usuario, así que nunca se mezclan dos chats:
sprout/{chat_id}/long_term: preferencias y hechos semánticos.sprout/{chat_id}/episodic/{session_id}: resúmenes de sesiones.
El ID de chat es el único segmento variable, lo que hace que la aislamiento sea fácil de entender y probar: cada jardinero único corresponde exactamente a un espacio de nombres, y ningún dos jardineros se cruzan.
El flujo de recuperación, montaje e inyección
En cada turno, el agente recupera los registros a largo plazo relevantes, los clasifica y los introduce en el prompt del sistema. Esto es lo que ocurre en cada mensaje, dentro de server.py:
- Recuperar. Llamar a
RetrieveMemoryRecordscontrasprout/{chat_id}/long_term, utilizando el mensaje del usuario como consulta de búsqueda, con un límite de 50 resultados y dentro de un presupuesto de 3 segundos. Si los tiempos de recuperación se agotan o surgen errores, nos degradamos de manera elegante y respondemos sin memoria, en lugar de fallar.
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
Fragmento 1: Recuperación de registros a largo plazo para la vuelta actual (representativo). Consulta el repositorio para el código completo.
La función Assemble añade lógica personalizada adicional. Queremos que las preferencias explícitas ocupen un lugar prioritario en comparación con los hechos inferidos; el orden es estable dentro de cada clase, y el resultado se limita antes de la inyección:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
Fragmento 2: La etapa de ensamblaje ordena las preferencias explícitas antes de los hechos inferidos.
Metadatos: Subgrupación de memorias dentro de un espacio de nombres
Los espacios de nombres responden a en qué memoria se refiere el registro, pero los metadatos responden a de qué trata. Dentro de sprout/{chat_id}/long_term, una búsqueda semántica para “mis petunias están marchitas” devolvería todo lo que sea similar en significado. Para un jardinero, eso significa una preferencia de fertilizante desde marzo y una nota de poda para el árbol de higuera, junto con los registros que realmente son importantes. Y los metadatos estructurados nos ayudan a reducir el alcance de las memorias antes de que lleguen al prompt.
Una regla guía todas las decisiones aquí. Una clave de metadatos solo puede filtrarse en el servidor si se declara como una clave indexada. Puede leer más en Filtrado de memoria estructurada con metadatos en Amazon Bedrock AgentCore Memory. En este caso, sprout utiliza tres claves indexadas:
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
Cada entrada nombra una clave, que debe coincidir con una clave indexada para poder filtrarla, y establece extractionType en ya sea STRICTLY_CONSISTENT, transmitido desde el evento, o LLM_INFERRED, extraído de la conversación. Para las claves inferidas, una configuración de extracción puede restringir los valores a una lista fija. Sprout hace eso exactamente, por lo que ambas rutas de escritura crearán el mismo vocabulario y un filtro significa lo mismo, independientemente de qué parte haya creado el registro.
Mantener el giro y cerrar el bucle
Después de que el modelo responda, server.py llama a CreateEvent con tanto el turno del usuario como el turno del asistente. Ese nuevo evento alimenta las estrategias de extracción, lo que enriquece el almacenamiento a largo plazo para la próxima vez.
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
Fragmento 3: Mantener el turno para que las estrategias de extracción puedan enriquecer la memoria a largo plazo de forma asincrónica.
La extracción es asincrónica, por lo que un hecho mencionado en esta sesión suele poder ser recuperado en una posterior. Diseña para ese retraso: los eventos de la sesión a corto plazo abarcan la conversación actual, y los registros a largo plazo abarcan todo lo anterior.
Uniendo todo: Un plan de riego personalizado
Aquí es donde la cadena de procesamiento completa funciona de extremo a extremo. A través de algunas conversaciones, catoga todo su jardín, una planta por vez, en lenguaje sencillo. Cada mención se convierte en un evento. Las estrategias de extracción extraen información sobre la planta, su ubicación y su exposición al sol en sprout/{chat_id}/long_term. Esta mañana, el usuario hace una pregunta: “¿Recuerdas las otras plantas de mi jardín?”. La recuperación extrae los registros, los clasifica y los introduce en el prompt del sistema. La asistente responde con la ubicación del usuario, su exposición al sol, la construcción de la cama, el comportamiento del suelo y el inventario de plantas, algo que no aparecía en el mensaje mismo.
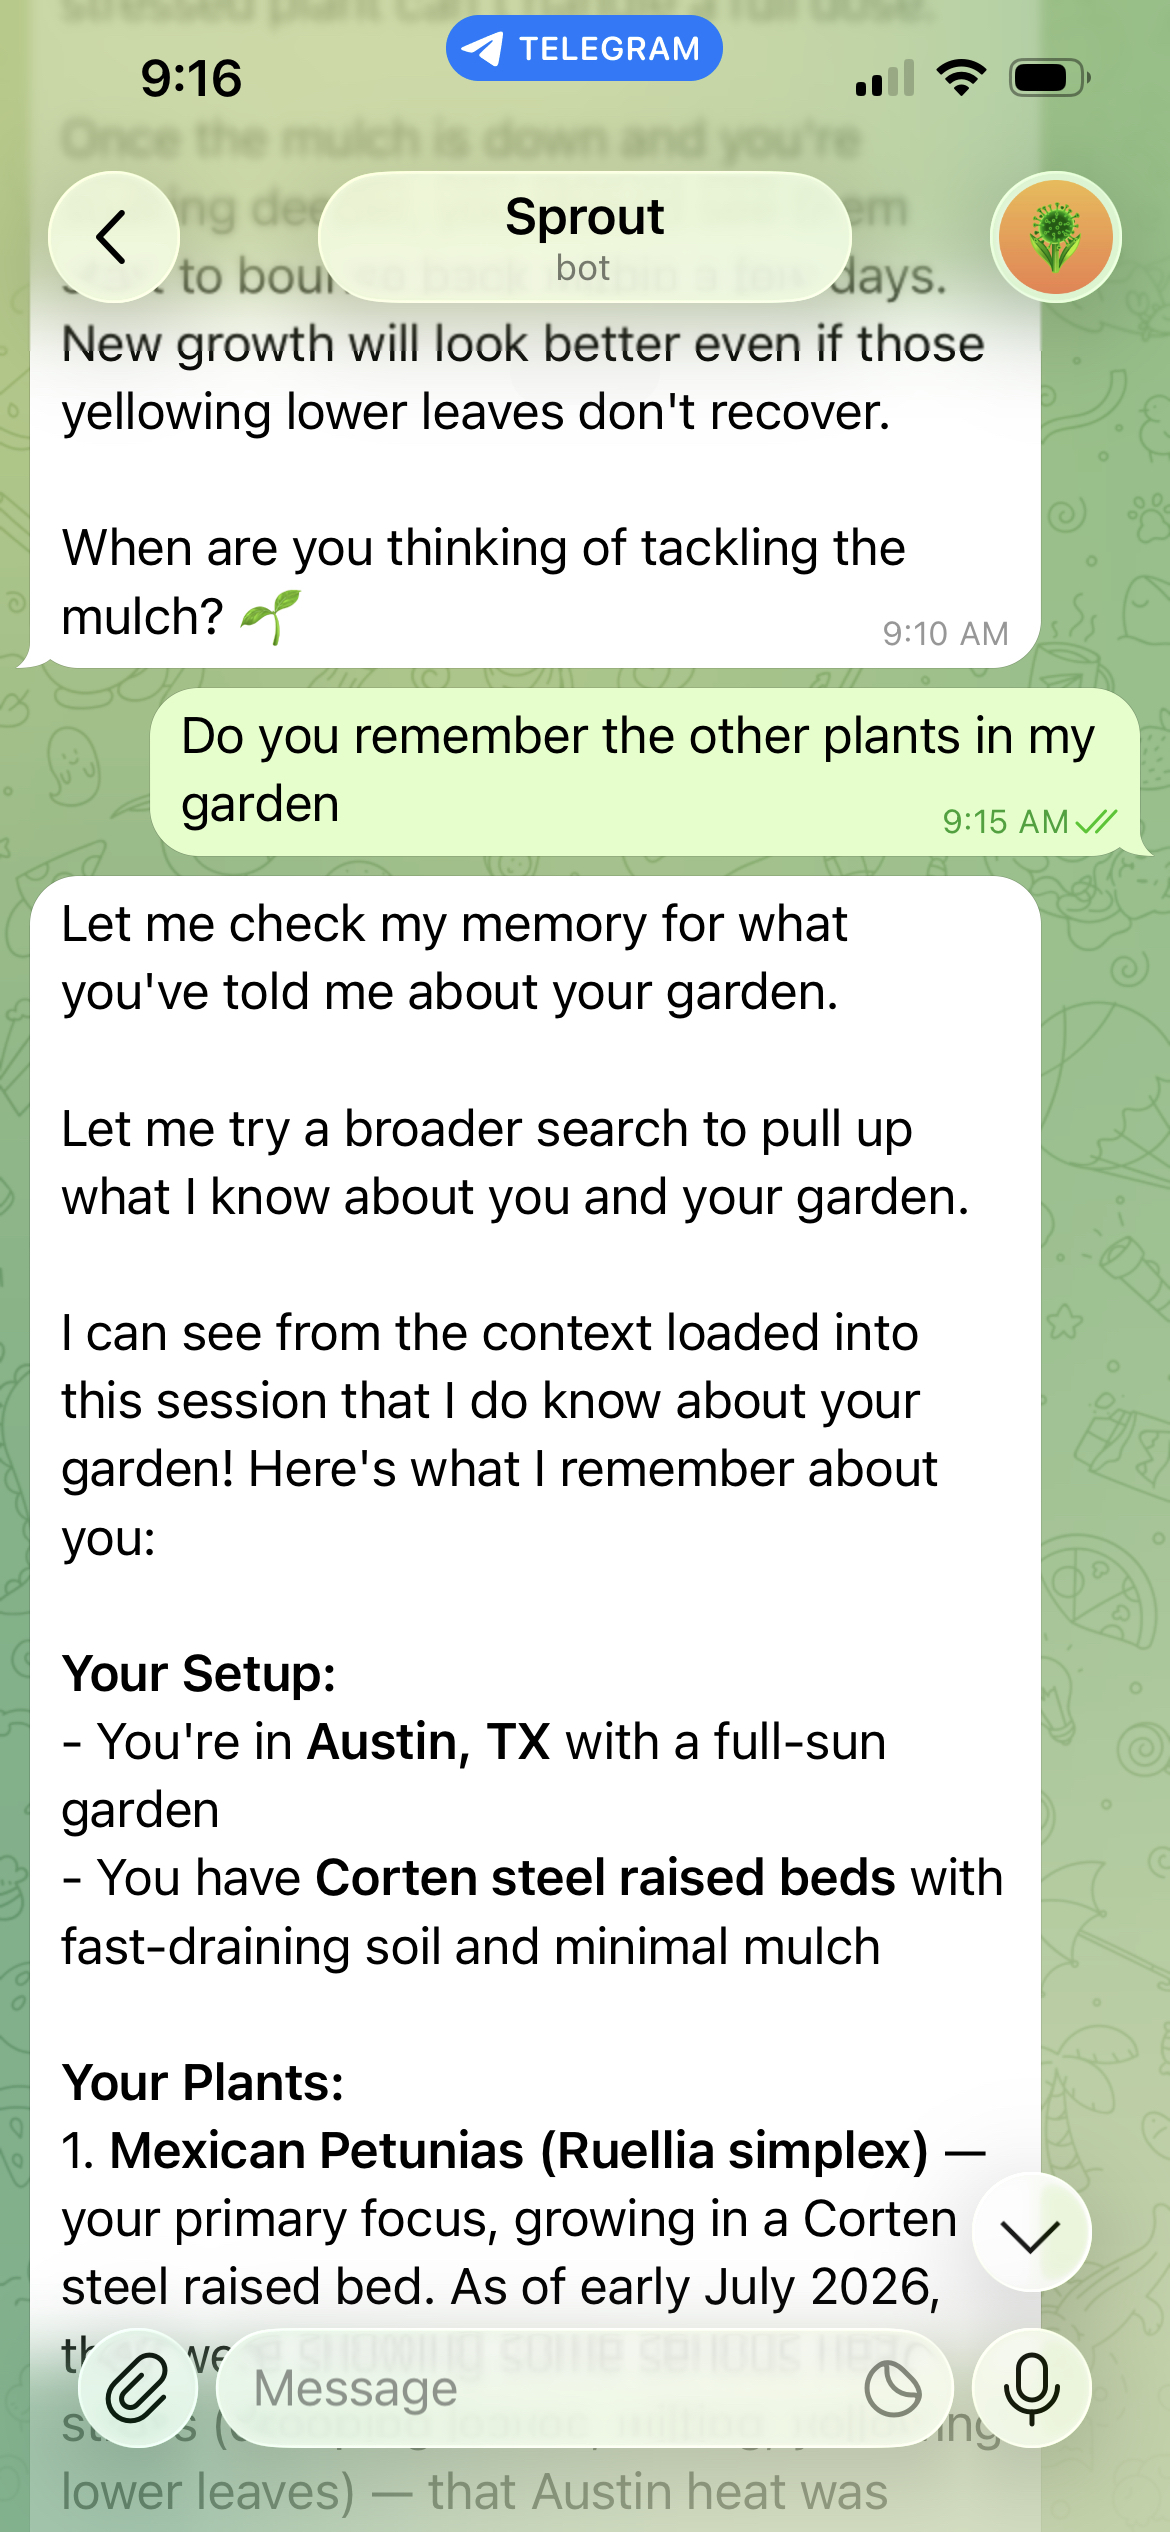
Figura 2: Sprout responde a una pregunta sobre el jardín al recordar el inventario de plantas almacenadas y las condiciones de crecimiento.
Usando la habilidad de planificación en el camino Amazon EventBridge → Cron, Sprout también puede convertir ese plan en recordatorios proactivos (“evitar las hierbas, el suelo todavía está húmedo por ayer”) y ajustarlos según la habilidad meteorológica cuando llegue lluvia o una ola de calor.
La memoria y la visión también se combinan entre sí. Cuando el usuario envía una foto de una planta marchita, la imagen llega a Claude Sonnet 4.5, mientras que el prompt del sistema sigue conteniendo todo lo que la capa de memoria conoce. El asistente relaciona la foto con las petunias mexicanas ya guardadas en el inventario del usuario y diagnostica el estrés por marchitamiento en el contexto, en lugar de analizar una foto anónima de planta de forma fría.
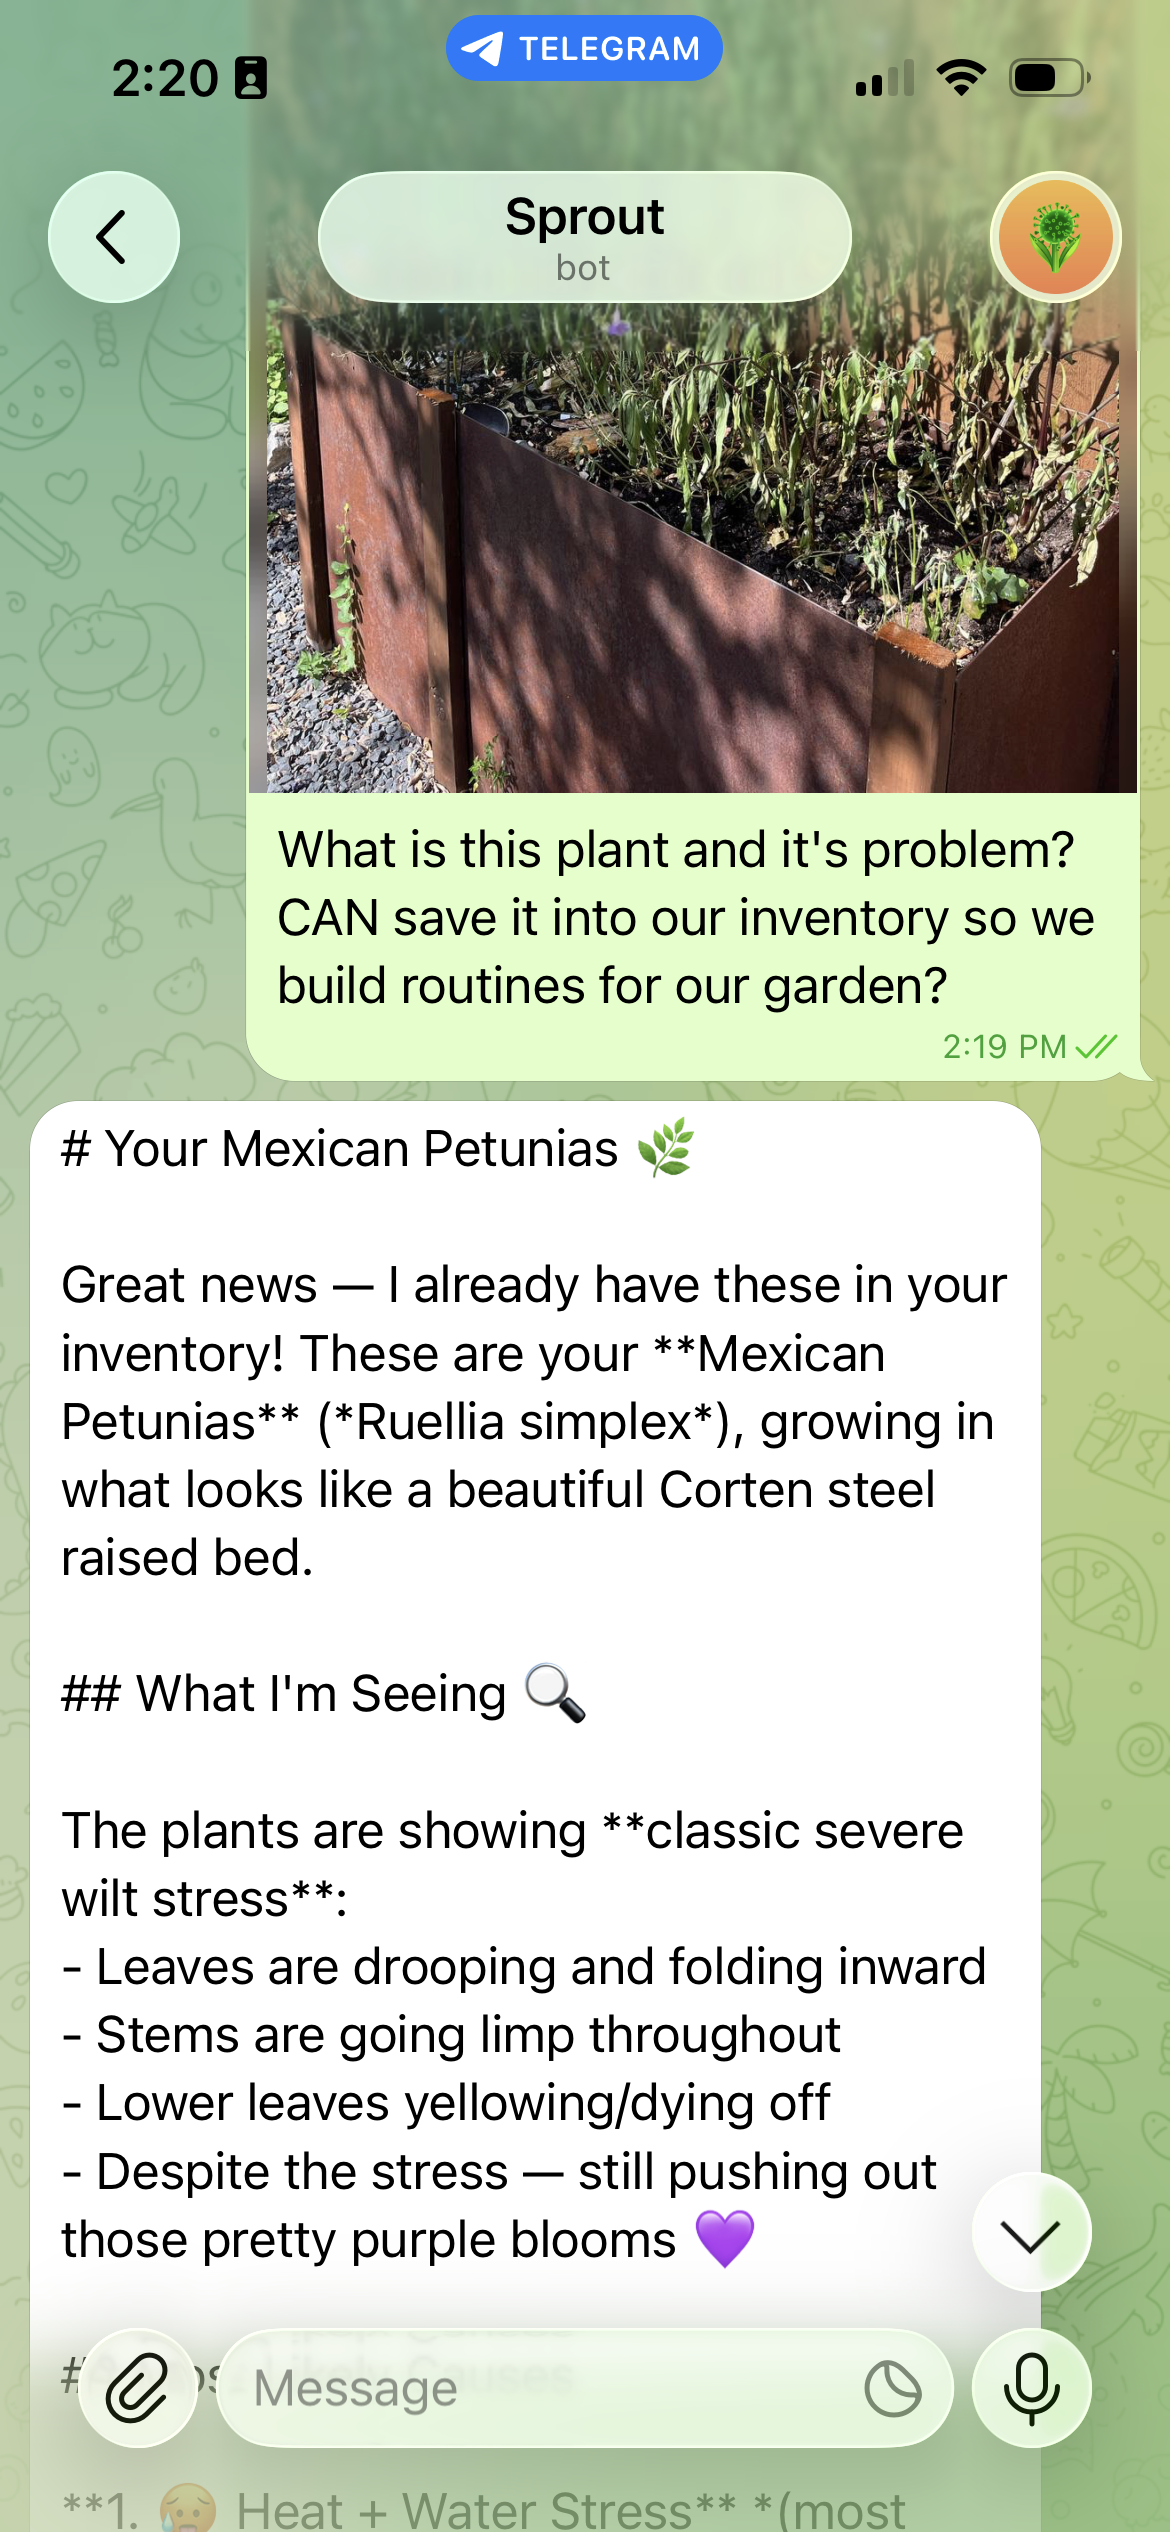
Figura 3: La visión y la memoria trabajando juntas. La foto pertenece al modelo de visión, mientras que el prompt del sistema contiene el contexto del jardín almacenado por el usuario.
Los modelos de visión no son infalibles. En una conversación anterior sin el contexto del inventario, la misma planta fue identificada con confianza como una *morning glory*, una especie con flores moradas en forma de trompeta. Basar el modelo de visión en el inventario almacenado por el usuario es lo que convirtió una suposición que parecía plausible en un diagnóstico correcto y personalizado. Es una buena ilustración de por qué la memoria mejora la precisión, y no solo el tono.
Mantener los costos de inferencia bajos con el caché de prompts
La inyección de memoria en cada turno hace que el prompt del sistema sea largo, y una implementación ingenua pagaría por esos tokens en cada solicitud. El caché del prompt en Amazon Bedrock resuelve este problema. La asistente estructura su prompt de manera que el prefijo estable, la persona y el bloque de memoria reunido vengan primero, y el mensaje del usuario volátil venga último. Bedrock almacena el prefijo procesado entre las solicitudes, por lo que los turnos repetidos dentro de una conversación omiten el recálculo de la parte inmutable. El caché de prompts puede reducir los costos en hasta el 90 por ciento y la latencia en hasta el 85 por ciento para los modelos compatibles.
La regla de ordenamiento es más importante que cualquier configuración individual: coloca el contenido estable en primer lugar, el contenido volátil en último, y mantén el orden interno del bloque de memoria determinista (lo que facilita la función de ensamblaje anterior), de modo que el prefijo coincida realmente entre las solicitudes.
Lineales de diseño para construir en AgentCore y OpenClaw
Sprout es un asistente, pero las decisiones que toma son generalizables. Si está construyendo su propio asistente con esta plataforma, las siguientes directrices son las que aplicaríamos en cualquier campo.
- Envuelve, no bifurca. Adapta tu marco de agente al contrato del contenedor AgentCore con un envuelve HTTP ligero, en lugar de modificar el marco. El contrato es pequeño, tiene puerto 8080 con
/pingy/invocations, y un envuelve te mantiene en el camino de actualización del marco. - Diseña los espacios de nombres antes de almacenar cualquier cosa. Los espacios de memoria de nombres son la frontera de aislamiento. Haga que el ID de usuario sea el único segmento variable, y elija uno de los IDs nativos del canal en los que ya confía, como el ID de chat. Los diseños multi-tenant eventualmente reciben auditorías y solicitudes de eliminación. Un esquema limpio de espacio de nombres hace ambos tareas triviales.
- Trata la memoria como una mejora, nunca como una dependencia. Cada operación de memoria debe permitirse fallar de manera elegante. Los fallos en la recuperación deben producir una respuesta sin memoria sin bloquear la respuesta. Los usuarios perdonan un gesto olvidoso mucho más fácilmente que uno fallido.
- Modeles de ruta según la tarea. Utilice un modelo rápido y económico para el texto de alto volumen, y reserve un modelo multimodal más potente para las operaciones que lo necesiten. Mantenga los IDs del modelo en variables de entorno, de modo que los cambios en el enrutamiento sean de configuración, no de código.
- Instrucciones de orden para el caché. Primero, la persona estable y la memoria; después, la entrada volátil del usuario; orden determinista en todo momento. Este hábito estructural es donde proviene la mayor parte de los ahorros en inferencias.
- Plan para la latencia de extracción. La memoria a largo plazo se extrae de forma asincrónica, por lo que no se puede prometer la recuperación de nuevos datos en la misma sesión. Deje que los eventos de la sesión corta cubran la conversación actual, y que los registros a largo plazo cubran las conversaciones anteriores.
- Establece un presupuesto desde el primer día. Un agente basado en consumo es económico hasta que una bucle de repetición o un usuario comunicativo lo hace de otra manera. Las alertas de AWS Budgets al 80 por ciento y al 100 por ciento del límite mensual no cuestan nada y detectan las sorpresas de forma temprana.
- mantenga las habilidades pequeñas y de un solo propósito. Una habilidad debe hacer una cosa que el usuario podría escribir en una oración, como comprobar el clima o establecer una recordatoria. Las habilidades pequeñas son independientemente probables, independientemente sustituibles y fáciles para que el modelo seleccione correctamente. Una habilidad que hace todo obliga al modelo a adivinar qué comportamiento quiso decir.
Cultiva tu propio
Dos formas de plantarlo, mismo jardín:
- Stack de lanzamiento de un solo paso: el plantilla de CloudFormation apunta a una imagen del Amazon Elastic Container Registry (Amazon ECR) público, por lo que se despliega únicamente un token de bot de Telegram.
- Construye tu propio: El script scripts/
deploy.shvalida el plantilla, genera y envía la imagen ARM64 personalizada al repositorio privado de Amazon ECR, despliega la pila y registra el webhook de Telegram, lo que permite una construcción totalmente personalizable.
El uso personal ligero cuesta alrededor de $5–9 por mes a partir de julio de 2026 (aproximadamente $2 para la infraestructura, $1–3 para el texto Haiku y $2 para la visión de soneto), con un presupuesto integrado de AWS que alerta cuando se alcanzan el 80 por ciento y el 100 por ciento del límite que se establece.
El código fuente completo está disponible en el repositorio GitHub sample-agentcore-memory-openclaw.
Limpiar
Cuando termine los experimentos, derrumba todo para evitar cargos continuos. Dado que todo el sistema es una pila de CloudFormation, la limpieza consiste principalmente en una simple eliminación.
- Eliminar la pila de CloudFormation. Esto elimina el agente de ejecución AgentCore, el API Gateway, las funciones Lambda, el horario de Amazon EventBridge y los roles de gestión de identidad y acceso de AWS (IAM) asociados.
- Elimine el almacén de memoria de AgentCore (y sus espacios de nombres) para que no se conserven registros de usuario.
- Elimine cualquier imagen que haya subido al repositorio privado ECR, y el propio repositorio si ya no es necesario.
- Elimine la alerta de presupuesto de AWS si la creaste fuera de la pila.
- Revoca el webhook de Telegram (o elimina el bot a través de BotFather), y revoca el acceso al modelo Bedrock si ya no lo necesitas.
Conclusión
El núcleo reutilizable de esta solución es un agente sin servidor en Amazon Bedrock AgentCore, con un sistema de habilidades y memoria gestionada. La memoria de AgentCore elimina la necesidad de construir almacenes de vectores personalizados y pipelines de extracción, mientras que le permite tener total control sobre lo que el agente recuerda y olvida. El cálculo basado en consumo más el almacenamiento en caché de prompts mantiene un asistente verdaderamente personalizado por unos pocos dólares al mes, y los manifestos de habilidades de OpenClaw hacen que todo el patrón sea portable entre diferentes dominios. La personalización también se compone: cuanto más interaccione el usuario, más útil se vuelve la asistente.
Para seguir adelante, comience con un único dominio como los recordatorios de riego y expanda el alcance de la memoria de manera incremental. Explorar la memoria episódica para que el agente pueda referirse a conversaciones pasadas específicas (“la última vez que discutimos el árbol de higuera, usted decidió no usar fertilizante”). O bifurque el repositorio, introduzca su propia personalidad y habilidades, y desarrolle cualquier asistente que necesite.
Para saber más, consulte la documentación de AgentCore. Los siguientes artículos relacionados abordan los componentes básicos con mayor profundidad:
- Memoria de Amazon Bedrock AgentCore: Construcción de agentes conscientes del contexto
- Construyendo agentes de IA más inteligentes: Análisis profundo de la memoria a largo plazo de AgentCore
- Utilizar efectivamente el almacenamiento de prompts en Amazon Bedrock
- Lanzar y escalar de forma segura tus agentes y herramientas en el entorno de ejecución Amazon Bedrock AgentCore