
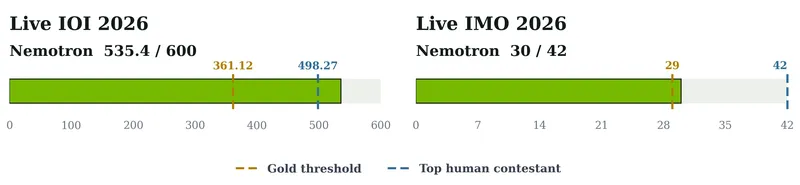
La Olimpiada Internacional de Informática (IOI) y la Olimpiada Internacional de Matemáticas (IMO) evalúan diferentes habilidades. La IOI requiere algoritmos y código que pasen pruebas ocultas bajo estrictos límites de tiempo y presentación. La IMO exige pruebas rigurosas en lenguaje natural. Ser exitoso en cualquiera de las competiciones es difícil. Ser exitoso en ambas implica algo más amplio.
Nuestros resultados recientes muestran que Nemotron es una base sólida y adaptable para construir modelos especializados de clase mundial. A partir de Nemotron 3, nuestros equipos utilizaron el ajuste fino supervisado (SFT), el aprendizaje por refuerzo (RL) y la inferencia impulsada por retroalimentación para crear sistemas que alcanzaron el nivel de medalla de oro tanto en IMO 2026 como en IOI 2026.

| Competencia | Especialización Nemotron | Resultado |
|---|---|---|
| IOI 2026 | Nemotron-3-Ultra-CC con SFT y GenCorrect | 535.4/600, por encima del umbral de oro de 361.12 y la puntuación más alta humana de 498.27 |
| En mi opinión 2026 | Nemotron 3 Ultra general, SFT y puntos de control RL en un sistema de generación-verificación-mejoría | 30/42, por encima del umbral oficial de oro de 29 |
El resultado de IOI provino de una ejecución en tiempo real y prospectiva, bajo las mismas restricciones de acceso a internet y presentación que los competidores humanos. Fue un benchmark no oficial, sin supervisión, y no se incluyó en el ranking oficial de IOI. Las pruebas presentadas por el sistema IMO fueron calificadas por calificadores oficiales de IMO.
Un receta de especialización reutilizable
“Fácil de ajustar” debe significar algo más que simplemente hacer que un punto de control sea adaptable para el entrenamiento. Debe significar que un modelo base capaz puede adaptarse a un dominio exigente con una receta clara y reutilizable.
En los dos proyectos, esa receta constaba de cuatro partes:
- Comience con un modelo base fuerte de Nemotron.
- Seleccionar problemas específicos para un dominio y trazas de razonamiento de alta calidad.
- Aplicar métodos estándar posterrecesión, como SFT y, cuando sea útil, RL.
- Añada el modelo especialista a un bucle de inferencia que genera, evalúa y mejora las respuestas candidatas.
Los procesos de entrenamiento y inferencia fueron significativos, pero el enfoque subyacente es familiar y reproducible. No necesitamos construir un nuevo modelo de base para cada desafío. Hemos especializado a Nemotron para esa tarea.
De la habilidad general en programación a oro en IOI
Para la programación competitiva, seleccionamos 22,000 problemas y generamos trazas de razonamiento sintético para entrenar a dos especialistas. Nemotron-3-Nano-CC, con 30 mil millones de parámetros en total y 3 mil millones de parámetros activos, recibió tanto SFT como RL. Nemotron-3-Ultra-CC, con 550 mil millones de parámetros en total y 55 mil millones de parámetros activos, recibió SFT.
La progresión en IOI 2025 hace que el valor de la especialización sea fácil de ver. Nano mejoró de 130 puntos antes del entrenamiento a 280 después del SFT y a 291 después del RL. Con GenCorrect, nuestra estrategia iterativa de generar, evaluar y refinar, alcanzó 468 puntos y superó el umbral dorado de 438.3. Ultra-CC alcanzó 502 puntos con la misma estrategia durante el tiempo de prueba.

Estos experimentos también mostraron que la adaptación no tiene que verse igualmente a todas las escalas. SFT produjo la mayor parte de los beneficios de Nano, mientras que RL añadió una mejora menor pero consistente. Para el modelo Ultra más potente, una sola época de SFT fue suficiente para superar al modelo Nano completamente entrenado en post, en IOI, ICPC y LiveCodeBench Pro. Este hallazgo guio el sistema Ultra-CC específico para la competición utilizado en IOI 2026, que obtuvo un puntaje de 535.4 de 600.
Enseñar a Nemotron para probar, verificar y revisar
El proyecto IMO aplicó la misma idea a las matemáticas olímpicas. Comenzando con Nemotron 3 Ultra, entrenamos a un especialista con SFT y a otro con RL.
El corpus SFT contenía 414,890 ejemplos filtrados por calidad en 15,818 problemas de demostración únicos. Hizo más que simplemente enseñar las respuestas finales. Los datos abarcaban la generación de demostraciones, su refinamiento, verificación y meta-verificación; por lo que el modelo aprendió a construir argumentos, identificar deficiencias, responder a críticas y juzgar si una demostración era completa. El modelo RL se entrenó con 9,597 problemas de demostración seleccionados cerca de la frontera de capacidad del modelo.
Amb los puntos de control post-entrenamiento superaron al modelo de disponibilidad general en los experimentos de desarrollo. El punto de control SFT fue el más fuerte en la primera ronda de búsqueda, mientras que el punto de control RL logró el mejor resultado global para un único punto de control. Sus fortalezas eran complementarias, por lo que el sistema final utilizó a ambos especialistas junto con el modelo general.
Para cada problema del IMO, los modelos generaban pruebas candidatas, las calificaban, producían críticas y perfeccionaban los intentos más prometedores. Una etapa separada de alto cálculo seleccionaba la presentación final. Todo el sistema funcionaba en lenguaje natural, sin un prover formal, herramientas externas ni acceso a Internet. Obtenió 30 puntos de 42, incluyendo crédito completo en cuatro de los seis problemas, y superó el umbral oficial de medalla de oro.

>El ajuste fino y el cálculo en tiempo de prueba trabajan juntos
Nuestro anterior artículo de Hugging Face sobre IOI 2025 mostró cómo el cálculo en tiempo de prueba puede llevar a los modelos de peso abierto al nivel de rendimiento de oro. Los nuevos resultados añaden una pieza importante: una mejor especialización proporciona al sistema de inferencia mejores candidatos, mejores críticos y mejores refinamientos.
En IOI, GenCorrect convirtió las mejoras obtenidas durante el ajuste fino en incrementos más significativos después de varias rondas de retroalimentación. En IMO, utilizar los puntos de control SFT y RL complementarios fue más valioso que simplemente obtener más muestras desde un único punto de control. En ambos casos, el mejor resultado se obtuvo combinando a un especialista competente con un sistema capaz de buscar, verificar y mejorar.
Esta distinción es importante. Las medallas no se produjeron únicamente mediante el ajuste fino, y tampoco se produjeron únicamente mediante la muestra por fuerza bruta. Provienen de la co-diseño del modelo, los datos y el bucle de inferencia.
Modelos abiertos, datos y recetas en Hugging Face
Que estos resultados sean útiles más allá de las competiciones. La colección Nemotron Labs IMO 2026 reúne los checkpoints de SFT y RL, ambos conjuntos de datos de entrenamiento, así como Nemotron-IMO-Bench, un nuevo benchmark con 200 problemas de nivel olímpico. El artículo sobre IMO describe el enfoque de entrenamiento y el sistema de generación-verificación-mejora, mientras que el repositorio NeMo-Skills incluye la pipeline de inferencia de IMO, prompts, pruebas presentadas y un quickstart reproducible. Para programación competitiva, el modelo Nemotron-3-Ultra-CC está disponible en Hugging Face, y el artículo sobre IOI proporciona la receta de entrenamiento y la metodología GenCorrect. La pipeline de evaluación e inferencia de IOI también está disponible en NeMo-Skills.
Juntos, IMO y IOI proporcionan evidencia excepcionalmente exigente para una idea sencilla: Nemotron puede ser ajustado para convertirse en especialistas de alto nivel en un área específica, y luego se compone con flujos de trabajo de inferencia transparentes para resolver problemas en la frontera de la competencia humana.
Estamos emocionados de ver qué construirá la comunidad de Hugging Face en el futuro.