

WER en árabe: 20.92% · Parámetros: 1.6B · WER en emiratí (evaluación de TII): 22.73%
Presentamos Falcon-ASR, nuestro modelo de reconocimiento de voz de 1.6 mil millones de parámetros para el árabe, con especial atención al dialecto emiratí. Desarrollado en el Technology Innovation Institute (TII) en Abu Dabi, también admite inglés, francés, español y portugués.
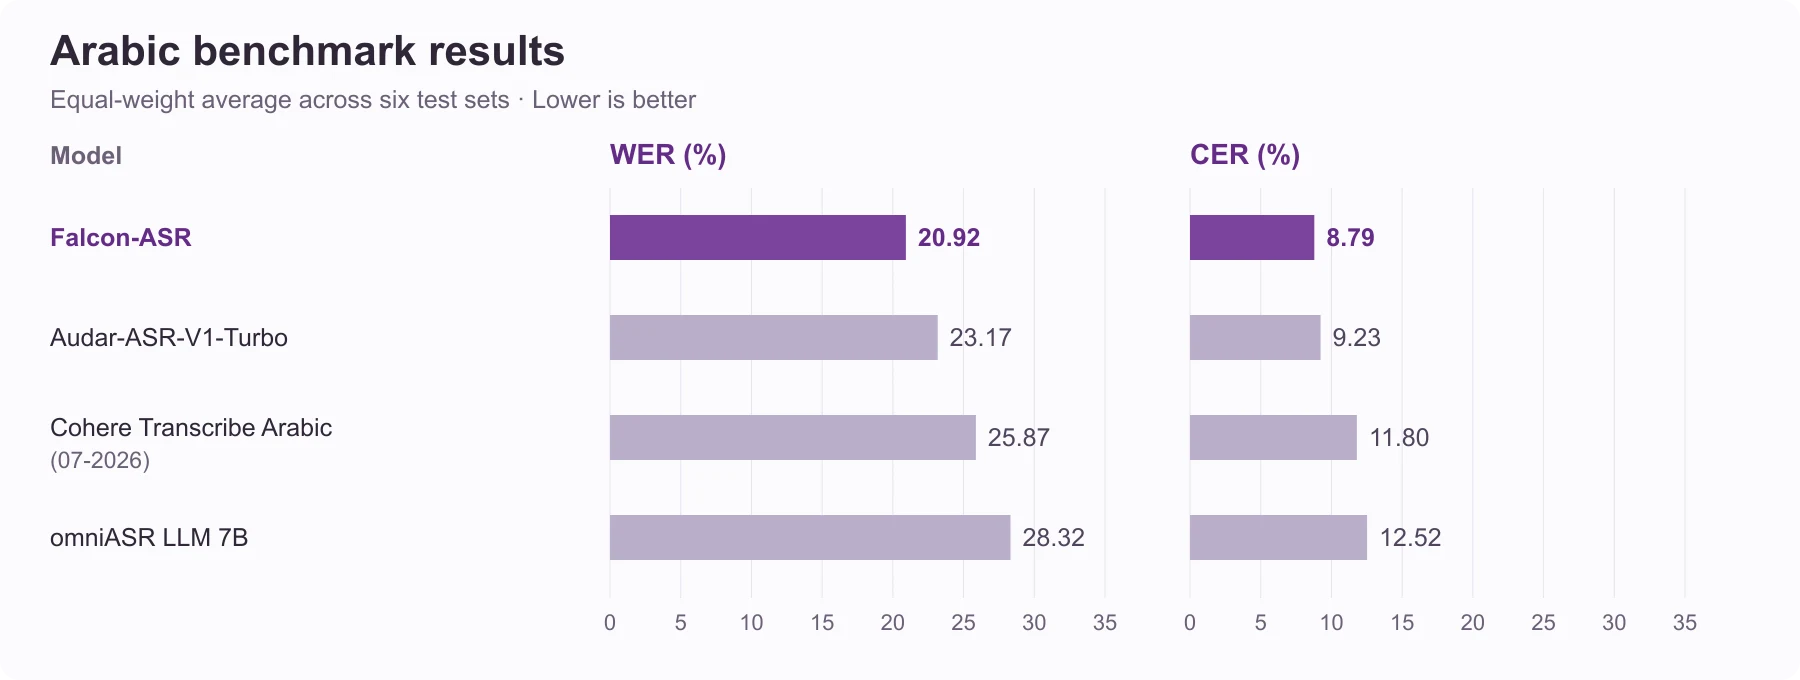
En nuestra evaluación, Falcon-ASR alcanzó una tasa promedio de error de palabras (WER) de 20.92% en seis conjuntos de prueba de árabe, en comparación con el mejor resultado publicado de 23.17% en la instantánea de la tabla de clasificación que utilizamos. En nuestra evaluación interna de emiratí, registró las tasas de error de palabras y caracteres más bajas entre los sistemas que comparamos.
También admitimos marcas de tiempo a nivel de palabra para las transcripciones, vinculando cada palabra transcrita con su posición en el audio.
Reconocimiento del árabe hablado
El habla árabe varía según la región, el hablante y el contexto. Un modelo que maneja una transmisión de noticias formal puede tener dificultades con una conversación en emiratí o con voz grabada por teléfono. El árabe dialectal también cuenta con menos recursos transcritos que el árabe estándar moderno (MSA), lo que dificulta el entrenamiento y la evaluación.
Entrenamos Falcon-ASR con emiratí, MSA, otros dialectos del Golfo y árabes, e inglés. Nuestro objetivo es transcribir las palabras que la gente usa en el habla cotidiana, incluyendo formas dialectales y cambios entre idiomas.
Resultados en benchmarks de árabe
El Open Universal Arabic ASR Leaderboard, mantenido por el ELM Research Center, clasifica los sistemas por el promedio de WER con igual ponderación en seis conjuntos de prueba. También informa la tasa de error de caracteres (CER). Valores más bajos son mejores para ambas métricas. Nuestra evaluación de Falcon-ASR sigue este protocolo.

WER = Tasa de Error de Palabras; CER = Tasa de Error de Caracteres. Un valor más bajo indica un mejor rendimiento.
Evaluamos Falcon-ASR en los mismos seis benchmarks usando los manifests fijados por la tabla de clasificación. Las cifras de los competidores son los promedios publicados en la tabla de clasificación, verificados el 30 de septiembre de 2026. El WER promedio de Falcon-ASR es 2.25 puntos porcentuales mejor que el mejor resultado publicado en esa instantánea.
Evaluación del habla emiratí
Los datos públicos de evaluación ya incluyen emiratí: Casablanca tiene un subconjunto de los EAU. Complementamos esa cobertura con una evaluación interna de habla emiratí y del Golfo adicional, utilizando grabaciones reservadas y transcripciones validadas por humanos para evaluar la precisión de transcripción más allá del subconjunto público de los EAU.
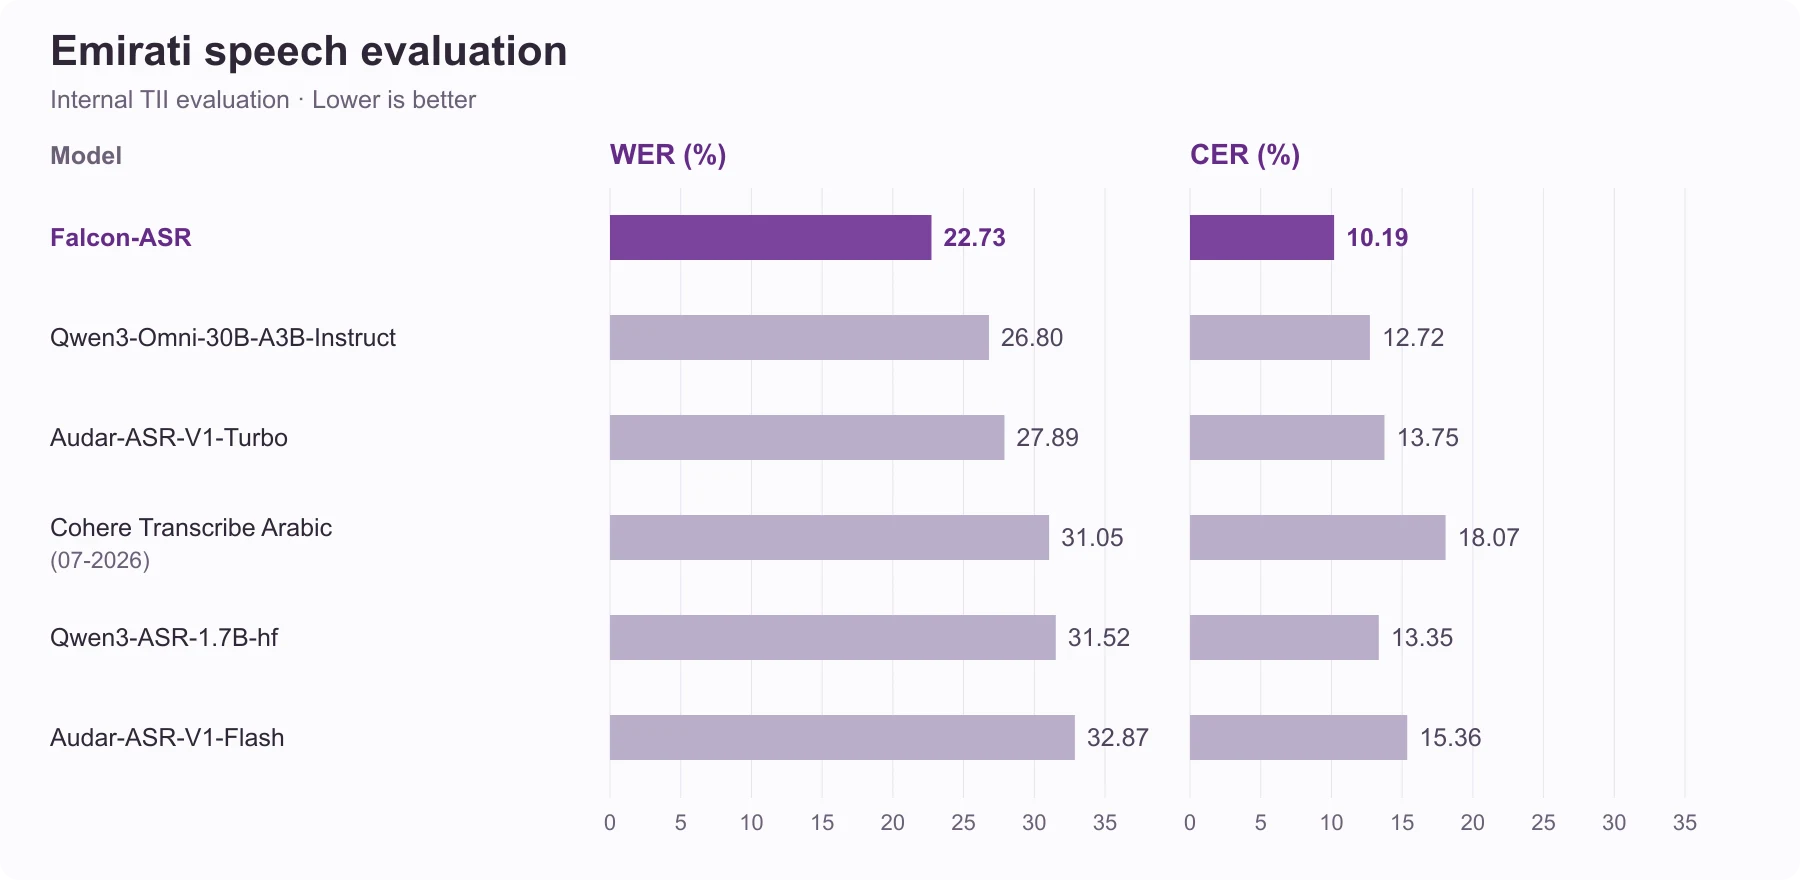
En nuestra evaluación interna de emiratí, Falcon-ASR alcanzó un 22.73% de WER y un 10.19% de CER:

Falcon-ASR tiene el WER y el CER más bajos entre los sistemas comparados aquí. Su WER es 4.07 puntos porcentuales inferior al de Qwen3-Omni, el siguiente mejor resultado. Los resultados muestran una mejor precisión de transcripción tanto a nivel de palabra como de carácter en esta evaluación.
Entrenamiento para diferentes condiciones de grabación
Incluimos ruido de fondo, habla superpuesta, música, reverberación de sala y efectos de telefonía, así como variaciones de velocidad y tono. Aplicamos el mismo tratamiento a las grabaciones en emiratí, exponiendo el modelo a una gama de condiciones que puede encontrar en reuniones, llamadas y otras grabaciones cotidianas.
Inglés y otros idiomas
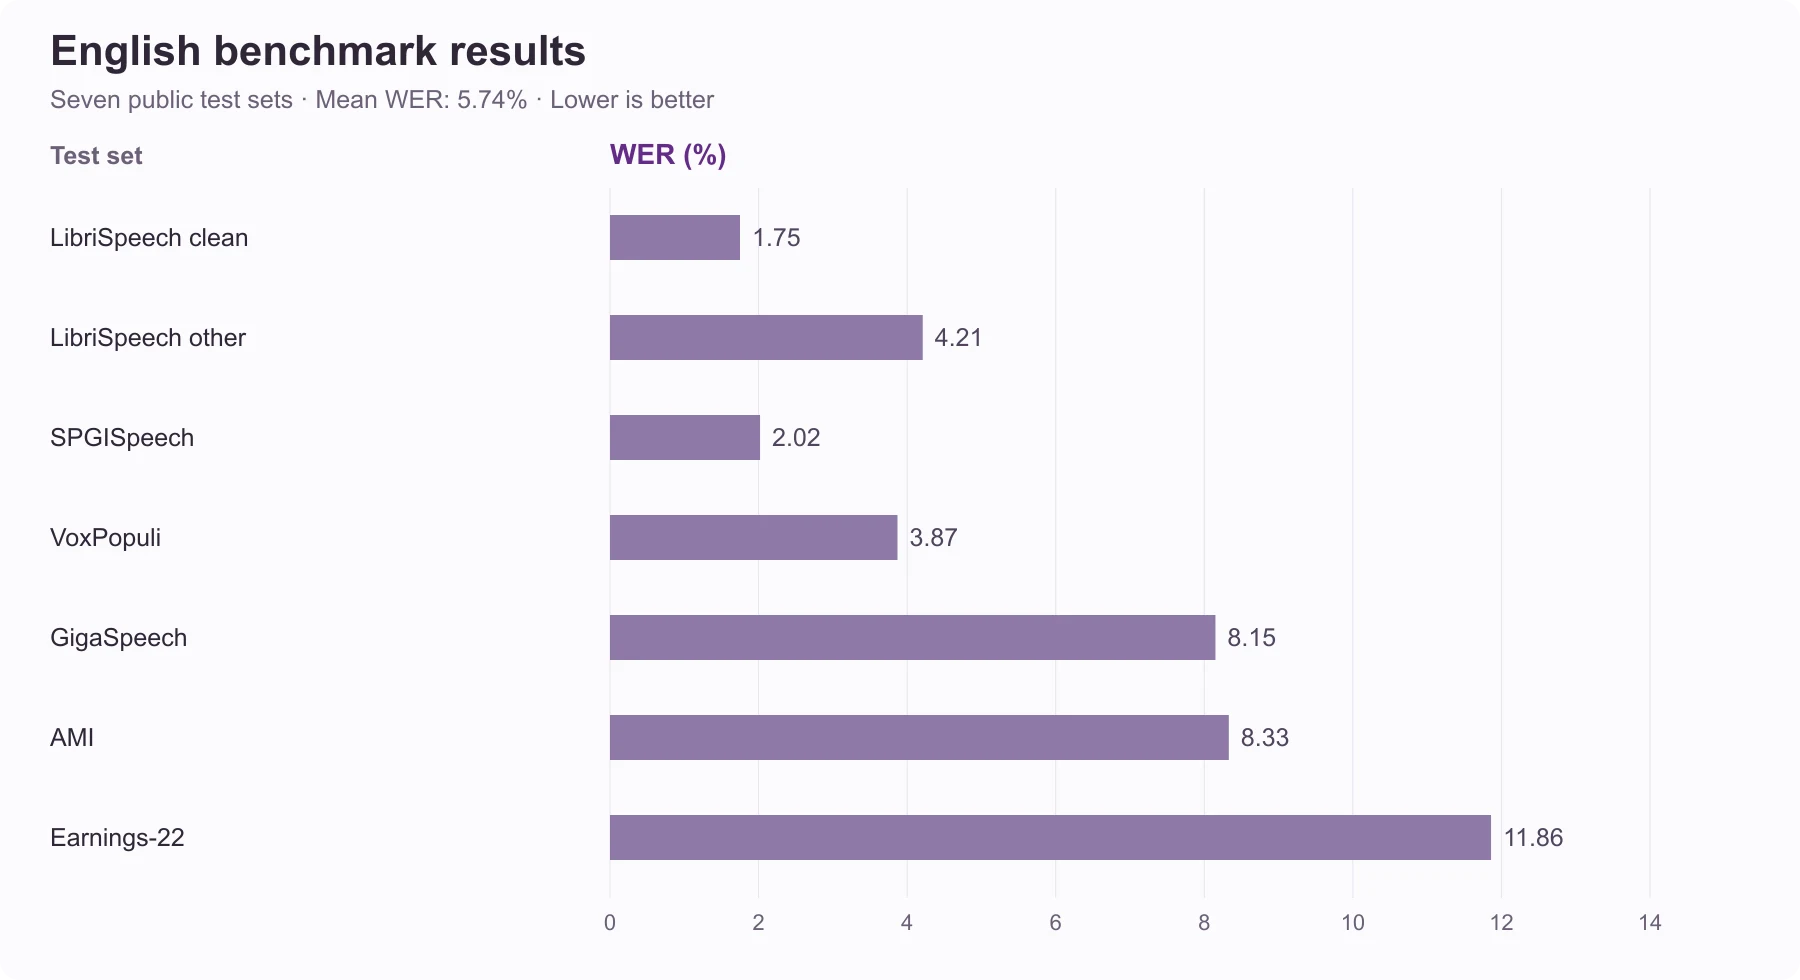
Falcon-ASR también transcribe inglés con los mismos pesos del modelo. En nuestra evaluación en los siete conjuntos de prueba públicos de inglés utilizados por el Hugging Face Open ASR Leaderboard, logró un WER medio de 5.74%.

El modelo también admite francés, español y portugués. Los cinco idiomas usan los mismos pesos, sin necesidad de una bandera de idioma. La salida es una transcripción en el idioma hablado.
Base del modelo
Falcon-ASR se basa en nuestro trabajo Falcon3-Audio. La arquitectura y el enfoque de entrenamiento de Falcon3-Audio se describen en Modelos de audio-lenguaje competitivos con un entrenamiento de una sola etapa eficiente en datos sobre datos públicos.
Prueba Falcon ASR
Nuestro Hugging Face Demo Space te permite probar Falcon-ASR y explorar sus capacidades de transcripción. El acceso por API y las aplicaciones nativas están previstos. Te invitamos a probar la Demo con tus propias grabaciones.
Agradecimientos
Agradecemos al equipo detrás del modelo Falcon-Emirati su apoyo con los modelos fundacionales en árabe. Lea sobre su trabajo más reciente en la entrada del blog Falcon-Emirati.
También extendemos nuestro sincero agradecimiento a Mikhail Lubinets por su apoyo continuo con la infraestructura de cómputo.
نقدّم Falcon ASR
نقدّم Falcon-ASR، نموذجنا للتعرف على الكلام العربي بحجم 1.6 مليار معلمة، مع اهتمام خاص باللهجة الإماراتية. طوّرنا النموذج في معهد الابتكار التكنولوجي (TII) في أبوظبي، وهو يدعم أيضًا اللغات الإنجليزية والفرنسية والإسبانية والبرتغالية.
في تقييمنا، حقق Falcon-ASR متوسط معدل خطأ في الكلمات بلغ 20.92% عبر ست مجموعات اختبار باللغة العربية، مقارنةً بأفضل نتيجة منشورة بلغت 23.17% في نسخة لوحة المتصدرين التي استخدمناها. وفي تقييمنا الداخلي للهجة الإماراتية، سجّل النموذج أدنى معدلات خطأ في الكلمات والأحرف بين الأنظمة التي قارناها.
ندعم أيضاً الطوابع الزمنية على مستوى الكلمات في عمليات التفريغ النصي، بحيث ترتبط كل كلمة بموضعها في التسجيل الصوتي.
التعرف على العربية المنطوقة
يختلف الكلام العربي باختلاف المنطقة والمتحدث وظروف التسجيل. فقد ينجح نموذج في تفريغ نشرة إخبارية رسمية، ثم يجد صعوبة في تفريغ محادثة باللهجة الإماراتية أو تسجيل عبر الهاتف. كما أن الموارد الصوتية المفرّغة نصيًا للهجات العربية أقل من تلك المتاحة للعربية الفصحى، مما يزيد صعوبة التدريب والتقييم.
درّبنا Falcon-ASR على اللهجة الإماراتية والعربية الفصحى ولهجات خليجية وعربية أخرى، إلى جانب الإنجليزية. وهدفنا هو تفريغ الكلمات التي يستخدمها الناس في حديثهم اليومي، بما في ذلك الصيغ اللهجية والانتقال بين اللغات.
نتائج الاختبارات العربية
ترتّب لوحة المتصدرين المفتوحة الشاملة للتعرف على الكلام العربي، التي يديرها مركز ELM للأبحاث، الأنظمة وفق متوسط معدل خطأ الكلمات عبر ست مجموعات اختبار، بوزن متساوٍ لكل مجموعة. وتعرض أيضًا معدل خطأ الأحرف (CER). وكلما انخفضت قيمة أي من المقياسين، كان الأداء أفضل. ويتبع تقييمنا للنموذج هذا البروتوكول.
WER هو معدل خطأ الكلمات؛ وCER هو معدل خطأ الأحرف. تشير القيمة الأقل إلى أداء أفضل.
قيّمنا Falcon-ASR على مجموعات الاختبار الست نفسها، باستخدام قوائم العينات المثبّتة في لوحة المتصدرين. وأرقام النماذج المنافسة هي المتوسطات المنشورة في اللوحة، والتي جرى التحقق منها في 30 سبتمبر 2026. وكان متوسط خطأ الكلمات للنموذج أفضل بمقدار 2.25 نقطة مئوية من أفضل نتيجة منشورة في تلك النسخة.
تقييم اللهجة الإماراتية
تتوافر بالفعل بيانات عامة لتقييم اللهجة الإماراتية، إذ تضم مجموعة Casablanca قسمًا خاصًا بالإمارات. ونكمّل هذه التغطية بتقييم داخلي لتسجيلات إضافية من الكلام الإماراتي والخليجي، باستخدام تسجيلات مخصّصة للاختبار ونصوص مرجعية خضعت لمراجعة بشرية، لتقييم دقة التفريغ على مواد إضافية إلى جانب البيانات الإماراتية العامة.
حقق Falcon-ASR في تقييمنا الإماراتي الداخلي معدل خطأ كلمات قدره 22.73٪ ومعدل خطأ أحرف قدره 10.19٪:
سجّل Falcon-ASR أقل معدل لخطأ الكلمات والأحرف بين الأنظمة المقارَنة هنا. وكان معدل خطأ الكلمات أقل بمقدار 4.07 نقطة مئوية من Qwen3-Omni، صاحب النتيجة التالية. وتُظهر النتائج تحسنًا في دقة التفريغ على مستوى الكلمات والأحرف في هذا التقييم.
التدريب على ظروف تسجيل مختلفة
ضمّنا بيانات التدريب ضوضاء خلفية وكلامًا متداخلًا وموسيقى وصدى الصوت وتأثيرات الاتصالات الهاتفية، إلى جانب تغيّرات في سرعة الكلام وحدّة الصوت. وطبّقنا المعالجة نفسها على التسجيلات الإماراتية، لتهيئة النموذج للتعامل مع ظروف مختلفة قد يواجهها في الاجتماعات والمكالمات والتسجيلات اليومية الأخرى.
الإنجليزية واللغات الأخرى
يفرّغ Falcon-ASR الكلام الإنجليزي باستخدام أوزان النموذج نفسها. وفي تقييمنا على مجموعات الاختبار الإنجليزية العامة السبع المستخدمة في لوحة Hugging Face المفتوحة للتعرف على الكلام، بلغ متوسط معدل خطأ الكلمات 5.74٪.
يدعم النموذج أيضًا الفرنسية والإسبانية والبرتغالية. وتستخدم اللغات الخمس أوزانًا واحدة، دون الحاجة إلى تحديد اللغة مسبقًا. ويكون الناتج تفريغًا نصيًا باللغة المنطوقة.
أساس النموذج
يستند Falcon-ASR إلى أعمالنا في Falcon3-Audio. وتعرض ورقة Modelos de audio-lenguaje competitivos con entrenamiento eficiente en datos en una sola etapa sobre datos públicos بنية Falcon3-Audio ونهج تدريبه.
Prueba de Falcon ASR
permite nuestra demo en Hugging Face probar Falcon-ASR y explorar sus capacidades de transcripción de voz. El acceso mediante API y aplicaciones nativas está previsto. Les invitamos a probar el modelo con sus propias grabaciones.
Agradecimientos
Expresamos nuestro sincero agradecimiento al equipo que desarrolló el modelo Falcon-Emirati por su apoyo en el ámbito de los modelos fundamentales para el idioma árabe. Se puede consultar el trabajo más reciente del equipo a través de el artículo publicado sobre Falcon-Emirati.
Asimismo, agradecemos sinceramente a Mikhail Lubinets su apoyo continuo a la infraestructura informática.