
La semana pasada, quería una versión pequeña del reescritor de prompts que viene con Qwen-Image 2.1. El oficial es un modelo de 9B que necesita unos 20 GB de memoria y piensa durante miles de tokens antes de escribir un solo párrafo. En el Hub, solo encontré copias comprimidas de ese mismo modelo de 9B. Así que describí lo que quería a ML Intern, y al día siguiente tenía una versión de 0.8B que funciona en una CPU. Devuelve una salida válida el 99.7% de las veces y usa cerca de un cuarto de los tokens del maestro. El cómputo de todo el proyecto, incluido el etiquetado de 8,797 solicitudes de ejemplo por el modelo de 9B, ascendió a 16 USD.
A lo largo de los días siguientes, hice cinco modelos más de la misma manera. Cada uno empezó como un mensaje en HuggingChat con ML-intern activado, y cada uno terminó como un modelo público en el Hub con su evaluación en la tarjeta del modelo. ML-intern planifica el trabajo, me pide un presupuesto antes de gastar nada, ejecuta una pequeña prueba antes del trabajo real, y luego entrena, evalúa y publica en el hardware de Hugging Face.
Cómo hago el prompt para ML Intern
El primer mensaje es donde invierto mi esfuerzo. Mi primer prompt, para el modelo citrus modelo compartido a continuación, tenía unas 450 palabras. Para mi 6.º proyecto ya rondaba las 2,000, porque cada proyecto me enseñó algo que quería incorporar al siguiente. Los siete prompts están en GitHub en yvrjsharma/ml-intern-prompts, exactamente como los escribí.
Un prompt empieza con la idea en una línea y por qué la quiero. Luego nombra las piezas exactas: el conjunto de datos, el modelo base, el script de entrenamiento. Todo lo que ya he verificado va bajo un encabezado que dice literalmente "Verified facts, do not re-derive", para que el agente gaste su presupuesto en el trabajo en lugar de redescubrir lo que ya sé. Para el LoRA de ángulos de cámara, esa sección indicaba qué entrenador acababa de añadir soporte para imágenes transparentes y qué issues abiertos de GitHub hacían arriesgado el entrenador de respaldo.
Dos líneas del prompt son críticas. La primera pide una línea base antes de cualquier entrenamiento. Por ejemplo, el citrus prompt dice: "Also report the base model's zero-shot score on the same metric before training so we can see the gain.". Sin ella obtienes un modelo entrenado y ninguna idea de si es mejor que con lo que empezaste. La segunda es una prueba de humo con una comprobación adjunta. Para los LoRAs de imagen pedí 50 pasos de entrenamiento y luego una comprobación de que los pesos guardados realmente habían cambiado, antes de pagar la ejecución completa.
Al final del prompt, expongo los entregables esperados y limito el costo. Defino qué debe ir en la tarjeta del modelo e incluyo una instrucción como: "Cap total spend at USD 12 and ask me before exceeding it.". Como ML-intern comienza cada tarea con un presupuesto de cero dólares y necesita permiso antes de ejecutar trabajos pagados, este límite de gasto se mantiene estrictamente aplicado. Cuando omites un presupuesto, el agente sugiere un par de caminos según el tamaño del proyecto y pregunta cuál prefieres.
No necesariamente necesitas todo eso en tu primer intento. Por ejemplo, no tenía la sección de hechos verificados en mi briefing de citrus y ML Intern aun así produjo un modelo que más que triplicó la precisión del Qwen3.5-2B modelo. Permíteme contarte 6 cosas que construí con Ml-Intern en solo un par de días.
1. Un modelo que conoce tu campo
Un modelo de visión general puede describir una hoja de cítricos amarillenta. Sin embargo, decirte si se trata de un problema de ácaros o de una deficiencia de magnesio, y los remedios biológicos y no biológicos para tratar la planta es muy difícil. Usando Claude, armé un conjunto de datos de entrenamiento combinado a partir de tres fuentes alojadas por la Project-AgML organización en el Hub. El resultado citrus-disease-vlm-instruct es un conjunto de datos que contiene 3,017 imágenes anotadas de 21 plagas, enfermedades, deficiencias nutricionales y enfoques de tratamiento distintos. ML-intern se encargó del fine-tuning de Qwen3.5-2B usando estos ejemplos, asegurándose de evaluar previamente el modelo base.
En las 335 fotos de prueba, el modelo base identificó el problema correcto el 14.9% de las veces. Tras dos épocas en una A10G, el modelo afinado alcanzó el 52.8%. Costo de cómputo: unos USD 1.90.
Echa un vistazo: Modelo · Dataset · App Citrus Doctor
2. Un modelo que dibuja tu personaje
Los modelos de imagen conocen a muchos personajes. Huggy, dibujado al estilo plano de los recursos de marca de Hugging Face, no era uno de ellos. Pedí a ML-Intern un LoRA en FLUX.2 klein base 4B, entrenado con 84 dibujos con leyendas del dataset Chunte/huggy_for_training .
El agente guardaba un checkpoint cada 100 pasos y dibujaba el mismo conjunto de prompts con cada uno, lo que hizo fácil la elección. El paso 200 fue el primero en el que Huggy estuvo completamente on-model. A partir del paso 500, el estilo de Huggy empezó a contaminar prompts que no tenían nada que ver con Huggy. El LoRA entrenado también funciona en el modelo klein destilado a 4 pasos. Costo de cómputo: unos USD 7.60.
Echa un vistazo: Model · Dataset · Huggy Generator App
3. Un modelo que hace un truco nuevo
- Los LoRA de ángulo de cámara se encuentran entre los complementos comunitarios más apreciados de los modelos Qwen-Image anteriores. Puedes darle al modelo una imagen de un objeto y pedirle verlo a 45 grados desde la izquierda. Cuando revisé unos días después del lanzamiento del modelo Qwen-Image 2.1, nadie había hecho uno, así que encargué a ML-intern construirlo.
ML-intern renderizó 1,030 objetos domésticos escaneados de Google Scanned Objects a 24 ángulos cada uno, 24,722 imágenes transparentes, en un trabajo de CPU que costó unos centavos. Después finalizó 461 objetos para entrenamiento y 40 reservados para pruebas, y 1,844 pares de antes y después del entrenamiento repartidos uniformemente entre 23 instrucciones de cámara.
El entrenamiento realizó 2,000 pasos en unos 90 minutos en una A100 (~USD 3.75). Todo el proyecto llevó alrededor de medio día y 48 trabajos, contando los que fallaron por paquetes faltantes o rutas incorrectas y que ML-Intern tuvo que reenviar. Costo total de cómputo: unos USD 16.
Echa un vistazo: Model · Dataset · Viewpoint Orbit App
- Doodle-in LoRA es otra idea genial. Sube una foto con un garabato magenta y añade un prompt breve que nombre un objeto. El LoRA reemplaza el garabato con ese objeto manteniendo la iluminación y la composición originales de forma consistente.
No existía un dataset para esto, así que mi prompt describía cómo crear uno. Partir de una foto real de Open Images, eliminar un objeto con el modelo de inpainting LaMa, y dibujar un garabato donde estaba el objeto. La foto sin modificar es el objetivo. ML-intern escribió y probó los scripts de construcción de pares en un sandbox de CPU, y luego los ejecutó como trabajos de GPU, registrando el autor y la licencia de cada foto de origen en el proceso. Construyó 6,042 pares de entrenamiento y un conjunto de pruebas de 160 pares, donde 40 de los pares de prueba provienen de 23 clases de objetos excluidas por completo del entrenamiento.
Antes del entrenamiento, midió el modelo base por sí solo y con el Viggle turbo LoRA, y comprobó que ejecutar las ediciones en lotes producía imágenes idénticas, lo que abarató la evaluación. El entrenamiento realizó 2,000 pasos en 1 hora 38 minutos en una A100 (~USD 4), y una comparación de los checkpoints guardados en 48 pares de prueba eligió el paso 500.
Combinado con el Viggle turbo LoRA a 6 pasos, el LoRA funcionó muy bien. 67.5% de objetos detectados donde fueron dibujados, a 4.7 segundos por edición. Los objetos de las 23 clases no vistas aparecieron con tanta fiabilidad como el resto (65.0% frente a 64.2%). El proyecto llevó algo más de un día y 59 trabajos. Costo total de cómputo: unos USD 24.
Echa un vistazo: Modelo · Dataset · App Doodle-in
4. Un modelo que se adapta a tu dispositivo
- El Pocket Rewriter al principio de esta publicación es el primero. ML-intern comenzó generando 8,797 solicitudes cortas de imágenes con un pequeño modelo instruct a través de Inference Providers, siguiendo una mezcla establecida en mi prompt: fotos, pósteres, logotipos, infografías y más, aproximadamente un tercio de ellas pidiendo texto exacto entre comillas, y muchas en idiomas distintos del inglés. El profesor de 9B luego reescribió todas en una A100 en 2 horas 37 minutos (~USD 6.50). Después de filtrar por calidad, se seleccionaron 1,840 ejemplos para el dataset de entrenamiento.
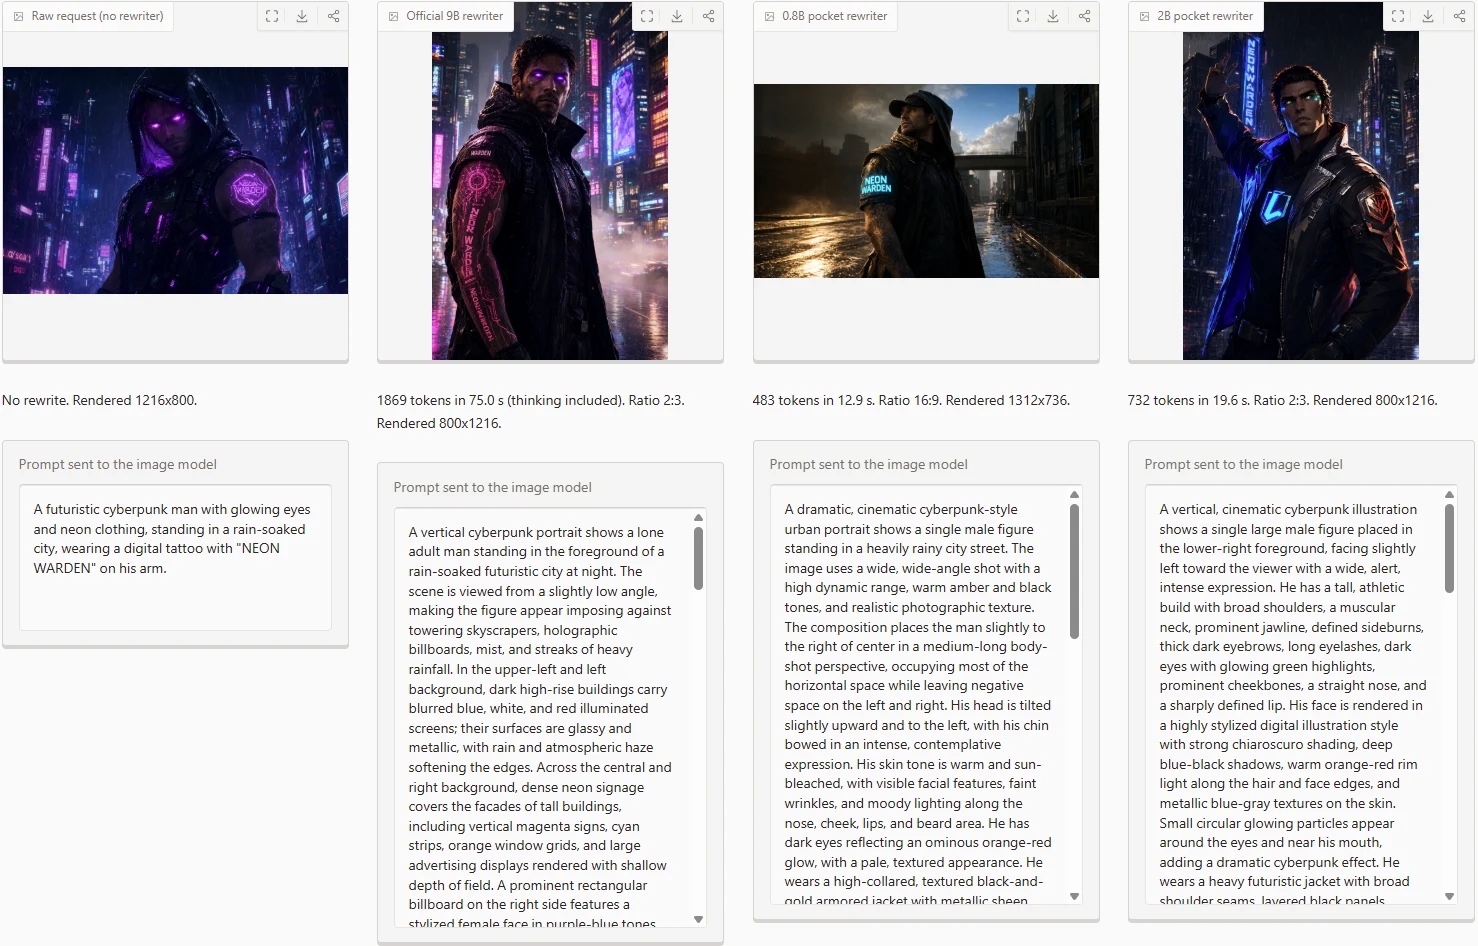
Entrenar a los estudiantes de 0.8B y 2B tomó 12 y 18 minutos en una A10G (USD 0.75 por ambos). El de 0.8B también se distribuye como un archivo GGUF de 812 MB para ejecutarse en una CPU. El proyecto tomó unas 11 horas y 24 trabajos. Costo total de cómputo: unos USD 16.
Echa un vistazo: Pocket rewriter 0.8B Student · 2B Student · Dataset · Pocket Studio App · Compara el teacher-student en Rewriter Arena
- Agate-Preview-002-4step es el segundo. Agate Preview 002 de Logolabs es un modelo texto-a-imagen de 260M de parámetros, lo bastante pequeño para un navegador, pero necesita 50 pasos con guidance, es decir, 100 pasadas de red por imagen. ¡Le pedí a ML-intern que lo destilara a solo 4 pasadas!
Tomó dos ejecuciones. La primera almacenó en caché 155,000 imágenes de entrenamiento como latentes, horneó el guidance en el modelo y luego redujo el número de pasos por etapas de 16 a 8 a 4, todo en A100s. El estudiante de 4 pasos superó a la ejecución del teacher con los mismos 4 pasos en GenEval y FID; después de eso, ML-intern lo exportó a ONNX para el navegador. Esta ejecución tomó unas 13 horas y USD 22.
Hice una segunda ejecución de entrenamiento pidiéndole a ML-Intern que mejorara un poco más el estudiante de 4 pasos. Entonces generó 24,000 pares de imágenes adicionales con el teacher a 16 pasos y ajustó finamente el estudiante de 4 pasos contra ellos durante alrededor de una hora. GenEval pasó de 0.509 a 0.536, frente al 0.563 del teacher a 50 pasos, con solo 4 pasos (un cuarto del cómputo). ML-intern reexportó la versión para navegador. La segunda ejecución tomó unas 8 horas. El costo total de cómputo entre ambas ejecuciones fue de unos USD 37.
Echa un vistazo: Modelo Agate de 4 pasos · Dataset · Ejecuta Agate en tu navegador · Agate 4-step LIVE
Lo que costó
| Modelo | Modelo base | Cómputo |
|---|---|---|
| Citrus Doctor | Qwen3.5-2B | USD 1.90 |
| Huggy LoRA | FLUX.2 klein base 4B | USD 7.60 |
| Pocket rewriter (0.8B y 2B) | Qwen3.5-0.8B y 2B | USD 16.05 |
| Viewpoint Orbit LoRA | Qwen-Image 2.1 | USD 16 |
| Doodle-in LoRA | Qwen-Image 2.1 | USD 24,30 |
| Agate de 4 pasos (dos ejecuciones) | Agate Preview 002 | USD 37 |
| Total | alrededor de USD 103 |
Estos son los cargos de trabajos de GPU y CPU informados para cada sesión.
Haz el tuyo
ML-intern está en HuggingChat. Activa el modo ML-intern y pega un prompt. Si quieres un punto de partida, mis prompts de ejemplo son libres de copiar. Parte de un modelo que desees que exista y un conjunto de datos que tengas, o uno que puedas describir. Dale un presupuesto pequeño, pide una línea base y una prueba de humo, y lee lo que devuelve antes de subir el límite.
Si creas algo con él, compártelo en X y etiqueta a @Gradio y @HuggingFace. Nos encantaría ver los modelos que hagas que nadie más pensarían en construir por ti.