
Por Yunzhong, desde Aofeisi
QbitAI | Cuenta oficial de QbitAI
Se empuja un tablón y el pasaje queda cerrado; se coloca una rampa y la pared alta se vuelve superable.
Cada acción cambia el mundo, y el mundo cambiado se convierte en el punto de partida de la siguiente decisión del agente.
Cuando ese mundo puede construirse con código y dibujarse en tiempo real mediante modelos de difusión, la IA dispone de un «campo de pruebas» que puede explorar una y otra vez: actuar directamente, observar las consecuencias, verificar hipótesis y llevar la experiencia a la siguiente ronda.
Esto es AgentGarten, el último lanzamiento del equipo MirroS. Conecta un entorno de código ejecutable con un renderizador neuronal en tiempo real: el código define las reglas físicas y el modelo genera la retroalimentación visual, con un rendimiento de más de 30 fps que permite a los agentes interactuar continuamente con el mundo.
En el clásico experimento del escondite, los cambios se produjeron rápidamente. El escondite aprendió en la ronda 4 a mover el tablón para construir un refugio, y el buscador dominó en la ronda 10 usar la rampa para saltar el muro. Tras fallar un salto, el buscador acercó activamente la rampa, ajustó su posición y lo intentó de nuevo.
Lo que impulsa la evolución de estas estrategias es el «manual de experimentos» que los propios agentes escriben.
Al final de cada ronda, revisan sus intentos, registran sus hallazgos y anotan sus dudas; en la siguiente ronda, continúan explorando con esa experiencia.
El código hace que el mundo funcione, el renderizado en tiempo real hace que el mundo sea visible, y el entrenamiento continuo permite acumular experiencia.
AgentGarten conecta los tres elementos en un circuito cerrado para explorar una pregunta mayor:
Cuando los agentes disponen de un mundo donde actuar, equivocarse y acumular experiencia, ¿cómo seguirá evolucionando la inteligencia en él?
Blog completo: https://mirros.ai/blog/worlds-for-evolving-agents
Informe técnico: https://mirros.ai/report/agent-garten.pdf
Código: https://github.com/MirroS-Lab/AgentGarten
Página del proyecto: https://mirros-lab.github.io/agent-garten
Lo que les falta a los agentes es un mundo donde entrenar una y otra vez
Si se quiere que la IA comprenda realmente el mundo físico, mostrarle grandes cantidades de videos está lejos de ser suficiente. Igual que no se puede aprender a nadar solo viendo grabaciones, el agente debe «bajarse al campo»: tomar acciones, observar los resultados reales y decidir el siguiente paso.
Esto requiere un entorno con certeza causal física: la caja empujada debe permanecer en su lugar, el pasaje bloqueado debe quedar intransitable, y todos los actos posteriores deben estar continuamente restringidos por esos cambios físicos.
Las dos rutas tecnológicas dominantes actuales tienen cada una sus limitaciones:
Los entornos tradicionales de motores de código/videojuegosofrecen estados precisos y reglas transparentes; cada colisión física queda perfectamente clara.
Pero su punto débil son los gráficos: los escenarios construidos de forma procedimental suelen ser solo geometrías blancas toscas con texturas repetidas. Lograr que cientos o miles de escenarios abiertos tengan una calidad fotorrealista de luces y sombras exige una inversión en modelado artístico e ingeniería que es una cifra astronómica.
Los modelos del mundo centrados en la generación de video(como los grandes modelos de video) pueden, ciertamente, generar imágenes de alta definición sorprendentes y producir fotogramas siguientes a partir de las acciones.
El problema es que la información física queda completamente oculta de forma implícita en la memoria de la red neuronal, sin ofrecer un estado explícito que se pueda consultar e intervenir. Si quieres ver cuánta agua queda en el vaso, hacer que un brazo robótico apriete un tornillo o establecer un conjunto estricto de reglas de arbitraje de tareas, en una simple caja negra de video es casi imposible avanzar.
La solución de MirroS se manifiesta así:que cada uno haga su trabajo: la física se encomienda al código, y las luces y sombras al modelo neuronal.
El código impulsa el mundo, el modelo se encarga de «cómo se ve»
En AgentGarten, un ciclo de interacción estándar funciona así:
El agente emite una instrucción de acción; el entorno de código calcula de inmediato las colisiones físicas y las actualizaciones de estado, y desde la perspectiva de la cámara en primera persona del agente, exporta un «bosquejo geométrico» ligero (es decir, profundidad espacial o normales de superficie);
Luego, el renderizador neuronal lee ese bosquejo geométrico y, combinándolo con la memoria visual previa, renderiza al instante el siguiente fotograma fotorrealista y se lo entrega al agente.
△Figura 2|Flujo cerrado entre el entorno de código y el renderizador neuronal. El agente emite una instrucción de acción, el mundo de código actualiza el estado y exporta las condiciones geométricas, y el renderizador neuronal genera en tiempo real la siguiente observación visual.
Esta división del trabajo trae consigo dos saltos cualitativos:
Primero, las reglas físicas siempre son "deterministas y controlables".
La disposición de las escenas, la detección de contactos y el resultado de los juegos son todos decididos por el código, sin generar ninguna "física alucinatoria".
Segundo, construir un mundo completamente nuevo se vuelve extremadamente rápido.
En el pasado, construir 100 entornos de simulación realistas requería un equipo artístico profesional para modelar, aplicar texturas e iluminar, con un costo tan alto que resultaba inasumible. En cambio, en AgentGarten, siempre que se pueda generar un simple contorno de profundidad tridimensional y normales, cualquier escena de código minimalista puede aplicarse directamente a este renderizador neuronal, obteniendo instantáneamente iluminación y materiales realistas. Vuelo con traje de alas, manipulación de brazos robóticos, cocina en la cocina y carreras de múltiples vehículos comparten la misma interfaz visual subyacente: el costo de expandir los entornos virtuales pasa, por primera vez, de ser "intensivo en trabajo artístico" a ser "expansión programática mediante código".
△Figura 3|Mundos físicos diversos en tareas cruzadas. Abarcan navegación espacial, manipulación de objetos, regrabación de movimiento de cámara e interacción entre múltiples vehículos. A la izquierda, el modelo blanco simple exportado por el código; a la derecha, los visuales realistas generados en tiempo real por el renderizador.
Más crucial aún, este renderizador esde generación en streaming: el agente da un paso en la acción, se dibuja un segmento de imagen, y solo cuando el agente ve con claridad el resultado toma la siguiente decisión; la interacción fluye de verdad de manera continua como en el mundo real.
Revisitando el escondite: 25 millones de rondas y 4 rondas
El mundo ya está construido; lo que hay que ver ahora es el agente: al actuar y revisar repetidamente en un mundo así, ¿puede mejorar por sí solo cada vez más?
Una referencia clásica es el experimento del escondite de OpenAI de 2019: los que se escondían y los buscadores competían en un campo con barreras y rampas, y tras una masiva auto-competencia aprendieron sucesivamente a construir refugios y a escalar muros usando las rampas.
El equipo de MirroS rehízo este experimento en AgentGarten, con una configuración de uno contra uno: el que se esconde prepara primero la escena, y luego le toca entrar al buscador.
Las reglas del enfrentamiento son claras y puras: el que se esconde prepara primero la escena bloqueando las entradas, y después entra el buscador a buscar. Los agentes controlan el movimiento y la manipulación escribiendo código Python, decidiendo únicamente según las imágenes generadas ante sus ojos, sin saber nada de las coordenadas espaciales ni de la posición del oponente.
Ambos parten de manuales completamente en blanco, y cada uno mantiene una biblioteca de estrategias compuesta por habilidades individuales. Cada enfrentamiento consiste en diez rondas, tras las cuales se hace un balance para consolidar lo aprendido, y en la ronda siguiente se seleccionan aleatoriamente partes de la biblioteca de habilidades para aplicarlas.
Pronto, aquellas estrategias clásicas de competencia emergieron sucesivamente en pocas rondas: mover barreras para bloquear puertas, trasladar rampas para construir puentes, y tras fracasar al escalar el muro, acercar la rampa para reintentarlo.
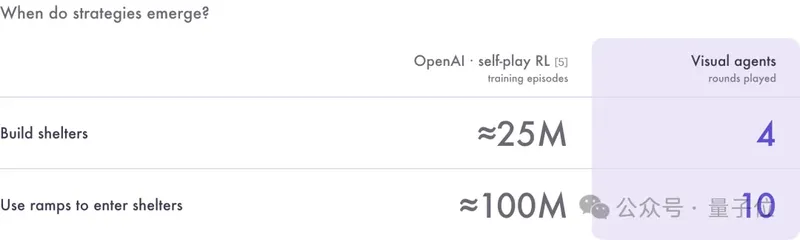
La investigación de 2019 se hizo famosa por la emergencia de estos comportamientos clásicos, y ofrece una comparación intuitiva (véase la figura 4): en aquel estudio, la IA, mediante aprendizaje por refuerzo desde cero, tardó alrededor de 25 millones de rondas en descubrir la construcción de refugios, y alrededor de 100 millones de rondas en aprender a saltar muros usando las rampas.
En cambio, en AgentGarten, los agentes, frente a imágenes visuales en primera persona, revisan y revisan sus manuales textuales entre rondas: el que se esconde aprendió a construir refugios en la ronda 4, y el buscador dominó el escalar muros con rampas en la ronda 10.
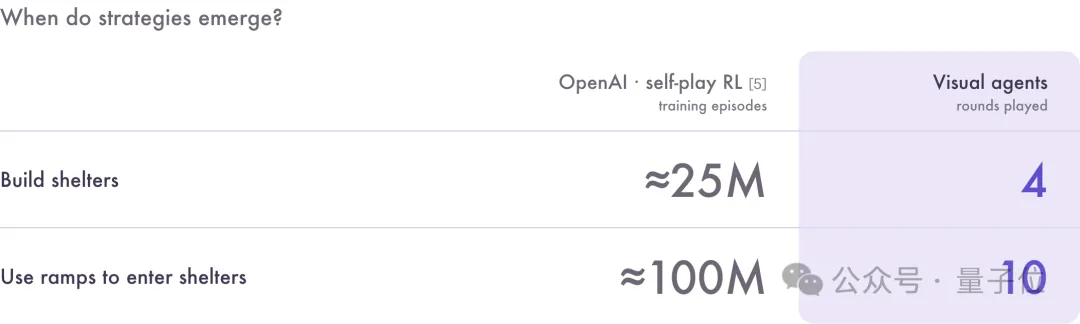
△Figura 4|Comparación de la escala de enfrentamientos necesarios antes de la aparición de estrategias representativas. La auto-competencia con RL entrena desde cero durante decenas de millones hasta cientos de millones de rondas sobre estados físicos privilegiados; el agente de MirroS actúa según imágenes renderizadas en primera persona y, mediante la reflexión ronda a ronda del manual, domina rápidamente las estrategias correspondientes en pocas rondas.
Aprender jugando y anotar, escribiendo la experiencia
El rápido progreso en Hide-and-seek depende de un flujo de entrenamiento universal.
El enfoque de MirroS es:dejar que el agente mismo "tome notas con sus manos". Todo lo que aprende lo escribe en manuales.
El entrenamiento se divide en cuatro etapas rigurosas y progresivas:
- Recibir la tarea: se recibe un documento de tarea que define el objetivo de la acción y las reglas rojas, pero sin ninguna respuesta estándar.
- Prueba y error a ciegas: actuar de manera autónoma bajo estrictos límites de pasos y tiempo. Solo hay imágenes de cámara, sin coordenadas divinas, sin mini-mapas, y sin ver la puntuación hasta el final.
- Escribir el manual: al terminar una ronda, hacer una autoevaluación y registrar honestamente: qué se intentó, qué fenómenos se observaron, qué juicios son dudosos y qué nuevas hipótesis habría que verificar la próxima vez.
- Archivar y heredar: el manual se archiva y congela, y se entrega directamente como herencia a priori al agente de la siguiente ronda.
Al hojear estos manuales escritos por los agentes, se descubre que tienen un marcado aire de indagación científica. El modelo distingue rigurosamente entre "lo observado en la realidad" y "las conjeturas imaginadas", y además anota deliberadamente para los sucesores guías para evitar trampas:
- El que se esconde resumió una verdad práctica: "la defensa consiste en bloquear los pasajes, no solo en obstruir la línea de visión", advirtiendo a los sucesores que aprovechen los ángulos muertos para reducir las brechas, y que prueben el efecto de bloqueo con pequeños desplazamientos;
- El buscador dedujo una ley de control: "antes de mover un objeto, tira de él un poco primero; no confundas atasco con agarre firme": al acercarse, pulsa primero la tecla de microtirón y observa si el objeto se desplaza respecto a los puntos de referencia de la habitación, para así comprobar si realmente lo ha agarrado;
- La advertencia de un conductor que cruza el puente es aún más aleccionadora: "que el disco objetivo se deslice hacia el punto ciego del frontal del coche no significa que el vehículo haya llegado ya a salvo”。
Las experiencias que superan la prueba son adoptadas por los sucesores, mientras que las lecciones fallidas los impulsan a intentar nuevas ramas de estrategia.
El mismo bucle, repetido en cuatro mundos diferentes
Hide-and-seek es solo un comienzo. Como el mundo del código es esencialmente un entorno de software programable, el mismo bucle de "explorar—repasar—consolidar" puede replicarse con facilidad en muchos más escenarios complejos.
El equipo ejecutó cuatro rondas de simulación en otros cuatro mundos completamente distintos:
- Acompañar al cachorro: el agente debe mantener, en 60 segundos, el afecto del cachorro acariciándolo con la mano y jugando a la pelota en el momento adecuado. La puntuación pasó de 13 puntos en la primera ronda a 19 puntos en la ronda 4.
- Cruce en un puente estrecho: dos vehículos negocian mutuamente el paso desde la perspectiva de conducción en primera persona, cruzándose en el menor tiempo posible en una vía estrecha de un solo carril para intercambiar los extremos. El tiempo total de ambos vehículos para completar el paso se redujo drásticamente de 71 segundos a 41 segundos.
- Pastoreo cooperativo: dos perros pastores colaboran con precisión solo con su propia visión para meter a cuatro ovejas en el corral y mantenerlas allí durante 5 segundos. De la ronda 1, en la que se agotó el tiempo y solo metieron tres ovejas, se pasó a lograr de forma estable en las tres rondas siguientes meterlas todas, «sin dejar ni una».
- Cargadora de cantera: la cargadora pesada debe empujar piedras, alimentar el material y almacenarlo. En la ronda 1 apenas lograba empujar las piedras, pero para la ronda 4 ya completaba todo el proceso con limpieza, con 31 segundos de antelación dentro del límite de 360 segundos.
Estas tareas de una amplitud tan grande demuestran lo mismo: este bucle cerrado de acumulación de experiencia también funciona en mundos radicalmente distintos.
Cómo hace la imagen para seguir la acción: cómo se logran 30 fotogramas por segundo en una sola tarjeta
Para que el agente pueda «mirar y actuar» en el mundo virtual, el renderizador neuronal debe superar tres grandes obstáculos que han perseguido durante mucho tiempo al video generativo:seguir el ritmo de las acciones repentinas, mantener la estabilidad en interacciones ultralargas y, además, ejecutarse lo bastante rápido。
El equipo de MirroS partió de un modelo fundamental omnomodal y propuso el método de entrenamientoAdversarial Forcing, que, junto con la optimización de la inferencia, abrió este canal visual:
1. De la generación completa fuera de línea a la renderización por bloques en flujo
Los modelos de vídeo solían generar el vídeo completo de una sola vez; AgentGarten lo transformó en una generación por bloques en flujo. El agente realiza una acción, el modelo produce de inmediato el bloque corto de imagen correspondiente, y tras ver el resultado toma la siguiente decisión.
2. Interacción de largo alcance sin deriva (reproducción exacta)
Cuanto más tiempo dura la generación continua, más fácil es que pequeños errores se acumulen en una deriva de apariencia. Muchos modelos cortan el grafo de cómputo histórico para ahorrar memoria de vídeo, por lo que los gradientes no pueden retropropagarse hacia la memoria histórica; si en una segunda pasada se recalcula toda la secuencia de manera uniforme, las mínimas diferencias en el orden de ejecución subyacente introducen errores de varios puntos porcentuales.
El equipo diseñó un mecanismo de reproducción exacta: en la primera pasada se despliega hacia adelante sin gradientes y en la segunda se vuelve a ejecutar con gradientes siguiendo exactamente el mismo ritmo por bloques, reproduciendo con precisión la trayectoria de inferencia y estabilizando la consistencia temporal de la interacción con secuencias largas.
3. Introducción de vídeo real adversarial: evitar la degradación de la imagen y los artefactos
Si solo se usa la destilación de puntuación con muestras generadas por el propio modelo, la inferencia prolongada tiende a distorsionarse y a aparecer artefactos en forma de rejilla.
El equipo introdujo en el entrenamiento un discriminador de vídeo real para construir la señal adversarial, tomando la calidad física real como ancla, lo que restringe la textura de la imagen y, a la vez, hace que los resultados generados se ajusten estrictamente a los contornos geométricos dados por el código.
4. Mantener una interacción en tiempo real de más de 30 fps
El equipo escribió a mano operadores fusionados personalizados de Triton, eliminó los viajes de ida y vuelta a la memoria de vídeo y evitó la espera de arranque en frío de varios minutos de la compilación tradicional de grafo completo; combinado con CUDA Graph para eliminar la sobrecarga de planificación de la CPU y con un decodificador ultraligero con una latencia inferior a 10 milisegundos, finalmente sostuvo de forma estable la interacción en bucle cerrado con una resolución de 480p y un rendimiento superior a 30 fps.
Preparar mundos que puedan ser vividos para agentes en evolución continua
El código ejecutable permite que los mundos de entrenamiento se generen de forma programática sin fin; el renderizador aprendido dota a esos mundos de una retroalimentación física realista y perceptible; el manual de experimentos acumulado convierte cada tanteo en un escalón para la siguiente ronda de exploración.
Combinando estas tres cosas, el agente dispone de un espacio donde realmente puede explorar, equivocarse y evolucionar.
Esta es precisamente la idea central con la que MirroS explora el Physical RSI (auto-mejora recursiva en el mundo físico).
El escalado de los modelos de lenguaje está en pleno auge, mientras que el escalado de la inteligencia en el mundo físico apenas comienza.
La verdadera inteligencia encarnada y universal requiere crecer continuamente a través de intercambios reales con el mundo físico:
que cada experiencia de lo desconocido se convierta en el punto de partida de la siguiente ronda de evolución.
Blog completo: https://mirros.ai/blog/worlds-for-evolving-agents
*Este artículo ha sido publicado por QbitAI con autorización; las opiniones pertenecen exclusivamente al autor original.