
Tian Yanlin, reportando desde Aofeisi (凹非寺)
Quantum Bit | Cuenta oficial de WeChat QbitAI
¡Vaya! ¿El equipo chino se ha lanzado directamente al primer puesto mundial en la赛道 de modelos de acción del mundo (WAM)?! Espera, "赛道" no debe quedarse en chino. Corrijo: "¡Vaya! ¿En la pista de los Modelos de Acción del Mundo (WAM), los equipos chinos se han lanzado directamente al primer puesto mundial?!"
Además, una serie de modelos encarnados líderes a nivel mundial, como GPT-6-Astra, π0.5 de Physical Intelligence y GR00T-N1.7 de NVIDIA, también quedaron atrás en esta ocasión.
Quien actúa es una empresa china de robótica:StarDance Era (Xingdong Jiyuan), la única empresa afiliada de robótica encarnada con participación accionarial de Tsinghua。
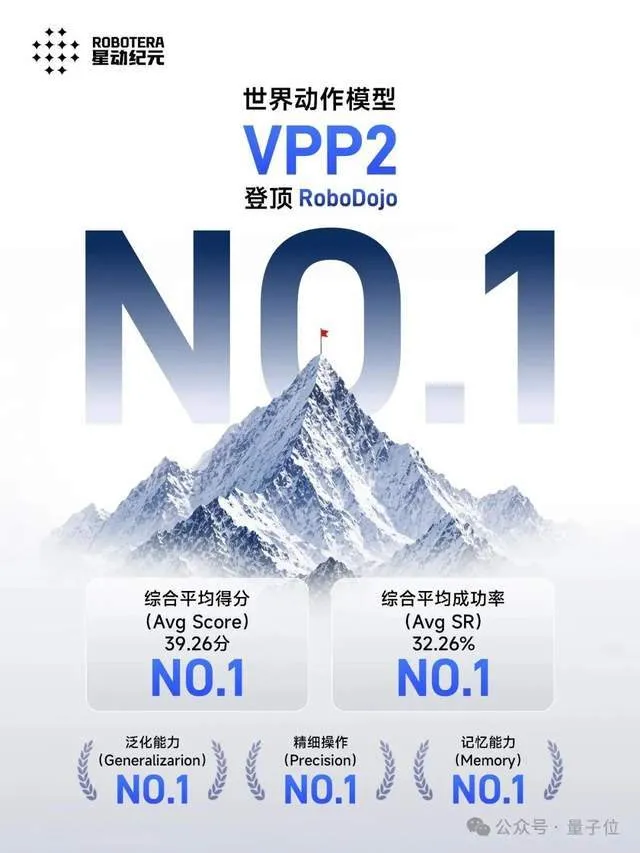
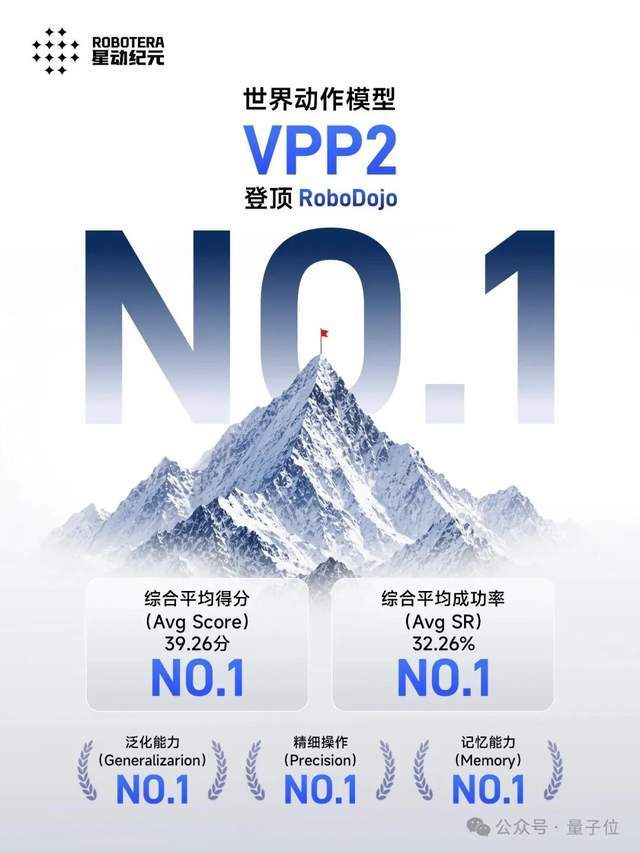
Recientemente, Xingdong Jiyuan (星动纪元)El modelo de acción mundial de desarrollo propio VPP2, alcanzó de un solo golpe la cima delranking de simulación RoboDojo。
con una tasa media de éxito general del 32.26% y una puntuación media general de 39.26 puntos, siendo primero en ambos indicadores.
La clave es que esta competición realmente no era fácil.
RoboDojo se autodenominael «Everest» de la inteligencia corporizada, liderado por el MMLab de la Universidad de Hong Kong y construido conjuntamente por cerca de 20 instituciones académicas de primer nivel de todo el mundo.
Se especializa en plantear problemas justo donde los robots no son buenos: si cambia el entorno, ¿seguirán sabiendo trabajar? Si los objetos están torcidos, ¿podrán agarrarlos con precisión? Si la tarea está a mitad, ¿recordarán lo que ocurrió antes?
En fin, no es tan fácil colarse confiando solo en la práctica repetitiva.
¿Y el resultado?
VPP2 de StarEra no solo obtuvo el primer puesto general, sino que también lideró encapacidad de generalización, manipulación fina y capacidad de memoria, tres dimensiones.
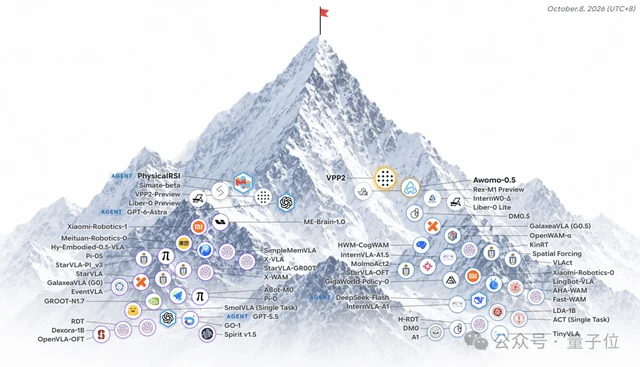
Según se dice, esta vez VPP2no añadió datos adicionalesniutilizó medios de mejora como Agent RSI,, y solo con el «conjunto de datos estándar»dejó atrás a toda una serie de expertos.
Esto demuestra que el modelo VPP2 en sí es lo suficientemente fuerte, que la mejora del rendimiento proviene del preentrenamiento y que la base es lo bastante generalizable, por lo que no depende de estrategias de mejora externas ni de «amañar puntuaciones» amplizando datos.
Oye, tío, ¿cómo se entrena exactamente un modelo tan potente???
Hurgamos en la hoja de ruta técnica y, la verdad, la ruptura de VPP2 esta vez sí que tiene sustancia.
Apunta a un viejo problema de los modelos de acción del mundo: si la predicción falla, la acción falla con ella.
La solución que propone VPP2 consiste primero en entrenar la capacidad de predicción de video hasta un nivel suficientemente fuerte, y luego dejar que el robot se mueva de verdad en entornos desconocidos.
De la predicción a la acción, ambas capacidades de generalización mejoran juntas.
Por los múltiples resultados de pruebas divulgados hasta ahora, VPP2 ya se ha convertido en uno de los competidores más fuertes de la categoría de modelos de acción del mundo (WAM).
El modelo de acción del mundo (WAM) corona un nuevo campeón en plena competencia
En la industria de la inteligencia encarnada hay un fenómeno bastante incómodo.
Las demos de robots son cada vez más espectaculares y las puntuaciones de los rankings de modelos cada vez más altas, pero si uno pregunta de verdad: ¿quién tiene el robot más inteligente, el que más trabaja?
La respuesta no es nada fácil.
Por ejemplo, pedir a un robot que agarre una taza. Sobre la mesa que vio durante el entrenamiento, puede acertar siempre. Pero con solo cambiar de taza o moverla un poco, empieza de inmediato a dudar de todo.
Y ni hablar de las tareas que requieren ejecutar múltiples pasos consecutivos.
Por eso es por lo que vale la pena prestar atención a este sistema de evaluación llamado RoboDojo.
Su objetivo es establecer un estándar de evaluación unificado y reproducible para la inteligencia encarnada, con pruebas en simulaciónque incluyen 42 tareas de manipulación bimanualy que cubren cinco dimensiones: generalización, manipulación de precisión, tareas de largo alcance, memoria y comprensión de instrucciones de vocabulario abierto.
En pocas palabras, se trata de sacar al robot de su zona de confort.
Los modelos robóticos tradicionales pueden acercarse a la puntuación perfecta en tareas conocidas, pero una vez que cambian el entorno, la posición de los objetos o la combinación de tareas, la tasa de éxito puede disminuir notablemente.
RoboDojo evalúa específicamente este tipo de situaciones complejas, para ver cuánta capacidad de generalización tienen los robots al enfrentar cambios.
Y el VPP2, en esta ocasión, ha presentado un balance bastante brillante.
Con una tasa de éxito promedio del 32.26 % y una puntuación promedio de 39.26 puntos, ambos indicadores ocupan el primer lugar.
Como comparación, en la evaluación de posentrenamiento del benchmark de simulación RoboDojo,GPT-6-Astraun promedio de éxito del 22.48% y una puntuación promedio de 28.97 puntos.
mientras queVPP2Superando por 9.78 puntos porcentuales y 10.29 puntos, respectivamente.
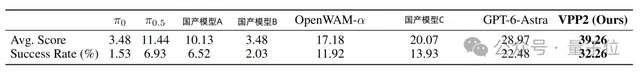
Captura de pantalla del artículo, los datos del modelo de referencia provienen de la tabla de clasificación oficial
Aquí, ambos indicadores tienen enfoques distintos: la tasa de éxito mide si el robot puede completar la tarea por completo; el puntaje promedio mide hasta qué punto avanzó la tarea, e incluso si no la logró terminar, refleja su desempeño en las etapas parciales.
Ambos indicadores combinan los resultados de las pruebas de cinco dimensiones de capacidades.
En otras palabras,VPP2 no solo completa una mayor proporción de tareas, sino que también muestra una mayor capacidad de finalización parcial en aquellas tareas que no llega a terminar.
Además, esta ventaja no se limita al puntaje general.
Al desglosar las cinco dimensiones de capacidades, VPP2 también obtiene el primer lugar en tres dimensiones: generalización, manipulación de precisión y memoria.
Estas tres capacidades corresponden a varios de los obstáculos que un robot debe superar para entrar al mundo real: si sigue funcionando al cambiar de entorno, si puede realizar operaciones con precisión y si puede recordar los pasos previos al ejecutar tareas de forma continua.
Ventaja en el puntaje general y también un buen rendimiento en las capacidades clave.
Sin embargo, por difícil que sea RoboDojo, el escenario de pruebas sigue siendo un «entorno simulado». Al llegar al mundo físico, la fricción, la deformación y las desviaciones de posición de los objetos generan nuevas variables.
La capacidad de generalización que VPP2 muestra en la simulación,¿seguirá siendo válida en el robot real?
Galaxea también realizó experimentos.
Esta vez, el equipo desplegó directamente VPP2en un robot real de doble brazo ALOHAy probó 10 tipos de tareas de manipulación zero-shot, como agarrar, colocar, apilar, plegar y verter.
Es decir, el robot tuvo que ponerse manos a la obra sin necesidad de un ajuste fino adicional para estas tareas de prueba.
Como resultado, VPP2 volvió a presentar resultados líderes:una tasa de éxito promedio del 58.5%, superior al 40% de π0.5.
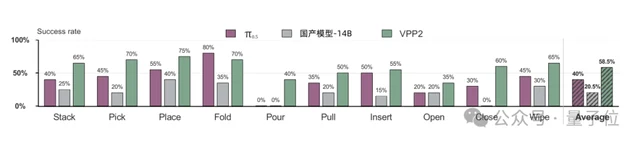
De los 10 tipos de tareas, VPP2 logró el mejor resultado en 9.
Esto se vuelve interesante.
El primer puesto del ranking demuestra su capacidad dentro de los sistemas de evaluación estandarizados; la operación de cero disparos en robots reales examina además si esas capacidades pueden transferirse a entornos físicos reales.
Al colocar las dos hojas de resultados una junto a la otra, las ventajas técnicas de VPP2 merecen aún más profundización.
Cabe señalar que VPP2 sigue la vía delmodelo de acción del mundo (WAM)。
La idea básica de este tipo de modelos es comprender, mediante la predicción de video, cómo cambiará a continuación el mundo físico, y luego convertir esa predicción en acciones del robot.
Pero esta vía ha tenido durante mucho tiempo un problema: que la predicción de video sea hermosa no significa que el robot realmente sepa trabajar.
Y precisamente VPP2 se lanzó esta vez contra ese problema.
De la generalización de la predicción a la generalización de la acción, ¿cómo lo logra VPP2?
Para entender el avance de VPP2, veamos primero una tarea sencilla: pedirle al robot que ponga un vaso de la mesa dentro de una caja.
Para un ser humano, extender la mano, agarrar, levantar y colocar requiere casi ningún esfuerzo de reflexión.
Pero el robot tiene que determinar la posición de la taza, la trayectoria del brazo mecánico, el momento en que la pinza debe cerrarse, y además predecir qué cambios ocurrirán en el mundo físico durante toda la operación. Cualquier desviación en un solo paso puede provocar un fallo.
Los modelos de mundo-acción (WAM) existentes son precisamente propensos a fallar en este punto.
Por un lado, los modelos de video comunes son buenos generando imágenes, pero que una imagen parezca razonable y que cumpla las leyes físicas reales son dos cosas distintas.
Por ejemplo, se le pide agarrar la taza de la izquierda, pero el modelo predice que agarra la de la derecha. El video se genera igual, pero cuando el robot lo ejecuta, se desvía por completo.
Por otro lado, incorporar directamente el aprendizaje de acciones al modelo de video puede dañar su capacidad de generalización original.
El resultado es que el robot aprende la acción, pero al cambiar de entorno ya no sabe hacerla.
VPP2 plantea un juicio muy directo:la calidad de la predicción de video determina el límite superior de la acción.
Basándose en esta idea, Xingdong Jiyuan (Robot Era) optó por entrenar por fases la predicción de video y el aprendizaje de acciones; el enfoque no es «cocinar video y acción en la misma olla», sino«desacoplarlos»y volver a«ordenarlos»。
Para ello, Xingdong Jiyuan diseñó unaestrategia de entrenamiento en tres fases:
- En la primera fase, se realiza un preentrenamiento continuado con video a nivel de eventos, para que el modelo aprenda a predecir el proceso completo de operación.
- En la segunda fase, se realiza un postentrenamiento y destilación con video de duración fija, para que la capacidad de predicción siga el ritmo de la ejecución en tiempo real del robot.
- En la tercera fase, se entrena un experto en acciones que convierte la predicción de video en acciones concretas, procurando al mismo tiempo conservar la capacidad de generalización original.
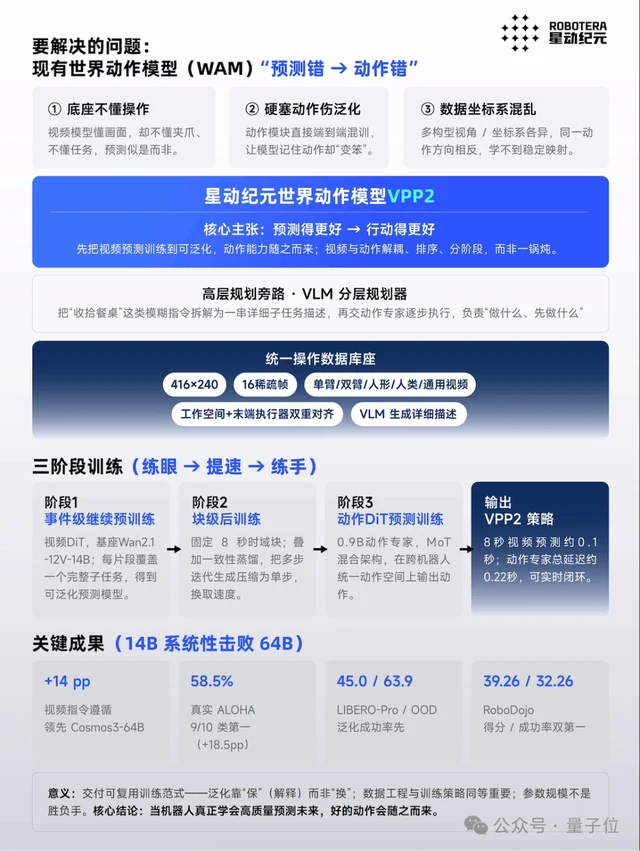
Las tres fases avanzan progresivamente y apuntan finalmente ados avances centrales: que la predicción pueda generalizar y que la acción también pueda generalizar.
Primer avance: dotar a la predicción de video de capacidad de generalización
Lo primero que VPP2 debe resolver es si el robot puede predecir con precisión los cambios físicos en tareas desconocidas.
Xingdong Jiyuan tomó como base Wan2.1-I2V-14B de código abierto de Alibaba, e integró datos de manipulación robótica, actividades humanas, video general y otros, cubriendo diferentes cuerpos de robot y formas de operación.
Sin embargo, lo realmente interesante es su procesamiento de los datos.
El equipo no simplemente alimentó al modelo con los videos en bloque, sino que primero dividió los procesos de operación en fragmentos semánticamente completos y les añadió descripciones detalladas.
Por ejemplo, no basta con decirle al modelo «pon la taza en la caja»; hay que especificar de qué brazo mecánico se trata, qué taza, qué caja, y todo el proceso de operación.
Porque una misma instrucción vaga puede corresponder a infinidad de trayectorias de acción.
Si el modelo ni siquiera tiene claro el objeto de la operación, naturalmente le resultará difícil predecir el futuro con precisión.
VPP2 simplemente describe la tarea con más detalle, de modo que las instrucciones lingüísticas y las operaciones físicas formen una correspondencia más estable.
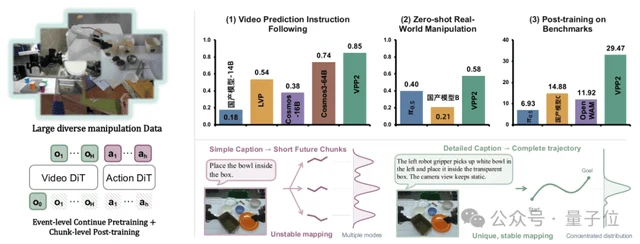
El paso más clave es el entrenamiento de predicción de video a nivel de eventos.
La predicción tradicional a corto plazo se centra en lo que ocurrirá en los siguientes fotogramas, mientras que VPP2 hace que el modelo aprenda directamente los cambios de una operación completa desde el inicio hasta el final.
Desde que el brazo mecánico se acerca a la taza, hasta que la agarra, y luego la coloca en la caja, lo que el modelo debe comprender es cómo ocurre todo un hecho completo.
De esta manera, ante objetos, posiciones o incluso tareas de manipulación nuevas, tendrá más posibilidades de predecir cambios físicos razonables.
En la prueba de seguimiento de instrucciones con videos de manipulación robótica,14B de parámetrosde VPP2 alcanza90%de éxito, mientras que el modelo Cosmos3 de 64B parámetros alcanzó un 78%.
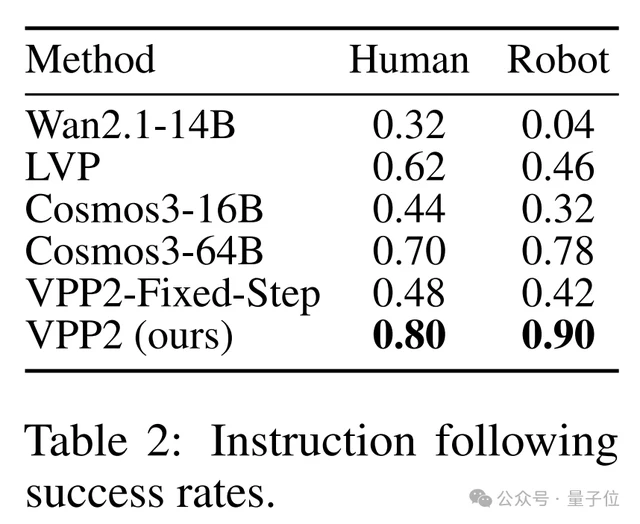
14B derrota a 64B.
Esto también demuestra que, en la predicción de operaciones físicas, la escala de parámetros no es el único factor decisivo; la capacidad de comprender verdaderamente el proceso de la operación es igualmente importante.
Sin embargo, por precisa que sea la predicción, de poco sirve si el robot no puede moverse.
Segundo avance: convertir la generalización de la predicción en generalización de la acción
Aquí hay dos obstáculos, uno esVelocidad, en segundo lugarCómo conservar la capacidad de generalización original del modelo de video mientras se aprenden los movimientos.
El primer obstáculo es fácil de entender. Si el robot tiene que trabajar generando un video durante varios segundos antes de cada movimiento, entonces ni la capacidad de predicción más potente resulta muy útil.
Xingdong Jiyuan eligió primero acelerar el modelo de predicción.
El equipo ajustó aún más el modelo de predicción a nivel de eventos para que predijera clips de video fijos de 8 segundos, y luego, mediante destilación de consistencia, comprimió el cálculo de múltiples pasos en una generación de un solo paso.
Al final, predecir los cambios visuales de los próximos 8 segundos toma unos 0.12 segundos de cómputo.
El segundo obstáculo es un poco más complicado.
Después de tanto esfuerzo por lograr que el modelo de video aprendiera a predecir tareas desconocidas, resulta que al incorporar el entrenamiento de acciones, el modelo solo sabe ejecutar operaciones familiares.
¿La capacidad de acción creció, pero se perdió la capacidad de generalización? Lo que VPP2 debe hacer es superar ambos obstáculos a la vez.
VPP2 introduce unDiT de acción de 0.9B parámetros(Action DiT),que adopta la arquitectura MoT, para aprender a generar movimientos del robot según los estados futuros predichos.
Sin embargo, Xingdong Jiyuan no entrenó desde cero el modelo de predicción de video (Video DiT) junto con el experto de acción.
Al inicio del entrenamiento de acciones, los parámetros base del modelo de video se congelaron y solo se adaptaron mediante LoRA, para evitar en lo posible que el entrenamiento de acciones dañara la capacidad de generalización predictiva ya existente.
Es como si primero se dejara que el robot entendiera cómo cambia el mundo físico, y luego se le entrenara para convertir esa «comprensión» en «acción».
Ambas capacidades crecen por etapas y se complementan mutuamente.
Al final, la predicción de video toma unos 0.12 segundos y el experto de acción unos 0.1 segundos,con una latencia total de generación de fragmentos de acción de aproximadamente 0.22 segundos.
Por supuesto, por más elegante que sea la arquitectura, hay que ver los resultados finales.
Laprueba zero-shot con el robot real ALOHAya mencionada ha mostrado el potencial de VPP2 para convertir la capacidad de predicción en operaciones de tareas desconocidas.
Otros dos conjuntos de pruebas de generalización validaron aún más este camino.
LIBERO-Proevalúa la capacidad de operación tras cambios en la posición de los objetos y en los requisitos de la tarea; VPP2 logró una tasa de éxito general del 45.0%, mientras que los mejores modelos base alcanzaron como máximo 11.0%.
LIBERO-OODevalúa la generalización combinatoria: recombina objetos, disposiciones y objetivos de tarea familiares para formar tareas nuevas nunca vistas antes.
VPP2 alcanzó una tasa de éxito general del 63.9%.
Vistos estos resultados en conjunto, la idea técnica de VPP2 queda clara.
Primero, mediante datos de múltiples fuentes, descripciones detalladas de tareas y entrenamiento con predicción a nivel de eventos, se logra que el modelo prediga los cambios físicos con mayor precisión.
Luego, mediante destilación para acelerar y aprendizaje de acciones por etapas, se convierte esa capacidad de predicción en operaciones reales, conservando en lo posible la capacidad de generalización original.
El límite superior del rendimiento de la inteligencia encarnada, evidentemente, aún no ha llegado al punto de depender solo de acumular escala por la fuerza.
VPP2 demuestra una vez más que,optimizar los conductos de datos y ajustar el paradigma de entrenamiento, estos métodos de ingeniería aparentemente sencillos,todavía tienen la oportunidad de aportar mejoras considerables en el rendimiento del modelo.
De GPT a WAM: la IA física está formando un nuevo paradigma
Que la predicción pueda generalizarse y que la acción también pueda generalizarse es el avance central más digno de atención de VPP2 como modelo de acción del mundo WAM.
Pero las tareas reales suelen ser más complejas. El robot no solo debe saber cómo hacer las cosas, sino también decidir qué hacer primero y qué hacer después.
Esto requiere que intervengan capacidades cognitivas y de planificación de nivel superior.
Aquí, Robot Era aportó una idea:GPT se encarga de pensar, VPP2 se encarga de hacer.
El primero se encarga de comprender, razonar y planificar, descomponiendo tareas complejas en pasos claros; el segundo se encarga de predecir cómo cambia el mundo físico y de convertir la planificación en acciones concretas.
Esta idea ya cuenta con un soporte experimental preliminar en el artículo de VPP2.
El equipo empleó en la práctica un planificador de alto nivel basado en VLM, encargado de la comprensión semántica, la memoria y la descomposición de tareas, y luego entrega las subtareas claras a VPP2 para su ejecución.
Los resultados son bastante intuitivos. En las pruebas de tareas de largo alcance seleccionadas en RoboDojo,tras introducir la planificación de subtareas con VLM, la tasa de éxito promedio pasó del 27.6% a57.6%。
Esto significa que, para que un robot complete tareas complejas, no basta con tener una potente capacidad de acción. La coordinación entre la planificación de alto nivel y la ejecución de bajo nivel también influye en el resultado de la tarea.
Siguiendo esta línea de razonamiento,GPT+VPP2podría dar lugar a unnuevo paradigma tecnológico de IA física: cognición general + ejecución física general.
Los modelos generales como GPT se encargan de comprender las intenciones, razonar y planificar, mientras que un WAM como VPP2 se encarga de predecir los cambios físicos y generar acciones, ajustándose continuamente mediante la retroalimentación de la ejecución.
Desde la cognición, la planificación y la predicción, hasta la ejecución y la retroalimentación, un bucle completo de IA física se va perfilando con claridad.
Y esto, a su vez, da al valor del WAM un margen de imaginación aún mayor.
La capacidad del modelo debe interactuar con el mundo físico a través del cuerpo, y el uso real expone fallos y genera retroalimentación, impulsando la mejora continua del modelo y del hardware.
Xingdong Jiyuan desarrolla simultáneamente el cerebro, el cuerpo y las manos diestras, y su estrategia de «full stack profundo» puede explicarse dentro de esta lógica:Lo que la empresa intenta dominar no es solo la fase de entrenamiento, sino también la fase de materialización de las capacidades y de retorno de la retroalimentación.
u1s1, por más elegante que sea la ruta técnica, al final hay que ir al mundo real a trabajar.
En este aspecto, Xingdong Jiyuan ya ha iniciado colaboraciones con empresas como China Post y SF Express, operando de forma regular en5 provincias y ciudades de todo el país y en más de 10 centros logísticos。
. En los escenarios logísticos, el tamaño de la mercancía, su ubicación y los procesos de trabajo pueden cambiar. Con la misma operación, al cambiar de almacén, el robot quizás tenga que readaptarse.
Esto también plantea exigencias más altas a la capacidad de generalización del robot.
Que el modelo pueda transferir lo aprendido a tareas desconocidas afecta directamente a la eficiencia y el costo de futuros despliegues en múltiples escenarios.
Por supuesto, el progreso de la comercialización de los negocios logísticos existentes no significa que VPP2 ya haya logrado un despliegue a gran escala. Que el modelo pueda funcionar de manera estable a largo plazo en más escenarios reales aún necesita verificación adicional.
Pero el resultado de VPP2 en esta ocasión ya ha emitido una señal que merece atención.
La competencia entre modelos de acción del mundo está pasando de predecir el futuro a convertir la predicción en acción general.
Al mirar retrospectivamente la cima alcanzada en RoboDojo, lo que merece atención ya no es solo un primer puesto.
De la simulación al robot real, de la generalización predictiva a la generalización de la acción, una serie de resultados experimentales de VPP2 indican que:el entrenamiento por fases de la predicción de video y el aprendizaje de acciones realmente puede mejorar la capacidad de manipulación del robot en tareas desconocidas.
Y a medida que los modelos cognitivos generales como GPT se integren más con los WAM, la IA física también podrá formar un sistema de capacidades más completo.
Al final, la próxima ronda de competencia en la inteligencia encarnada consiste en si los robots pueden llevar lo aprendido a más escenarios desconocidos.
Predecir con precisión es importante, pero también hay que poder hacerlo. Esa es la clave para que los modelos de acción del mundo avancen realmente hacia el mundo físico.
PD:VPP2 ya está disponible como código abierto,Los interesados pueden probarlo y reproducir los resultados del artículo.
Si de verdad obtienen alguna sorpresa al ejecutarlo, recuerden volver a contárnoslo~
1.Código abierto
: https://github.com/roboterax/video-prediction-policy-2
2.Página del proyecto:
https://robert-gyj.github.io/video-prediction-policy-2