
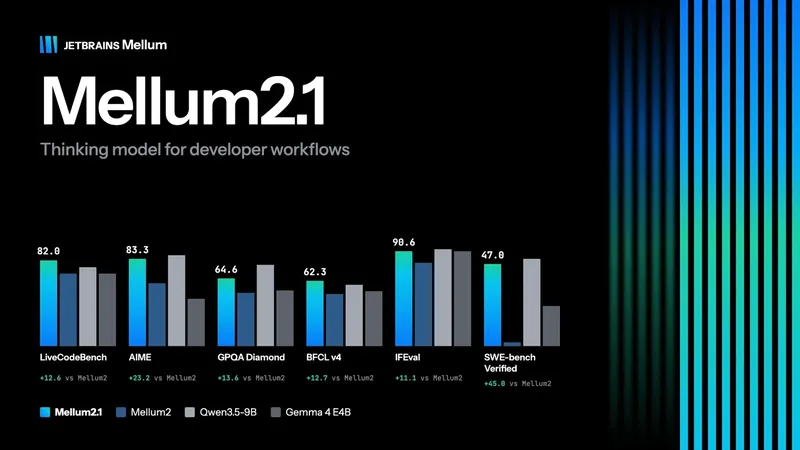
IT之家 El 9 de octubre, JetBrains publicó un artículo en su blog ayer (8 de octubre), anunciando la lanzamiento del modelo Mellum2.1, con el objetivo de mejorar significativamente las capacidades de programación de agentes inteligentes. Este modelo mantiene la arquitectura mixta de expertos de 12B de Mellum2, cuenta con 2.5B de parámetros activos y sigue siendo distribuido bajo la licencia Apache 2.0.
Mellum2.1 actualiza principalmente la etapa de aprendizaje reforzado después del preentrenamiento, expandiéndola desde los pasos finales a corto plazo hacia el cuerpo principal del entrenamiento, y añade datos de entrenamiento en tareas como matemáticas, competiciones de algoritmos, ciencia, uso de herramientas y ingeniería de software.
JetBrains ha establecido la infraestructura de entorno de aprendizaje refuerzo interno para este modelo, activando millones de cubos de prueba durante el entrenamiento, que abarcan miles de entornos. Además, antes del entrenamiento, el equipo seleccionó conjuntos de datos abiertos, eliminando tareas con defectos de prueba, respuestas no verificables y dificultades inapropiadas.
Después de la actualización, Mellum 2.1 puede explorar el repositorio de código, editar archivos y verificar sus propias modificaciones. JetBrains indica que la mejora más significativa se produce en el campo de la programación de agentes: el modelo puede identificar las causas de los tests fallidos, redactar soluciones de corrección y verificar los resultados.
En términos de rendimiento, la arquitectura Mellum2.1 es consistente con la de Mellum2, y la velocidad permanece igual. La predicción de múltiples tokens (MTP) mejora aún más la velocidad de respuesta. En escenarios de una única solicitud, la MTP aumenta su velocidad en aproximadamente 1.6 veces.
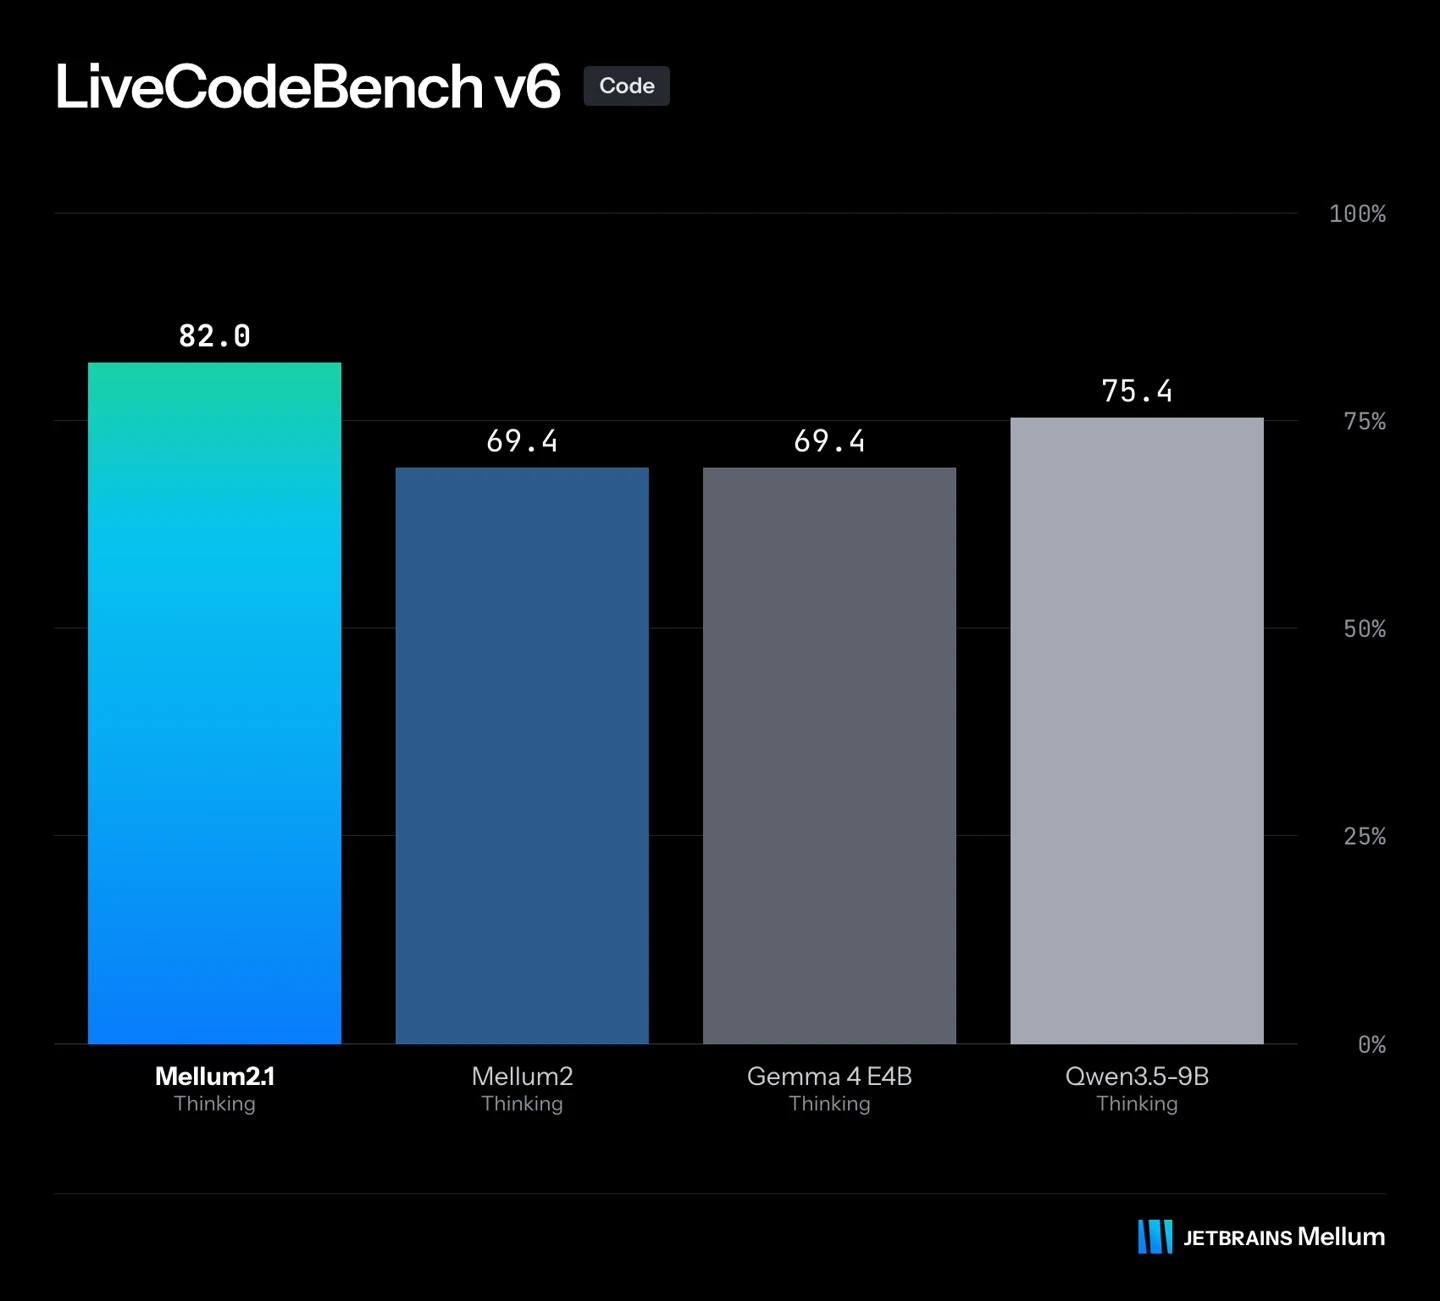
JetBrains compara Mellum2.1 con Mellum2, Qwen3.5-9B y Gemma 4 E4B en las mismas condiciones de evaluación. Los resultados muestran que en condiciones de carga alta, el consumo de tokens de razonamiento de Mellum2.1 es casi el doble del de Qwen3.5-9B, y hay mejoras en dimensiones como programación, competiciones de algoritmos, matemáticas, llamadas a herramientas y conocimiento general. IT Home adjunta las capturas de pantalla correspondientes de la siguiente manera:
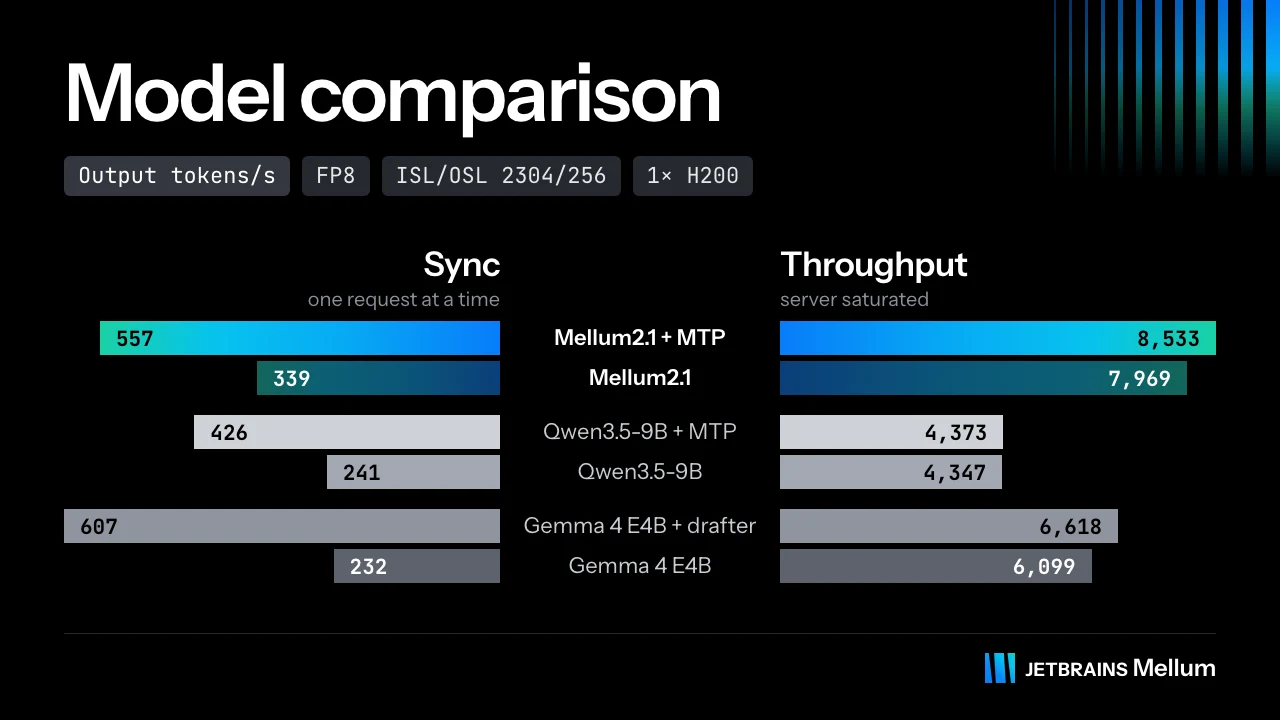
Mellum2.1 ya está disponible en Hugging Face, y admite el despliegue en infraestructura local o propia, permitiendo que las empresas guarden su código y datos en su entorno específico. Posteriormente, la versión oficial lanzará también versiones en formato GGUF para llama.cpp, Ollama y LM Studio, así como el componente de decodificación de suposiciones MTP de vLLM.