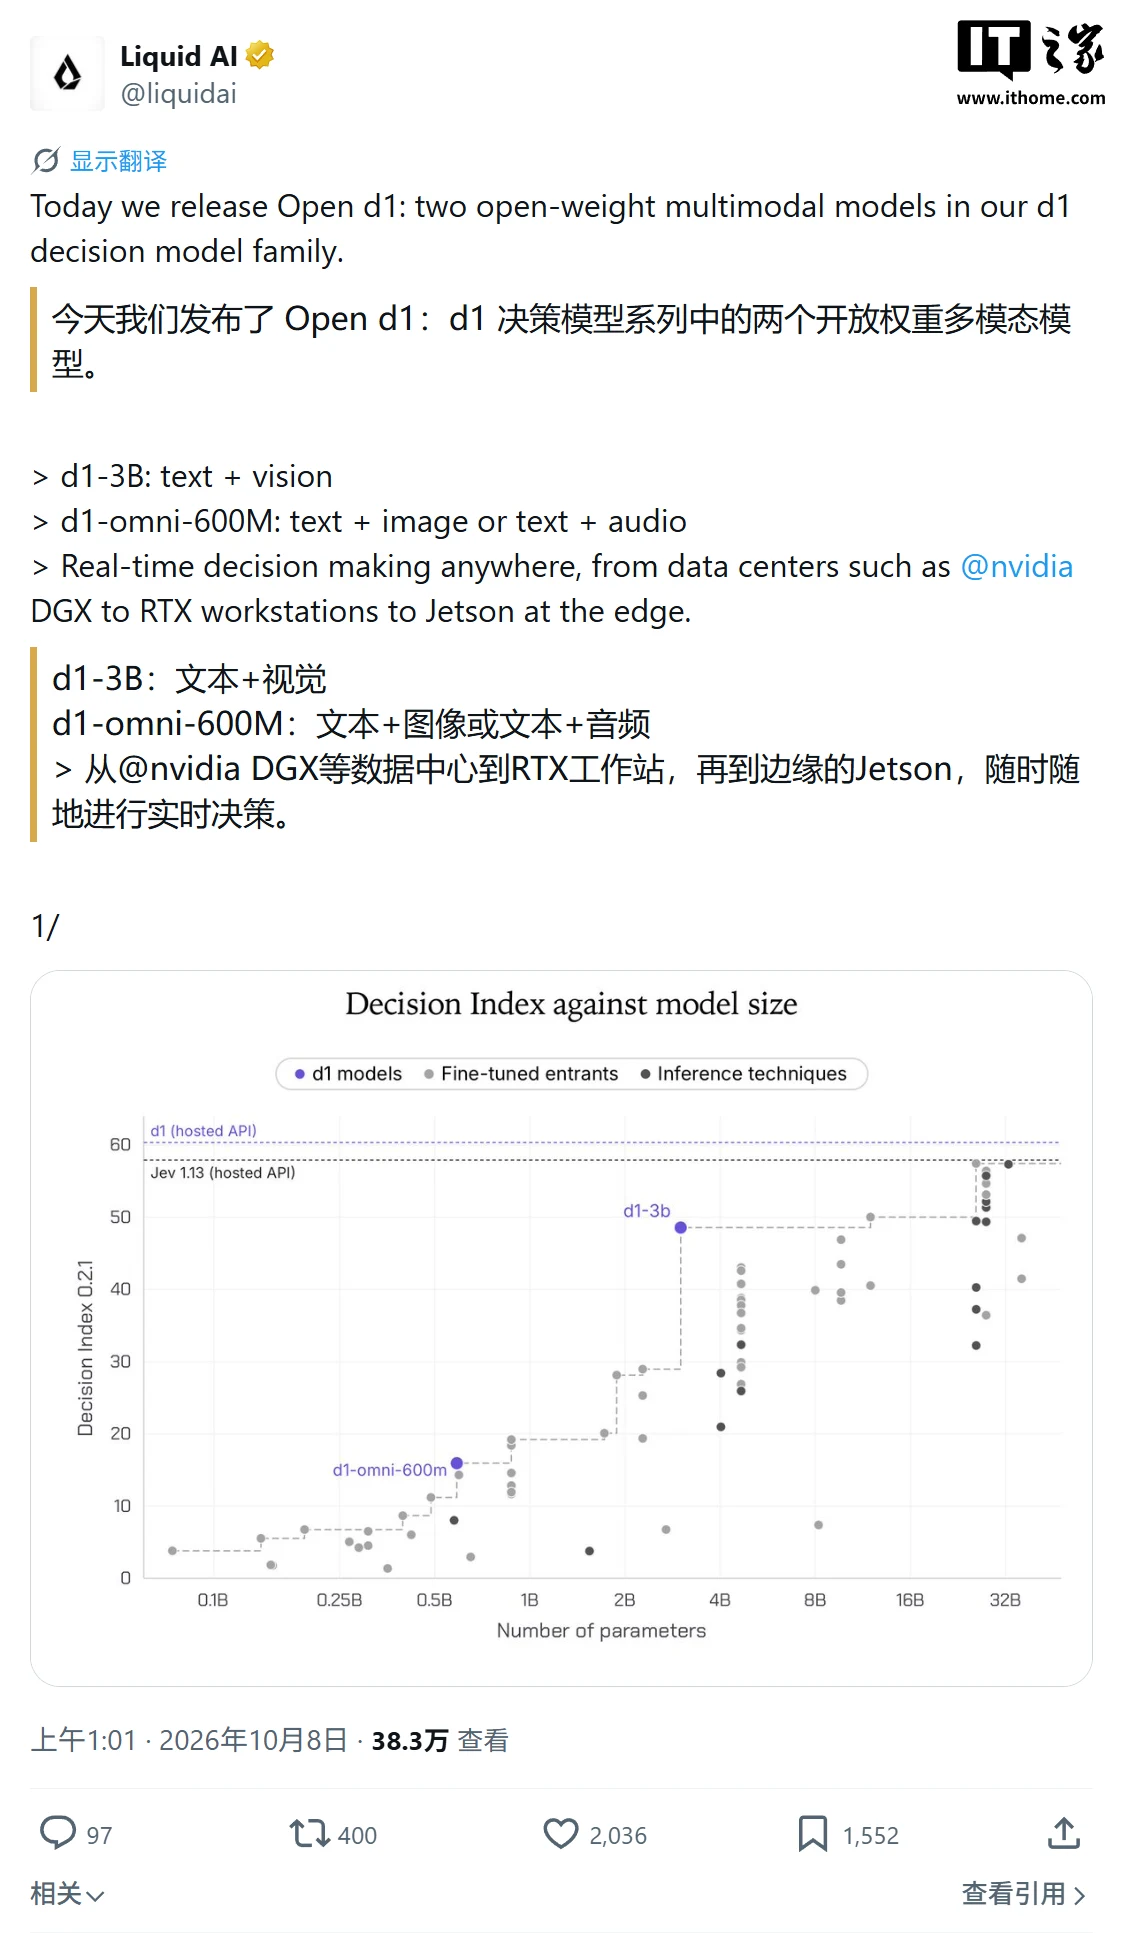
IT之家 Mensaje del 9 de octubre: Liquid AI publicó el 7 de octubre una entrada en su blog anunciando el lanzamiento de dos modelos de decisión de pesos abiertos de la serie d1: d1-3B admite juicios de texto e imágenes con 3.120 millones de parámetros,d1-omni-600M admite entradas de texto, imágenes y voz con 587 millones de parámetros.
Según la entrada del blog citada por IT之家,tras el lanzamiento explosivo del modelo Jev en septiembre,OpenAI y otras empresas también han lanzado modelos de decisión similares, y Liquid AI es el nuevo miembro que se une a esta batalla. d1-3B y d1-omni-600M ya están disponibles públicamente en Hugging Face, donde los usuarios pueden descargarlos, ajustarlos finamente y desplegarlos.
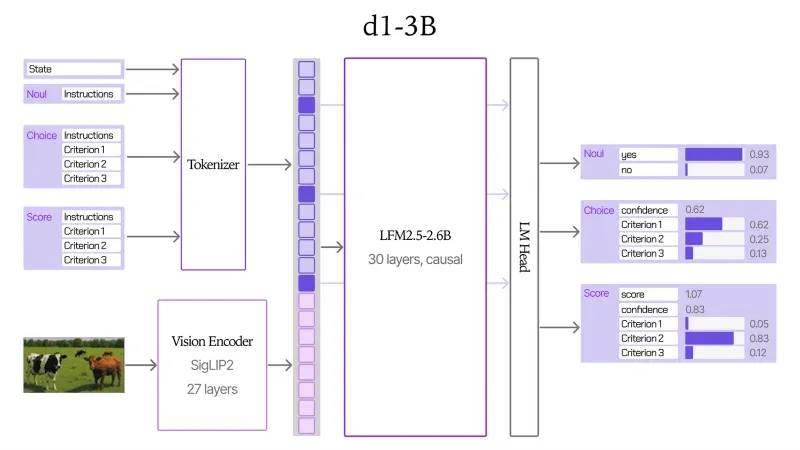
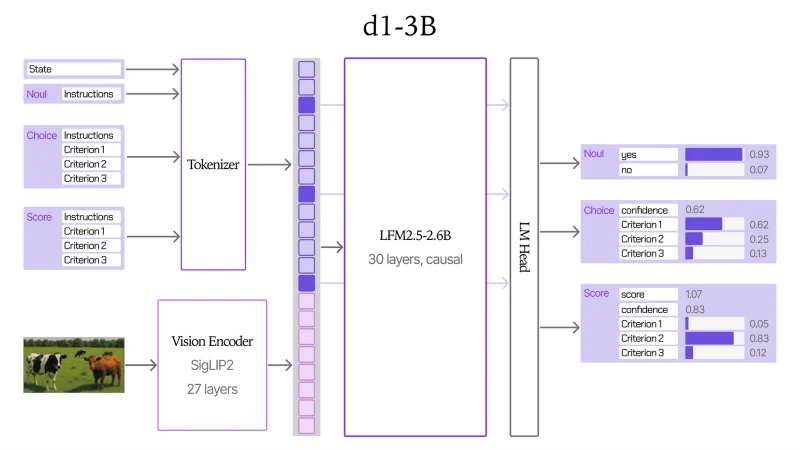
d1-3B tiene 3.120 millones de parámetros y está entrenado sobre el modelo de visión y lenguaje LFM2.5-VL-3B, admitiendo entradas de texto e imagen. El modelo obtuvo 48.57 puntos en el conjunto de pruebas público Decision Index v0.2.1, y Liquid AI afirma que supera a todos los modelos de menos de 10B.
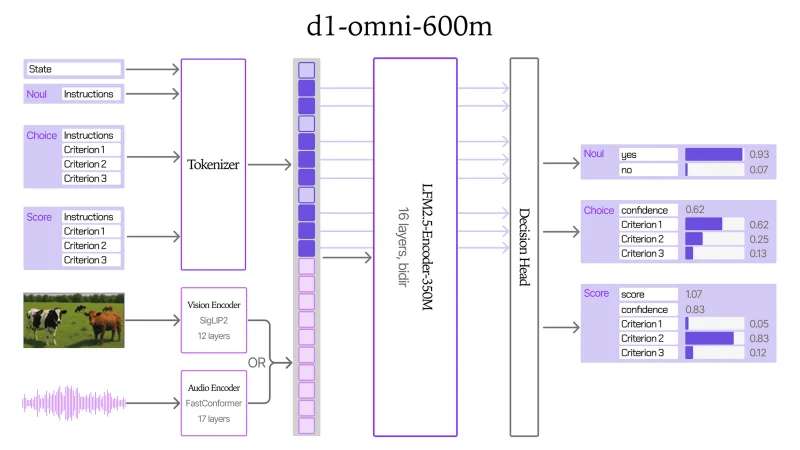
d1-omni-600M tiene 587 millones de parámetros y está entrenado a partir del codificador bidireccional LFM2.5-Encoder-350M. El modelo admite entradas combinadas de texto e imágenes, o de texto y voz, y constituye el primer punto de control experimental multimodal de modelos de decisión de Liquid AI.
En cuanto a la velocidad de inferencia, d1-3B tarda 8 milisegundos en responder una sola pregunta en una NVIDIA RTX 4090, y 102 milisegundos en procesar una imagen de 384 píxeles. En un Jetson AGX Thor, una sola pregunta tarda 16 milisegundos; en un Jetson Orin Nano, 50 milisegundos.
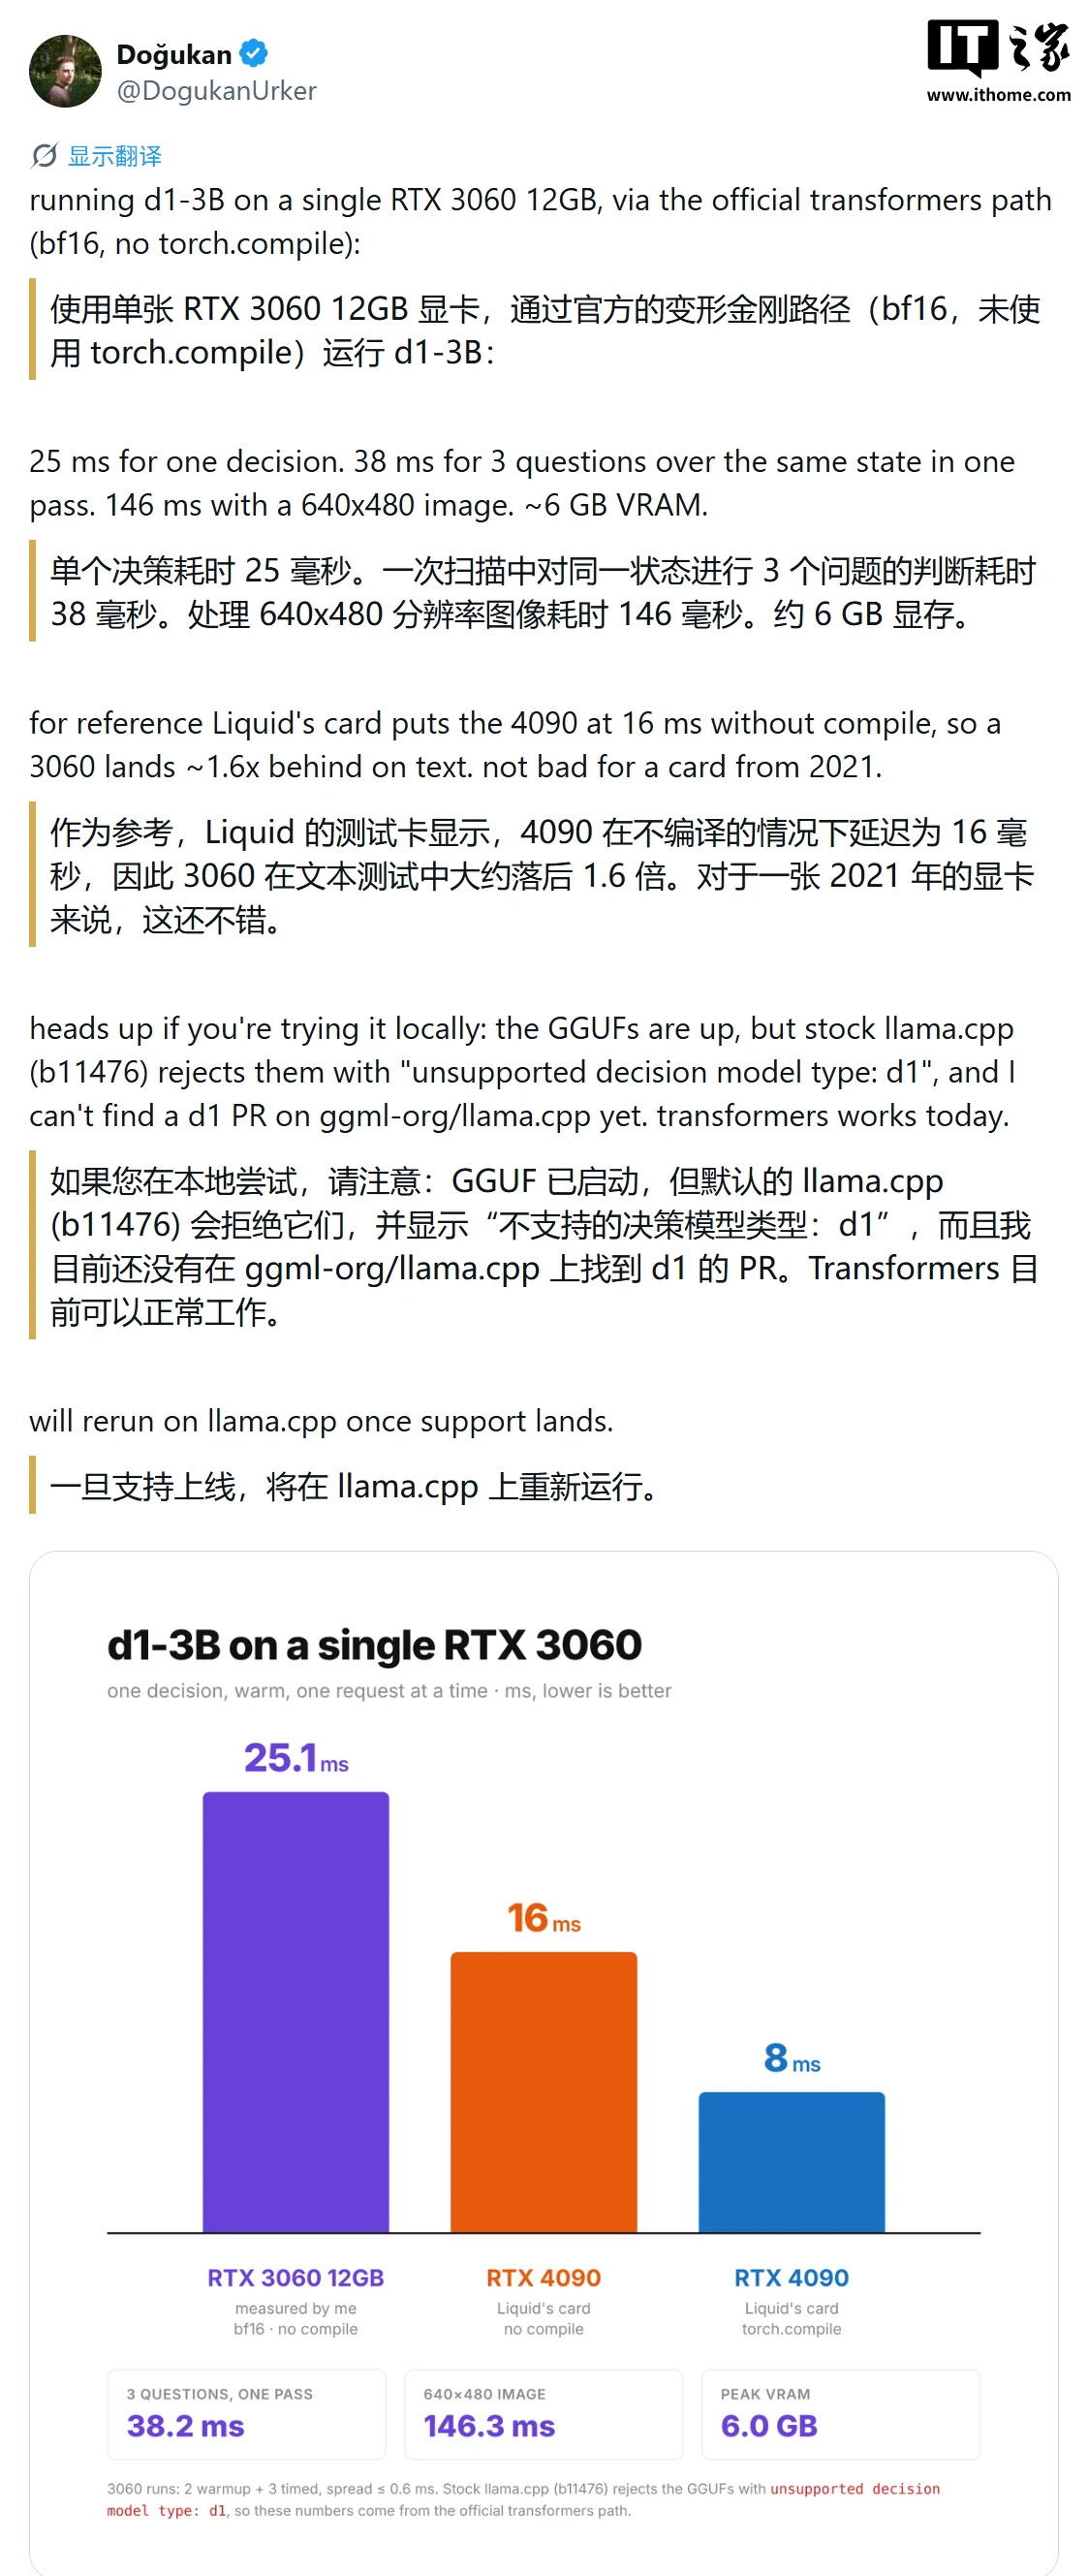
Las pruebas de usuarios muestran que d1-3B, en una GeForce RTX 3060 con 12GB de memoria de vídeo, tarda 25 milisegundos en cada juicio y 146 milisegundos en procesar una imagen de 640×480 píxeles, con un uso máximo de memoria de vídeo de unos 6GB. Otros usuarios han informado de que el modelo tarda 8 milisegundos por juicio en una RTX 3090.