
Wen Le, desde Aofeisi
Quantum Bit | Cuenta oficial QbitAI
El equipo Seed de ByteDance atrapó la dualidad divino-demoníaca de DeepSeek.
La misma pregunta, sin cambiar nada, solo añadiendo unos pocos caracteres irrelevantes al principio, ¿¿¿y de repente el modelo ya no sabe responder???
Y no es un fallo ocasional.
Los investigadores de Seed descubrieron que el rendimiento de DeepSeek-V4 varía según la posición de la información introducida,cambiando periódicamente cada 4 Tokens。
¿Qué significa? Que si el modelo recuerda o no algo depende ¡¡¡de dónde esté ubicado ese algo en la entrada??
Añade dos Tokens al principio y la respuesta puede pasar de incorrecta a correcta; añade dos más y vuelve a cambiarla.
Vaya, vaya, ahora el modelo también le importa la posición al responder.
En pruebas de recuperación con contexto largo de 128K, los investigadores descubrieron que, con solo cambiar la posición de una misma información, la precisión de recuperación de los modelos de la serie DeepSeek-V4puede variar hasta 40.2 puntos porcentuales。
El equipo descubrió además que este problema está relacionado con una técnica de optimización de contexto largo que emplea DeepSeek-V4:
la compresión por bloques de la KV Cache。
Esta técnica fue diseñada para que el modelo procese textos largos con menos memoria y mayor eficiencia.
Pero tras la compresión, dejó al modelo alternando entre dios y demonio (doge).
Con dos Tokens más, DeepSeek de repente responde bien
Los investigadores de Seed de ByteDance comenzaron haciendo un experimento con el propio código de DeepSeek.
El objeto de prueba fueDeepSeek-V4-Flash-Base。
Extrajeron una función de cuantización FP8 del código de inferencia oficial de DeepSeek-V4 y pidieron al modelo completar el último Token.
La respuesta correcta de la tarea debería ser 8, porque este código necesita realizar una conversión de tipos relacionada con FP8.
Pero el modelo a veces insiste en que debería completarse con 32.
Para averiguar qué estaba pasando, los investigadores añadieron delante del código una cadena de documentación puramente decorativa, con algunos signos de igual repetidos.
Luego comenzaron a ajustar la cantidad de signos de igual.
El código no cambió, la posición a completar no cambió, y por supuesto la respuesta correcta tampoco... El único cambio fue que delante aparecieron estos Tokens sin ningún significado práctico.
Como resultado, la respuesta de DeepSeek comenzó a saltar de un lado a otro.
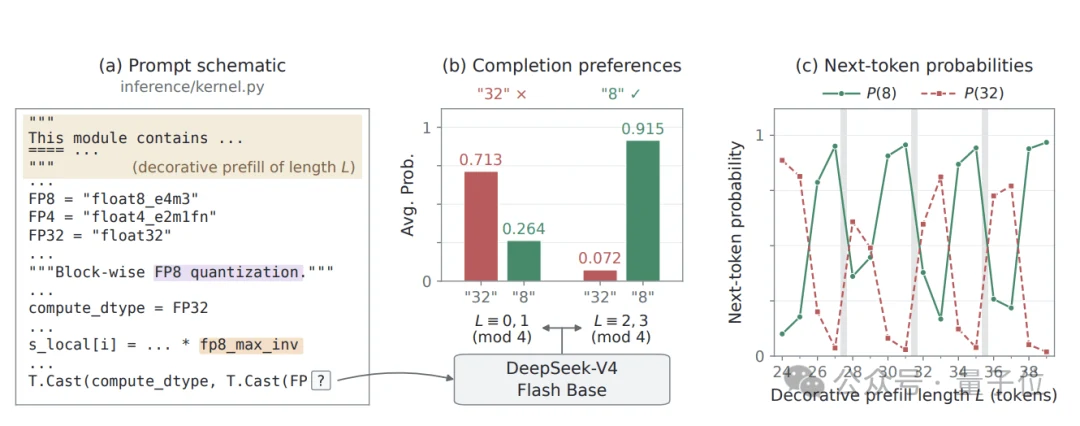
Cuando la longitud del relleno cae en ciertas posiciones, el modelo tiende a responder el 32 incorrecto.
Al desplazar uno o dos Tokens hacia adelante, vuelve a inclinarse por el 8 correcto.
Al seguir desplazándolo, la respuesta incorrecta vuelve a aparecer—
Todo el proceso se repite en un ciclo de 4 tokens。
Más concretamente, de las 16 longitudes de relleno probadas en el artículo, cuando el residuo de la longitud módulo 4 es 0 o 1, el modelo tiende a la respuesta incorrecta 32; cuando el residuo es 2 o 3, tiende a la respuesta correcta 8.
Los investigadores también contabilizaron las probabilidades que el modelo asignaba a las dos respuestas candidatas.
En un grupo de posiciones, la respuesta incorrecta 32 alcanzó una probabilidad promedio del 71.3 %, mientras que la respuesta correcta 8 solo obtuvo un 26.4 %.
Al cambiar a otro grupo de posiciones, la situación se invirtió por completo:
la probabilidad promedio de la respuesta correcta 8 subió al 91.5 %, y la de la respuesta incorrecta 32 quedó reducida a solo un 7.2 %.
Es decir, un simple cambio en la longitud de unos pocos caracteres irrelevantes al inicio basta para que el modelo emita juicios radicalmente distintos ante el mismo problema.
Esto es bastante difícil de evaluar.
Cuando los programadores depuran código, normalmente primero revisan la lógica, las variables y las dependencias.
Ahora parece que también convendría revisar de paso si se han escrito dos signos igual de más al principio.
Sin embargo, un solo caso de autocompletado de código no basta para mostrar cuán generalizado es el problema.
Por ello, el equipo de Seed decidió ampliar las pruebas.
Dirigieron su mirada hacia una tarea clásica dentro de la capacidad de los grandes modelos para manejar contextos largos:la de buscar una aguja en un pajar。
Los investigadores construyeron un contexto de 128K tokens que contenía aproximadamente1.6万 pares clave-valor。
por ejemplo, K1 corresponde a V1, K2 corresponde a V2…
Luego pidieron al modelo que encontrara el Value correspondiente a una Key determinada.
Durante las pruebas, las relaciones clave-valor no cambiaban, la pregunta no cambiaba y la longitud total del contexto se mantenía constante.
Los investigadores ajustaron principalmentela posición de la información objetivo respecto al límite de la ventana de compresión。
Y descubrieron que la curva de precisión de la serie DeepSeek-V4 mostraba, sorprendentemente, oscilaciones periódicas muy marcadas.
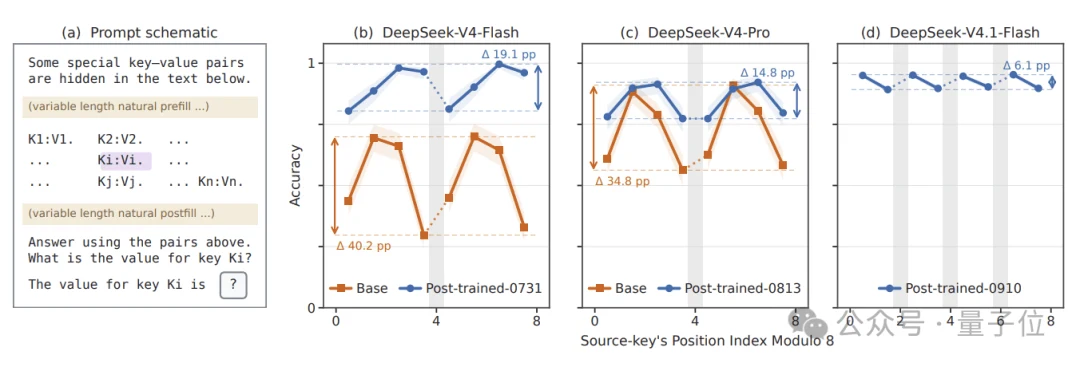
Entre ellas, DeepSeek-V4-Flash-Base presentó una diferencia máxima de precisión de 40.2 puntos porcentuales entre distintas posiciones,
y DeepSeek-V4-Pro-Base alcanzó 34.8 puntos porcentuales.
Después delpost-entrenamientola situación mejoró algo.
En DeepSeek-V4-Flash-0731 la diferencia se redujo a 19.1 puntos porcentuales, y en DeepSeek-V4-Pro-0813 a 14.8 puntos porcentuales.
En el más reciente DeepSeek-V4.1-Flash-0910, la diferencia bajó aún más, a 6.1 puntos porcentuales.
Pero las diferencias periódicas seguían existiendo.
¿De dónde proviene esta variabilidad?
Al examinarlo con más detalle, el periodo de fluctuación de DeepSeek-V4 es de 4 tokens, mientras que el de DeepSeek-V4.1 se convirtió en 2 tokens.
Los investigadores descubrieron que estocorresponde exactamente al paso de compresión del KV Cache que cada generación de modelos emplea por su parte。
Vaya, hasta los ciclos de fluctuación en el rendimiento al responder preguntas coinciden con la configuración de compresión subyacente.
¿El problema está en la compresión del KV Cache?
Entonces hablemos de la compresión del KV Cache.
Cuando los modelos grandes procesan contextos largos, necesitan guardar una gran cantidad de información de Key y Value correspondiente a los Token históricos, para usarla en cálculos de atención posteriores.
Cuanto más largo es el contexto, mayores son la memoria y los costos de cómputo que ocupa esta caché.
Especialmente en tareas largas que implican fácilmente cientos de miles o millones de Token, el KV Cache se convierte con frecuencia en el cuello de botella de la eficiencia de la inferencia.
Así que DeepSeek-V4 adoptócompresión de KV Cache por bloques。
La idea es dividir los Tokens contiguos en ventanas y comprimir la información de cada ventana en menos entradas de caché.
De este modo, el modelo no tiene que reservar una caché del mismo tamaño para cada Token histórico.
Esto ahorra memoria y también reduce el coste de cálculo de la atención en contextos largos.
Pero el equipo de Seed descubrió que la causa de la dualidad divino-demoníaca de DeepSeek podría estar oculta en este proceso de dividir en bloques.
Supongamos que cada 4 Tokens forman un paso de compresión.
Entonces, si una misma información aparece en la posición 1, 2, 3 o 4 dentro de la ventana, las condiciones en las que se comprime pueden ser diferentes.
El artículo denomina a esta posición relativa al borde de la ventana de compresiónPhase (fase)。
Los investigadores descubrieron queel modelo presenta diferencias sistemáticas en su capacidad de recuperación según la fase de la información。
Denominaron a este fenómenoPhase Sensitivity, sensibilidad a la fase。
Pongamos un ejemplo: se entrega al modelo el mismo material:
En la primera maquetación, el número clave cae justo en una posición que el modelo retiene fácilmente;
En la segunda maquetación, solo se añaden unas cuantas palabras al principio, y la posición del número clave respecto a la ventana de compresión cambia.
El material sigue siendo el mismo, pero puede haber diferencias notables en si el modelo logra después encontrar el número.
Además, este problema no puede explicarse simplemente como que "la información quedó cortada justo entre dos ventanas".
Los investigadores descubrieron que, incluso cuando Key y Value caen dentro de la misma ventana de compresión, la precisión de recuperación puede variar mucho según la posición.
Esto indica que el problema también tiene que ver con cómo el modelo escribe realmente la información en la caché comprimida y cómo la lee después de la caché.
Para confirmarlo más a fondo, el equipo de Seed decidió entrenar desde cero un lote de modelos por su cuenta.
Tomaron como base laarquitectura Qwen3-0.6Bconstruyeron varios esquemas de compresión de KV Cache y establecieron como control un modelo de atención completa sin compresión por bloques.
Lo esencial era cambiar solo el mecanismo de compresión, para ver si las oscilaciones periódicas aparecían en consecuencia.
El resultado:todos los modelos con compresión por bloques sometidos a prueba mostraron variaciones periódicas correspondientes al paso de compresión。
A la inversa, el modelo base de atención completa no mostró una periodicidad de ese nivel.
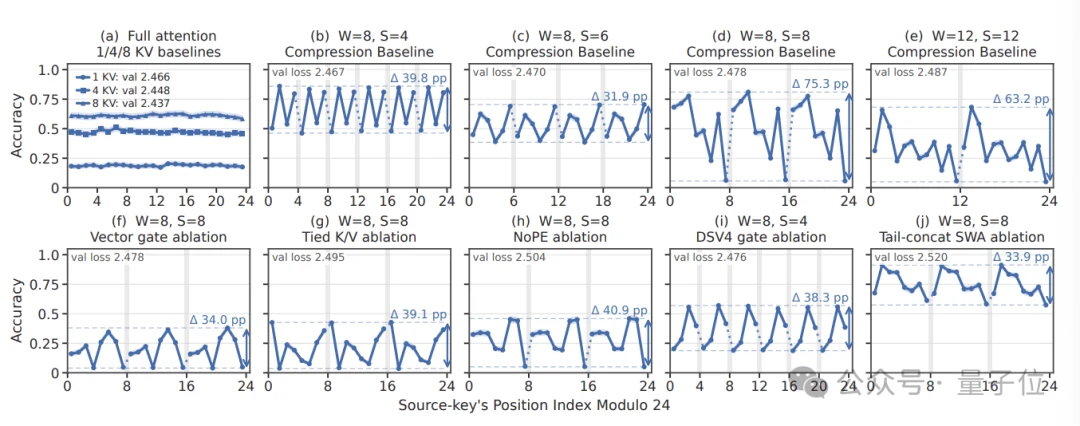
Los investigadores también ajustaron por separado el tamaño de la ventana y el paso de compresión, y descubrieron que el periodo cambia principalmente siguiendo el paso de compresión.
Con un paso de 4, el rendimiento oscila con un periodo de aproximadamente 4 Tokens;
con un paso de 6, el periodo también pasa a ser de aproximadamente 6 Tokens;
Con un paso de 8, ocurre lo mismo;
……
Incluso sin usar codificación posicional RoPE, o reemplazando los pesos de compresión aprendibles por un simple promedio, el fenómeno persiste.
En otras palabras, el problema no es causado individualmente por alguna codificación posicional o por algún módulo especial en particular.
El propio diseño de compresión por bloques puede introducir debilidades periódicas de recuperación.
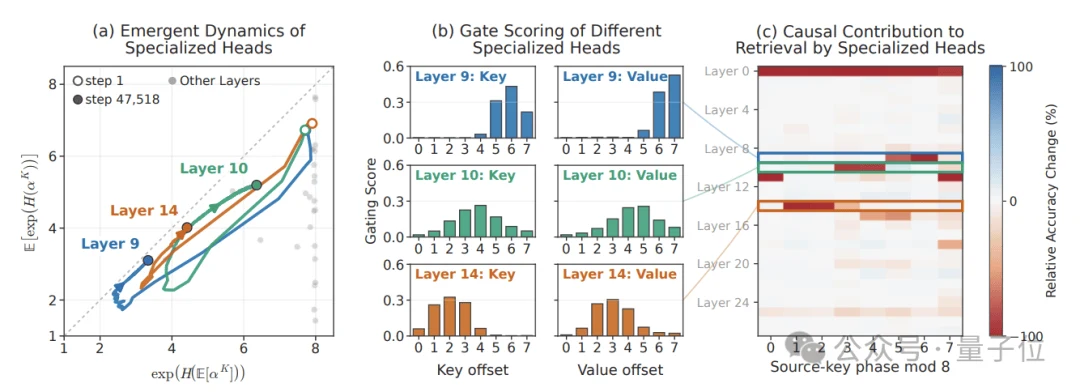
El equipo de Seed realizó además intervenciones en las cabezas de atención, observando cómo cambia la capacidad de recuperación del modelo en cada fase tras eliminar diferentes componentes.
Descubrieron que las contribuciones de las distintas cabezas de atención a las distintas fases no son iguales.
Algunas cabezas son más hábiles para procesar la información de ciertas posiciones, mientras que otras desempeñan un papel mayor en otras posiciones.
Los investigadores lo llaman Phase Specialization, especialización de fase.
Es decir, dentro del modelo parece formarse una división del trabajo: diferentes componentes de atención desarrollan preferencias por diferentes posiciones dentro de la ventana comprimida.
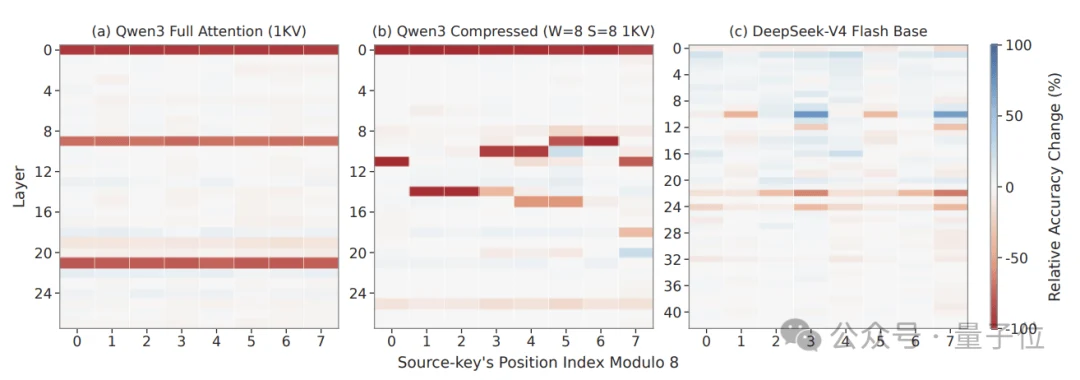
Esta división del trabajo puede ayudar al modelo a realizar la recuperación de información, pero también puede hacer que ciertas posiciones se conviertan en eslabones relativamente débiles.
El artículo también analizó el proceso de entrenamiento mediante un modelo teórico simplificado, y descubrió que el flujo de gradientes puede impulsar que los módulos de compresión formen preferencias estables por posición.
Esto también explica por qué esta periodicidad no es simplemente un ruido aleatorio. Puede ser un resultado que surge de forma natural cuando el modelo aprende a comprimir información.
Pero este tipo de problema no necesariamente se revela directamente en los benchmarks comunes, porque las evaluaciones convencionales suelen resumir una gran cantidad de resultados de prueba en una puntuación promedio.
Supongamos que el modelo funciona muy bien en algunas posiciones y claramente se queda atrás en otras; la calificación promedio final podría seguir siendo buena.
Por eso el equipo de Seed propone que, al evaluar modelos que adoptan compresión por bloques del KV Cache, no basta con observar la precisión de recuperación general, sino que hay que colocar la misma información en diferentes fases de compresión y medirla por separado.
Sin embargo, a pesar de esta desviación de rendimiento causada por la posición, dada la memoria y el costo computacional de la inferencia de contexto largo, la compresión sigue teniendo un valor muy real.
Pero tras ahorrar caché, el modelo podría dejar de tratar la información de diferentes posiciones por igual.
Por supuesto, según los resultados experimentales de esta ocasión, el post-entrenamiento y la iteración de la arquitectura sí pueden reducir notablemente esta brecha.
Dirección del artículo: https://arxiv.org/pdf/2609.36322