
Construir un agente de IA para una demo y operar uno para 40 millones de desarrolladores son problemas de ingeniería diferentes. Postman se propuso construir Agent Mode, una forma nativa de IA de trabajar en pruebas de API, documentación, descubrimiento e implementación. El equipo esperaba que la calidad del modelo y el diseño de prompts fueran los problemas más difíciles. Los desafíos más profundos surgieron de integrar un agente en un producto maduro con años de suposiciones basadas en la interfaz, una amplia superficie y conceptos especializados.
En esta publicación, Postman y AWS describen los patrones arquitectónicos que surgieron al hacer que un producto maduro fuera legible para un agente de IA. Estos patrones incluyen controlar la proliferación de herramientas, exponer lecturas basadas en esquemas y tratar el contexto, en lugar de la capacidad, como el principal cuello de botella.
También explicamos cómo Agent Mode usa Amazon Bedrock para flexibilidad de modelos, inferencia entre Regiones con alcance geográfico, retención cero de datos dependiente del modelo y almacenamiento en caché de prompts de varios niveles. En conjunto, estas lecciones pueden ayudar a los equipos a llevar los agentes de producción más allá de los prototipos.
Por qué Postman construyó Agent Mode
Agent Mode es el portal de Postman para trabajar con el producto de una manera nativa de IA en pruebas, documentación, descubrimiento e implementación. Postman ha evolucionado durante 11 años, y los desarrolladores y usuarios aprendieron a localizar información a través de la interfaz expandiendo barras laterales, revisando pestañas y abriendo solicitudes. Rediseñar esa conciencia para un agente sacó a la luz suposiciones estructurales en las API del producto, la experiencia de usuario y la distribución del conocimiento del producto. Un agente razona sobre datos en lugar de navegar por una pantalla. La Figura 1 ilustra cómo Agent Mode funciona directamente contra la aplicación.
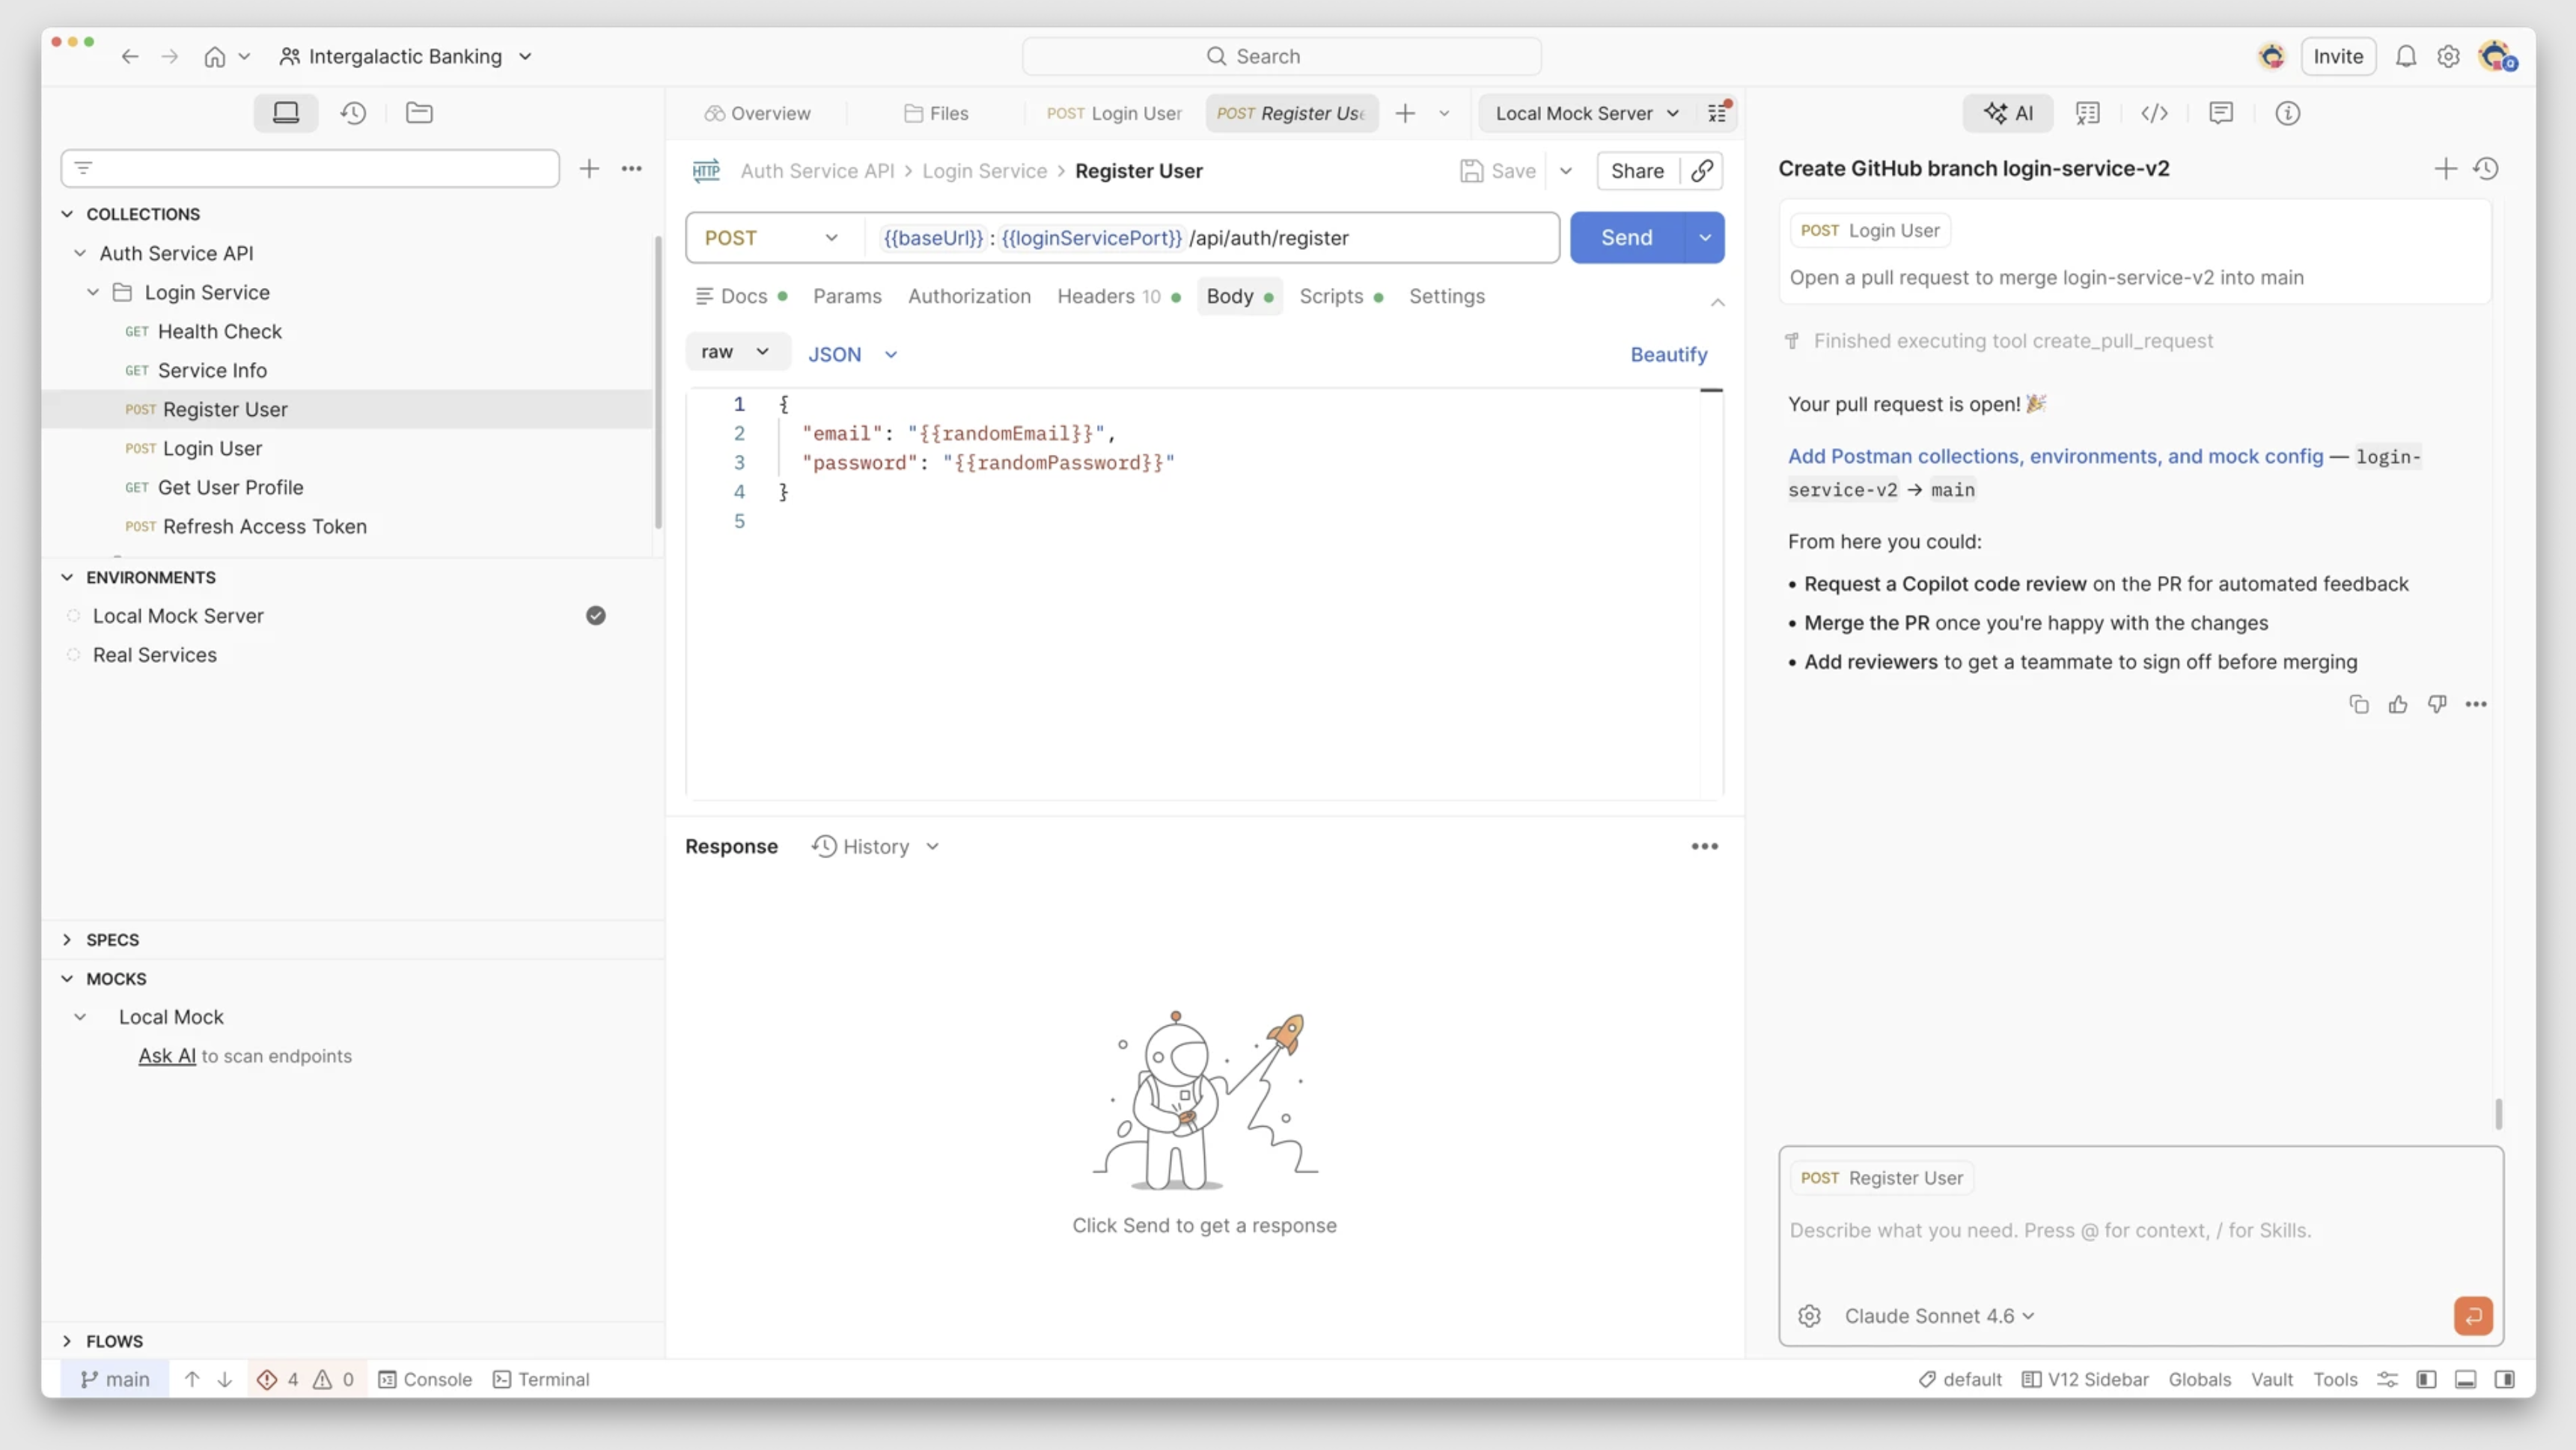
Figura 1: Agent Mode funciona directamente contra la aplicación de Postman. En este ejemplo, abre un pull request y propone los siguientes pasos sin requerir que el usuario navegue por la interfaz
Agent Mode se ejecuta en Amazon Bedrock, que proporciona acceso administrado a modelos fundacionales detrás del agente. Dar soporte a la comunidad global de desarrolladores de Postman crea una demanda variable y sensible a la latencia con picos de tráfico pronunciados. Con Amazon Bedrock, Postman puede escalar esta carga de trabajo de producción sin operar su propia infraestructura de servicio de modelos, manteniendo flexibilidad en la selección de modelos y control sobre el rendimiento, el procesamiento geográfico y el costo. La Figura 2 ofrece una vista de alto nivel de la arquitectura de producción antes de que las siguientes secciones examinen sus componentes.
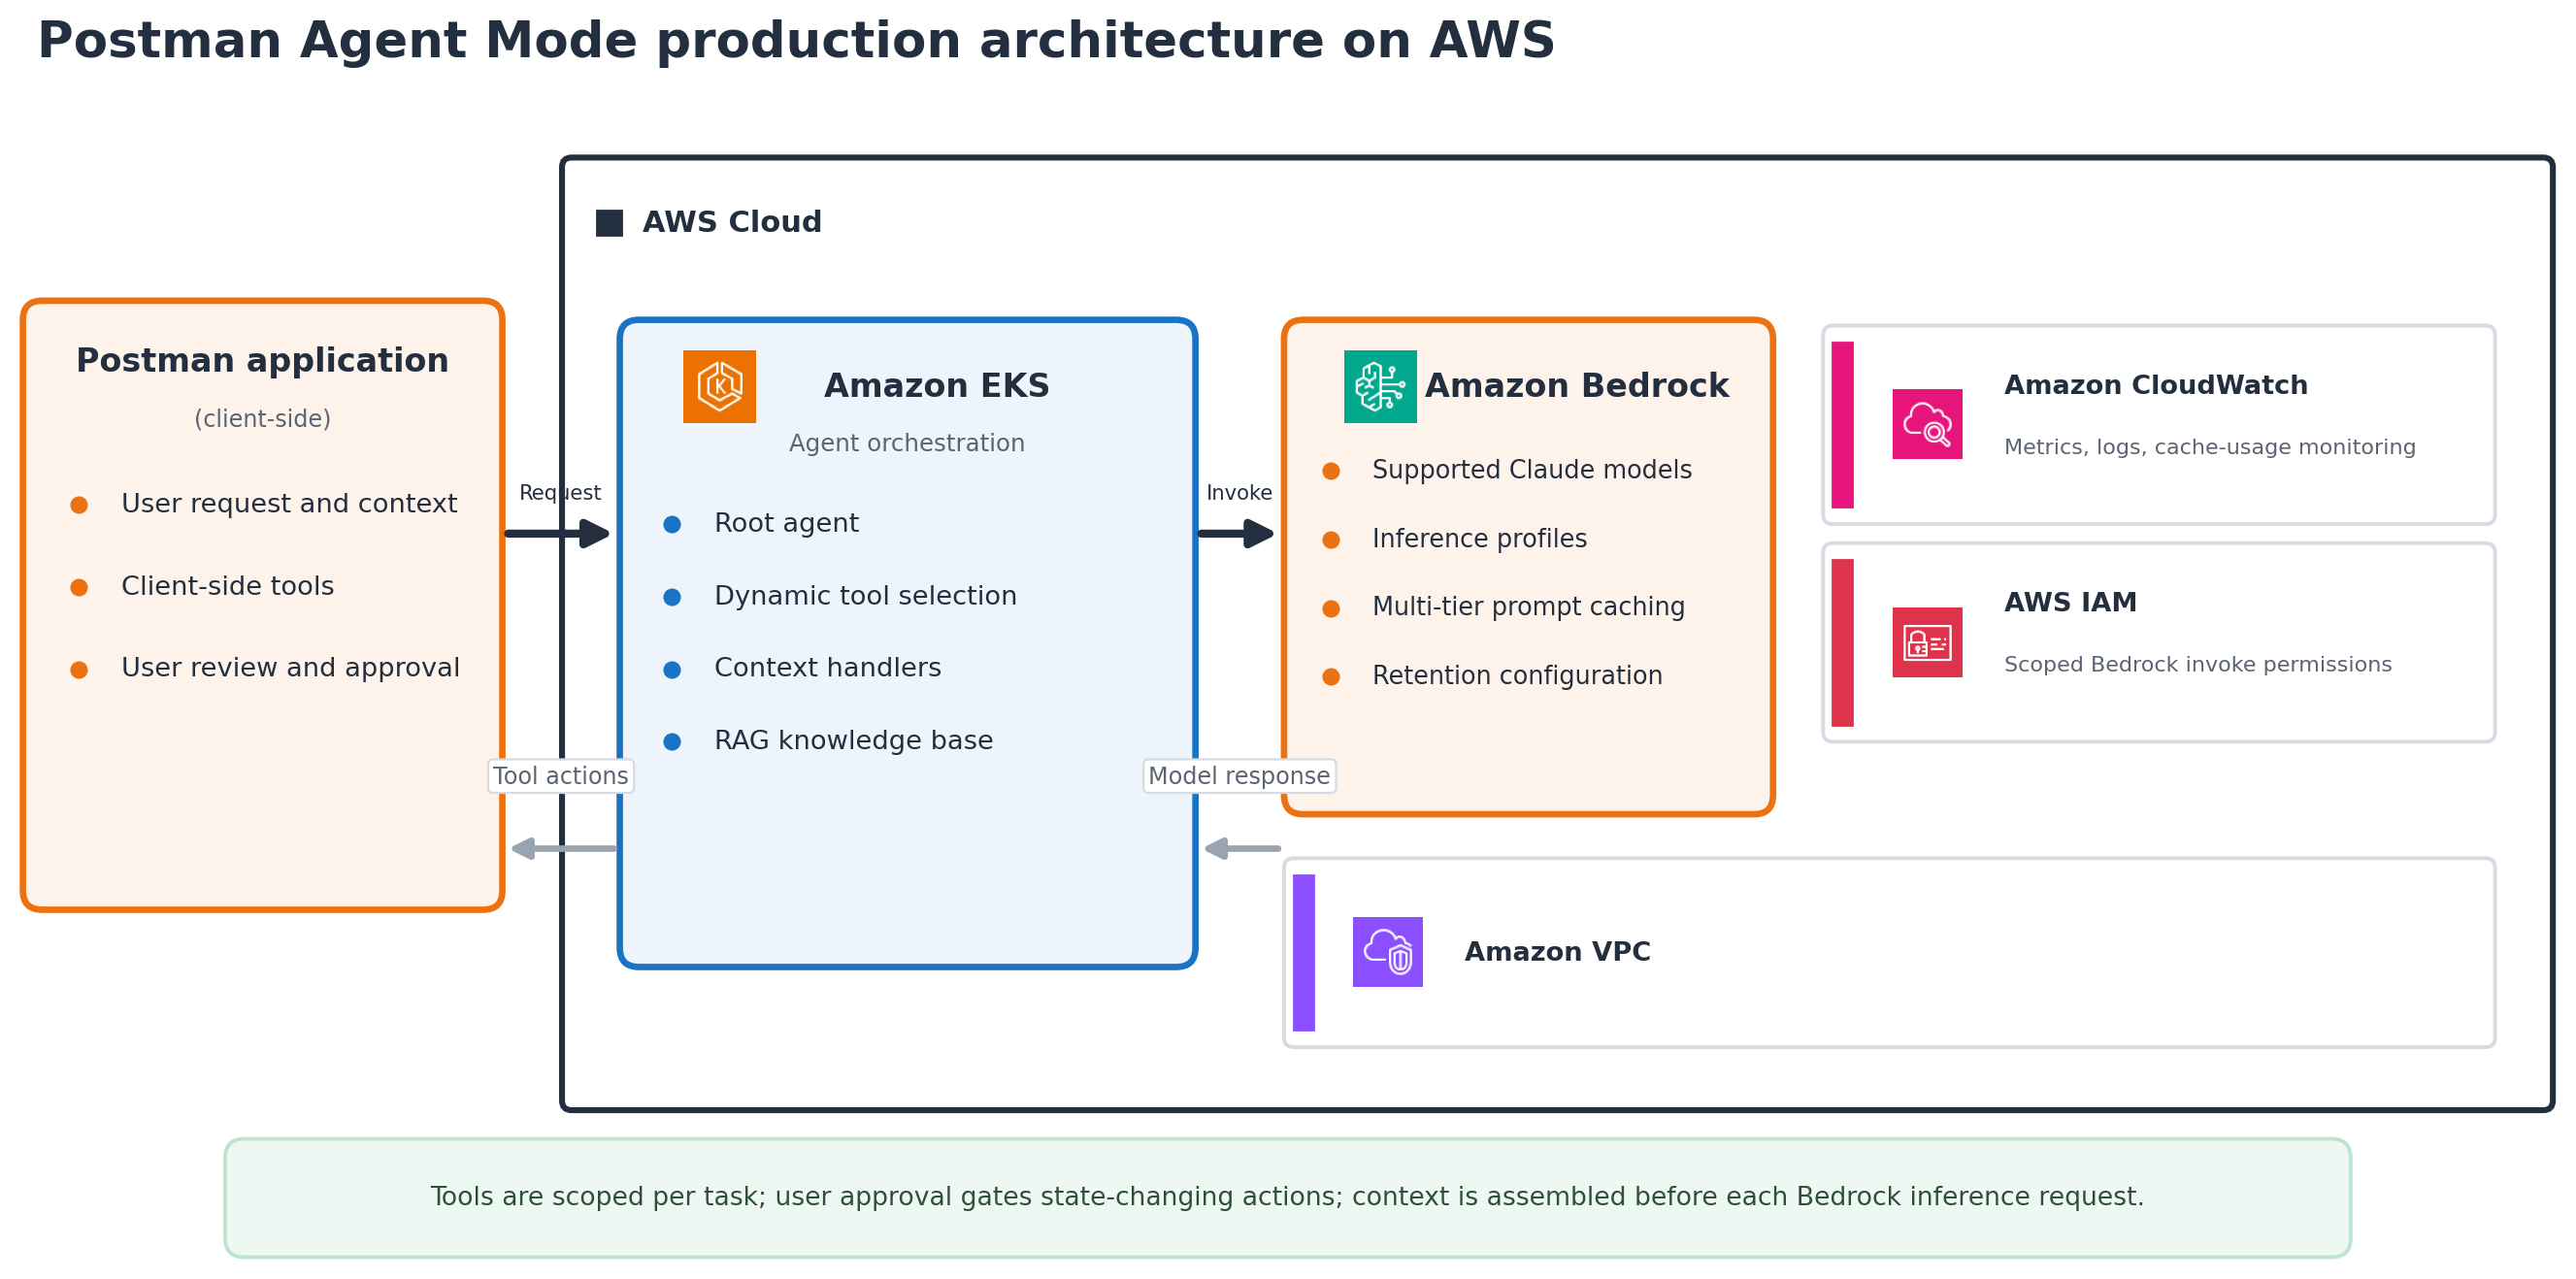
Figura 2: Postman Agent Mode combina herramientas del lado del cliente, orquestación de agentes, contexto diseñado a propósito e inferencia de modelos de Amazon Bedrock. Las herramientas se delimitan para cada tarea, y la aprobación del usuario sigue siendo parte de las acciones que modifican el estado de la aplicación
La supervisión humana es parte del diseño de producción. Agent Mode requiere la aprobación del usuario antes de realizar acciones que modifican el estado de la aplicación. Postman también delimita las herramientas disponibles a la tarea, selecciona un contexto diseñado a propósito y aplica configuraciones de retención de datos dependientes del modelo. Estos controles reducen las acciones no deseadas y la exposición innecesaria de datos, mientras que las pruebas y la supervisión de producción siguen siendo necesarias. Como control de IA responsable, Postman utiliza Amazon Bedrock Guardrails para redactar información de identificación personal antes de que llegue al modelo de lenguaje extenso (LLM) subyacente. Los administradores empresariales pueden activar esto en la configuración de guardrails de Agent Mode.
Gestión de la proliferación de herramientas
En Agent Mode, las herramientas definen cómo actúa el agente dentro de Postman. Al principio, el equipo se inclinó por herramientas altamente atómicas: acciones pequeñas y precisas, como abrir una solicitud, actualizar un campo u obtener un fragmento específico de metadatos. Ese enfoque respaldaba la corrección y el control en las primeras iteraciones, pero también reveló varios problemas.
Muchos flujos de trabajo del mundo real requieren largas secuencias de llamadas a herramientas. Incluso cuando cada paso era rápido, la experiencia general se sentía lenta, porque cada acción tenía que volver al modelo antes de que pudiera comenzar la siguiente. Los usuarios veían al agente avanzar paso a paso por acciones que habían agrupado mentalmente como una sola operación.
En las pruebas de Postman, los errores de selección de herramientas aumentaron una vez que el conjunto de herramientas visible superó aproximadamente las 40 herramientas. El agente podía llamar a herramientas inexistentes, pasar argumentos incorrectos a pesar de tener esquemas válidos, o seleccionar herramientas que parecían semánticamente razonables pero eran incorrectas en ese contexto. Los modelos más grandes o más recientes redujeron este comportamiento, pero no lo eliminaron.
Más allá de cierto tamaño del conjunto de herramientas, exponer más herramientas puede reducir la efectividad del agente. La arquitectura actual selecciona las herramientas según la necesidad y el contexto, y aísla los hilos de ejecución individuales. El modelo ve solo las herramientas relevantes para la tarea actual. La Figura 3 ilustra este proceso de selección dinámica.
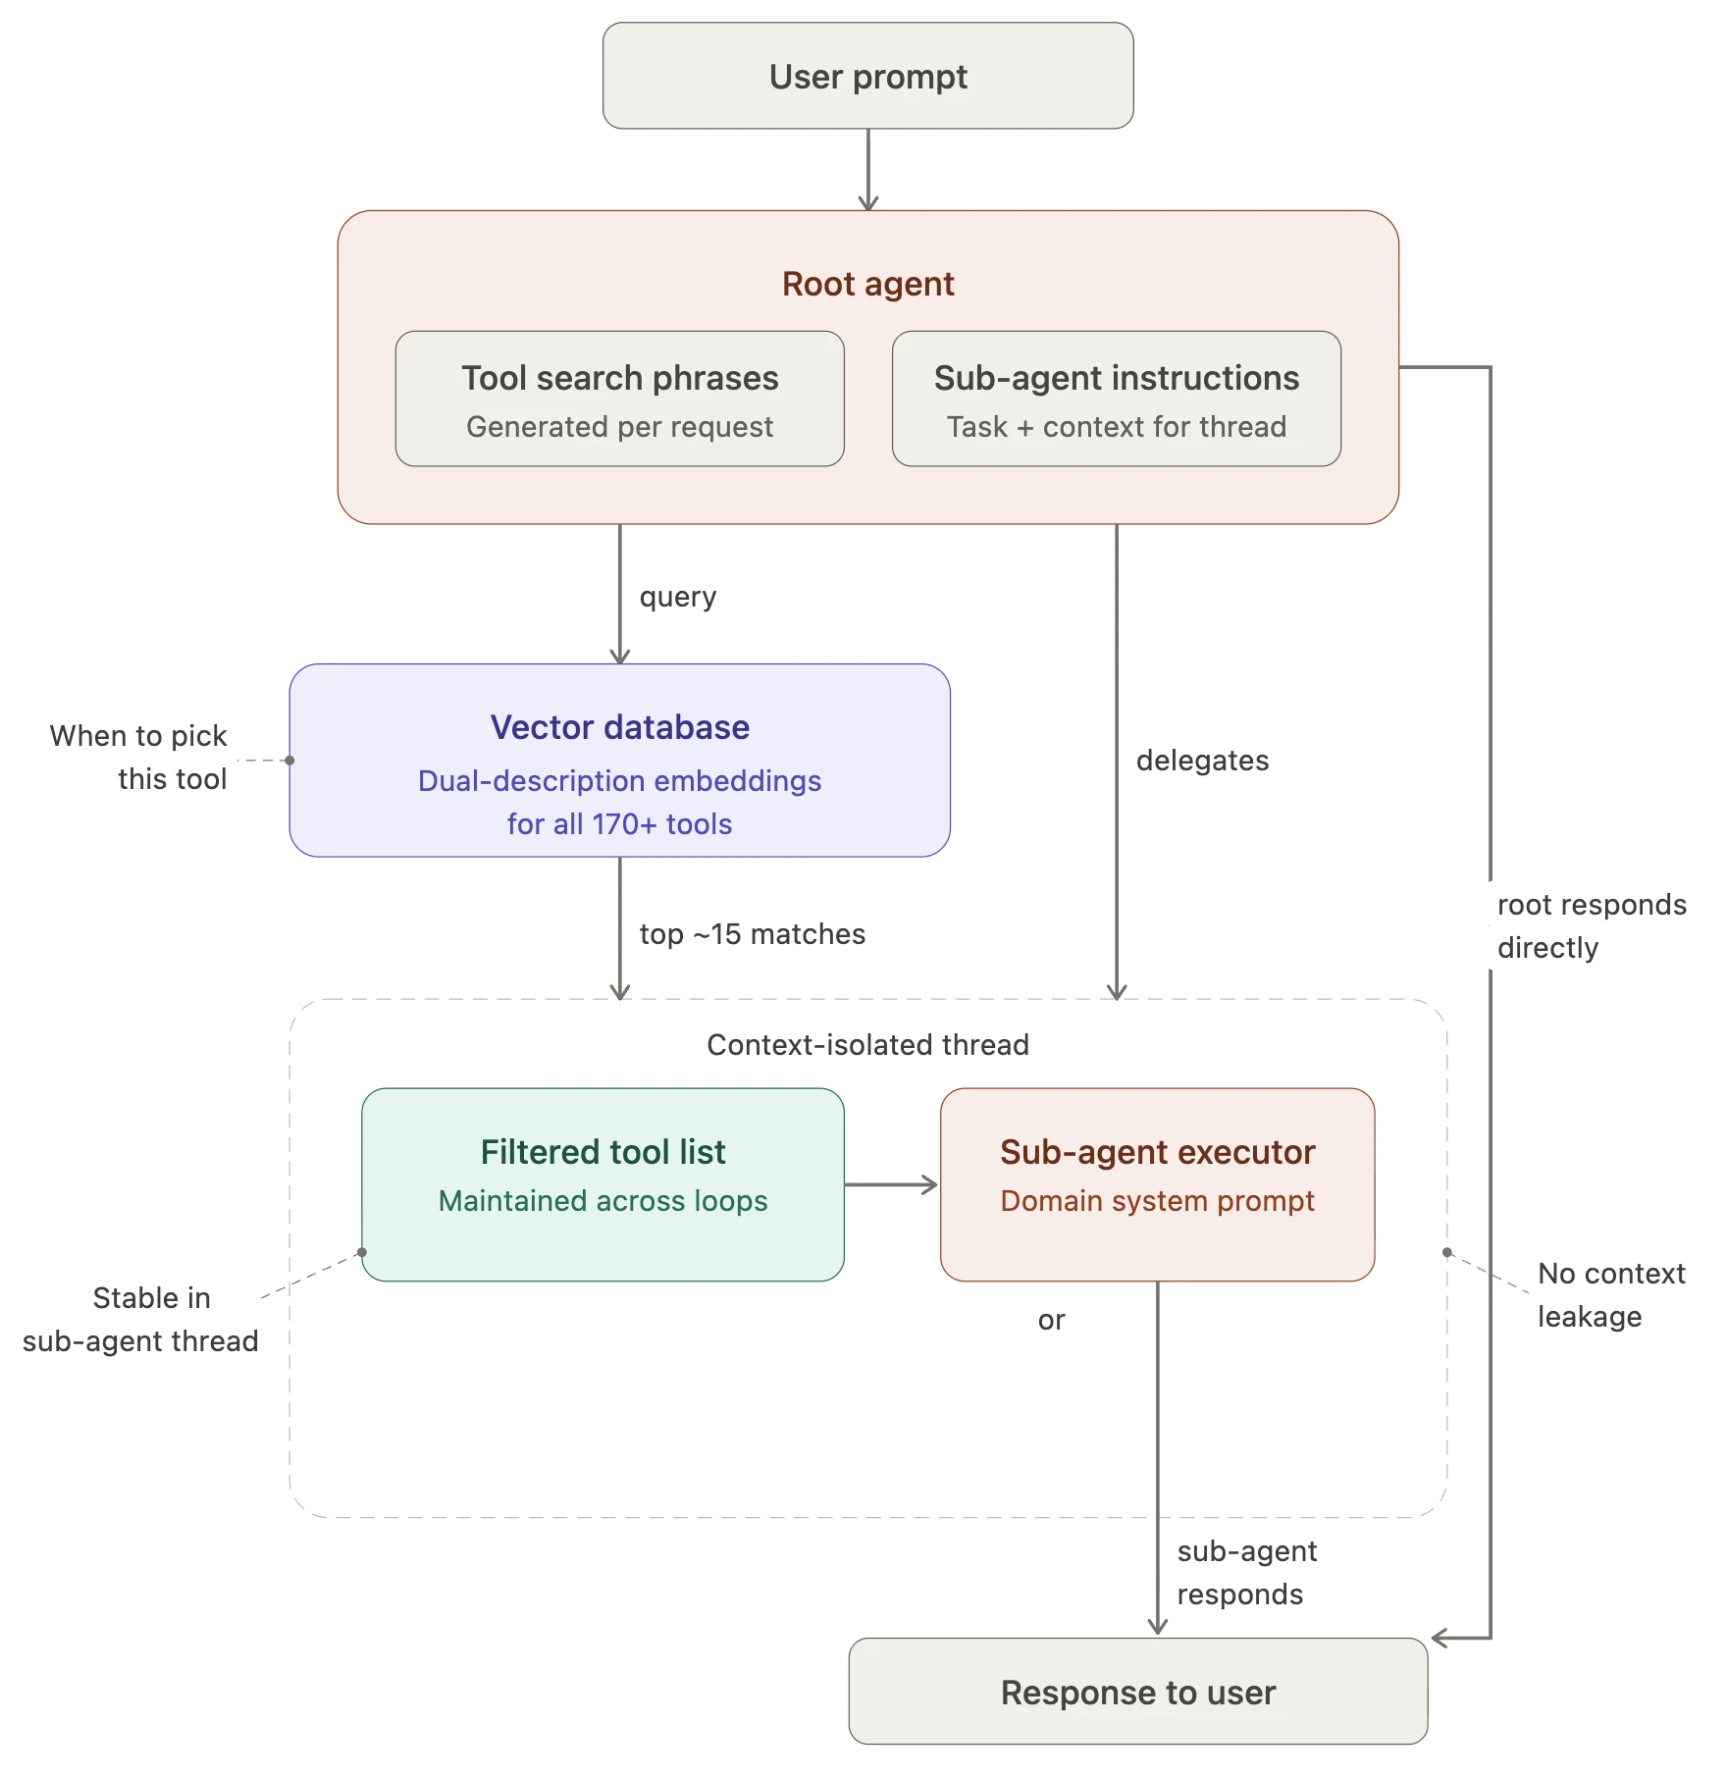
Figura 3: El agente raíz consulta una base de datos vectorial de embeddings de herramientas y reduce más de 170 herramientas a aproximadamente 15 relevantes para la solicitud. Luego entrega esas herramientas a un subagente con contexto aislado, de modo que el modelo ve solo las herramientas necesarias para la tarea
Un problema más sutil era que muchas APIs de cliente estaban acopladas implícitamente al estado de la interfaz. Las herramientas que modificaban solicitudes necesitaban que ciertos elementos estuvieran abiertos, mientras que otras herramientas abrían nuevas pestañas como efecto secundario. El agente tenía que abrir una pestaña de solicitud para leerla, imitando interacciones de la interfaz en lugar de razonar sobre los datos. Postman está desacoplando activamente las herramientas de las pestañas, y su Native Git feature hace un uso extensivo de este enfoque. Por ejemplo, Agent Mode ahora puede enviar solicitudes en segundo plano sin una pestaña abierta, aunque todavía se requiere la aprobación del usuario.
Conclusión para desarrolladores: Trate su catálogo de herramientas como parte del presupuesto de contexto. Delimite dinámicamente las herramientas expuestas al modelo por tarea, y desacople “lo que el agente puede hacer” de “lo que la interfaz resulta tener abierto”.
Exponer lecturas basadas en esquemas
Para productos como el API Catalog, Postman consolidó múltiples vistas estrechas en una sola herramienta de consulta. Estos productos exponen datos estructurados como el tiempo de actividad de los servicios, los resultados de pruebas y los tiempos de respuesta de los endpoints en muchos servicios.
Dado los esquemas de las tablas de ClickHouse subyacentes, el agente puede generar consultas complejas con joins y cláusulas WHERE. Esto reduce sustancialmente el número de herramientas distintas necesarias para responder una pregunta de análisis:
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;
Con este enfoque, el trabajo de ingeniería pasa de construir una herramienta por pregunta a modelar bien los datos una sola vez. El agente puede entonces generar una variedad de consultas mucho más amplia de lo que el equipo jamás podría haber enumerado como herramientas individuales.
Conclusión para desarrolladores: Donde tenga datos bien estructurados, dé al agente acceso de lectura consciente de los esquemas a un motor de consultas en lugar de una proliferación de herramientas de lectura de propósito único. Intercambia cantidad de herramientas por modelado de datos, lo que produce una mejor curva de escalado.
El contexto era el verdadero cuello de botella
Postman inicialmente asumió que la falta de tools sería el mayor obstáculo. En la práctica, la falta de context o su incompletitud causaron más fallos que la falta de capacidades.
El contexto es la comprensión que tiene el agente de dónde está el usuario en Postman, qué entidades están activas y qué estado ya se ha establecido. Cuando ese contexto era incorrecto o estaba ausente, incluso las herramientas correctas se volvían ineficaces. La Figura 4 distingue las dos formas de contexto suministradas al agente.
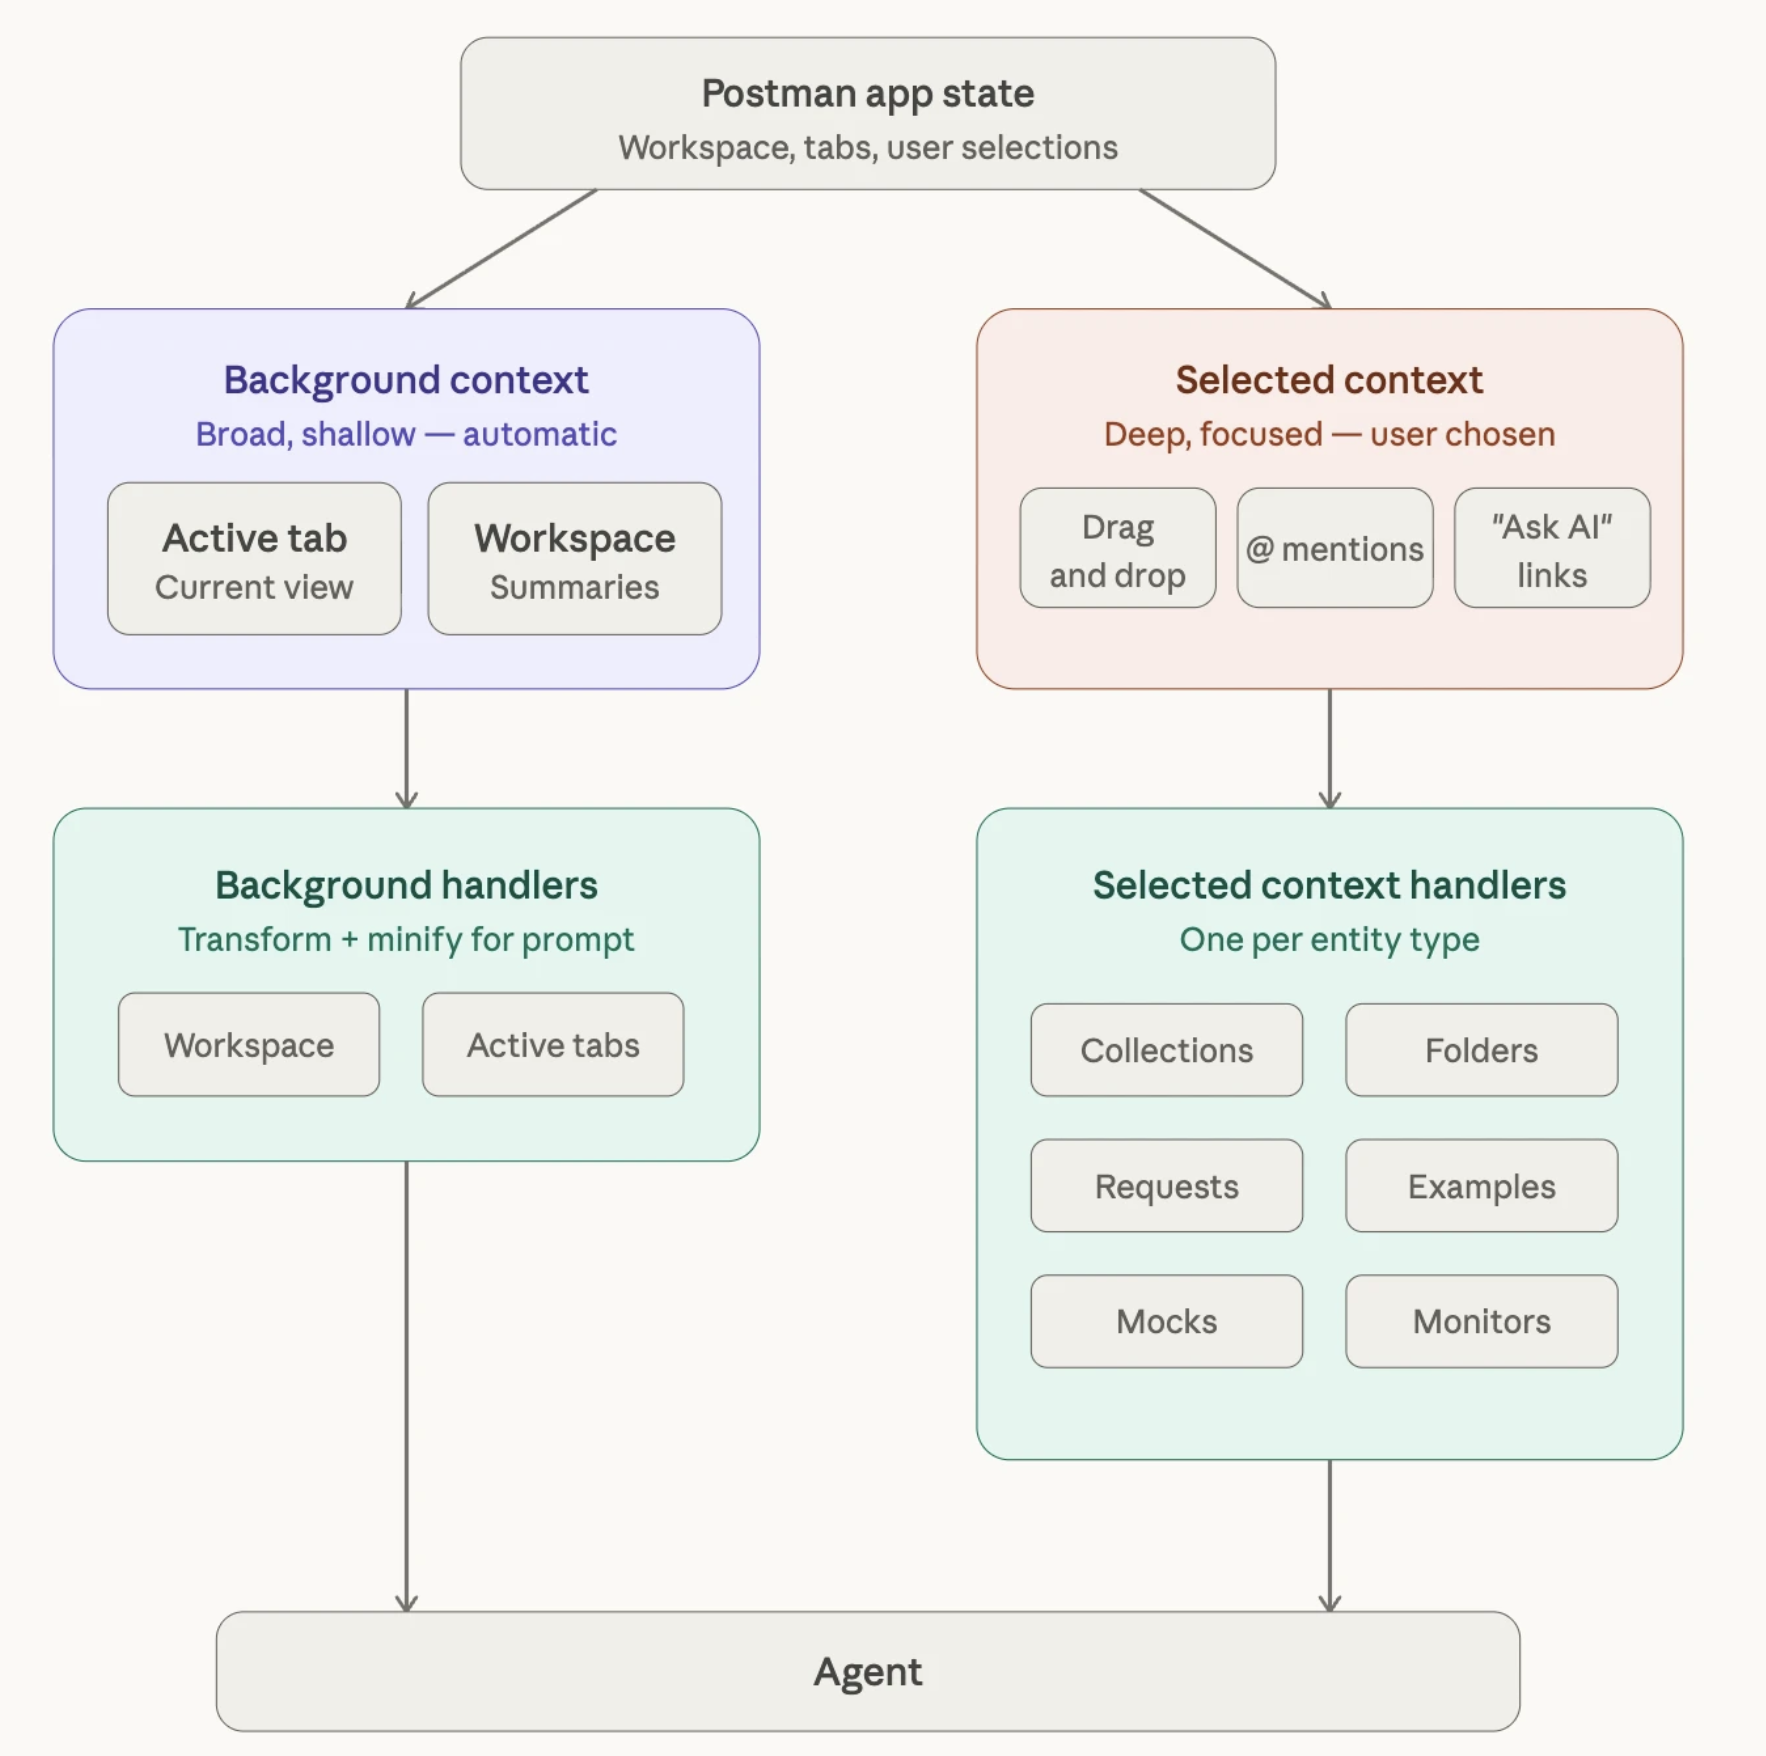
Figura 4: Dos tipos de contexto alimentan al agente. El contexto general y superficial de fondo se recopila automáticamente y se minimiza para el prompt. El contexto seleccionado, profundo y enfocado, es elegido por el usuario y se dirige a través de un controlador dedicado para cada tipo de entidad. Cada controlador destila la entidad en la información que el agente necesita
El desafío era estructural. A lo largo de 11 años, los desarrolladores y usuarios aprendieron a encontrar información a través de la interfaz. Rediseñar esa conciencia para un agente requirió múltiples iteraciones para determinar qué importaba en cada flujo de trabajo y qué era ruido. Serializar el modelo de datos existente de la interfaz no produjo un contexto útil porque esos objetos estaban diseñados para el renderizado y la transferencia de datos, no para el razonamiento. Por ello, Postman construyó controladores de contexto dedicados que destilaban cada entidad en lo que el agente necesitaba saber.
A medida que más objetos obtenían controladores, la truncación se convirtió en el siguiente problema. Muchos campos contienen datos abiertos generados por los usuarios, incluidas descripciones de solicitudes, especificaciones de OpenAPI y payloads de solicitudes. Estos datos pueden saturar la ventana de contexto. Gestionar cuidadosamente el presupuesto de contexto es esencial a escala y respalda el enfoque respaldado por el sistema de archivos que el equipo está explorando, donde cada controlador no necesita lógica personalizada de truncamiento y expansión.
Conclusión para desarrolladores: No alimente al modelo con su modelo de datos de renderizado. Construya controladores de contexto con un propósito específico y trate la ventana de contexto como un presupuesto escaso y gestionado activamente. El ruido desplaza a la señal mucho antes de que el modelo alcance su límite.
Uniendo todo
A medida que el Agent Mode evolucionó, quedó claro que el sistema tenía que agregar tres componentes distintos, cada uno resolviendo un problema diferente.
- Las herramientas del lado del cliente viven en la aplicación Postman y representan las acciones finales que el agente puede realizar, como abrir solicitudes, modificar configuraciones, ejecutar colecciones e inspeccionar la autenticación. El Agent Mode también utiliza herramientas del lado del servidor para funciones como la búsqueda web y la gestión del bucle del agente, pero la mayoría de las herramientas operan sobre la aplicación Postman.
- Las instrucciones genéricas del agente definen el comportamiento a nivel del sistema, incluyendo qué tan proactivo debe ser el Agent Mode, cómo comunica la incertidumbre y qué conocimiento base del producto lleva consigo.
- Una base de conocimiento utiliza un enfoque de Generación Aumentada por Recuperación (RAG). Postman tiene una gran superficie de producto que incluye múltiples protocolos de solicitud, servidores simulados (mock), monitores, documentación, la API Network, gobernanza de espacios de trabajo, variables, helpers, generación de código, configuraciones de solicitud y ejecuciones de colecciones.
Codificar todo esto en prompts estáticos no era viable, y la mayor parte es irrelevante para una consulta determinada. Para la siembra inicial, el equipo usó el Learning Center de Postman para generar artículos concisos específicos de funcionalidades. En tiempo de ejecución, Agent Mode selecciona artículos de conocimiento según la consulta entrante y el contexto disponible. Por ejemplo, cuando un usuario selecciona un servidor simulado (mock server), Agent Mode inyecta automáticamente el artículo relacionado. Esto mantiene el agente ligero de forma predeterminada al tiempo que proporciona profundidad cuando es necesario. La base de conocimiento evoluciona con la aplicación, por lo que los equipos pueden enviar documentación de Agent Mode junto con nuevas funcionalidades.
Ejecutar Agent Mode en Amazon Bedrock
Los tres componentes descritos anteriormente se resuelven en la misma acción en tiempo de ejecución: una llamada de inferencia a un modelo fundacional (FM). A la escala de Postman, el tráfico es intermitente y dirigido por desarrolladores. El enrutamiento, el almacenamiento en caché y los controles de procesamiento geográfico ayudan a Postman a absorber picos de tráfico, gestionar el costo de la inferencia y abordar requisitos de procesamiento específicos de cada carga de trabajo. Amazon Bedrock proporciona cuatro capacidades que son las más importantes aquí.
Flexibilidad de modelos dentro de la familia Claude
Agent Mode no está atado a un solo modelo. A través de las API de inferencia de modelos de Amazon Bedrock, Postman puede acceder a los modelos Anthropic Claude admitidos y enrutar cada carga de trabajo a un modelo apropiado. Un modelo más rápido puede atender interacciones de alto volumen y sensibles a la latencia, mientras que un modelo más grande puede manejar razonamientos complejos donde la calidad importa más que el costo. Cambiar entre los modelos Claude admitidos es principalmente un cambio de configuración en lugar de una nueva integración. Esta flexibilidad respalda directamente los desafíos de dispersión de herramientas y de contexto descritos anteriormente. En las pruebas de Postman, los modelos más nuevos y más grandes redujeron las alucinaciones de herramientas, y Postman puede adoptar los modelos admitidos sin reconstruir la integración. Consulte los modelos admitidos por región de AWS en Amazon Bedrock.
Inferencia entre regiones para alto rendimiento
El tráfico de desarrolladores es muy variable, y aprovisionar para la demanda máxima en una sola región de AWS puede ser costoso. Agent Mode usa la inferencia entre regiones de Amazon Bedrock para enrutar automáticamente las solicitudes entre las regiones de destino definidas por un perfil de inferencia. En tiempo de ejecución, la aplicación pasa el ID del perfil de inferencia seleccionado o el nombre de recurso de Amazon (ARN) como modelId en Converse o InvokeModel. El perfil, las políticas de control de servicio y de AWS Identity and Access Management (IAM) aplicables, y las cuotas deben permitir todas las regiones de destino que Bedrock pueda seleccionar.
- Los perfiles de inferencia geográficos enrutan las solicitudes solo entre las regiones admitidas dentro de una geografía definida, como Estados Unidos o la Unión Europea. Esta opción combina un mayor rendimiento con un límite de procesamiento geográfico configurado.
- Los perfiles de inferencia globales pueden enrutar las solicitudes entre las regiones de destino admitidas en todo el mundo para proporcionar rendimiento adicional durante los picos de tráfico. Son apropiados solo cuando la carga de trabajo no requiere un límite de procesamiento restringido geográficamente.
Postman puede seleccionar el perfil de inferencia por carga de trabajo: un perfil global para el máximo rendimiento disponible o un perfil geográfico cuando el procesamiento debe permanecer dentro de la geografía definida del perfil. Esta elección es explícita en el modelId utilizado para cada solicitud de inferencia de Bedrock.
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
Residencia de datos y controles empresariales
Para los clientes empresariales, la geografía de procesamiento permitida puede ser tan importante como el rendimiento. Los perfiles de inferencia geográficos restringen el enrutamiento de Bedrock a las regiones de destino admitidas por el perfil dentro de la geografía seleccionada. Esto no significa que la inferencia se ejecute dentro del entorno de AWS propio de Postman. Amazon Bedrock procesa las solicitudes en las regiones de AWS elegibles para ese perfil, con los datos cifrados en tránsito y en reposo. AWS indica que Bedrock no usa los prompts y las finalizaciones para entrenar modelos de AWS ni para distribuirlos a terceros. Postman ha configurado retención de datos cero con data_retention_mode establecido en none para los modelos de Agent Mode admitidos. La disponibilidad y el comportamiento dependen del modelo, por lo que cada modelo de producción debe verificarse contra la documentación actual de protección y retención de datos de Amazon Bedrock.
Almacenamiento en caché de prompts para mantener los costos bajo control
Un agente de producción reenvía un contexto estable considerable en cada turno, incluidas las instrucciones del sistema, el comportamiento genérico del agente, un conjunto básico de herramientas, el conocimiento seleccionado y el contexto de la conversación. Reprocesar el prefijo sin cambios en cada solicitud añade latencia y costo evitables.
Agent Mode usa el almacenamiento en caché de prompts de Amazon Bedrock para reutilizar prefijos de prompt estables. El núcleo casi inmutable, incluido el prompt del sistema, las instrucciones del agente y las definiciones básicas de herramientas, utiliza un punto de control de caché de una hora. El contexto más variable utiliza un punto de control de cinco minutos que se renueva en cada acierto de caché. Bedrock requiere que el punto de control de mayor duración aparezca antes que el de menor duración. El nivel más corto se adapta a las sesiones interactivas porque el contexto inactivo expira, mientras que el nivel de una hora puede amortizar su mayor precio de escritura en caché entre muchas lecturas. Los beneficios de la caché y los TTL admitidos dependen del modelo seleccionado. Los equipos pueden verificar el comportamiento mediante los campos de uso cacheReadInputTokens y cacheWriteInputTokens y medir el tiempo hasta el primer token para sus propias cargas de trabajo.
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}}  # variable layer
Conclusión para desarrolladores: Trate la inferencia como un problema de enrutamiento y almacenamiento en caché, no solo como una decisión de selección de modelo. Seleccione el modelo de Claude según cada carga de trabajo, elija el perfil de inferencia entre Regiones adecuado y almacene en caché el prefijo estable del prompt con TTL que coincidan con la frecuencia de cambio de cada capa.
Mejores prácticas para escalar agentes en producción
Destiladas del recorrido de Postman, para los creadores que trabajan con Amazon Bedrock:
- Presupueste las herramientas con tanto cuidado como los tokens. Seleccione dinámicamente las herramientas expuestas por tarea. En las pruebas de Postman, los errores de selección de herramientas aumentaron a medida que el conjunto de herramientas visibles se hacía grande.
- Prefiera lecturas conscientes del esquema antes que la proliferación de herramientas. Modele bien sus datos y deje que el agente los consulte.
- Desacople las acciones del agente del estado de la interfaz. Si una herramienta requiere una pestaña abierta, el agente está navegando por la interfaz en lugar de razonar directamente sobre los datos.
- Ingeniería deliberada del contexto. Los gestores de contexto de propósito específico superan siempre a serializar su modelo de renderizado.
- Gestione la ventana de contexto como un recurso escaso. La estrategia de truncamiento y expansión es un problema de diseño de primera clase, no una ocurrencia tardía.
- Envíe documentación junto con las funcionalidades. Una base de conocimiento RAG solo sigue siendo útil si evoluciona al mismo ritmo que el producto.
- Enrute y almacene en caché en Bedrock. Empareje cada carga de trabajo con el modelo de Claude apropiado, elija la inferencia entre Regiones según los requisitos de rendimiento y geográficos, y aplique caché por niveles a los prefijos estables de los prompts.
Conclusión
Construir Agent Mode obligó a Postman a enfrentar la brecha entre las capacidades de los grandes modelos de lenguaje y la estructura de productos maduros: suposiciones de interfaz, clientes acoplados, catálogos de herramientas extensos y conocimiento distribuido entre documentación y equipos. La selección dinámica de herramientas, las lecturas basadas en esquemas y la ingeniería deliberada del contexto surgieron como patrones repetibles a la escala de la comunidad de desarrolladores de Postman. Amazon Bedrock proporciona el acceso administrado a modelos, la inferencia entre Regiones, los controles de retención dependientes del modeloy la caché de prompts que soportan la arquitectura de producción.
Ya sea que esté construyendo su primer agente o escalando uno existente, estos patrones pueden ayudar a los equipos a evitar desafíos comunes de integración y escalado de agentes.
Para obtener más información, consulte la documentación de Amazon Bedrock, incluyendo orientación sobre inferencia entre Regiones, almacenamiento de prompts en caché, y protección y retención de datos. Para obtener orientación sobre la implementación relacionada, lea Effectively use prompt caching on Amazon Bedrock y Amazon Bedrock anuncia la inferencia global entre Regiones para aumentar el rendimiento en el AWS Machine Learning Blog. Para explorar el producto, consulte la documentación de Postman Agent Mode.
La implementación en producción de Postman es propietaria y no está disponible como un repositorio de ejemplo público.