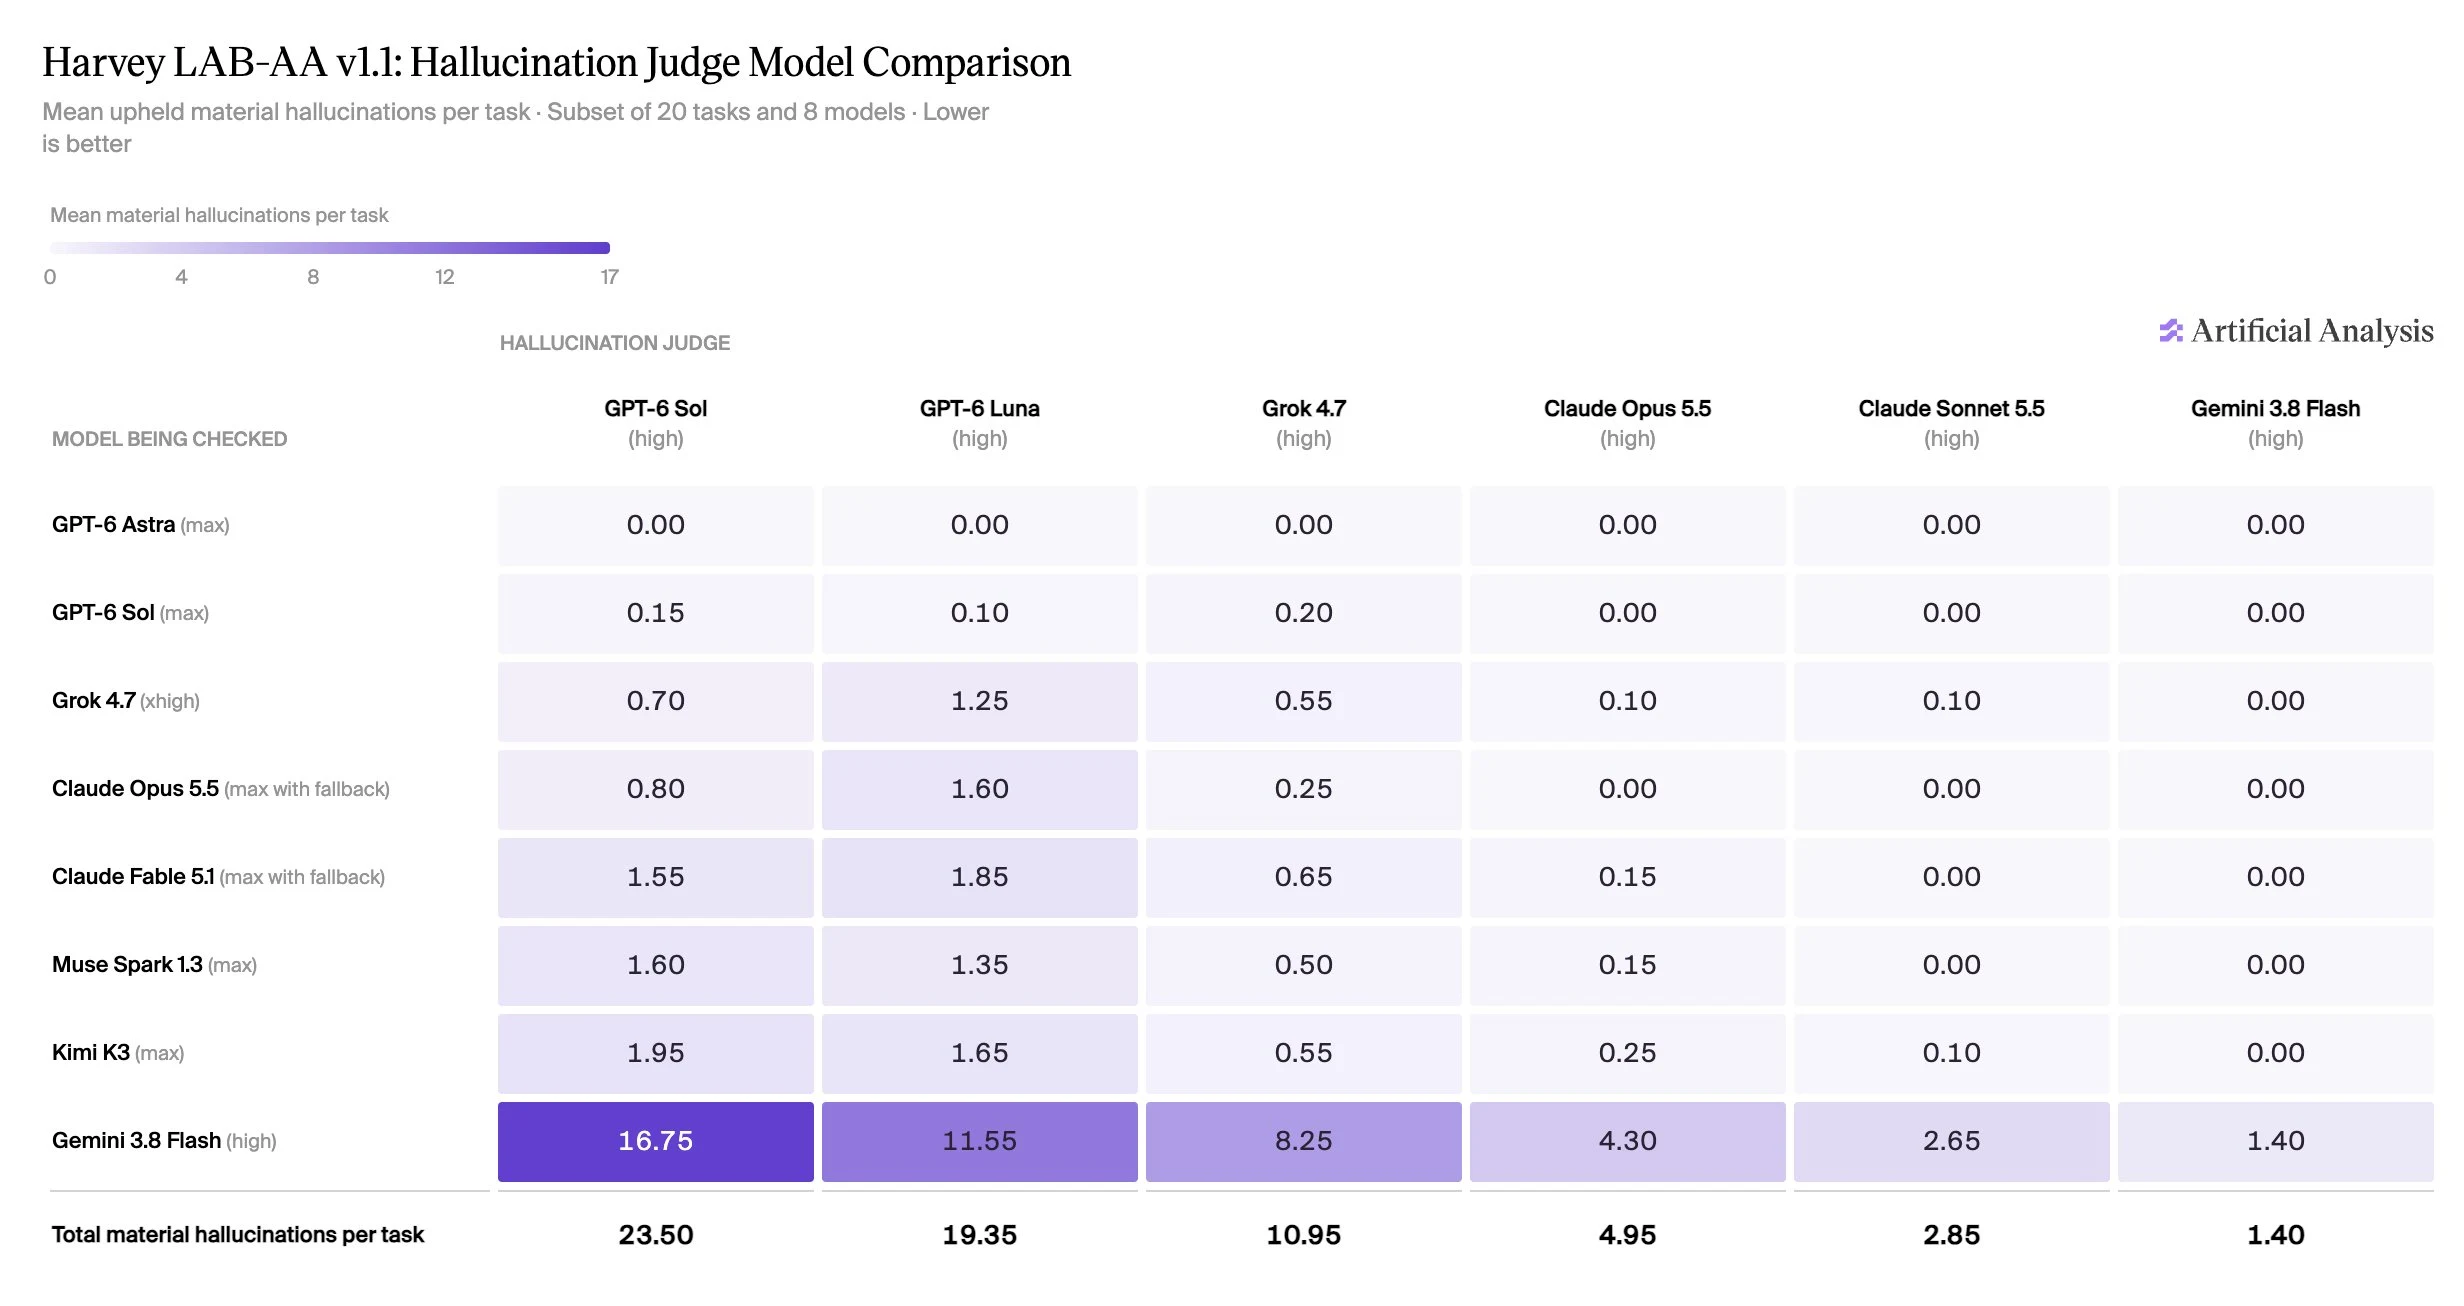
Comparamos seis verificadores de alucinaciones sobre los mismos resultados obtenidos a partir de un subconjunto fijo de 20 tareas y ocho modelos. Ejecutamos nuestro control de dos etapas utilizando GPT-6 Sol (alto), GPT-6 Luna (alto), Grok 4.7 (alto), Claude Opus 5.5 (alto), Claude Sonnet 5.5 (alto) y Gemini 3.8 Flash (alto), y seleccionamos GPT-6 Sol (alto) para su uso en producción.
En este subconjunto de 20 tareas, GPT-6 Sol y GPT-6 Luna identificaron generalmente más alucinaciones materiales, mientras que Claude Sonnet 5.5 y Gemini 3.8 Flash identificaron muchas menos. Claude Opus 5.5 se encontraba entre Grok 4.7 y Claude Sonnet 5.5 en todas las filas de modelos. En total, Opus identificó 99 alucinaciones materiales, en comparación con 219 para Grok, 57 para Sonnet y 470 para GPT-6 Sol. GPT-6 Sol identificó más alucinaciones de material, a pesar del enfoque conservador del control de errores, lo que excluye el conocimiento legal general no contenido en los documentos originales.
Los seis revisores no encontraron alucinaciones materiales en los resultados de GPT-6 Astra, mientras que GPT-6 Sol osciló entre 0 y 0.20 por tarea. Ambos fueron entre los modelos con menos alucinaciones materiales según cada revisor. Esta comparación muestra diferencias en el comportamiento del revisor; las cifras por sí solas no establecen precisión ni descartan preferencia propia.