
vLLM ahora soporta Vera Rubin NVL72!
NVIDIA Vera Rubin es la plataforma de próxima generación diseñada para la inferencia agentic. Desde su anuncio, Inferact, NVIDIA, Red Hat y la comunidad vLLM han estado promoviendo el uso de vLLM en Vera Rubin NVL72, y hoy vLLM funciona en Vera Rubin NVL72, con compilaciones diarias de contenedores y soporte para modelos de DeepSeek, Moonshot AI, Z.ai y MiniMax.
Este artículo es una visión preliminar de la situación actual, y aquí hay algunos puntos destacados del trabajo realizado hasta ahora:
- Hardware de Vera Rubin NVL72: 5 veces más NVFP4 FLOPS, aproximadamente 2.4 veces más ancho de banda HBM y 1.7 veces más ancho de banda bidireccional NVLink del GB200 NVL72, con exponencialidades 2-4 veces más rápidas para softmax.
- Soporte en día 0: Rubin se basa en la familia de arquitecturas de Blackwell, por lo que los kernels Blackwell de vLLM son compatibles con Rubin. Gracias a esto, vLLM ya soporta modelos diversos como DeepSeek, Kimi, GLM y MiniMax en Rubin.
- Kernels ajustados con Rubin: A través de FlashInfer 0.7.0, vLLM obtiene kernels de atención, GEMM y MoE ajustados con Rubin. También hemos ajustado nuestro kernel de prellenado de Atención Espasada MiniMax (MSA) para Rubin.
- MoE con conocimiento de localidad: Para aprovechar al máximo el aumento en la banda de memoria HBM de Rubin, aprovechamos los dominios de localidad de CUDA 13.4 para dividir las pesas del MoE. Esto permite que las SMs lea las pesas únicamente desde la memoria más cercana a ellas.
- Rendimiento inicial: Los resultados iniciales ya muestran mejoras impresionantes con vLLM: 7.8 veces el rendimiento por GPU en comparación con el GB200 NVL72 en AgentX, con la misma interactividad, y hasta 3.7 veces más rendimiento en VLM que el GB300 NVL72 en MLPerf. Este es solo el comienzo; esperamos ver aún más rendimiento a medida que continúen las optimizaciones.
¿Qué cambios hace Rubin para la inferencia?
Haga clic para ampliarFigura 1. Comparación por GPU de NVIDIA Vera Rubin NVL72 y GB200 NVL72. Pase el cursor sobre una métrica para resaltar su parte del GPU; “Mostrar tabla” muestra todos los valores. Fuentes: páginas de especificaciones de NVIDIA Vera Rubin NVL72 y GB200 NVL72, así como los blogs de desarrolladores de NVIDIA Rubin.
La plataforma Vera Rubin
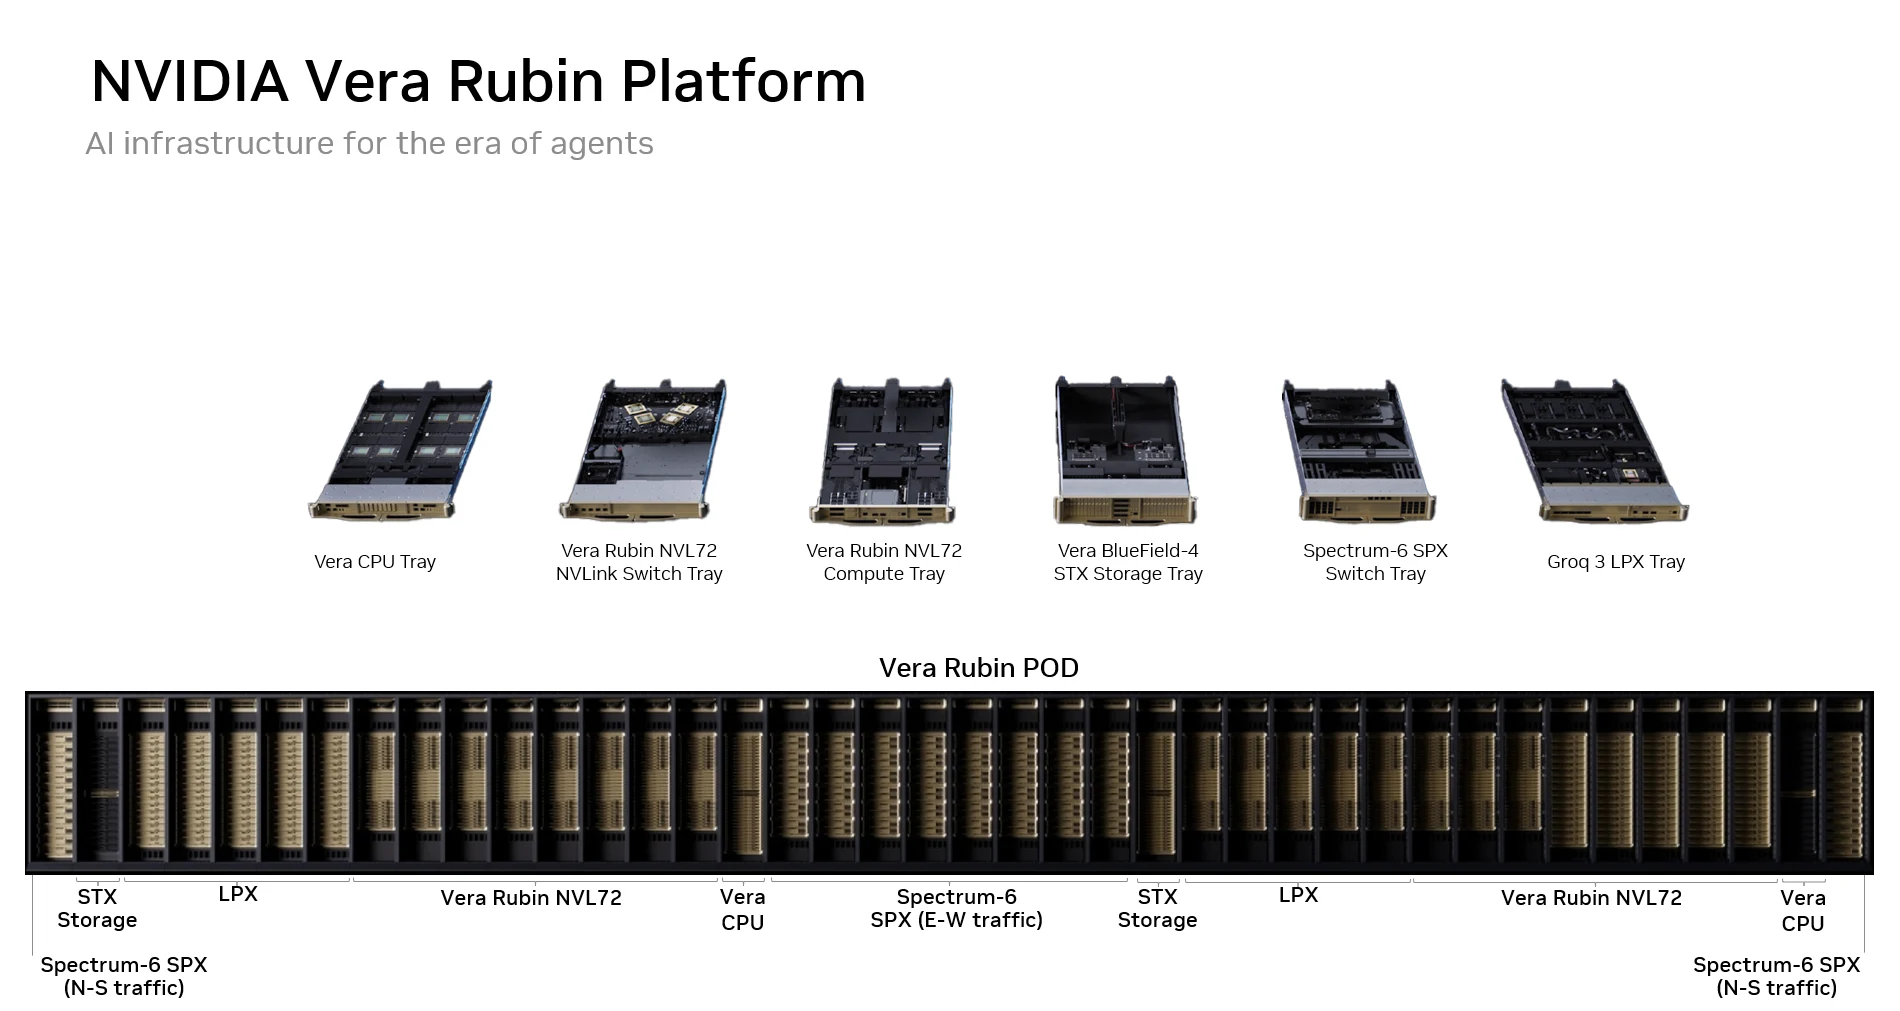
La plataforma Vera Rubin ofrece un rendimiento excelente gracias al diseño conjunto extremo de sus componentes de rack; incluye cinco nuevos sistemas de escala de rack diseñados específicamente para cargas de trabajo de IA agentica: Vera Rubin NVL72, Vera CPU rack, Groq 3 LPX, Spectrum-6 SPX y BlueField-4 STX Storage.
Una sola Vera Rubin NVL72 proporciona 5 veces más FLOPS de inferencia NVFP4 que el GB200 NVL72 y un ancho de banda de memoria 2.4 veces mayor. En el aspecto de la red de escalado, el NVLink de sexta generación ofrece hasta 1.7 veces más ancho de banda que Blackwell, lo que conduce a una experiencia de usuario significativamente mejor en escenarios de servicio agentic de producción.
Softmax. Cabe destacar que Rubin también mejoró el rendimiento de softmax, que es una operación fundamental en la atención de los LLM. Rubin aumenta el rendimiento exponencial, incluyendo un 2x FP32 y un 4x BF16/FP16 en comparación con el NVIDIA GB200, lo que ayuda a que softmax mantenga el ritmo de las operaciones matriciales más rápidas.
Memoria. El HBM en Rubin ha sido actualizado de HBM3e a HBM4, ofreciendo un ancho de banda hasta 2.4 veces mayor en comparación con el GB200 NVL72. En combinación con su capacidad computacional más potente, el GPU de Rubin acelera operaciones clave de inferencia de LLM como GEMM, MoE (mixtura de expertos) y atención, y proporciona un rendimiento general mucho mayor y una latencia de decodificación menor (detalles a continuación).
Redes. La red entre GPU también se ha mejorado significativamente en la plataforma Rubin. El NVLink de sexta generación proporciona un ancho de banda de red 1.7 veces mayor que la generación anterior. Esto acelera las operaciones de comunicación colectivas (por ejemplo, AllReduce y All2all) y otras operaciones de comunicación, mejorando así la velocidad y la escalabilidad de la inferencia de LLM a gran escala (por ejemplo, desagregación de prefill/decode y paralelismo amplio entre expertos).
vLLM: Estado de soporte para Rubin
La comunidad de vLLM ha estado trabajando en la habilitación de Rubin justo después de su anuncio público. Como parte esencial de la comunidad de vLLM, ingenieros de NVIDIA, Inferact y Red Hat han colaborado y contribuido para asegurar que todos los usuarios puedan desplegar modelos arbitrarios en la plataforma Rubin con facilidad.
En esta sección, destacamos el soporte en curso de vLLM para Rubin, es decir, el aprovechamiento de los dominios de localidad, y las mejoras en la usabilidad para una implementación inmediata en hardware Rubin.
Soporte para dominio de localidad
Desde Ampere, las GPU NVIDIA han incorporado accesos de memoria global no uniformes. La característica de dominio de localidad en NVIDIA CUDA 13.4 permite que las aplicaciones aprovechen al máximo los accesos de memoria global no uniformes, colocando el cálculo y los datos dentro del mismo dominio de localidad. Las SM pueden acceder a la memoria global dentro de su propio dominio de localidad con mayor ancho de banda y menor latencia que el HBM en otros dominios. Con Green Contexts y CUDA streams, podemos lanzar un kernel en cada dominio de localidad, de modo que cada kernel pueda acceder a la memoria local. Esta característica acelera principalmente las cargas de trabajo limitadas por memoria, como la decodificación de MoE. Los dominios de localidad siguen en fase de diseño y desarrollo activo. En esta sección, usamos la decodificación de MoE como ejemplo para un análisis más detallado.
Haga clic para ampliarFigura 3. Split-N en MoE hacia adelante en dos dominios de localidad. Las pesas W se dividen por columnas en N/2, y los SMs de cada dominio solo leen la mitad de W en su propia HBM, de modo que cada dominio utiliza su ancho de banda de memoria local. La entrada X y la salida C están en ambos dominios. Utilice Pause, Prev/Next o los chips de paso para seguir los pasos.
El decodificado MoE está limitado por la lectura de pesos desde HBM, por lo que nuestro objetivo es optimizar el rendimiento de la memoria en los dominios de localidad. Al observar primero la nueva característica de dominio de localidad de Rubin, utilizamos la estrategia split-N tanto en FC1 como en FC2, como se muestra en la Figura 3. Dividimos la columna de pesos en partes, colocamos cada parte en la memoria global de cada dominio de localidad, y restringimos los SMs de cada dominio a su partida local. Esto elimina la mayoría de las accesos a memoria entre dominios, lo que conduce a un mejor rendimiento del kernel y a ahorro de energía. Dado que la memoria de activación es relativamente pequeña durante el decodificado, mantenerla no localizada entre dos dominios de memoria causaría un sobrecargo mínimo.
Las SMs no siempre pueden dividirse en dominios iguales. La creación del dominio local, por defecto, no incluirá esas SMs al intentar crear particiones iguales. Para que ambas particiones tengan SMs iguales, es necesario activar cudaDevSmResourceGroupBackfill (modo backfill) al crear los dominios (se refiere a los usuarios a la documentación oficial del dominio local para más detalles). Durante nuestro estudio de rendimiento, incluimos tanto el modo por defecto (solo se utilizan 200 SMs en ambos dominios) como el modo backfill (se utilizan todas las 212 SMs).
La Figura 4 compara el tiempo de avance de la capa preliminar MoE (FC1 + FC2) con los dominios de localidad tanto activos como inactivos para diferentes estrategias paralelas. Utilizamos las formas MoE M3 MiniMax como ejemplo. Con el dominio de localidad activado, podemos obtener consistentemente un aceleramiento promedio de 1.2 veces en configuraciones de avance de pequeños tokens. Y la tendencia sigue siendo más o menos la misma para otras estrategias de servicio TP y EP. Incluso en el modo por defecto, donde solo se utilizan 200 de las 212 SMs, activar los dominios de localidad produce un beneficio similar. La razón principal es que en la decodificación de tokens pequeños, el paso hacia adelante está dominado por el cargamento de peso, y los dominios de localización permiten un mayor rendimiento de HBM. Estos resultados iniciales son solo un punto de partida, con espacio para ajustes y optimizaciones adicionales para maximizar los beneficios de localización en Rubin.
Haga clic para ampliarFigura 4. Latencia preliminar de FC1 + FC2 por rango en la capa MiniMax M3 MoE en Rubin, tanto no localizada como localizada (lo inferior es mejor), con el aceleramiento (latencia no localizada ÷ latencia localizada) por cada par. Las tablas cambian la estrategia paralela (TP2, TP4, EP2, EP4); los interruptores alternan entre el modo de relleno (todos 212 SMs) y el modo predeterminado (200 de 212 SMs). Enrutamiento equilibrado; el tiempo de comunicación no está incluido.
Usabilidad día-0
La usabilidad siempre es la primera prioridad de vLLM. Hoy, los usuarios pueden descargar y utilizar las imágenes nocturnas creadas con CUDA 13.4 y PyTorch 2.15 desde el Docker Hub de vLLM, es decir vllm/vllm-openai:cu134-nightly, para hardware Rubin.
Compatibilidad con la pila de software Blackwell. Rubin se basa en la familia de arquitecturas de Blackwell, con instrucciones extendidas de núcleo tensor tcgen05. Es un nuevo objetivo de compilación de GPU (sm107), pero los kernels construidos para el objetivo de la familia Blackwell (sm100f) también pueden ejecutarse en él. En la práctica, los kernels de Blackwell de vLLM, especialmente aquellos con mucha operación GEMM, como la atención y el MoE, ya pueden ejecutarse en Rubin sin ninguna modificación.
Construcciones de contenedores diarias. Las construcciones de contenedores diarias para Rubin ya están disponibles (#55953), activadas por #53443 y #54640 para la ruta de construcción de Rubin en CUDA 13.4, y #56545 y #59288 para las actualizaciones de dependencias de Rubin.
Cobertura del modelo. Con estas partes instaladas, vLLM ahora puede servir a diversos modelos, incluyendo DeepSeek, Kimi, GLM y MiniMax en Rubin.
Kernels ajustados por Rubin
Poco a poco, los kernels que aprovechan las capacidades y características específicas del hardware de Rubin están siendo lanzados y subidos a las bibliotecas de kernel como FlashInfer, la rama de vLLM de MSA (vllm-project/MSA), Humming (vllm-project/humming), etc. Hasta hoy, vLLM ha integrado algunos kernels importantes para lograr un rendimiento máximo en Rubin, incluyendo GEMM con NVFP4 o MXFP4 densa, NVFP4 MoE, atención en FP8, prefilling de MSA en FP8 y muchos otros.
Rendimiento
Evaluamos el rendimiento de vLLM al ejecutarlo en GPUs Vera Rubin NVL72, utilizando dos pruebas representativas: SemiAnalysis AgentX (detallada en nuestro artículo anterior), y MLPerf Inference v6.1.
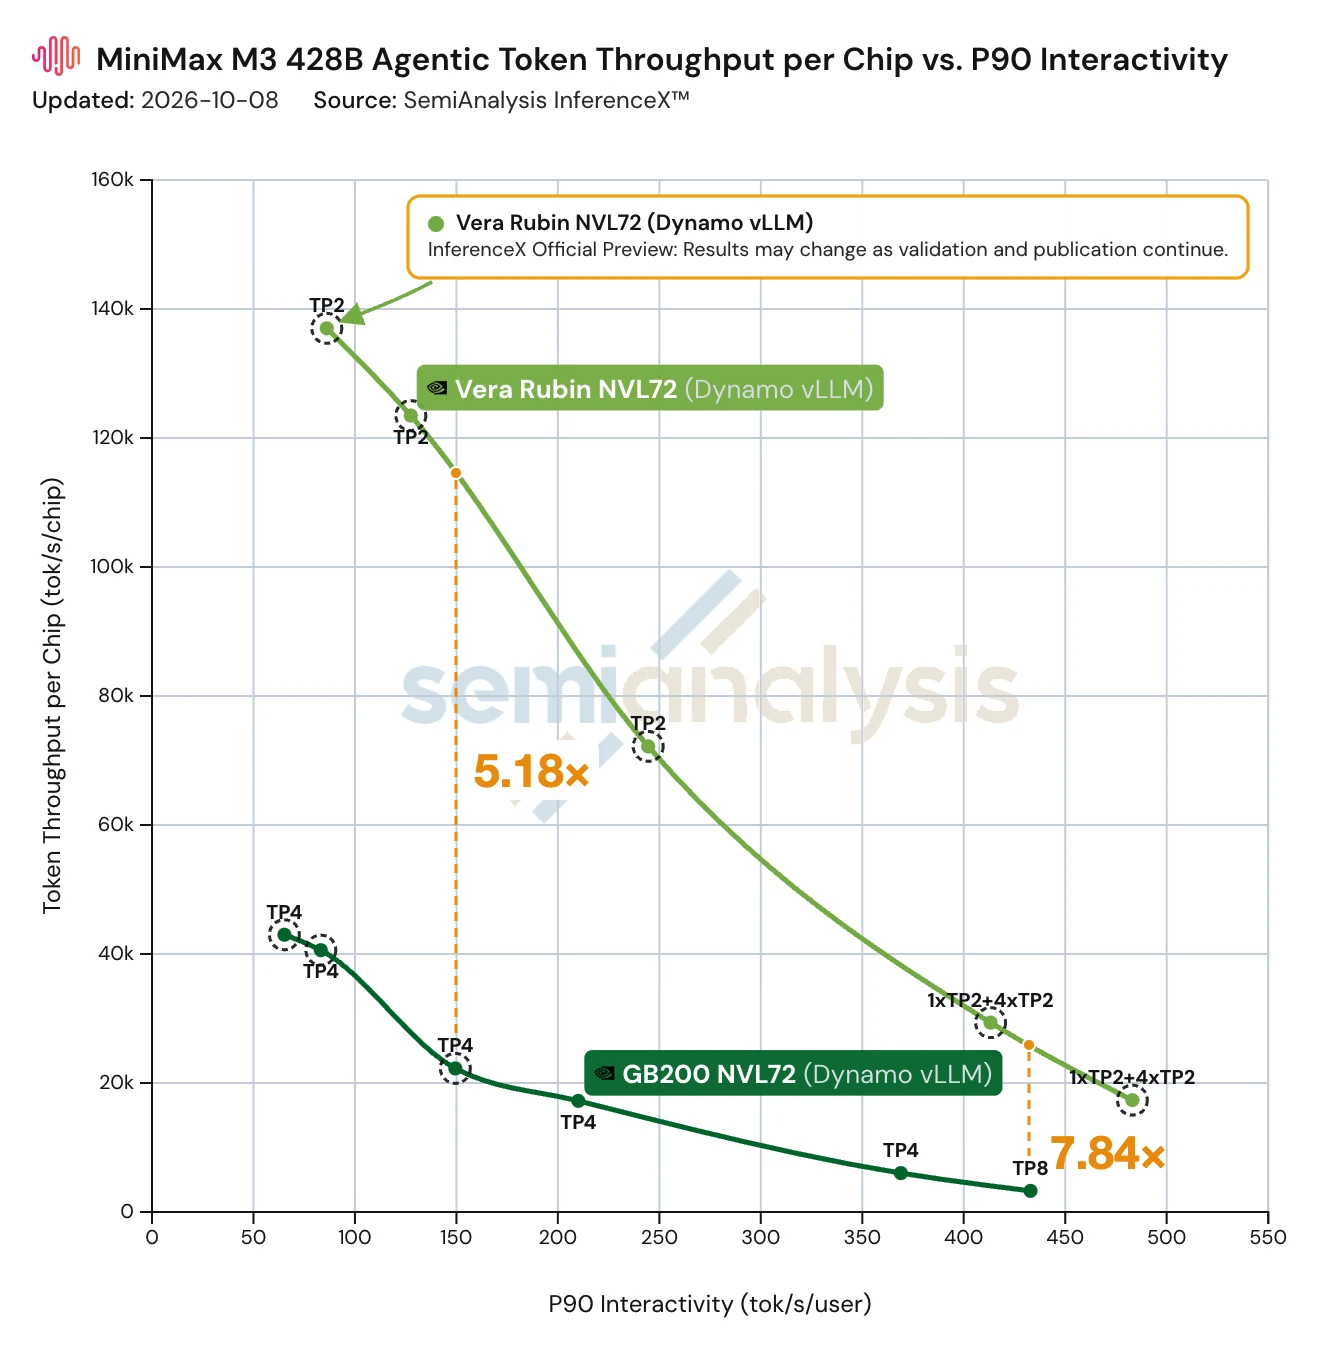
En AgentX, vLLM que ejecuta MiniMax M3 en Vera Rubin NVL72 ofrece hasta 7.84 veces el rendimiento por NVIDIA GB200 con interacción equilibrada, y 5.18 veces más rendimiento bajo una restricción de 150 TPS. Esta es una visión muy preliminar de las capacidades de inferencia de la plataforma. A medida que tengamos acceso a más nodos Vera Rubin NVL72, ampliaremos los tests y aceleraremos la optimización, con expectativas de mayores mejoras en rendimiento a medida que avance ese trabajo.
La ronda de MLPerf Inference v6.1 fue el primer lugar donde se probó vLLM en la plataforma NVIDIA Vera Rubin NVL72. En el benchmark de Modelo de Lenguaje de Visión (VLM), al desplegar el modelo Qwen3-VL-235B-A22B a través de vLLM como motor de inferencia backend y Dynamo como enrutador frontend, Vera Rubin NVL72 ofrece un rendimiento hasta 3.7 veces superior al de GB300 NVL72 en escenarios offline, de servidor e interactivo. Más detalles sobre los resultados publicados de MLPerf Inference v6.1 se encuentran en el artículo del blog de NVIDIA.
Pasos siguientes
“Roma no se construyó en un día”, y el perfeccionamiento de la usabilidad y el rendimiento en las GPU Vera Rubin NVL72 será un camino continuo lleno de emoción. En el futuro inmediato, trabajando juntos como comunidad, planeamos habilitar muchas más funciones nuevas para las GPU Rubin, incluyendo pero no limitado a:
- Integrar el sm107 FlashInfer MegaMoE en vLLM a través de FlashInfer.
- Habilitar completamente los dominios de localidad para las capas MoE.
- Descubre y aprovecha más oportunidades que se superponen entre diferentes capas o núcleos a través de PDL y Lamport Sync.
- Explorar los kernels megáficos para casos de uso sensibles a la latencia.
- Optimizar los kernels KDA y MLA en Rubin para Kimi K3.
- Integrar los kernels Rubin CSA y HCA para DeepSeek-V4.1-Flash.
- Terminar y integrar los kernels de decodificación de Rubin MSA.
- Integrar el kernel CFT counted-write MoE all-to-all en vLLM a través de FlashInfer.
Agradecimientos
Este trabajo es un esfuerzo colaborativo entre Inferact, NVIDIA, Red Hat y la comunidad más amplia de vLLM. Nos gustaría extender un agradecimiento especial a:
- NVIDIA, por acceso anticipado a la Vera Rubin NVL72 y una colaboración estrecha durante todo el desarrollo.
- Inferact y NVIDIA, para liderar la colaboración Rubin, gestionar el ajuste del rendimiento, integrar los núcleos MSA y analizar el rendimiento del MoE consciente de la localidad.
- NVIDIA y Red Hat, por la configuración y activación de las construcciones diarias de Docker para Rubin.
- La comunidad de vLLM, por el soporte continuo y las contribuciones durante todo el proceso.
Apéndice: ejecutar vLLM en Vera Rubin NVL72
Mostrar las configuraciones de kernel para RubinvLLM ya ha integrado algunos kernels altamente optimizados para Rubin. Esta sección trata sobre las configuraciones correspondientes para habilitarlos y lograr un rendimiento máximo en las GPU de Rubin.
- CuTe-DSL denso NVFP4 o MXFP4 GEMM. Por defecto, está activado para un punto de control del modelo NVFP4/MXFP4, pero se puede establecer
--linear-backend flashinfer_cutedslpara NVFP4 o--linear-backend flashinfer_cutlasspara MXFP4 para asegurar que esté activado. - CuTe-DSL NVFP4 MoE. Puede activarlo mediante
--moe-backend flashinfer_cutedsl. - CuTe-DSL maskado agrupado GEMM para NVFP4 W4A4 MoE en el formato “batched” expert. Esto es aplicable a una implementación con
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_epdondeN>1. En este caso,--moe-backend auto|flashinfer_cutedslambos se resolverían en este kernel. - CuTe-DSL FP8 BMM para capas lineales estáticas de per-tensor FP8 W8A8. Está activado por defecto y puede ser utilizado por el autotuner de FlashInfer.
- Trtllm-gen FP8 atención. Para activarla, se necesita la caché KV en FP8 mediante
--kv-cache-dtype fp8o un checkpoint que especifique una caché KV en FP8, así como la configuración de--attention-backend FLASHINFER|FLASHINFER_MLA. Para el prealfabetización MLA estilo DeepSeek, también se debe agregar-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true. - CuTe-DSL FP8 MSA prefill. Para activarlo, es necesario utilizar la caché de KV FP8 a través de
--kv-cache-dtype fp8o un punto de control que especifique una caché de KV FP8, además de establecer--attention-config.minimax_m3_msa_decode_backend=cutlass.