
LFM2.5-24B-A2B es un modelo de razonamiento de 24B parámetros con solo 2B parámetros activos, diseñado para agentes rápidos y privados en el dispositivo. Piensa antes de responder, llama a herramientas y trabaja en tareas multietapa dentro de los sistemas de agentes populares. Como solo 2B parámetros están activos por token, cada token de razonamiento es económico, por lo que se puede ejecutar agentes continuamente en el propio hardware.
- Agente de primera clase: Competitivo con Qwen3.6-35B-A3B, un modelo con ~50% más parámetros totales y activos, en tareas de agentes y uso de herramientas, obteniendo una puntuación de 48.09 en LiveClaw frente a 38.19.
- Razonamiento a velocidad MoE: Siempre piensa antes de responder. Con solo 2B parámetros activos por token, cada token de razonamiento es económico.
- Inferencia eficiente: 184 tok/s en un Apple M5 Max y hasta 21K tok/s de salida por tok/s en un único GPU NVIDIA B300.

Cómo construimos un agente de razonamiento con 2B parámetros activos
LFM2.5-24B-A2B se basa en LFM2-24B-A2B y mantiene su arquitectura: 40 capas, 64 expertos por bloque MoE con enrutamiento top-4, y el mismo híbrido de convoluciones cortas cerradas y GQA. La ventana de contexto aumenta de 32K a 131K tokens, y un expansión de tokenizer en lugar de lugar duplica el vocabulario de 65K a 128K tokens para una mejor tokenización no latina. A diferencia de su predecesor, es un modelo de solo razonamiento que produce una cadena explícita de pensamiento antes de su respuesta final.
El preentrenamiento fue escalado de ~17T a ~33T tokens. Durante la fase de entrenamiento intermedio, se añaden 2T tokens en 32K contexto, con un peso hacia el razonamiento, las matemáticas, el código, el seguimiento de instrucciones y el texto multilingüe; además, se añaden 300B tokens en 131K contexto, con un peso hacia los datos de largo contexto. Las llamadas de herramientas y las trayectorias de varios turnos aparecen en ambas fases. Después del entrenamiento, el modelo base se convierte en un agente en cinco etapas:
- Supervisado ajuste fino (SFT)
- Especialización del profesor
- Distribución en política multi-dominio (MOPD), no agentic: distribuir a los maestros especialistas en tareas no agentic.
- MOPD, agentic: una segunda etapa de destilación centrada en tareas agenticas.
- Aprendizaje refuerzo agente (Agentic RL): entrenar el modelo dentro de las herramientas agentes, como OpenClaw, Hermes Agent, Pi y OpenCode.
Resultados del benchmark
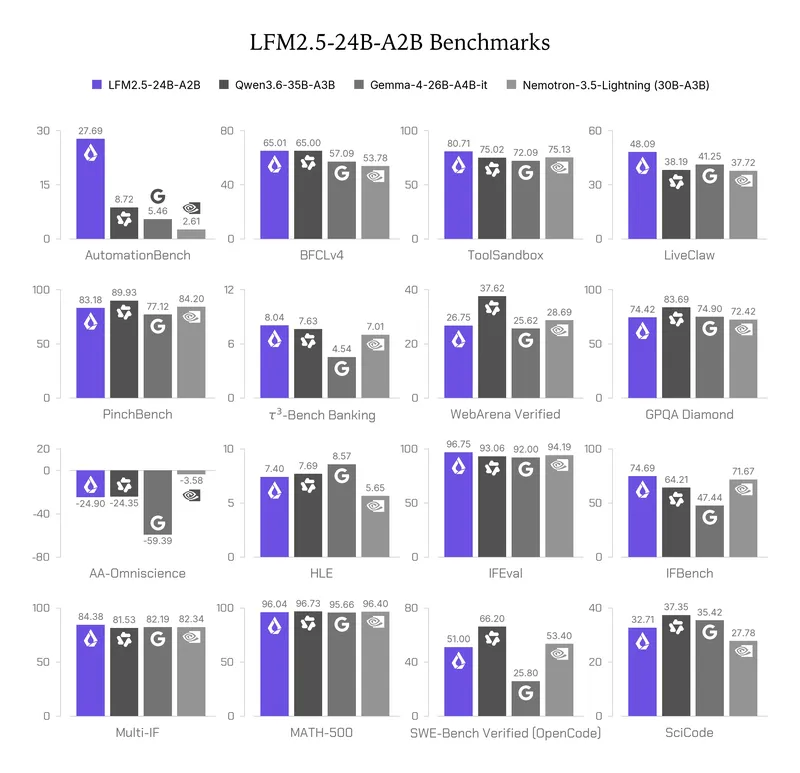
Evaluamos LFM2.5-24B-A2B en comparación con Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it y Nemotron-3.5-Lightning en 16 puntos de prueba que abarcan el uso de herramientas y flujos de trabajo agenticos, conocimiento, seguimiento de instrucciones, matemáticas y programación. Es el modelo más pequeño del grupo, pero es competitivo con MoEs con ~50% más parámetros totales y activos.
| Punto de referencia | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verificado | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omnisciencia | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verificado (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*Todos los modelos fueron evaluados con vLLM, utilizando los parámetros de generación recomendados para cada benchmark.*
Para su aplicación, las ventajas son el uso de herramientas y la seguimiento de instrucciones. LFM2.5-24B-A2B lidera o iguala a la competencia en cinco de los ocho índices de uso de herramientas y agentes (AutomationBench, BFCLv4, ToolSandbox, LiveClaw y τ³-Bench Banking), y en AutomationBench obtiene más del triple de la puntuación del modelo siguiente en mejor posición. También lidera en los tres índices de seguimiento de instrucciones. Los modelos más grandes mantienen una ventaja en pruebas de benchmark con mucha información, como GPQA Diamond, HLE y AA-Omniscience, así como en pruebas de codificación como SWE-Bench Verified (OpenCode) y SciCode. Por lo tanto, se recomienda usar LFM2.5-24B-A2B junto con recuperación o búsqueda web para cargas de trabajo que requieren mucha información.
Estos resultados hacen que LFM2.5-24B-A2B sea una base sólida para los agentes que necesitan razonar, llamar a herramientas y funcionar de manera confiable en su dispositivo.
Velocidad de inferencia en CPU y GPU
LFM2.5-24B-A2B viene con soporte desde el primer día en todo el ecosistema de inferencia, incluyendo llama.cpp, MLX, vLLM, SGLang y ONNX.
Inferencia de Edge. LFM2.5-24B-A2B es el más rápido entre los MoEs comparados: decodifica 184 tokens/s en un M5 Max y 114 tokens/s en un Ryzen AI Max+ 395. Esto es hasta 1.7 veces más rápido que el modelo siguiente, mientras se utiliza la menor cantidad de memoria.

Inferencia de GPU. LFM2.5-24B-A2B es el modelo más rápido en su clase de tamaño, alcanzando más de 21K tokens de salida por segundo con alta concurrencia en un solo B300.

Cómo utilizar LFM2.5-24B-A2B
Abra LFM2.5-24B-A2B cuando necesite agentes que razonen, utilicen herramientas de llamada y funcionen de manera confiable en su dispositivo.
Instalar la versión más reciente de transformers (compatible con transformers>=5.0.0):
pip install -U transformers
Luego cargue y ejecute el modelo:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
Usa esto en tu agente harness
Sirva LFM2.5-24B-A2B localmente detrás de cualquier backend compatible con OpenAI, y luego dirija su dispositivo de agente hacia él. Por ejemplo, con el Hermes Agent:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
La puerta de enlace depende del backend de servicio que utilice: llama.cpp y MLX usan 8080, vLLM usa 8000, SGLang usa 30000, y LM Studio usa 1234. Consulte la tarjeta de modelo para las configuraciones de OpenClaw y Pi, y nuestro guía para la configuración completa. Visite nuestro blog de lanzamiento para ver ejemplos en video.
> Comenzar con LFM2.5-24B-A2B
Tanto LFM2.5-24B-A2B como LFM2.5-24B-A2B-Base son de peso abierto y están disponibles en Hugging Face hoy:
- Descargar: LFM2.5-24B-A2B-Base y LFM2.5-24B-A2B en Hugging Face.
- Uso en tu arnés: sigue nuestro guía sobre cómo ejecutar un agente local, como OpenClaw, Hermes Agent y Pi.
- Ajustar: adaptar LFM2.5-24B-A2B a su tarea con nuestros tutores de ajuste fino.
No podemos esperar ver qué construirá.
Cita
Si utiliza este trabajo, por favor cita el blog de lanzamiento:
@article{liquidAI202624BA2B,
  author  = {Liquid AI},
  title   = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}