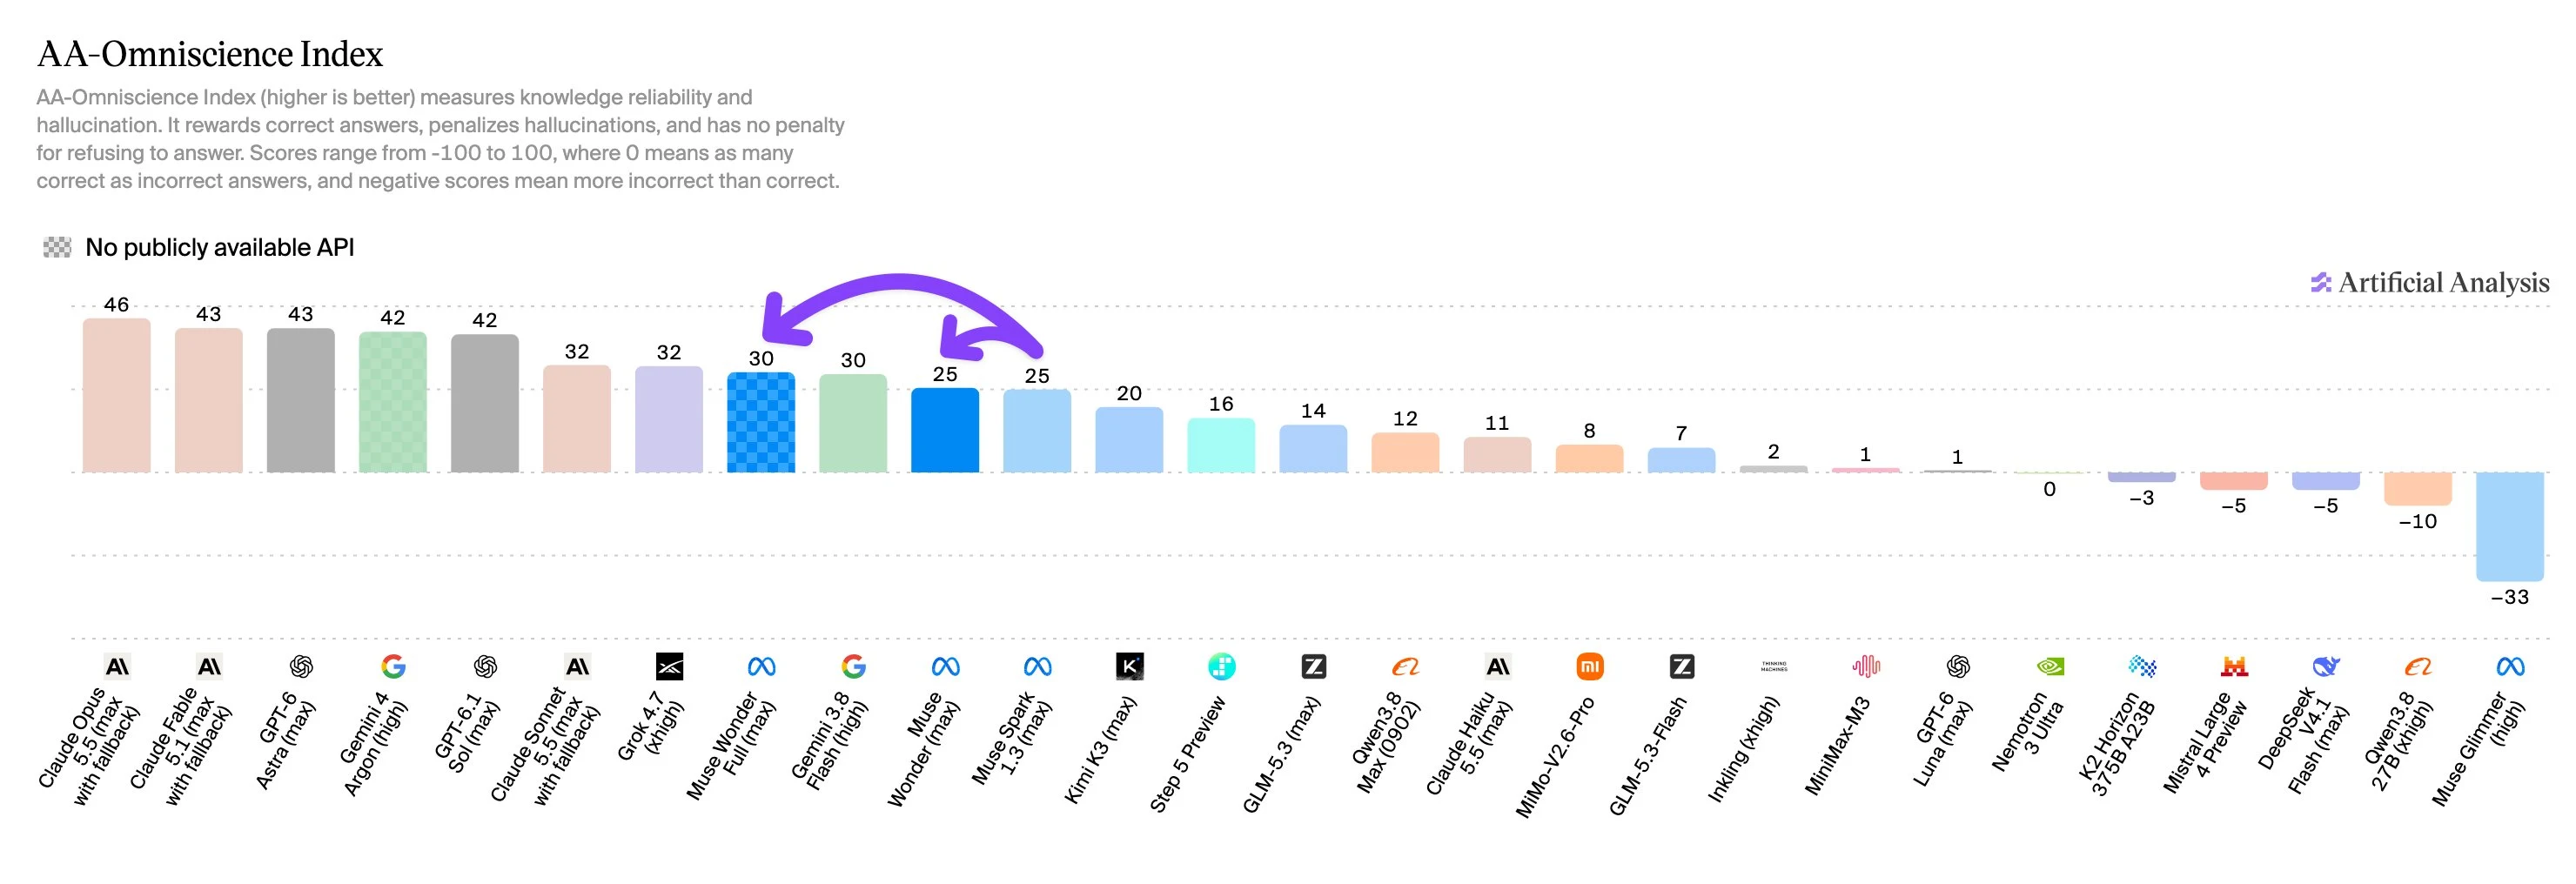
El conocimiento sigue siendo una debilidad relativa para ambos modelos, pero esto se ve mitigado por tasas de alucinación muy bajas. En AA-Omniscience, Muse Wonder Full (max) obtiene 30 y Muse Wonder (max) obtiene 25, al nivel de Muse Spark 1.3 (max), por debajo de, por ejemplo, Claude Opus 5.5 (46), GPT-6 Astra (43), Gemini 4 Argon (42) y Claude Sonnet 5.5 (32)
La ganancia de 5 puntos de Muse Wonder Full (max) proviene de reducir su tasa de alucinación (del 33% al 23%), lo que lo sitúa entre los modelos con menos alucinaciones de los probados: tiene la segunda tasa de alucinación más baja de cualquier modelo con 45 o más puntos en el Intelligence Index, solo por detrás de Gemini 4 Argon (high, 15%). Muse Wonder (max) es el tercero con un 27%