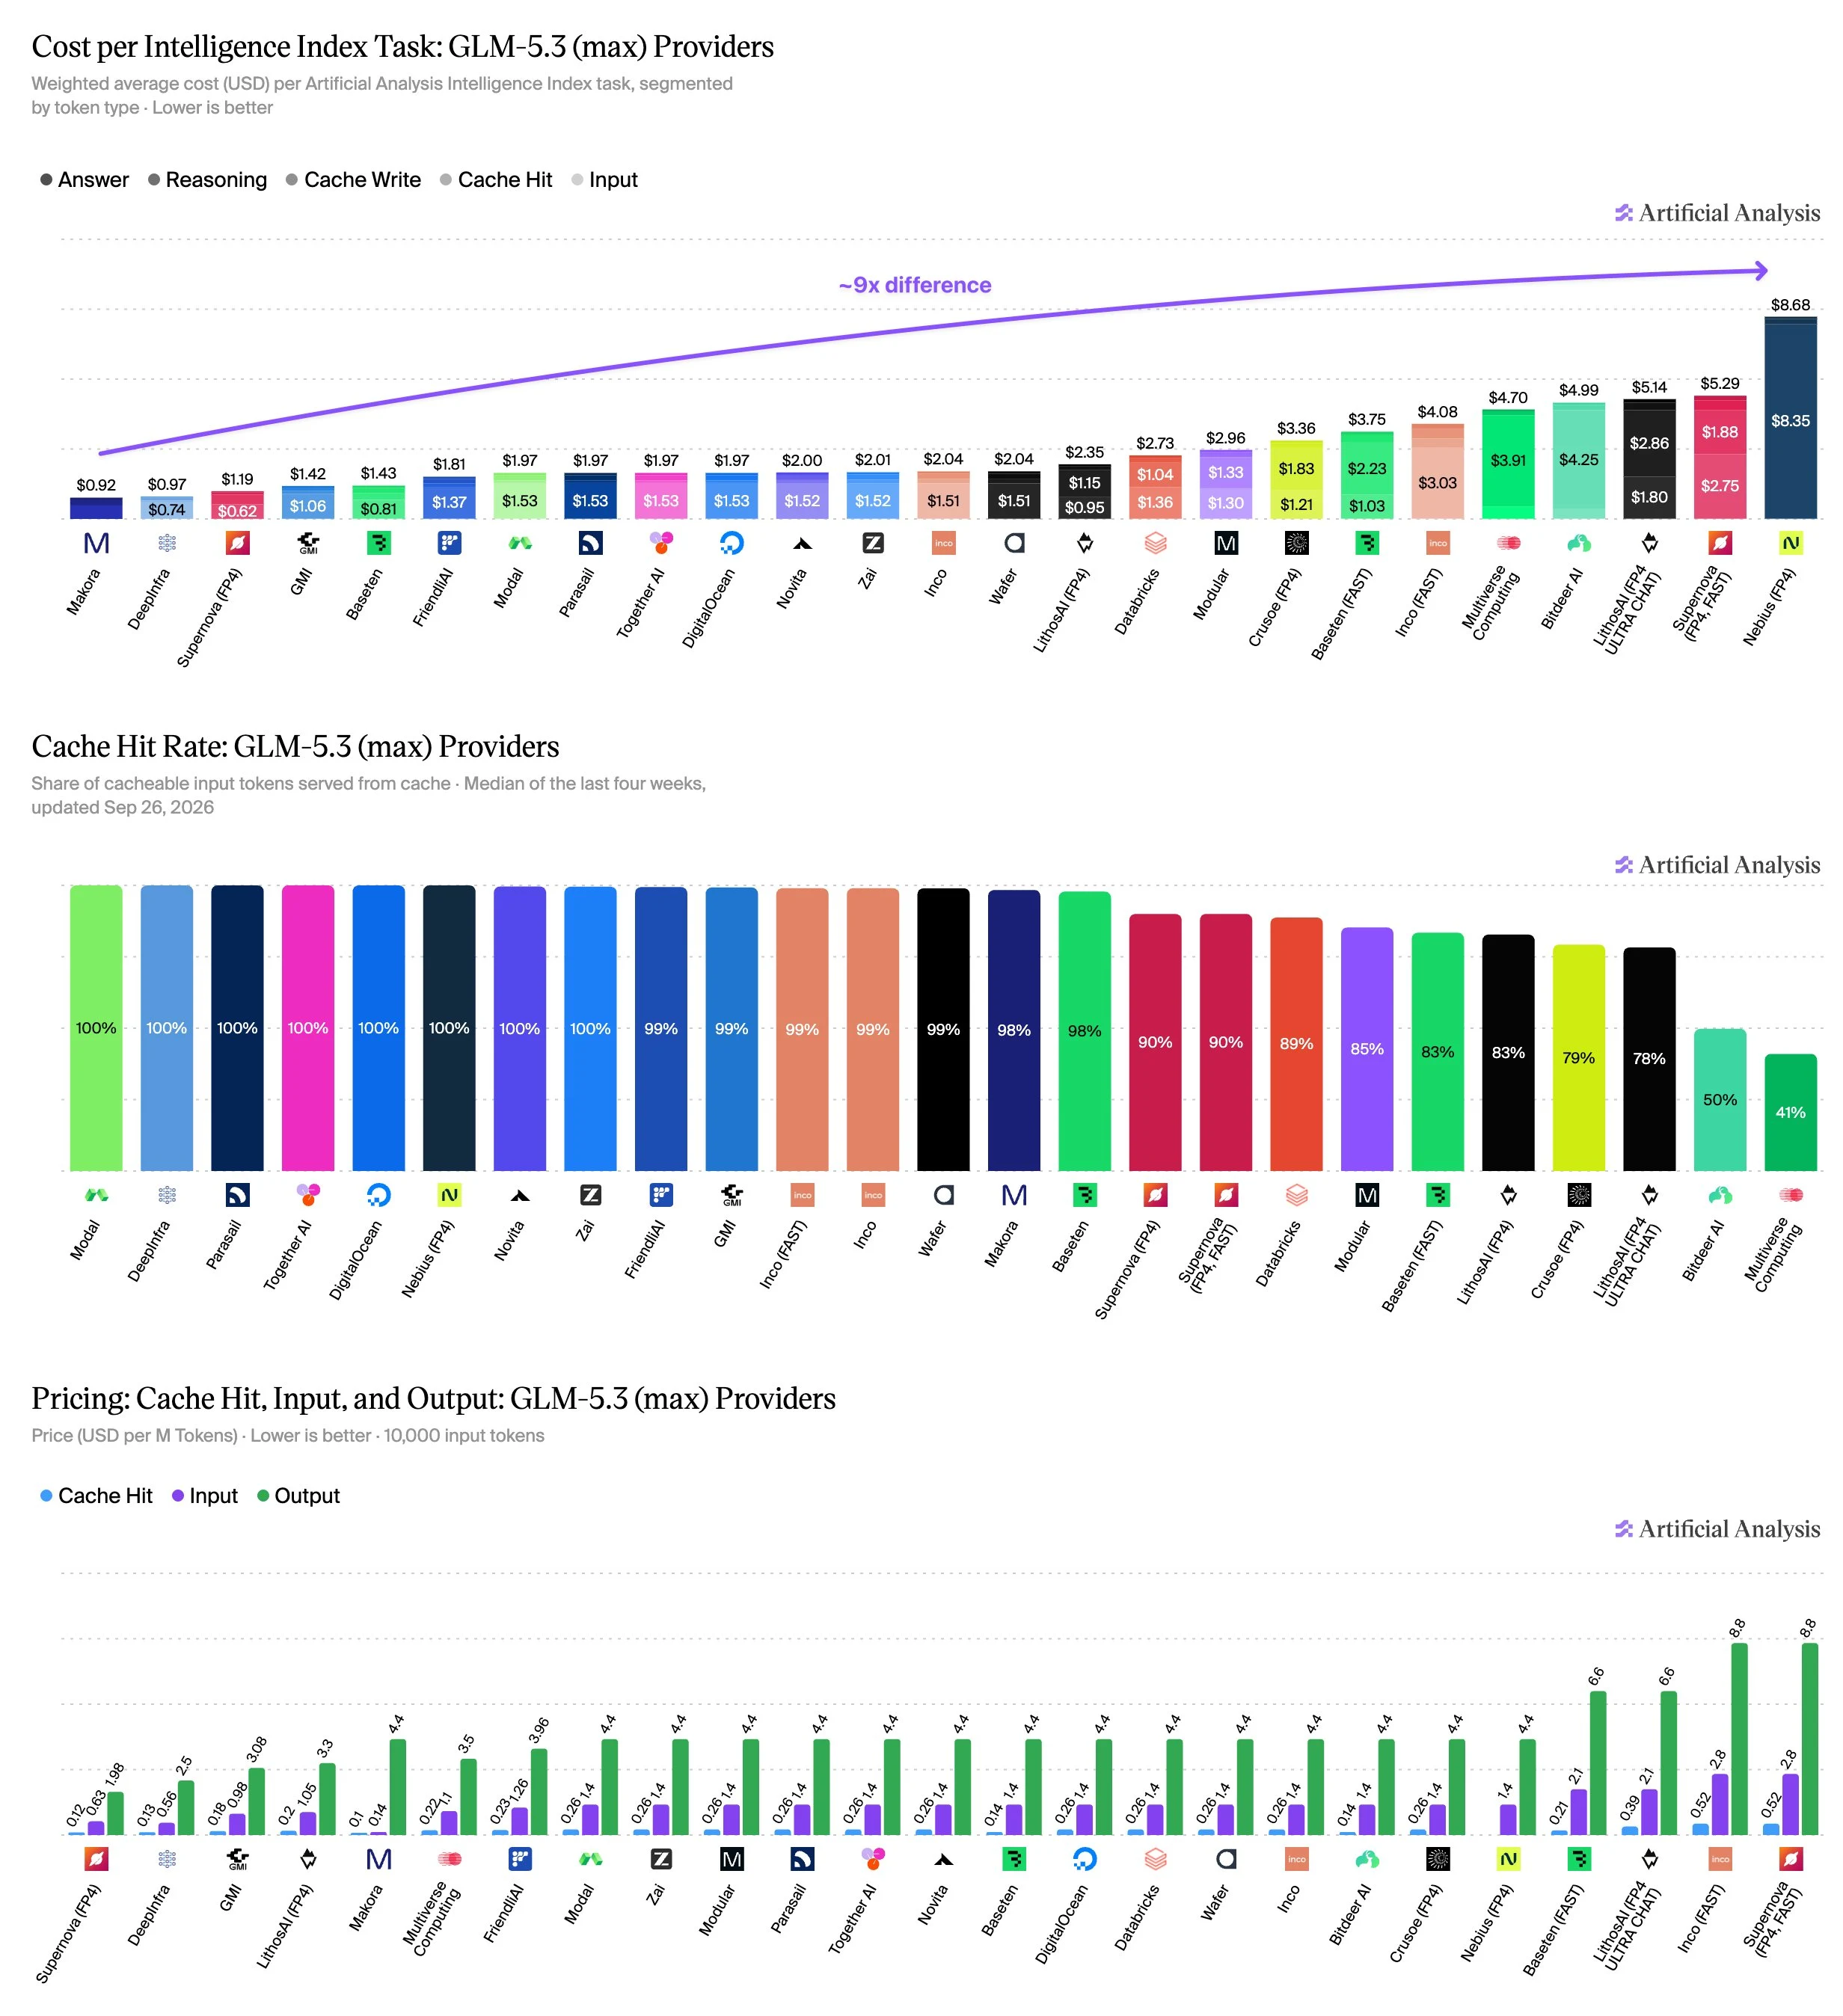
Las tasas de acierto en el caché y el costo por tarea según el proveedor están ahora disponibles en Artificial Analysis: El costo por tarea para GLM-5.3 (máximo) varía aproximadamente 9 veces entre los proveedores, debido a una combinación de la tasa de acierto en el caché y los precios de los tokens
Los trabajos de carga agentic reenvían todo el historial de conversación en cada turno, por lo que la mayoría de los tokens de entrada son accesibles en la caché. Los precios de la caché y las tasas de acierto en la caché determinan la mayor parte de la diferencia en el Coste por Tarea. Ya utilizamos las tasas de acierto en la caché medidas para calcular el Coste por Tarea, y ahora las publicamos para cada punto final del modelo que rastreamos.
¿Qué novedades?:
➤ Las tasas de hito en la caché ahora son visibles para todos los endpoints de primera y tercera parte, medidas mediante la ejecución de tareas de codificación agentic de múltiples turnos y la lectura de tokens almacenados en cada proveedor. La tasa de hito en la caché es la proporción de tokens de entrada almacenables que se sirven desde la caché.
➤ El coste por tarea está ahora disponible para los proveedores de modelos con pesos abiertos, calculado a partir de los precios de entrada, salida, hito en la caché y escritura en la caché de cada proveedor, aplicados a su tasa de hito en la caché medida. Para estandarizar entre proveedores para un modelo dado, utilizamos los mismos números de entrada, salida y tokens almacenables del Index de Inteligencia del modelo.
Puntos clave:
➤ El costo por tarea en GLM-5.3 (máximo) varía entre 9 veces en los proveedores, desde $0.92 en Makora hasta $8.68 en Nebius. Ambos ofrecen casi todo el contenido que se puede almacenar en la caché (98% y 100%), y cobran el mismo precio de salida ($4.40 por 1M tokens), por lo que la diferencia proviene de los precios de entrada: Makora cobra $0.10 por 1M tokens de entrada almacenada, mientras que Nebius no ofrece descuento por entrada almacenada en sus endpoints sin servicio en la nube compartidos y factura todo el contenido a un precio completo de $1.40.
➤ La tasa de acierto en la caché varía entre 41% y 100% entre 21 proveedores (25 endpoints). 15 endpoints tienen una tasa de 98% o más, y ocho tienen un 100%: Modal, DeepInfra, Parasail, Together AI, DigitalOcean, Nebius, Novita y la API de primera parte de Z AI. Multiverse Computing tiene la menor tasa, del 41%, seguida por Bitdeer con un 50%.