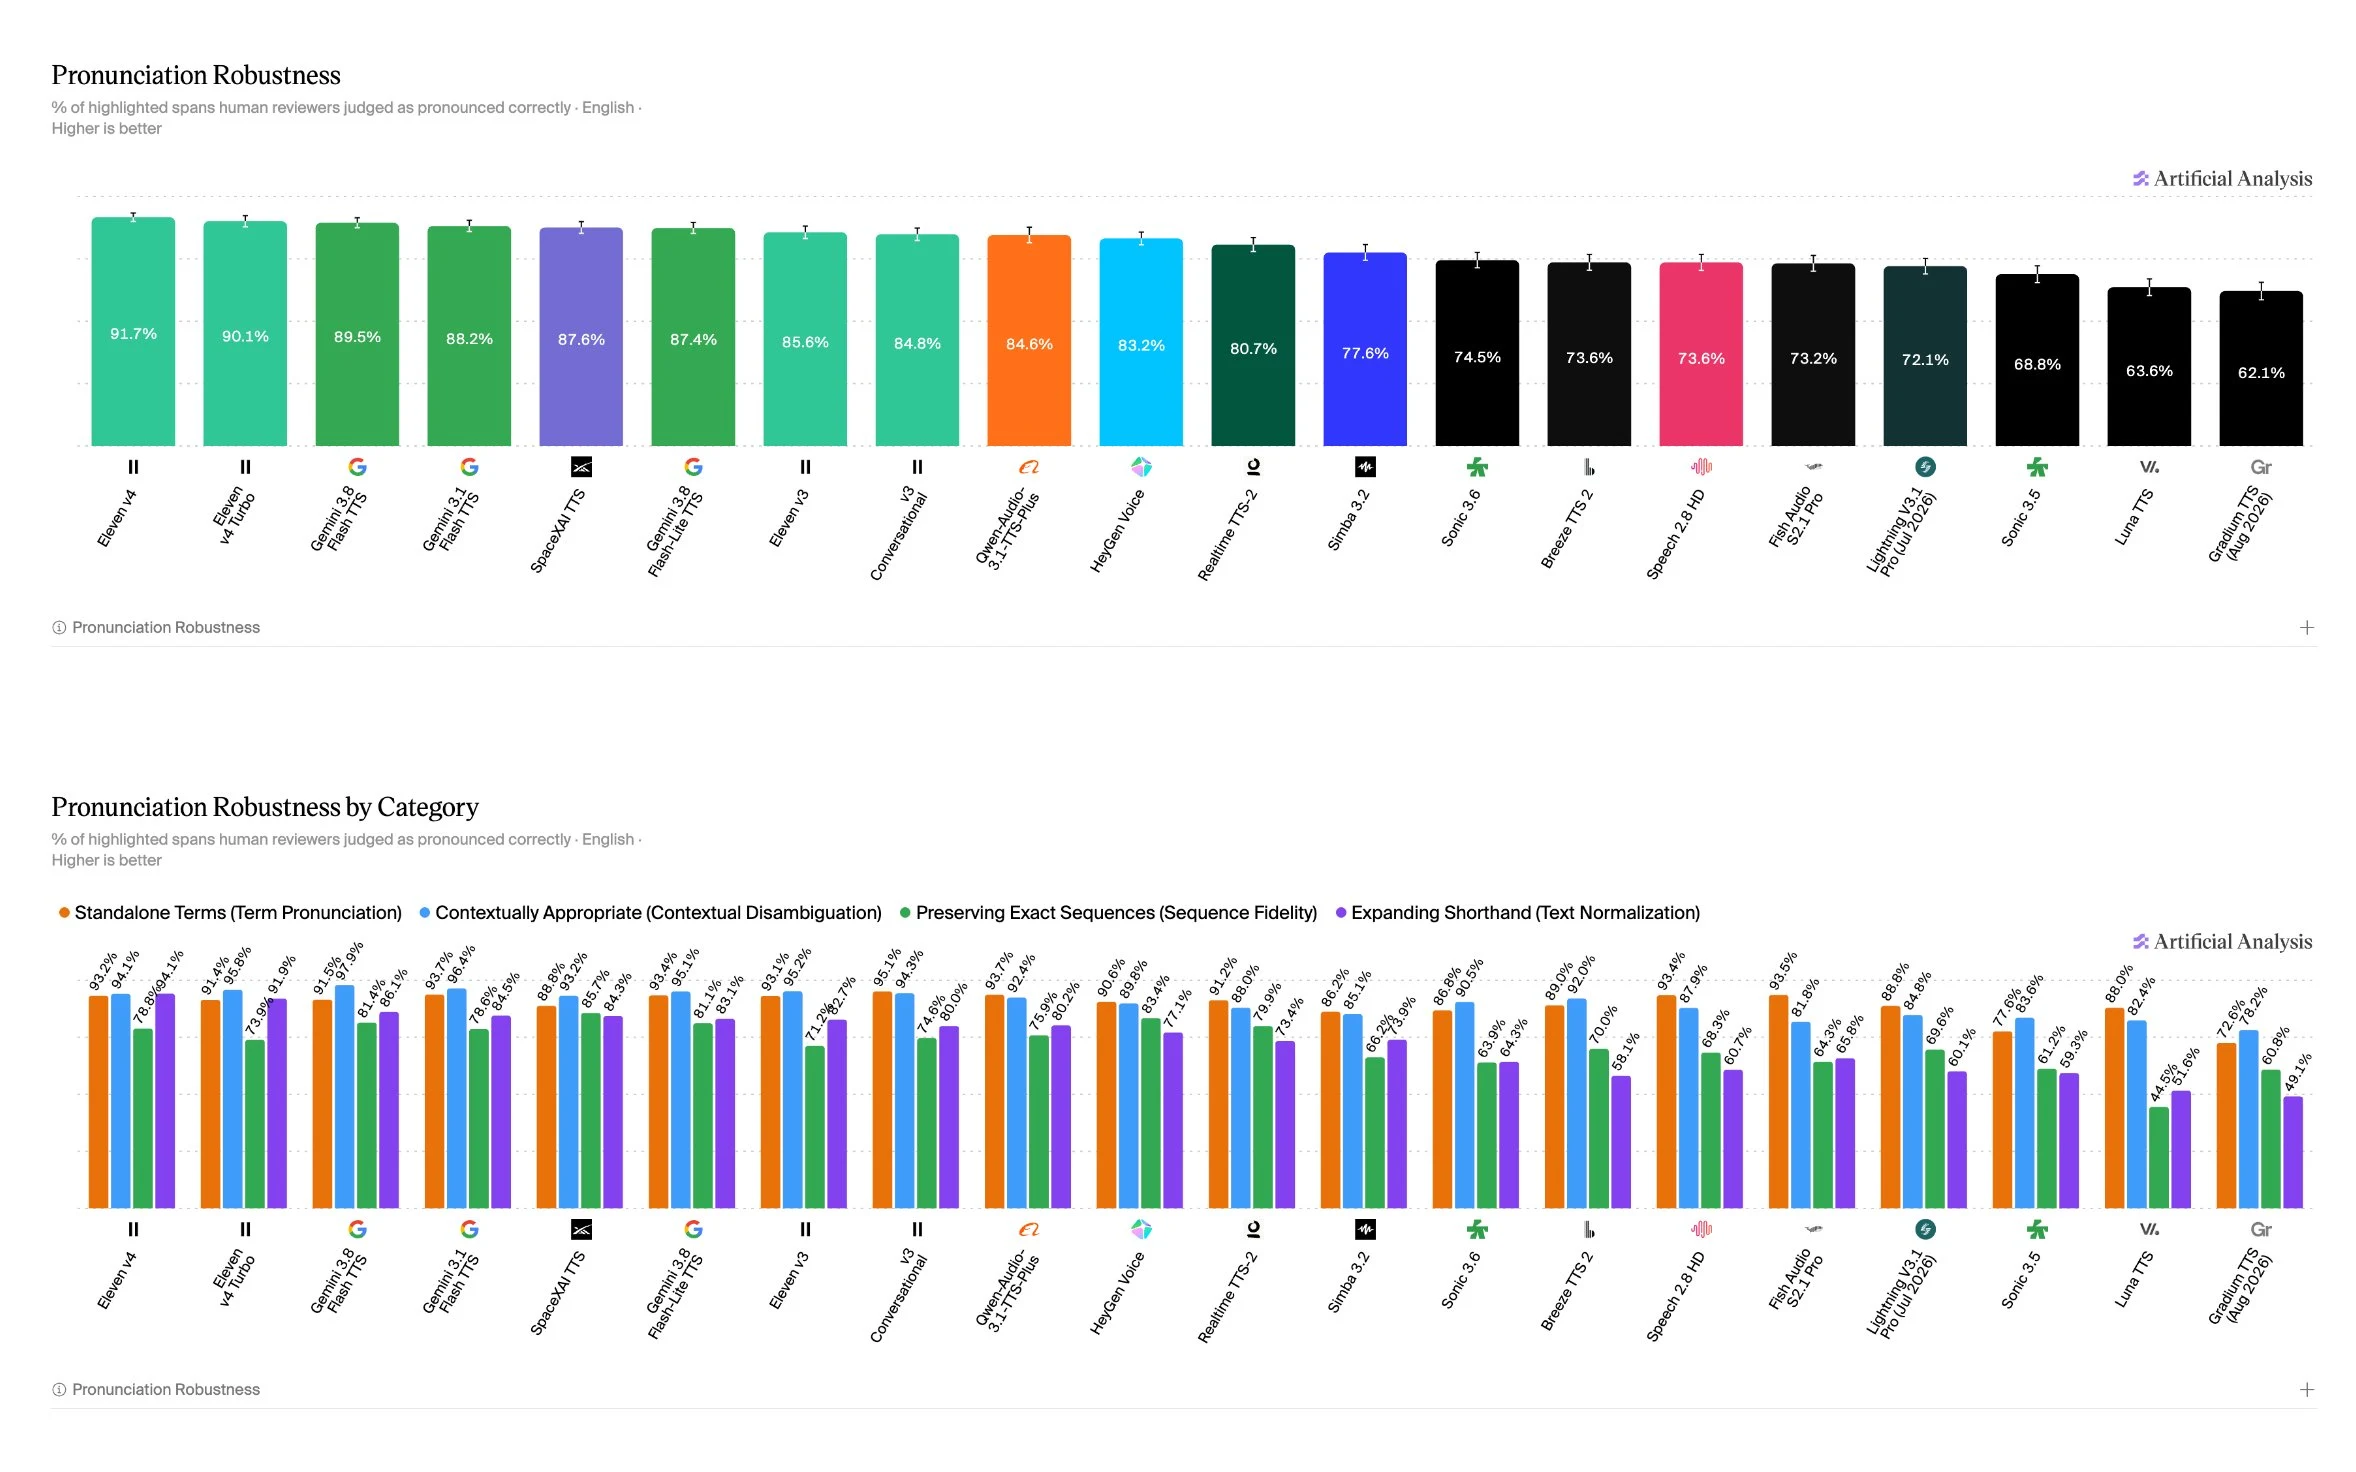
HeyGen Voice obtiene una puntuación del 83.1% en general en el benchmark de Pronunciation Robustness de Artificial Analysis, ocupando el puesto #10 de 29 modelos.
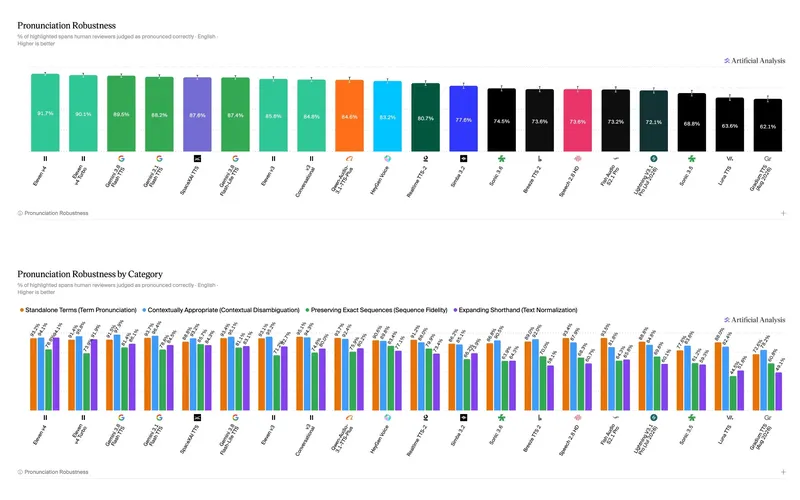
Pronunciation Robustness mide si los modelos de Text to Speech pronuncian correctamente textos desafiantes en cuatro categorías, con revisores humanos que evalúan cada clip contra pronunciaciones aceptadas acordadas previamente.
➤ Preservación de Secuencias Exactas: 83.3%, ocupando el puesto #2 por detrás de SpaceXAI TTS con 85.7%
➤ Términos Independientes: 90.5%, con Eleven v3 Conversational a la cabeza con 95.1%
➤ Apropiado en Contexto: 89.8%, con Gemini 3.8 Flash TTS a la cabeza con 97.9%
➤ Expansión de Abreviaturas: 77.0%, en comparación con Qwen-Audio-3.1-TTS-Plus con 80.2%, y Eleven v4 a la cabeza con 94.1%