
Jin Lei, desde Ao Fei Si
Quantum Bit | Cuenta oficial de WeChat: QbitAI
¿Qué?35BdeMoE, enteléfono móvil¿También puede funcionar con total fluidez?
¡Sí~ Es verdad.
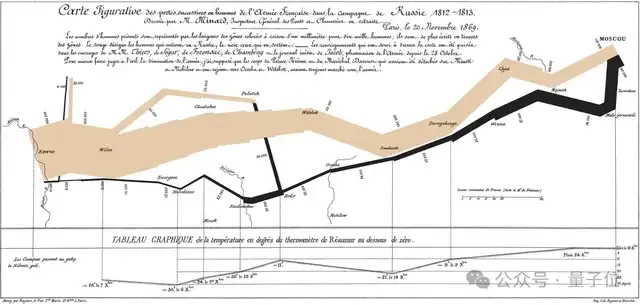
Nosotros directamente enSin conexión a Interneten estado, dariPhone 17 Pro MaxSubida desde el teléfono una imagen clásica de visualización de datos: el mapa de la ruta de la marcha fallida de la expedición de Napoleón a Rusia:
Luego hacemos la pregunta directamente:
¿Cuál es la temperatura mínima registrada en la imagen, en grados Celsius, y en qué día ocurrió? Explica también el proceso de conversión.
Se puede ver que en menos de 1 minuto, el modelo del teléfono de Apple encontró la anotación de 30 grados bajo cero en esa línea, determinó que la fecha era el 6 de diciembre de 1812 y, tras hacer la conversión de 1 grado Réaumur = 1.25 grados Celsius, dio la respuesta de 37.5 grados bajo cero Celsius.
Y además, la velocidad del modelo en este teléfono móvil,Podría ser aún más rápido。
Por ejemplo, con la misma foto de una señal de estacionamiento en la calle y la misma pregunta sobre la hora de estacionamiento, a la izquierda está el modelo de 35B sin optimizar y a la derecha el modelo optimizado:
Se puede ver que, sin optimizar, la velocidad era de aproximadamente 2 tokens por segundo; pero tras la optimización, la velocidad alcanzó los 8-12 tokens por segundo. Incluso sin conexión a Internet, las respuestas salían a toda velocidad.
Según se sabe, la velocidad de decodificación de este modelo de 35B en un iPhone 17 Pro Max, ocupando solo 3 GB de memoria, puede alcanzar¡Más de 13 tokens por segundo!
Suave, realmente es bastante suave.
Entonces, ¿qué clase de IA es exactamente este modelo que puede funcionar así en un teléfono móvil?
Sin rodeos: se trata de MiniCPM-V 4.7, que acaba de ser lanzado oficialmente en código abierto por ModelBest (面壁智能) y OpenBMB. Incluye dos versiones de distinto tamaño:
- 35B-A3B: 35B de parámetros totales, activando solo 3B en cada inferencia, y también es el primer modelo MoE de la serie MiniCPM-V. Solo necesita unos 3G de memoria para funcionar con fluidez en dispositivos iOS y Android.
- 1B: con 1.3B de parámetros reales, se destaca por su tamaño extremadamente reducido, y en OCR, matemáticas y comprensión de video se sitúa en el primer nivel entre los modelos de su mismo tamaño.
Sin embargo, siendo justos, correr rápido es solo un aspecto; entonces, ¿qué nivel representa realmente MiniCPM-V 4.7 dentro del círculo de los grandes modelos en el dispositivo?
Visión generalEn cuanto a lo anterior, el 35B-A3B obtuvo 91.72 en MMBench y 80.67 en MMStar;Pregunta de cienciasen cuanto a, MMMU y MathVista son respectivamente 80.22 y 88.00.Comprensión de videoTambién obtuvo 76.40 y 68.90 en Video-MME y LongVideoBench.
Especialmente en OmniDocBench v1.6, 35B-A3B obtuvo94.24 puntos, mientras que los otros cuatro modelos rondan los 80 puntos, lo que supone una ventaja de más de 12 puntos.
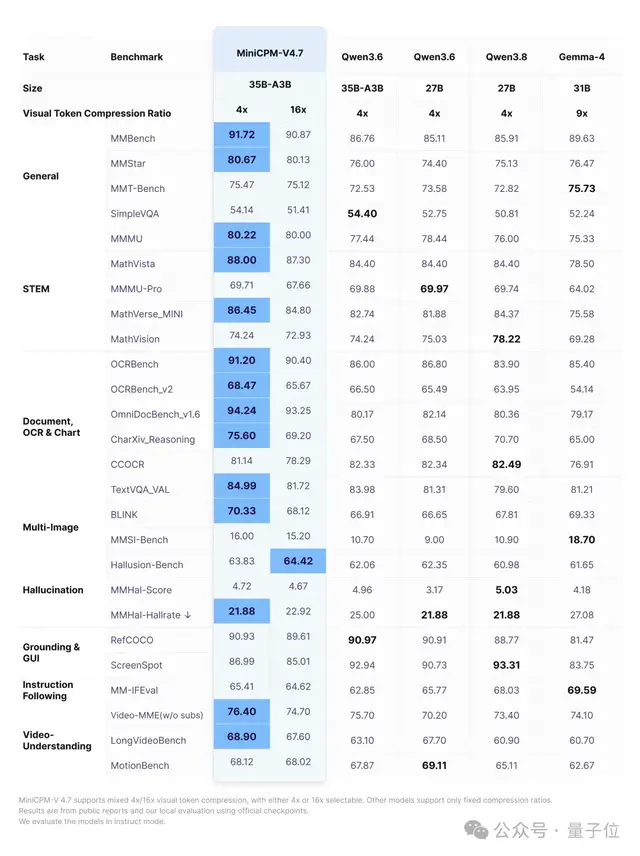
Merece aún más mención el rendimiento después de llevar la compresión visual a 16 veces. MMBench solo baja de 91.72 a 90.87, y OCRBench de 91.20 a 90.40: la potencia de cómputo ahorrada apenas se canjeó por precisión.
Además de esto, MiniCPM-V4.7 enCapacidades de texto sin formatoEn chino, el conocimiento CMMLU obtuvo 90.21, y la llamada de herramientas τ2-Bench obtuvo 84.65, también los más altos de la tabla.
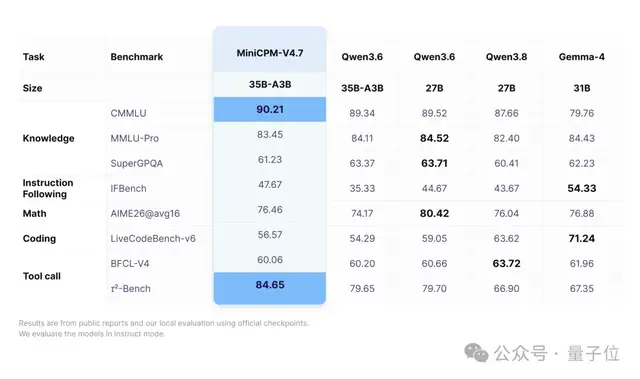
Según se ha informado, MiniCPM-V4.7 esEl primeroUn modelo MoE de código abierto que puede funcionar fluidamente en el dispositivo sin sacrificar el rendimiento.
A continuación, veamos más de sus efectos.
Lleva el 35B en el bolsillo y úsalo incluso sin conexión a internet
Comencemos con un problema bastante cercano a nuestra vida cotidiana.
Lo que se introdujo al modelo esta vez era una encuesta de consumo eléctrico del hogar, en la que figuraban la potencia y el tiempo de uso del aire acondicionado, el refrigerador, la hervidora eléctrica, el televisor, la lavadora y los dispositivos en espera, junto con la factura de la luz de este mes: 420 kilovatios-hora en total, 126 yuanes.
Esta pregunta tiene en total tres partes, que son:
Primero estime cuánta electricidad consume cada aparato al mes y ordénelos; luego calcule qué porcentaje de la factura pueden explicar estos aparatos sumados y si la parte restante puede atribuirse por completo a los demás aparatos; por último, elija el más ahorrador entre tres planes de ahorro de energía: que el aire acondicionado funcione 1 hora menos al día, ver 2 horas menos de televisión al día, y desconectar por completo los dispositivos en espera durante 8 horas al día.
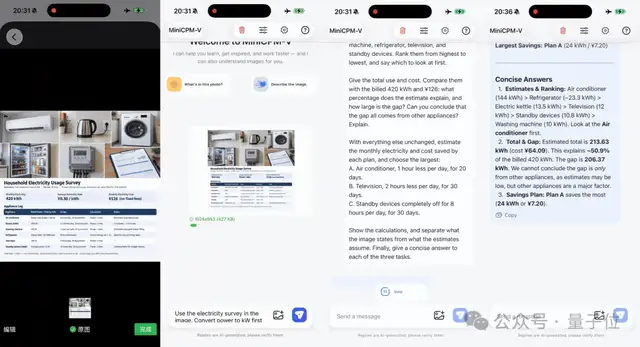
Por los resultados, el 35B-A3B primero convirtió los vatios a kilovatios y luego multiplicó la potencia por el tiempo de uso, calculando punto por punto. El aire acondicionado consume 144 kWh al mes, en primer lugar; la nevera, según su etiqueta de 280 kWh anuales, equivale a unos 23.33 kWh al mes; después vienen el hervidor eléctrico, el televisor, los dispositivos en espera y la lavadora.
Los seis electrodomésticos suman unos 213.63 kWh, que al precio de la factura equivalen a 64.09 yuanes, explicando solo alrededor del 50.9% de la factura, y aún faltan 206.37 kWh. De los tres planes, usar el aire acondicionado 1 hora menos es el más rentable: ahorra 24 kWh al mes, unos 7.2 yuanes.
Se puede ver que, incluso sin conexión a la red, ante un gráfico tan complejo, el 35B-A3B lo manejó con total solvencia.
Después de ver el 35B, veamos ahora el rendimiento del 1B; la tarea asignada al 1B esta vez fue convertir una página de un artículo académico a Markdown:
Por favor, transcribe esta imagen a markdown.
En menos de medio minuto se reconstruyeron los niveles de títulos, los párrafos y las tablas, y las fórmulas se escribieron en LaTeX; tras renderizarlas, la composición coincidía básicamente con la del original.
Para quienes suelen llevar capturas de artículos y páginas PDF a sus notas, este tipo de trabajo antes solía requerir conexión y delegarse a modelos en la nube. Ahora un pequeño modelo de 1.3B puede hacerlo por completo en local en el móvil.
Por supuesto, además del móvil, dispositivos de borde como eliPadtampoco representan ningún problema.
Por ejemplo, la pregunta del mapa de la expedición de Napoleón se ejecutó en un iPad M4, y la respuesta seguía siendo el 6 de diciembre de 1812, a 37.5 grados bajo cero.
Además de en el borde, también ejecutamos MiniCPM-V4.7 medianteAPIProbé MiniCPM-V4.7.
La primera pregunta era de contabilidad: preparamos una muestra de tique de supermercado con 6 artículos, desde leche pura y pan integral hasta pañuelos, además de dos descuentos por membresía y cupón, con un pago final de 78.40 yuanes. La consigna era organizarlo en una tabla de cuentas en chino y verificar si las cuentas del tique eran correctas.
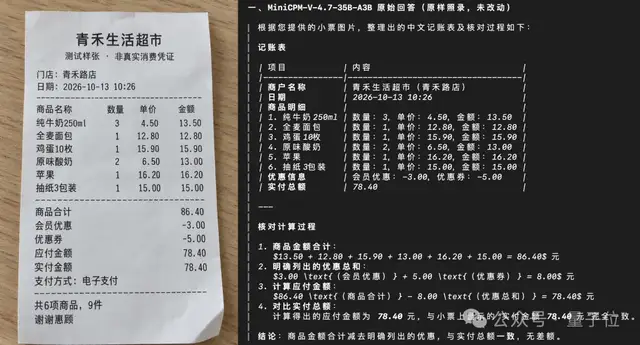
Por los resultados, el 35B-A3B primero listó en la tabla la tienda, la fecha y la cantidad, precio unitario e importe de los 6 artículos, cotejándolos uno a uno con la imagen original sin un solo error de lectura.
Al verificar, aunque el tique indicaba claramente que el total de los artículos era de 86.40 yuanes, volvió a sumar los 6 importes desde el principio, obtuvo 86.40 yuanes, luego restó dos descuentos de 8 yuanes en total y calculó 78.40 yuanes, coincidiendo exactamente con el importe pagado del tique.
La segunda pregunta también estaba relacionada con el estacionamiento, pero con reglas algo más complejas que las mostradas al principio.
El escenario que establecimos fue: martes, con credencial de residente, sin haber aparcado aún ese día en ese lugar, con plan de estacionar de 14:10 a 15:40. Luego se le pidió juzgar cinco cosas: cuánto duraría el estacionamiento, si chocaría con la prohibición por limpieza, si excedía el límite de tiempo, si había que pagar la tarifa y si todo el plan cumplía el reglamento.
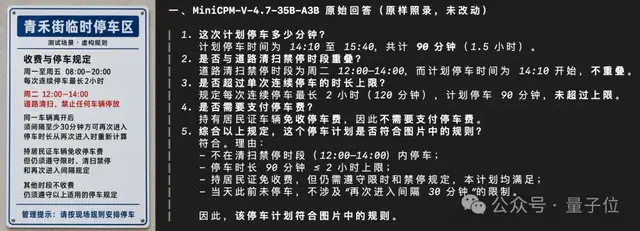
El 35B-A3B respondió correctamente las cinco preguntas. Calculó que el estacionamiento duró 90 minutos en total; comenzando a las 14:10, evitó exactamente el periodo de limpieza de 12 a 14 horas y no excedió el límite de 2 horas; y por poseer la credencial de residente, la tarifa podía exonerarse.
En el juicio final, repasó cada regla y además notó que ese día no había aparcado antes, por lo que la norma de "para volver a entrar hay que esperar 30 minutos" no aplicaba, concluyendo que el plan de estacionamiento cumplía el reglamento.
¿Cómo corre un 35B con 3 GB de memoria?
Tras ver los resultados, surge la pregunta:
¿cómo puede un modelo de 35B funcionar en un móvil con 12 GB de memoria, y además sin ser lento?
El 35B-A3B es un modelo MoE que, aunque tiene en total 35B de parámetros, solo unos 3B participan realmente en el cálculo al generar cada token. Sin embargo, hay un inconveniente: qué expertos se llamarán en cada capa solo se sabe cuando la capa anterior termina de calcular.
Y como la memoria del móvil no puede contener todos los expertos, la mayoría deben guardarse en la memoria flash y leerse cuando se necesitan.
Antes había dos métodos habituales. Uno era leer cada experto solo cuando se necesitaba: el modelo podía correr, pero la decodificación era demasiado lenta para una conversación en tiempo real; el otro era fijar de antemano un pequeño grupo de expertos para toda la conversación: se reducían las lecturas de disco, pero el modelo podía elegir entre menos expertos y su capacidad inevitablemente se veía comprometida.
MiniCPM-V 4.7 busca tener lo mejor de ambos mundos: velocidad suficiente sin sacrificar fácilmente la capacidad. En el uso práctico hay que considerar un paso más: los desarrolladores lo personalizan para su negocio, y al aprender el modelo nuevas habilidades debe conservar en lo posible las que ya tenía.
Primero, cómo correr más rápido.
La planificación anticipada de expertos (LES) optimiza conjuntamente la precarga de expertos, la programación del cálculo y el acceso a los pesos: cuándo moverlos, cuál calcular primero y cuánto mover cada vez, todo tiene su detalle.
El equipo aprovechó una característica: las características de entrada de dos capas adyacentes del modelo suelen ser muy similares. Por tanto, mientras la capa actual aún calcula, se pueden enviar sus características de entrada del router al router de la siguiente capa, prediciendo con antelación qué expertos podría necesitar la siguiente capa, y un hilo en segundo plano lee los pesos correspondientes de la flash a la memoria.
Cuando la siguiente capa comienza a trabajar, la mayoría de los expertos necesarios ya están listos. En las pruebas del equipo, este método puede preparar por adelantado más del 80% de los expertos necesarios, y sin necesidad de entrenamiento adicional.
El orden de cálculo también se ajusta en consecuencia:Se calculan primero los expertos seleccionados por el enrutamiento real y ya cargados, mientras se cargan de forma síncrona los demás expertos necesarios. Se procura que el cálculo y la lectura del disco se realicen al mismo tiempo, reduciendo el «esperar a que lleguen los datos para trabajar».
Aquí hay una distinción clave: la predicción solo se encarga de trasladar por adelantado y organizar el orden de cálculo; qué expertos usa cada token al final sigue siendo decidido por el mecanismo de enrutamiento original del modelo. Los expertos no acertados se cargan y se calculan con normalidad, sin omitirse para ganar velocidad.
Otra parte de la optimización ocurre en los propios pesos. Mediante la cuantificación de precisión mixta capa por capa, el equipo redujo el tamaño de los pesos de los expertos, conservando en lo esencial la capacidad del modelo, y así disminuyó la cantidad de datos cargados en cada ocasión; además, reorganizó los pesos en un diseño de almacenamiento continuo, reduciendo las lecturas fragmentadas para que la memoria flash lea secuencialmente de manera más eficiente.
Una parte reduce lo que hay que trasladar y otra hace el traslado más fluido; junto con la carga anticipada y el cálculo paralelo, todo ello alivia la presión de almacenamiento y ancho de banda en el dispositivo.
En el iPad Pro M4 con 16 GB de memoria, el esquema de despacho de expertos especulativo (lookahead expert parallelism) logró una mejora global de x5 en la velocidad de decodificación.
Además, el equipo entrenó para el modelo un modelo borrador (draft) complementario llamado DSpark, que se integra en frameworks de inferencia en el dispositivo como llama.cpp. El modelo borrador propone varios tokens primero y el modelo principal los verifica por lotes, acelerando aún más la generación. En pruebas con un Mac M5 de 16 GB de memoria, la velocidad de decodificación mejoró en promedio un 17% adicional.
El lado visual también ahorra. MiniCPM-V 4.7 adopta la técnica de compresión temprana dentro del ViT de LLaVA-UHD v4, que fusiona los tokens visuales por adelantado dentro del propio codificador visual, de modo que las capas posteriores tienen menos que calcular. Los desarrolladores además pueden alternar entre compresión de 4x y 16x; como se mencionó antes, al activar 16x las puntuaciones casi no bajan.
La suma de estas técnicas es lo que ModelBest llama «rápido todavía más rápido».
Además de correr rápido, hay otro problema que los desarrolladores se encuentran con frecuencia: después de ajustar el modelo para un negocio concreto, mejora en las nuevas tareas, pero sus capacidades generales originales se degradan.
Para ello, ModelBest lanzó el ajuste fino con autorrepetición (Self-Replay Fine-Tuning). El método es muy directo: antes del ajuste fino, se hace que el modelo responda a un lote de preguntas que cubren sus capacidades originales, se seleccionan las respuestas de alta calidad y se mezclan en los datos de entrenamiento de las nuevas tareas. Así, el modelo aprende nuevas habilidades mientras repasa lo que ya sabía, reduciendo el olvido de sus capacidades existentes.
Estos «materiales de repaso» provienen del propio modelo, por lo que se ajustan mejor a su forma original de responder. Todo el método sigue el flujo estándar de ajuste fino, sin necesidad de modificar la estructura del modelo ni la función de pérdida. Los datos de repetición solo necesitan generarse una vez y pueden reutilizarse cuando el modelo aprende distintas capacidades nuevas o se somete a múltiples entrenamientos.
A diferencia de métodos de entrenamiento como el aprendizaje por refuerzo en línea o On-Policy Distillation, que exigen que el modelo genere nuevos datos en cada entrenamiento, el ajuste fino con autorrepetición acerca infinitamente el coste de personalizar nuevas capacidades al del ajuste fino supervisado convencional (Supervised Fine-tuning), a la vez que conserva el rendimiento general del modelo.
Cuando los grandes modelos ya no le tienen miedo al móvil
Dicho lo técnico, volvamos al sector de los móviles.
En 2026, la IA en el dispositivo se encamina hacia una implantación a gran escala. Según las previsiones de IDC, este año los envíos en China de los nuevos teléfonos con IA alcanzarán 147 millones de unidades, un crecimiento interanual del 31.6%, con una penetración que superará por primera vez el 53%. Dicho de otro modo: por cada dos móviles nuevos vendidos, uno lleva IA en el dispositivo. Li Dahai, CEO de ModelBest, también ha dicho que 2026 será el año uno del despliegue a escala de la IA en el dispositivo.
Sin embargo, para los fabricantes de móviles queda un problema muy real: el coste.
La memoria no deja de subir de precio; 12 GB ya son el mínimo para un móvil con IA, los gama alta suelen traer 16 GB de serie y algunos modelos empiezan a explorar los 24 GB. Si un modelo quiere ser más potente, suele tener que consumir más memoria, y cuanto más cara es la memoria, más costoso resulta ese camino.
Por eso, ejecutar modelos más grandes con menos memoria resulta tan atractivo para los fabricantes. El iPhone 17 Pro Max tiene 12 GB de memoria, mientras que 35B-A3B puede funcionar con fluidez con unos 3 GB, dejando el resto del espacio para otras aplicaciones.
A más largo plazo, el foco de la competencia en IA en el dispositivo también está cambiando. Antes se comparaba el proceso de fabricación de los chips y la potencia de cómputo; a partir de ahora, la buena coordinación entre modelos y frameworks de inferencia con el hardware será cada vez más lo que marque la diferencia.
En cuanto al ecosistema, MiniCPM-V 4.7 es compatible con bastantes plataformas. Puede desplegarse en iOS, Android y HarmonyOS, y el mismo día del lanzamiento completó la adaptación a plataformas de chips como Rockchip, Houmo, Intel, AMD y Arm. En frameworks de inferencia soporta SGLang, vLLM, llama.cpp y Ollama; para ajuste fino puede usarse SWIFT y LLaMA-Factory, y ofrece varias versiones cuantizadas como GGUF, AWQ, GPTQ y FP8.
Detrás de esta línea está la ley de densidad propuesta por ModelBest y la Universidad de Tsinghua. Según esta ley, la densidad de capacidades de los grandes modelos se duplica aproximadamente cada 3.5 meses: la misma capacidad requiere cada vez menos parámetros. Hasta septiembre (9) de 2026, la serie MiniCPM ya había superado los 5000万 de descargas acumuladas.
En resumen, llevarse un gran modelo útil en el bolsillo sin complicaciones ya no es nada difícil.