
Yun Zhong, desde Au Fei Si
Quantum Bit | Perfil público QbitAI
¿Cuanto más datos se recopilen, más capaces serán los robots para hacer trabajo?
Este año, desde las más de veinte mil horas de datos de operación humana utilizados por EgoScale, hasta los millones de horas de entrenamiento previo de Dyna-2, los robots están ampliando el alcance de su aprendizaje del comportamiento humano.
Estos dos estudios utilizaron diferentes rutas de entrenamiento de modelos, pero ambos buscan descubrir algo: si los datos de operación humana pueden superar las limitaciones de escala que impone la recopilación por parte del cuerpo robótico, y si esto puede proporcionar una base para que los robots aprendan más tareas.
Surgen preguntas adicionales: cuando los robots necesitan dar pasos, agacharse o coordinar las manos para completar la tarea, ¿cuánta información sobre la interacción del cuerpo con el entorno queda registrada en los datos por hora?
Tomar un paquete: la persona primero debe llegar a la posición adecuada, doblarse, extender la mano y agarrarlo, luego ajustar la postura para levantar el paquete. Moverse alrededor de la cama, alisar la manta, los movimientos de pasos y brazos, así como la fuerza del contacto, también deben ser coordinados continuamente.
En los datos Ego, centrados en la visión, podemos ver qué ha hecho la persona, pero no necesariamente podemos registrar completamente el estado físico que subyace detrás de esas acciones.
Si en el futuro el robot necesita aprender la operación ágil de movimiento completo, solo saber cómo usar las manos puede no ser suficiente.
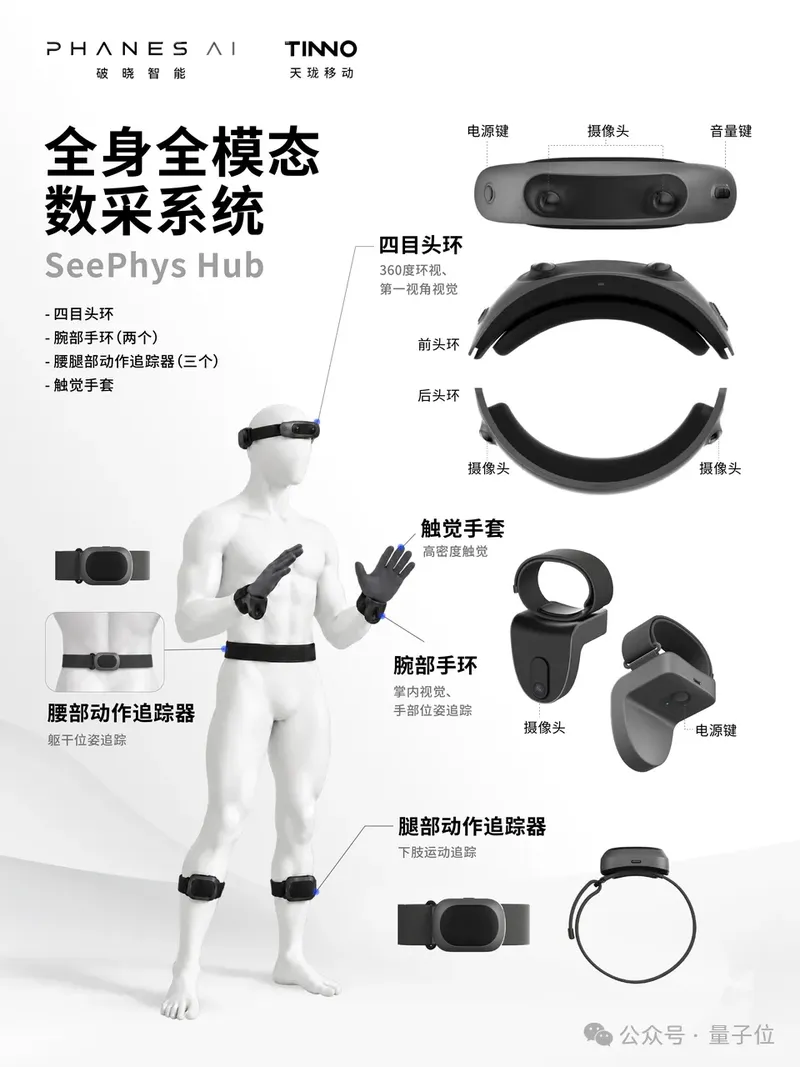
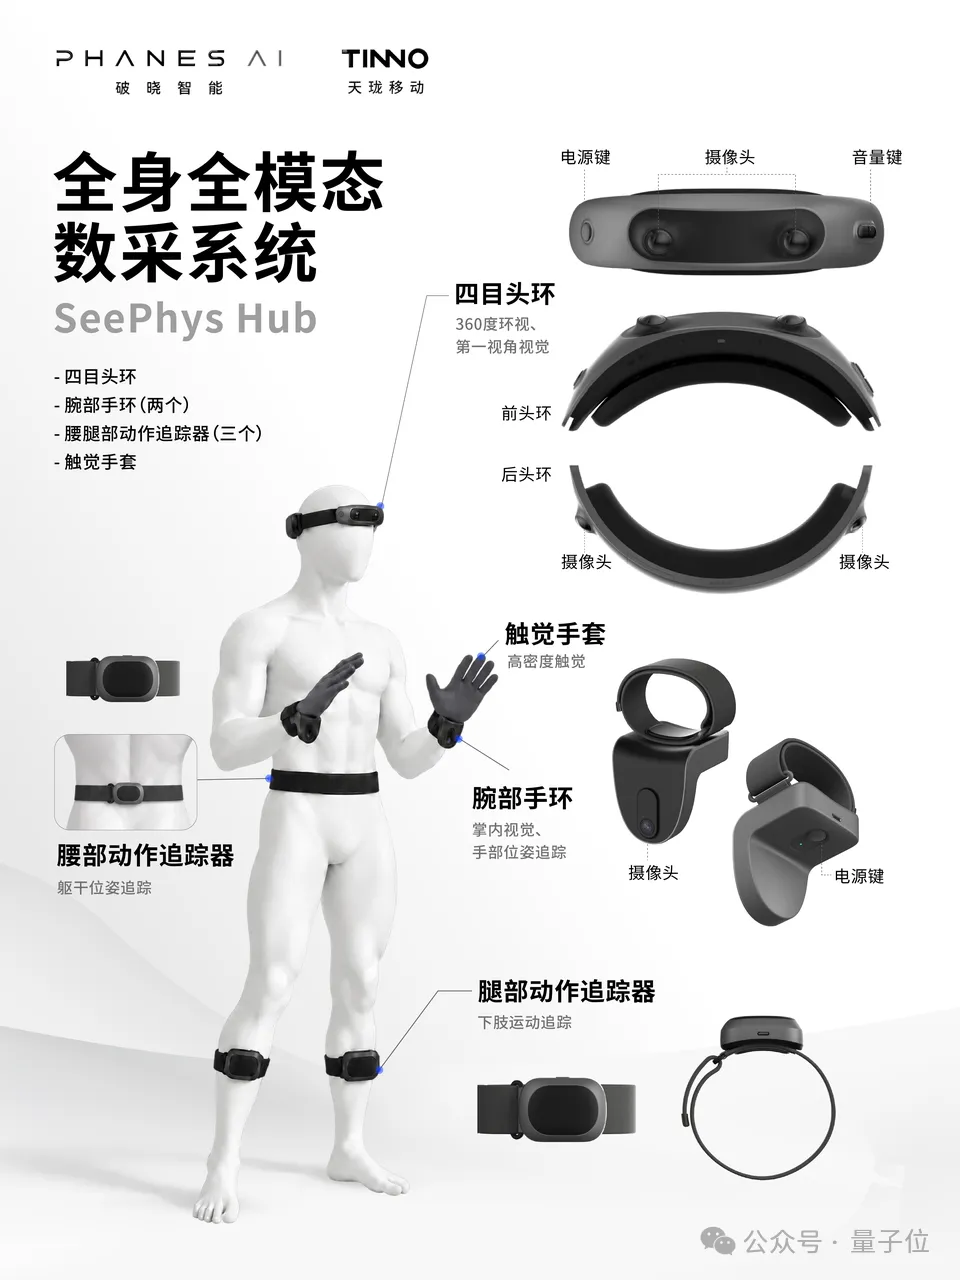
El 14 de octubre, Breaklight Intelligence y Tianlong Mobile lanzaron el Sistema de Recopilación de Datos de Todo el Cuerpo y Todo Modo SeePhys Hub, con el objetivo de complementar la información de Ego.
El conjunto de equipo está compuesto por un anillo para la cabeza con cuatro ojos, dos anillos para los brazos, tres registradores de movimiento para las caderas y piernas, y una joda táctil. A través de la fusión de señales visuales y motoras, se restaura la postura corporal completa, y según las necesidades del trabajo, se recopila la presión de contacto en las manos.
Espera mantener las ventajas de la ligereza y la facilidad de escalado de Ego, al mismo tiempo que recupera la información sobre el movimiento físico y los estímulos táctiles que están fuera del campo de visión.
Para Boshi Intelligent, esto no se trata simplemente de añadir varios sensores, sino de explorar otra forma de recopilación de datos entre los datos de movimiento y captura de alta precisión pero con un alto costo de recolección, y los datos Ego, que son ligeros pero con información relativamente limitada.
Anote los movimientos del cuerpo y la “sensación” juntos.
Los datos recolectados desde la primera perspectiva, es decir, los datos Ego, se han convertido en una fuente importante para la recolección de datos de embodied cognition.
Ego es muy atractivo; la persona utiliza el dispositivo para realizar operaciones en escenarios cotidianos, y la cámara sigue a la persona, por lo que la recolección no tiene que realizarse siempre alrededor del cuerpo del robot.
Pero para las tareas que requieren movimiento y colaboración integral, registrar solo las imágenes inmediatas podría omitir algunos estados clave.
Por ejemplo, cuando una persona levanta la mano para tomar un objeto que está en una posición elevada, los hombros, los brazos y el tronco deben ajustarse juntos. La cámara de primera perspectiva puede captar las manos, pero no necesariamente puede ver la posición de los codos y las piernas. Cuando hay obstáculos en el propio cuerpo, obstáculos de objetos o zonas ciegas de visión, estimar la postura completa del cuerpo se vuelve aún más difícil.
Aunque estos movimientos pueden estimarse mediante videos, la fiabilidad de la estimación se convierte en un gran problema cuando se encuentran obstáculos por parte del propio cuerpo, objetos o zonas ciegas de visión.
La solución de SeePhys Hub consiste en añadir un pequeño número de nodos de seguimiento en las posiciones clave del cuerpo humano.
SeePhys Hub utiliza un sistema de nodos dispersos: se colocan tres sensores de seguimiento de movimiento en la cintura y en los muslos, combinando información visual de la cabeza y datos de los dos brazos para recuperar la postura del cuerpo completo mediante algoritmos. La IMU proporciona señales relacionadas con el movimiento, el UWB ofrece información de medición de distancia entre los nodos, y al combinarlas con la visión, se estima la postura del cuerpo completo.
La cobertura visual también se ha ampliado. El collar de cuatro ojos ofrece una visión en 360°, mientras que la cámara en el brazo complementa los detalles de la operación a corta distancia. Las guantes táctiles opcionales registran los cambios de presión cuando las manos tocan objetos. La información visual, el movimiento corporal y la sensación táctil se registran de forma sincronizada, permitiendo recuperar el proceso real de operación humana.
El equipo de investigación y desarrollo dio un ejemplo: después de tomar las botellas del refrigerador, la persona se dobla hacia un lado para cerrar la puerta, y la cámara situada detrás de la cabeza sigue pudiendo grabar ese movimiento. Los actos que realizan las personas en escenarios reales suelen ocurrir a través de tales giros, movimientos y cambios de perspectiva.
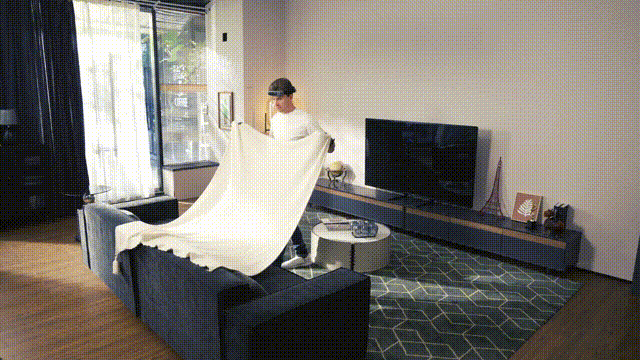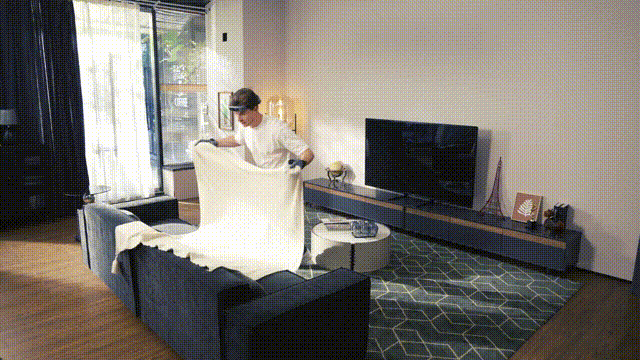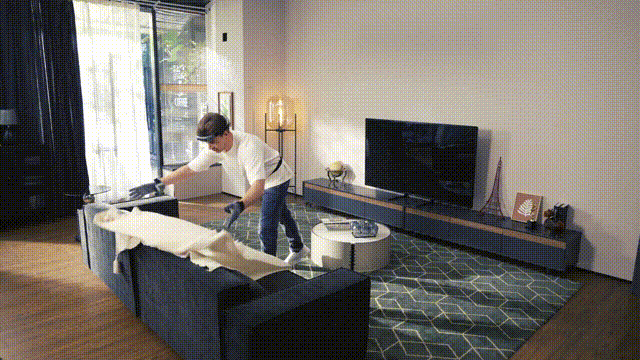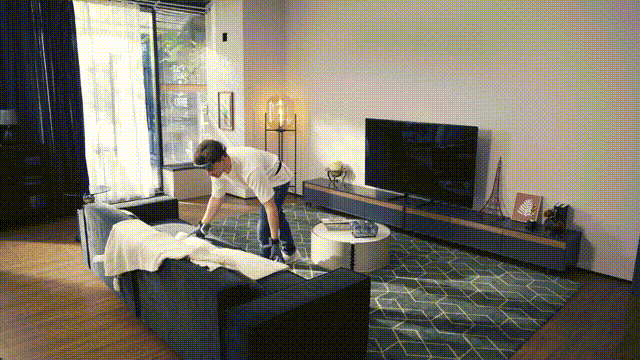
Más abajo está “la sensación”.
Tomar una uva, después de tocarla, ¿debería seguir aplicando fuerza o detenerse y ajustarla suavemente? La persona corrige su movimiento según el contacto real. Las guantes táctiles registran la presión del contacto, lo que le da al movimiento en la video una señal física correspondiente.
Para el modelo, esta información tiene la oportunidad de ayudarle a comprender la relación entre el movimiento del cuerpo, el contacto de las manos y los cambios ambientales. Lo que el equipo espera mejorar es la cantidad de información útil que pueden generar los datos de operación por hora.
Los señales múltiples también deben alinearse en el mismo momento. En la video, el instante en que la mano toca el objeto, es necesario que coincida con los cambios de presión y el estado de movimiento, para poder analizar completamente el proceso de interacción. Según los datos del producto, la precisión de sincronización de la cámara, el IMU y el UWB dentro del collar de cabeza no supera los 0.5 milisegundos. Este paso técnico poco visible también afecta si los datos de diferentes modalidades pueden conectarse efectivamente.
Después de la recolección, hay una etapa de procesamiento. La plataforma complementaria de SeePhys Hub se encarga de la análisis, limpieza, división de movimientos y etiquetado semántico, además de conectar la reconstrucción del escenario, la estimación de postura y el seguimiento de las manos. La redirección de movimientos convierte los movimientos humanos en acciones del cuerpo robótico, proporcionando soporte para el entrenamiento y la adaptación posteriores.
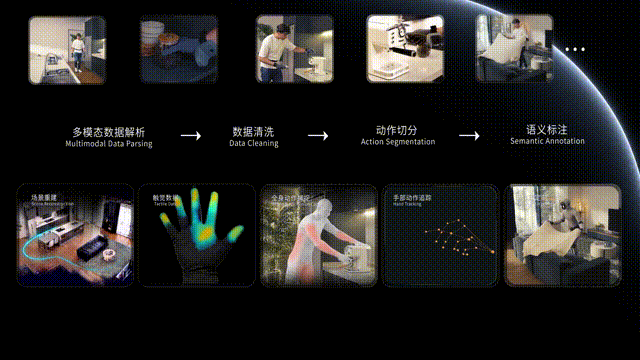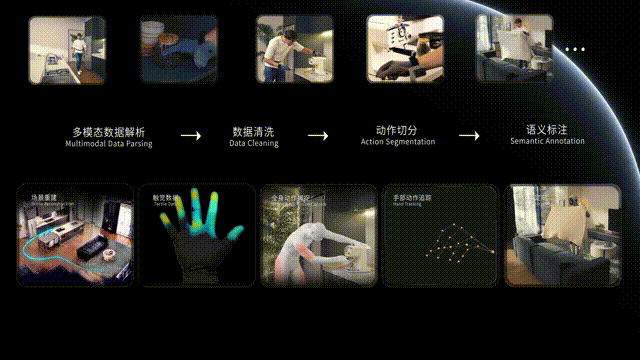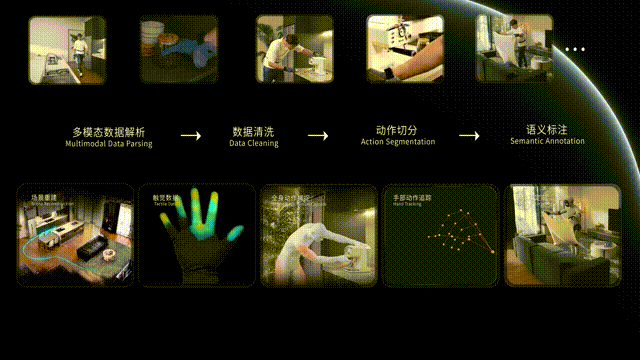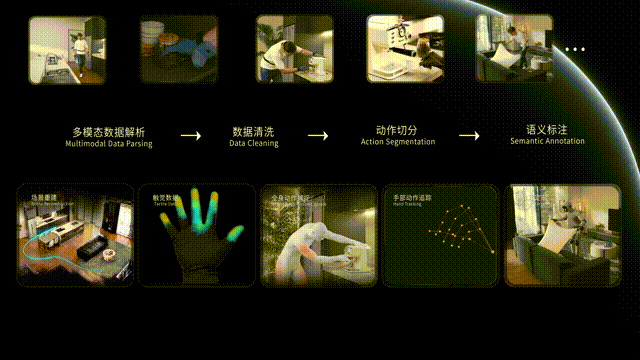
Los sensores no son más numerosos cuanto mejor, la recolección a gran escala requiere nuevas elecciones técnicas.
El nuevo modal de datos, por supuesto, puede proporcionar más pistas, pero la calidad y la disponibilidad de los datos también dependen de cómo se recopilen. El problema vuelve a referirse a la ingeniería y al producto.
La selección de productos ofrecida por Breakfast se basa en un pequeño número de nodos, combinada con algoritmos. El peso del collar no supera los 220 gramos, y el collar para muñeca individual no supera los 75 gramos. El equipo ha colocado la ligereza, el costo y la libertad de movimiento en situaciones reales en una posición importante en el diseño del producto.
Esto también explica su posición en el plan de recolección.
En la pirámide de datos de tres niveles descrita por Yang Shuo, fundador y CEO de Dawnbreak, el nivel inferior consiste en videos de internet en gran cantidad, que añaden información de postura y tacto mediante algoritmos; el nivel superior contiene datos de captura de movimiento de alta precisión y operaciones con equipos reales; SeePhys Hub se enfoca en el nivel medio, intentando equilibrar el potencial de recopilación a gran escala con registros de interacción más completos.
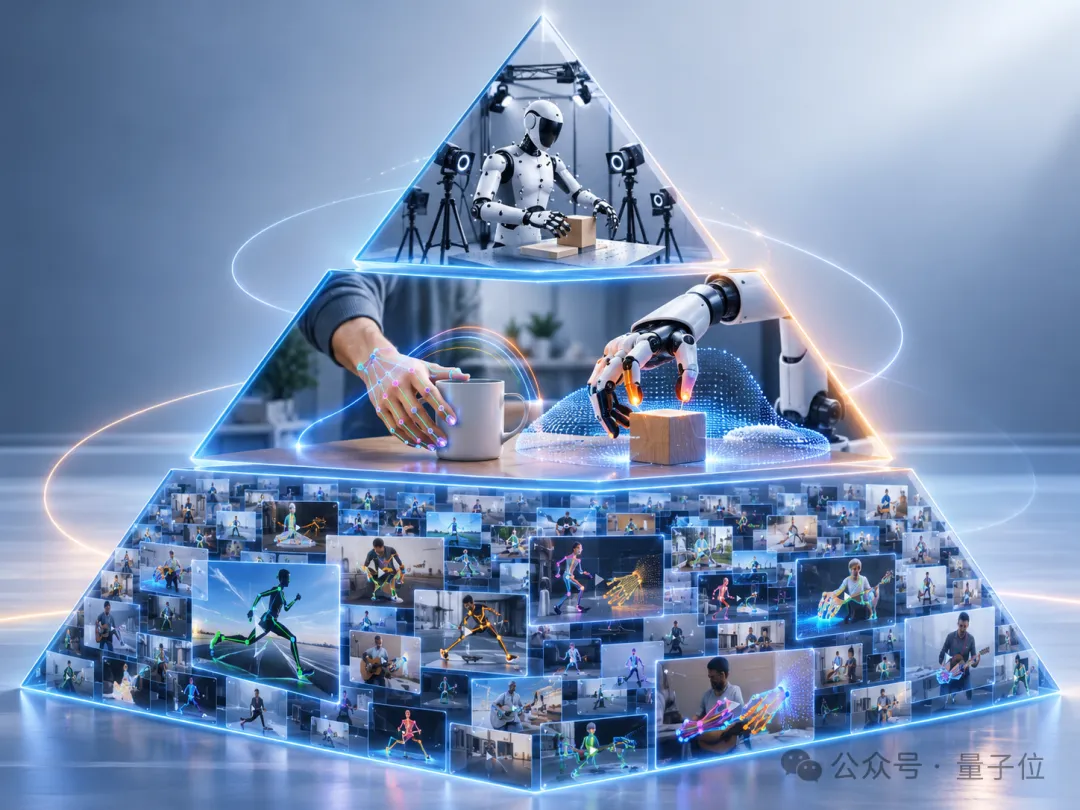 △La imagen fue generada por IA
Cada capa se encarga de tareas diferentes. Los datos de movimiento y captura pueden utilizarse para supervisar la estimación de postura, los datos reales ayudan a adaptar el modelo al robot, mientras que las grabaciones de vídeo humanas ofrecen más escenarios y operaciones. Lo que los dispositivos wearables complementan es la capacidad de entrar en entornos reales y registrar continuamente a las personas.
Las guantes táctiles tienen un diseño opcional, también debido a las mismas consideraciones técnicas.
Según Yang Shuo, el equipo ha contactado a algunas empresas que gestionan la recopilación de datos. “La primera solicitud que nos hicieron fue que no permitieran que nuestros empleados usaran guantes”.
Porque cuando se trata de escenarios específicos como lavar los platos, que implican protección contra agua, las operaciones precisas pueden verse afectadas por el uso de guantes, y el propio sensor también puede generar ruido. El equipo ha experimentado en pruebas que, después de que los guantes tocaron varias botellas de agua, la mano vacía sigue mostrando presión local.
Este tipo de ruido que entra en los datos aumenta la dificultad de su procesamiento y entrenamiento posterior. Si los dispositivos de vestimenta afectan la operación de las personas, también afectará el valor de los registros.
Por lo tanto, el brazalete y los guantes de SeePhys Hub pueden usarse por separado. Los clientes configuranlos según las tareas, mientras que el equipo continúa investigando cómo estimar la sensación táctil a partir de la visión, ampliando así las fuentes de datos disponibles.
Para poder desplegar realmente el equipo, la cadena de suministro y la garantía de calidad también son cruciales. En esta colaboración, Boshi se enfoca enel diseño del producto y los algoritmos, mientras que Tianlong Mobile proporcionaexperiencia en control de costos, cadena de suministro y garantía de calidad.
Los servicios comerciales también se centran en las capacidades del cliente. De acuerdo con la planificación del equipo, los clientes con habilidad en algoritmos pueden adquirir hardware y procesar datos por sí mismos; aquellos que necesitan un plan completo pueden elegir algoritmos complementarios y despliegue local; en escenarios como la investigación científica, también se puede utilizar una plataforma en la nube para obtener datos procesados.
Los operadores de recolección de datos, los equipos de modelos con cuerpo, las partes interesadas en escenarios y las instituciones científicas son todos usuarios que el equipo se enfoca en atender.
En opinión de Yang Shuo, la acumulación detrás de los dispositivos incluye también algoritmos de estimación de postura, así como datos de pareja utilizados para entrenar y validar los algoritmos. Solo cuando el hardware, los algoritmos y el procesamiento de datos trabajan juntos, se pueden convertir los sensores que llevan puestos en personas en registros operativos que puedan usarse para el entrenamiento.
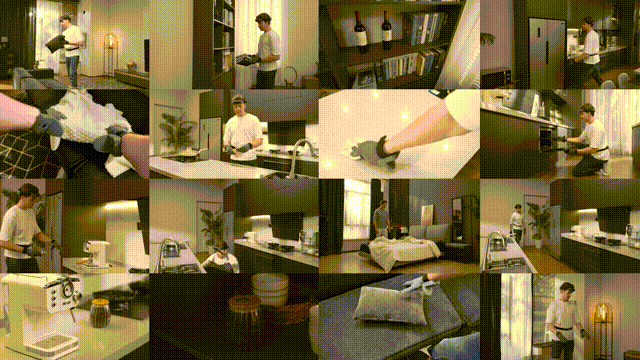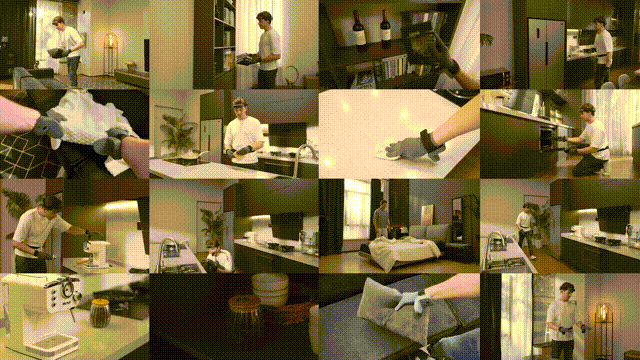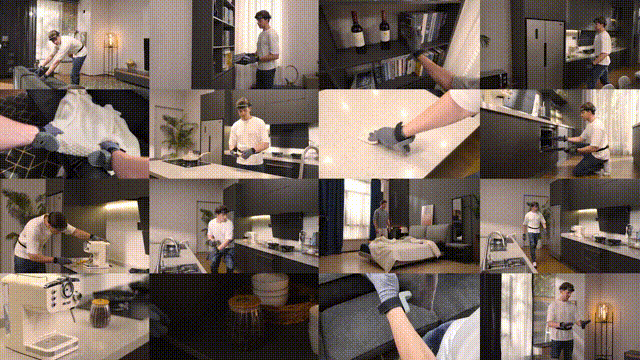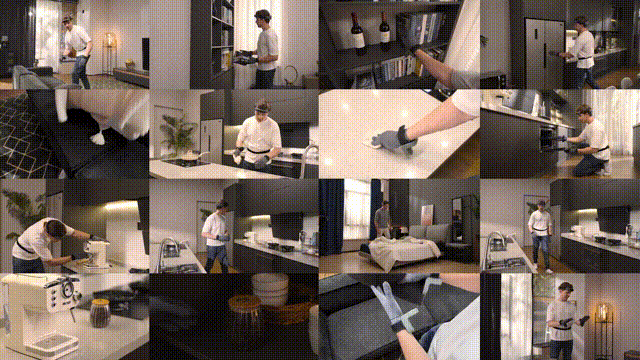
Un equipo que trabaja en modelos mundiales, ¿por qué comienza primero con la recopilación de datos?
“Nuestro objetivo final debe ser hacer bien el modelo.” Yang Shuo dio esta respuesta al hablar sobre por qué se desarrollaron equipos de recopilación de datos.
Pero esto no deja de generar dudas: ¿por qué una empresa que quiere crear robots para el cerebro elegiría un enfoque “de curva salva”, comenzando por datos y equipos?
En opinión de Yang Shuo, el problema radica precisamente en qué datos se necesitan para el modelo. Para modelar juntos el movimiento del cuerpo, el contacto de las manos y los cambios ambientales, se requieren registros de operaciones correspondientes. Los datos necesarios son difíciles de obtener a bajo costo y en gran escala, por lo que el equipo eligió complementar esa fuente por sí mismos.
Esta elección también está relacionada con el contexto de investigación anterior de Yang Shuo y su equipo.
Fundador de PHANES AIYang ShuoNacido en 1998, actualmente es profesor emérito y tutor de doctorado en el Instituto de Ciencia y Tecnología Informática de la Universidad de Harbin, Shenzhen.
Yang Shuo ha dedicado mucho tiempo a la investigación en modelos de gran tamaño de todo tipo, visión por computadora e inteligencia con cuerpo. A los 26 años fue nombrado profesor emérito y tutor de doctorados en Harbin Institute of Technology (Shenzhen), siendo el profesor y tutor de doctorado más joven en el campo de la inteligencia artificial en China.
Desde su creación, Baoxiao Intelligence ha formado un equipo que combina investigación de modelos y experiencia en ingeniería. Según la empresa, más del 90% de sus miembros clave se graduaron de universidades como Tsinghua University, Peking University, Universidad de Hong Kong y Harbin Institute of Technology. Las investigaciones y prácticas de ingeniería abarcan modelos de gran tamaño en todos los modos, modelos mundiales, procesamiento de datos a gran escala y desarrollo de hardware.
Anteriormente, el equipo ya había llevado a cabo una serie de investigaciones relacionadas con la obtención, ampliación y uso de datos táctiles.
En mayo de 2026, se publicaron el conjunto de datos EgoTouch y el estudio TouchAnything. El primero registra de forma sincronizada videos desde la primera perspectiva, la postura de las manos y la presión táctil real, permitiendo que los modelos aprendan la relación entre la visión y el contacto; el segundo intenta, además, estimar las áreas de contacto y la distribución de la presión a partir de los videos, para complementar la información táctil con más datos visuales.
En TouchWorld, estos “sentidos táctiles” comienzan a participar en las acciones del robot. El modelo predice de antemano los objetivos visuales y el contacto, y durante la ejecución, corrige las desviaciones basándose en la retroalimentación táctil real. Enchufar enchufes, limpiar ollas, usar papel higiénico: todas son las tareas reales que el equipo utiliza para probarlo en el dispositivo real.
SeePhys Hub extenderá el alcance del estudio desde el contacto de las manos hasta el movimiento corporal completo. Para la habilidad en los movimientos corporales, los robots necesitan comprender no solo cómo las manos tocan los objetos, sino también cómo se mueve el cuerpo, cómo se ajusta la postura y qué resultados físicos se producen con esos movimientos.
Estos son precisamente los contenidos que el próximo paso de Dawn espera aprender a través del modelo del mundo de todo modalidad. Según el plan, el equipo espera lanzar el modelo del mundo de todo modalidad en 2027, y priorizará la verificación de aplicaciones en escenarios verticales como la industria, la restauración y la venta al por menor.
Sin embargo, en esta etapa de amanecer, aún no se está preparando para fabricar el cuerpo físico del propio robot.
La consideración de Yang Shuo es que los datos, los modelos y las escenas de implementación siguen cambiando. Si el robot debe transportar objetos pesados o cuál es la carga necesaria, todo esto afecta el diseño del dispositivo. Establecer los componentes hardware demasiado pronto también puede limitar la dirección de los algoritmos posteriores. Él llama a este riesgo “costo de inversión puro y duro”.
Por eso, existe un ente real que puede colocarse más atrás. Actualmente, el equipo utiliza un modelo de prueba de ente universal y planea colaborar con empresas de entes y entidades de escenario para llevar a cabo proyectos piloto de aplicaciones; si en el futuro lanzarán su propio ente, dependerá de que las necesidades del escenario y los beneficios comerciales estén más claros.
La aurora también tiene su propia opinión sobre la competencia en los modelos. Los robots, en última instancia, necesitan percibir, tomar decisiones y ejecutar en tiempo real en entornos reales; muchas situaciones también requieren la implementación en el dispositivo. En comparación con ampliar excesivamente el tamaño de los parámetros, la forma de hacer que los modelos de tamaño limitado adquieran habilidades de interacción física y realicen tareas de manera estable podría ser un desafío más realista.
Mirando hacia atrás, en los últimos años, la recolección de datos con robots ha sido una proceso de reducción: pasando de la operación a distancia a Ego, liberándose del cuerpo físico del robot y simplificando el equipo de recolección, para que más operaciones diarias humanas se conviertan en datos de entrenamiento que puedan ser obtenidos a gran escala.
Pero cuando los robots comienzan a aprender a caminar, agacharse, transportar y realizar operaciones delicadas, la información sobre el movimiento del cuerpo y el contacto fuera de la cámara se convierte en algo que no se puede descartar fácilmente.
La elección al amanecer se basa en esta ruta ligera, para recuperar el movimiento corporal y la sensación táctil. SeePhys Hub es responsable de registrar una interacción humana más completa, y el modelo mundial de todo modalidad del futuro tendrá que aprender aún más sobre la relación entre acciones, contactos y resultados físicos.
Desde cómo el registrador completa las tareas, hasta permitir que los robots aprendan realmente a actuar de forma autónoma. Esta es la siguiente etapa que Dawn espera lograr mediante datos de todo el cuerpo y todos los modos.
*Este artículo está publicado con autorización de Qbit, y las opiniones pertenecen exclusivamente al autor original.*