
Yunzhong desde Aufeisi
Quantum Bit | Cuenta oficial QbitAI
Pedir a un Agent que escriba informes semanales o analice propuestas ya es parte de la rutina de mucha gente. Pero cada vez que comienza, el usuario aún tiene que buscar materiales y explicar el contexto, y el agente también debe pasar por múltiples pasos como buscar, leer y organizar antes de poder empezar realmente la tarea.Si cambia la tarea, todo este proceso hay que repetirlo.Procesar repetidamente estos materiales ya existentes, además de consumir tiempo, aumenta el consumo de tokens. Cuantos más materiales y más largos los pasos, más fácil es omitir información o cometer desviaciones, afectando la precisión en la finalización de la tarea.
Para resolver estos problemas,WorkSwarm por primera vez soporta de forma nativa el espacio de conocimiento personal。
El "espacio de conocimiento personal" se basa en múltiples fuentes de materiales configuradas por el usuario, recopila contenido automáticamente y, mediante procesamiento por reglas, procesamiento híbrido de reglas y grandes modelos de lenguaje o procesamiento por agentes, organiza los materiales en conocimiento personalcon directorio, con conexiones y con fuentesy lo pone a disposición del agente mediante revelación progresiva.
WorkSwarm organiza los materiales personales en conocimiento personal reutilizable a largo plazo, logrando"recopilar una vez, reutilizar muchas veces"facilitando que el agente encuentre y aproveche mejor la información relevante, mejora la precisión en la finalización de las tareas, y al mismo tiempo reduce el tiempo de preparación de la tarea y el consumo de tokens.
Espacio de conocimiento personal de openJiuwen: recopilación automática de conocimiento personalizado multifuente, el agente de oficina lo usa según necesidad
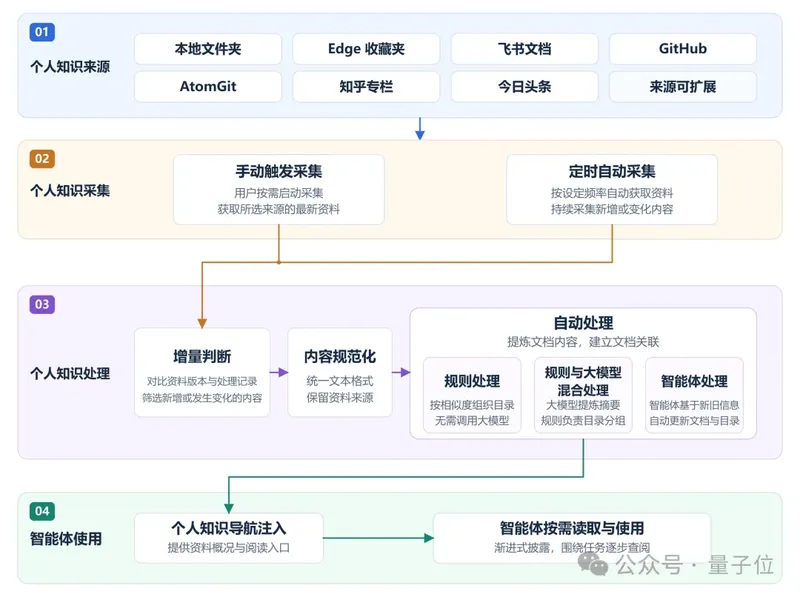
El espacio de conocimiento personal se estructura en cuatro capas —fuentes, recopilación, procesamiento y uso— y convierte los materiales personales acumulados diariamente por el usuario en conocimiento de contexto de tarea reutilizable de forma sostenida.
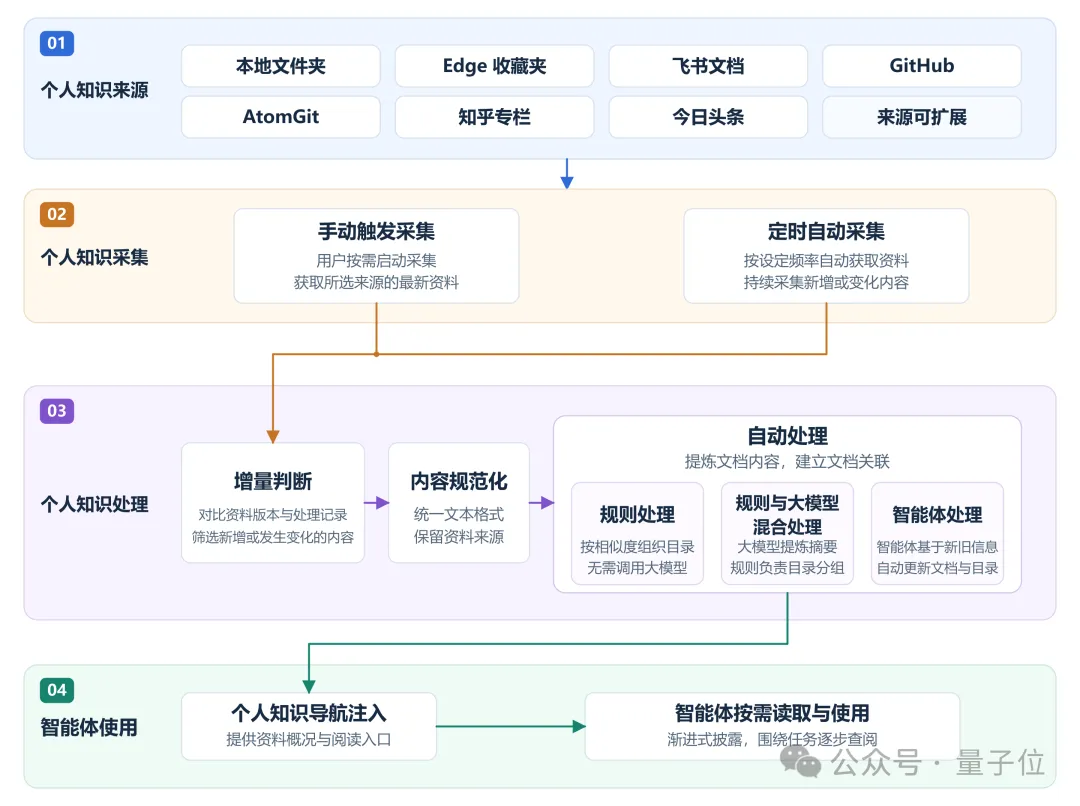 △ Flujo de cuatro capas del espacio de conocimiento personal, mostrando la configuración de materiales multifuente, la recopilación manual y programada, los tres métodos de procesamiento y el uso según necesidad por parte del agente
El usuario primero elige las fuentes de conocimiento personal y el alcance de recopilación, y el sistema obtiene el contenido según necesidad o de forma programada. Los materiales recopilados pasan por una unificación de formatos y un juicio incremental, identificando el contenido nuevo y los cambios de la ronda actual, y luego, según la configuración, se elige el método de reglas, híbrido de reglas con grandes modelos de lenguaje o de agente, organizándolos en un directorio temático y páginas Markdown, manteniendo además las relaciones y fuentes de los documentos. Una vez superada la verificación de la estructura del directorio y las citas de fuentes, el resultado de la organización queda a disposición del usuario para su consulta.
Cuando el usuario activa el uso en tareas, el sistema proporciona al agente el panorama del conocimiento personal y los puntos de entrada de lectura, y el agente va leyendo gradualmente las páginas relevantes en torno a la pregunta actual, de modo que el conocimiento existente se convierte en el contexto para completar la tarea.
Configuración y recopilación del espacio de conocimiento personal: elección autónoma de las fuentes de conocimiento personal, con soporte de recopilación incremental manual/programada
Tras activar el espacio de conocimiento personal en la página "Conocimiento" dentro de "Configuración", el usuario puede agregar fuentes comocarpetas locales, favoritos de Edge, columnas de Zhihu, Toutiao, documentos de Feishu, GitHub y AtomGitLas diferentes fuentes pueden configurarse por separado, y el usuario decide de forma autónoma qué materiales personales entran en el espacio de conocimiento personal.
Una vez completada la configuración, el usuario puedeiniciar la recopilación manualmentepara actualizar activamente su espacio de conocimiento personal, o también configurarrecopilación automática programadapara obtener contenido de forma continua según la frecuencia establecida. El sistema identifica los materiales nuevos o modificados combinando identificadores de fuente, versiones y progreso de recopilación, y, junto con el conocimiento personal existente, procesa los materiales nuevos o modificados.
La página de gestión de fuentes muestra el progreso de recopilación y el estado más reciente; el usuario puede ajustar la frecuencia de actualización, ver los resultados de la ronda actual y también detener una recopilación en curso.
Active el espacio de conocimiento personal en la página "Conocimiento" de "Configuración" y luego entre en "Gestión de fuentes" de la página "Conocimiento". El video toma Toutiao como ejemplo: se agrega el enlace de la página de un autor, se inicia la recopilación manualmente y se consulta el estado de ejecución de la fuente.
Procesamiento del conocimiento personal: ofrece tres métodos de organización que convierten materiales dispersos en conocimiento reutilizable
Las páginas web, los documentos y el código tienen estructuras diferentes, y los contenidos sobre un mismo tema pueden estar dispersos en múltiples fuentes. El espacio de conocimiento personal primero unifica el formato de los materiales, luego destila el contenido y lo organiza por temas en directorios y páginas, de modo que el agente pueda conocer primero el panorama general y leer después, paso a paso, los contenidos relacionados, conservando al mismo tiempo los enlaces y las fuentes de los documentos originales.
Tras recopilar material nuevo, el sistema lo complementa y actualiza en función del conocimiento personal ya existente, de modo que el conocimiento se acumule de forma continua en un mismo conjunto de archivos de texto plano.
El usuario puede, en la página "Conocimiento" de "Configuración", elegir uno de los siguientes tres métodos de procesamiento según las características del material y sus necesidades de organización:
- Procesamiento por reglas: utiliza los pesos de términos BM25 y la similitud de contenido para clasificar por temas las páginas relacionadas y mantener los enlaces entre directorios y páginas, sin necesidad de llamar a modelos generativos.
- Procesamiento híbrido de reglas y modelos grandes: primero el modelo grande extrae el título, el resumen y las palabras clave del material nuevo; luego las reglas completan la agrupación temática y la organización del directorio; finalmente el modelo grande genera los títulos y las introducciones del directorio, facilitando la comprensión y la consulta.
- Procesamiento mediante el agente: el agente analiza la relación entre el material nuevo y el conocimiento personal ya existente, prioriza actualizar o fusionar las páginas temáticas existentes, añade documentos cuando es necesario y mantiene sincronizadas las descripciones del directorio y las referencias cruzadas entre documentos.
Al usar los dos últimos métodos, el usuario puede configurar el modelo empleado para organizar el material. Una vez finalizada la organización, el sistema revisa la estructura del directorio y las citas de fuentes; el contenido que supera la revisión queda disponible para que el usuario lo consulte y para que lo use el agente.
El usuario también puede buscar contenidos relacionados mediante el árbol de archivos, el grafo o la búsqueda, abrir los documentos para leer el texto completo y rastrear el material original mediante las anotaciones de "Fuentes".
Una vez finalizada la recopilación, ya se han recopilado los contenidos relacionados con "jev". El usuario puede buscar jev en la página "Conocimiento", leer el texto organizado en el panel derecho, y también consultar el grafo para ver los nodos relacionados y sus conexiones.
Uso según necesidad: divulgación progresiva, para que el agente comience a trabajar con el conocimiento ya existente
Después de que los materiales se organizan como conocimiento personal, el usuario puede conectar el agente al espacio de conocimiento personal mediante el menú "+" del área de entrada de tareas. Al recibir la entrada del usuario, el agente obtiene primero el panorama general del espacio de conocimiento personal y los puntos de entrada de lectura, conociendo el alcance del conocimiento existente; luego, según la tarea actual, consulta paso a paso a lo largo de los directorios y los enlaces de los documentos para complementar el contexto necesario.
Este método de divulgación progresiva es similar a asumir un trabajo revisando primero el índice y la presentación del proyecto y luego consultando los documentos pertinentes, de modo que cada tarea lea el conocimiento existente según su necesidad.
La recopilación y el uso en tareas pueden controlarse por separado. El usuario puede dejar que el sistema recopile y organice material de forma continua, y activar el uso por parte del agente cuando lo necesite. Al desactivar el uso en tareas, el material sigue recopilándose, y el usuario también puede navegar y buscar directamente los documentos existentes.
El usuario decide qué material entra en su espacio de conocimiento personal y cuándo puede usarlo el agente. Al iniciar una tarea, solo necesita enfocarse en el problema a resolver en esta ocasión; el conocimiento acumulado previamente proporciona al agente el contexto para comprender y completar la tarea.
Tras activar el espacio de conocimiento personal, escriba “preséntame jev” y envíelo. WorkSwarm consultará entonces los documentos sobre Jev en el espacio de conocimiento personal y generará una introducción que abarca el mecanismo central, casos de implementación y otros contenidos.
Comparación de resultados: mejora de la tasa de aprobación de tareas, reducción del tiempo y del consumo de tokens
Con el espacio de conocimiento personal activado, el agente puede primero conocer el alcance del material existente y luego localizar y leer los documentos relevantes, reduciendo el trabajo de buscar y organizar repetidamente el material original durante la tarea.
El equipo realizó primero 2 pruebas comparativas para observar el impacto de este cambio en la calidad de finalización de las tareas, el tiempo empleado y el consumo de tokens.
La comparación muestra que, con el espacio de conocimiento personal, WorkSwarm puede combinar los archivos de clientes, el material del proyecto y los planes de trabajo para elaborar un resumen concreto del proyecto y los próximos pasos; si faltan los conocimientos personales relevantes,el agenterealiza múltiples búsquedas sin obtener el contexto del proyecto y solo puede ofrecer un marco genérico de preparación de reuniones, pidiendo al usuario que aporte material adicional.
La comparación muestra que, con el espacio de conocimiento personal activado, WorkSwarm puede aprovechar el conocimiento acumulado de fuentes como los favoritos del navegador del usuario, las columnas de Zhihu y otras, para completar las tareas más rápidamente.
Además, el equipo de openJiuwen construyó un conjunto de pruebas de 25 preguntas, basado en material de siete tipos de fuentes: artículos locales, favoritos del navegador, documentos de Feishu, GitHub, AtomGit, Zhihu y Toutiao, que cubre escenarios como la búsqueda en una sola fuente, la síntesis entre fuentes, la reutilización con tema cambiado, los hechos faltantes y las tareas irrelevantes, y estableció previamente puntos de aceptación para cada pregunta. Los resultados de las pruebas muestran que, tras activar el espacio de conocimiento personal:
- la tasa de aprobación de tareas aumentó un 32%. El espacio de conocimiento personal facilita que el agente localice el material necesario y responda combinando información personalizada de distintas fuentes, reduciendo los casos en los que la tarea no se completa por no encontrar el material o por omitir información.
- el tiempo total de las tareas se redujo un 76.2%. El material se recopila y organiza de antemano, de modo que durante la tarea se pueden consultar directamente los documentos relevantes, reduciendo los pasos de búsqueda, lectura y organización improvisada del material original.
- el consumo total de tokens en la fase de tarea se redujo un 84.1%. El conocimiento organizado puede reutilizarse en diferentes tareas; el agente lee el contenido relevante según las necesidades de la tarea, reduciendo el consumo de tokens derivado de reorganizar repetidamente el material original y de introducir contenido irrelevante.
Este experimento utilizó un procesamiento mediante agente; aunque la fase de preprocesamiento también consume tokens, ese coste puede controlarse eligiendo un modelo adecuado para la organización de material y de precio más bajo, y se amortiza gradualmente a medida que los resultados de la organización se reutilizan en múltiples tareas.
Conclusión
El espacio de conocimiento personal de openJiuwen organiza el material personal disperso en conocimiento reutilizable de forma sostenible. El usuario elige libremente las fuentes, el sistema las recopila y actualiza continuamente, de modo que el material resulta fácil de consultar y puede ser leído por el agente según las necesidades, proporcionando contexto para diferentes tareas.
En el futuro, el espacio de conocimiento personal de openJiuwen planea combinar los registros de uso del usuario para identificar objetivos de trabajo y lagunas de conocimiento, y aportar material de forma proactiva, de manera que la acumulación de conocimiento se ajuste mejor a las necesidades reales y que el agente de oficina te entienda cada vez mejor con el uso.
El espacio de conocimiento personal convierte el material que has acumulado en el punto de partida de tu próxima colaboración con un Agent.
El espacio de conocimiento personal ya está disponible en WorkSwarm; los usuarios interesados pueden descargarlo con un clic desde el sitio web oficial y probarlo de inmediato:
Sitio web oficial de WorkSwarm: https://openjiuwen.com/workswarm
GitHub: https://github.com/openJiuwen-ai/jiuwenswarm
AtomGit: https://atomgit.com/openJiuwen/
*Este artículo se publica con autorización otorgada a QbitAI; las opiniones pertenecen exclusivamente al autor original.