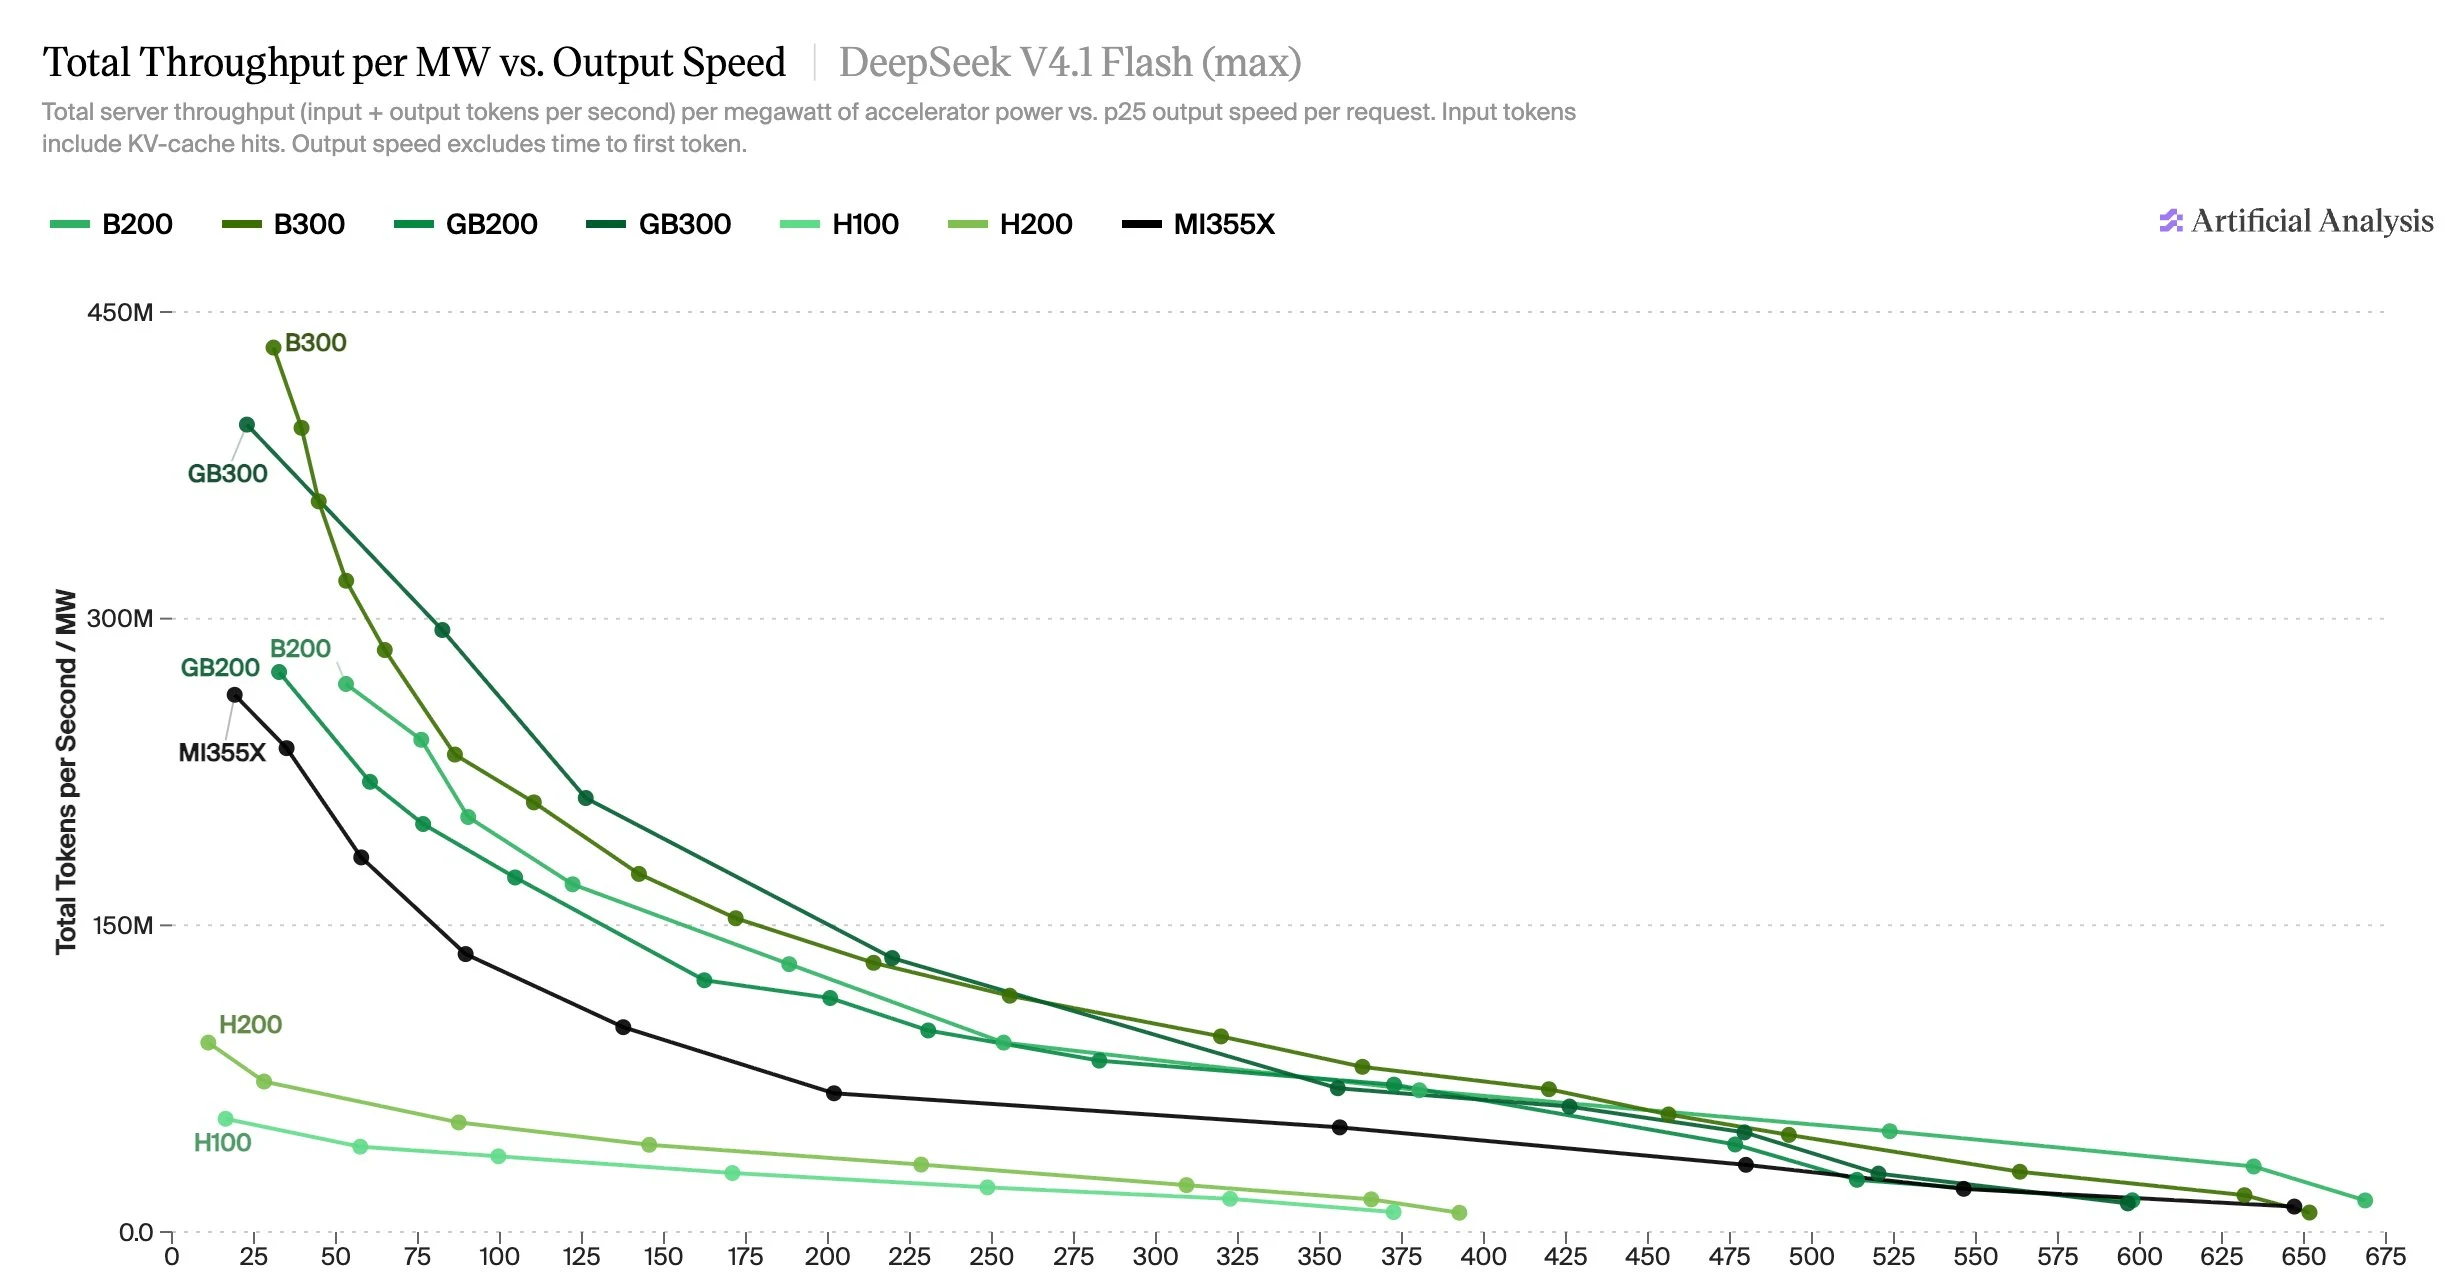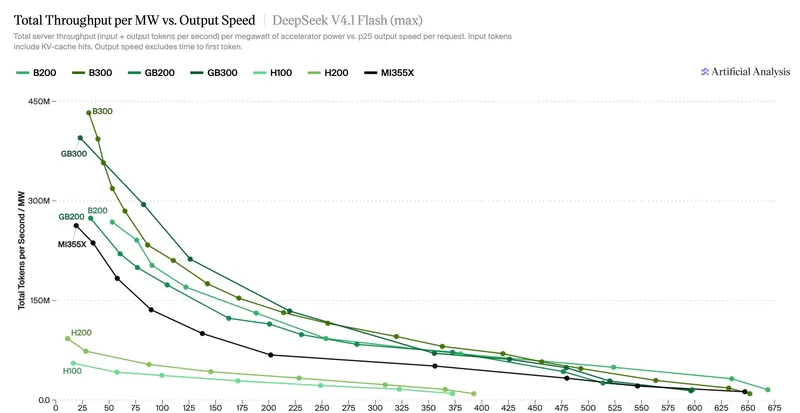
Hemos añadido DeepSeek V4.1 Flash a AA-AgentPerf, con resultados para hardware NVIDIA y AMD. A una velocidad de 100 tokens/s por usuario, el NVIDIA GB300 ocupa el primer lugar, con un rendimiento de hasta 261M tokens/s por MW.
AA-AgentPerf es nuestro benchmark de rendimiento de inferencia agente. Reproduce sesiones reales de codificación agente, incluyendo el almacenamiento del prompt y los retrasos en las llamadas a herramientas, para ofrecer una medida realista del rendimiento de inferencia en las cargas de trabajo agente cotidianas. Medimos el rendimiento total del sistema por megavatios de potencia de ejecución y la velocidad de salida por agente en diferentes niveles de concurrencia, para mostrar el equilibrio entre la utilización del sistema y la experiencia de usuario individual.
DeepSeek V4.1 Flash se une al leaderboard hoy. Añade cuatro modelos destacados al leaderboard, junto con DeepSeek V4 Pro 0813, Kimi K3 y GLM-5.2/5.3. Estamos desarrollando los modelos destacados a medida que se lanzan nuevos modelos de peso abierto populares, y mostraremos los resultados del día 0 para los principales lanzamientos futuros.
Contexto sobre DeepSeek v4.1 Flash:
➤ Obtiene una puntuación de 39 en el Índice de Inteligencia de Análisis Artificial, por delante del anterior V4 Pro 0813 de DeepSeek, que tenía una puntuación de 36, con aproximadamente un tercio de los parámetros (552B ‘esqueleto’ y 16B activos, en comparación con 1.6T y 49B).
➤ Está construido sobre una nueva arquitectura, con un diseño de codificador-decodificador causal que activa 8B parámetros por token de entrada y 16B por token de salida. Utiliza además 196B parámetros de memoria n-grama de Engram que pueden alojarse en la memoria del host en lugar del acelerador, y atención comprimida y escasa que requiere aproximadamente un cuarto de la memoria KV del modelo Flash V4 anterior por token.
➤ Esto hace que sea mucho más eficiente el servicio, ya que las pesas se ajustan a menos GPU y el caché KV más pequeño deja espacio para más agentes concurrentes por GPU
Resultados iniciales de AA-AgentPerf para DeepSeek V4.1 Flash:
➤ V4.1 Flash funciona con tan solo 2 GPU, por lo que los sistemas a escala de rack tienen menos ventaja en comparación con nodos individuales de 8 GPU como el B300, que se queda dentro de aproximadamente el 20% del rendimiento del GB300 NVL72 a escala de rack en toda la curva, y lidera en ambos extremos
➤ A 100 tok/s por usuario, GB300 lidera con ~261M tokens/s por MW, por encima de B300 (~220M), B200 (~193M), GB200 (~178M) y MI355X (~128M)
➤ Cada sistema Blackwell y MI355X puede alcanzar una velocidad de salida de aproximadamente 600 a 670 tok/s para un único agente (es decir, con tamaño de lote de uno), en comparación con 372 a 392 tok/s en H100 y H200
➤ V4.1 Flash es tanto más inteligente que V4 Pro 0813 como mucho más barato de servir, generando entre 1.3x (GB300) y 6.2x (B200) el rendimiento por MW a 100 tok/s por usuario en comparación con su versión más grande.