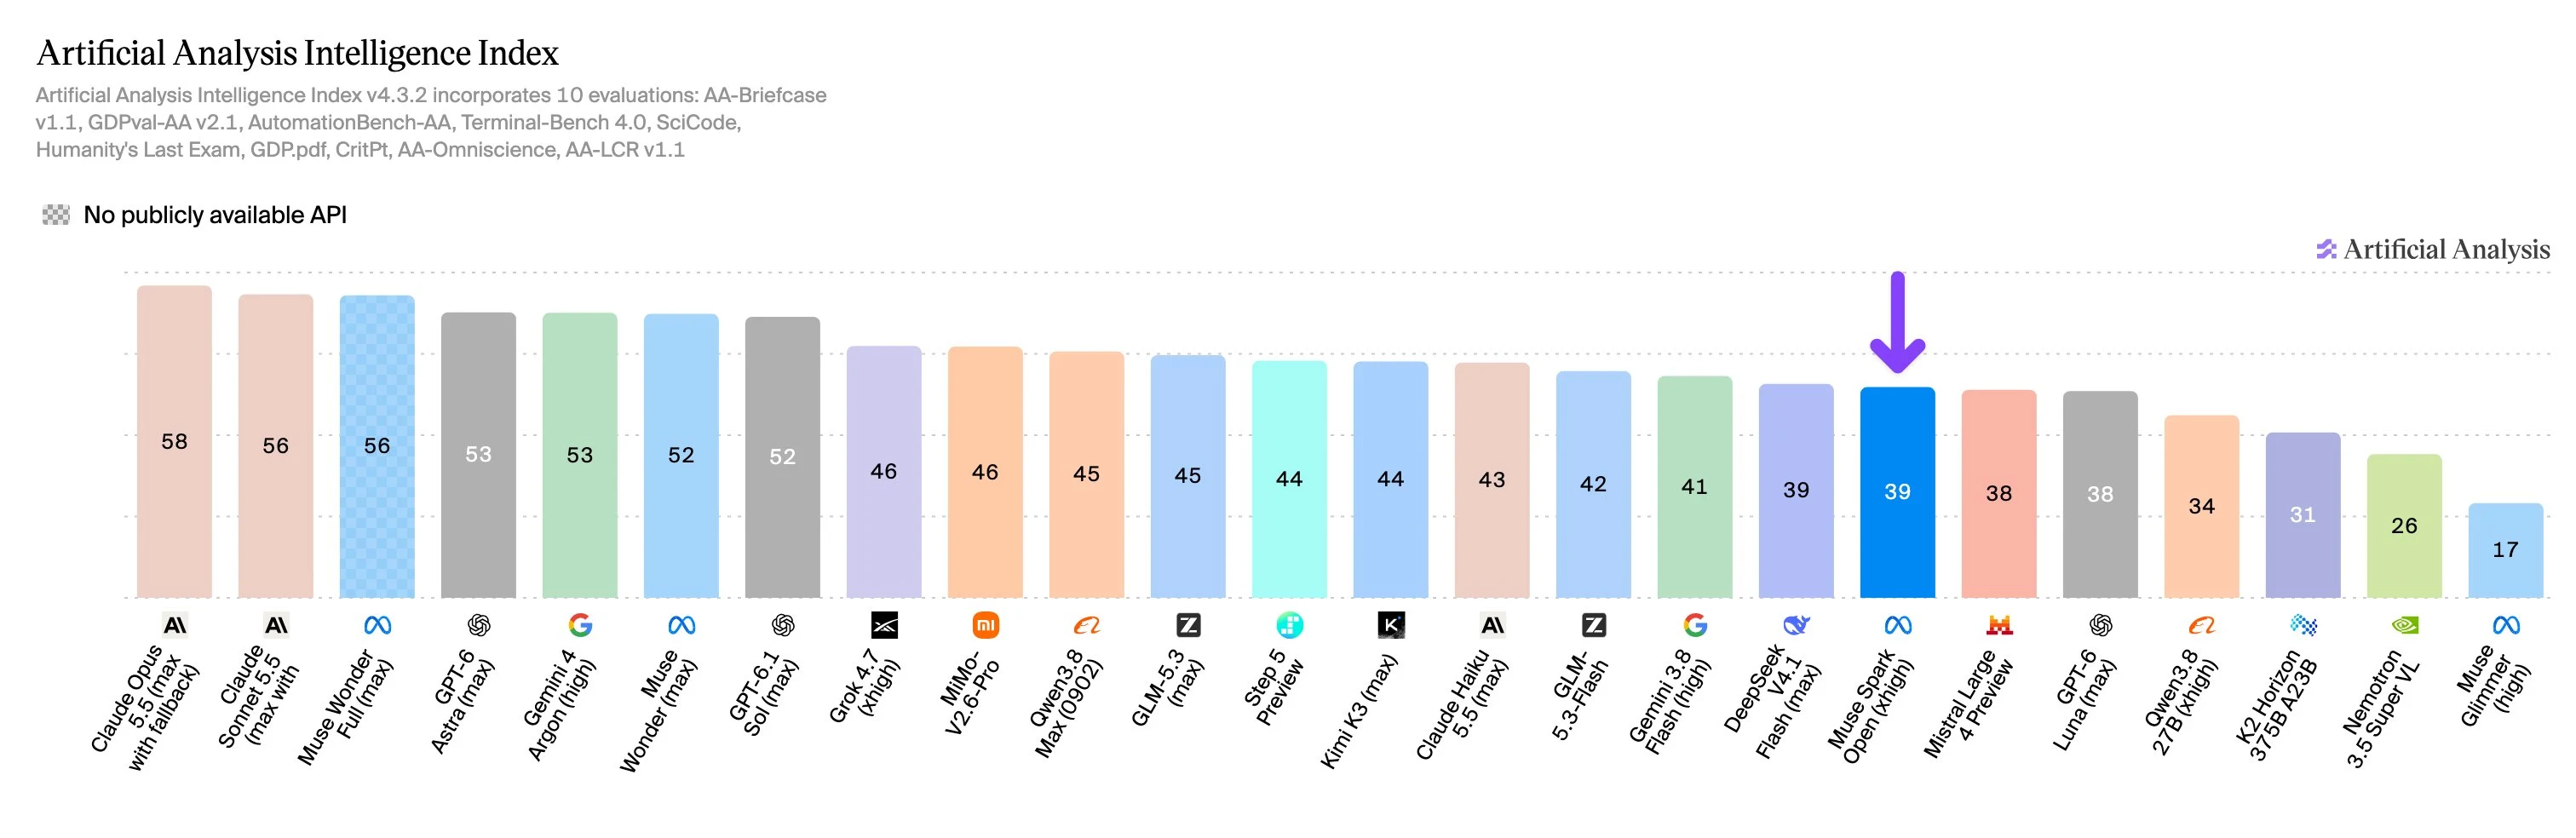
Meta ha lanzado Muse Spark Open, un modelo de pesos abiertos de 816B (42B activos) que obtiene 39 en el Artificial Analysis Intelligence Index, lo que lo convierte en el modelo de pesos abiertos #1 de EE. UU.
Muse Spark Open (xhigh) obtiene 22 puntos más que Muse Glimmer (high, 17), el modelo denso de pesos abiertos de 30B de Meta de agosto. También supera a Nemotron 3.5 Super VL (26) de NVIDIA, el siguiente modelo de pesos abiertos de EE. UU. con mayor puntuación, que se lanzó hoy
@AIatMeta nos compartió acceso antes del lanzamiento público para realizar benchmarks. ¡Felicidades a @AIatMeta, @finkd y @alexandr_wang por el lanzamiento!
Conclusiones clave:
➤ Pesos abiertos al nivel del modelo insignia de Meta de agosto. Muse Spark Open obtiene una puntuación a menos de un punto de Muse Spark 1.2 (xhigh, 40). Es más fuerte en AutomationBench-AA y tiene una tasa de alucinación más baja, pero es más débil en precisión de GDPval-AA v2.1, CritPt y AA-Omniscience. Dentro de la línea actual de Meta, queda 13 puntos por detrás de Muse Wonder (max, 52) y 17 puntos por detrás de Muse Wonder Full (max, 56)
➤ Eficiente en tokens, a un costo moderado por tarea. Muse Spark Open usa 40k tokens de salida por tarea del Intelligence Index, la menor cantidad entre los nueve modelos de pesos abiertos con mayor puntuación: por ejemplo, un 16% menos que Muse Spark 1.2 (xhigh, 48k) y un 43% menos que GLM-5.3 (max, 71k), su par chino más cercano por tamaño. Together AI, Fireworks y Baseten lo ofrecen en el lanzamiento por $1.25/$4.25 por 1M de tokens de entrada/salida ($0.15 de entrada en caché). Con ese precio cuesta $0.84 por tarea del Intelligence Index. Eso es menos que Muse Spark 1.2 ($0.97) a los mismos precios por token y menos de la mitad que GLM-5.3 (max, $2.01), pero aproximadamente tres veces más que DeepSeek V4.1 Flash (max, $0.27)
➤ Una debilidad relativa en trabajo agéntico en comparación con los líderes chinos de pesos abiertos. Entre los nueve modelos de pesos abiertos con mayor puntuación, Muse Spark Open ocupa el último lugar en las cuatro evaluaciones agénticas del índice, pero el cuarto en las otras seis combinadas, y lidera todos los modelos de pesos abiertos en AA-Omniscience (25). GLM-5.3 (max), el modelo chino más cercano por tamaño, debe toda su ventaja de 6 puntos a las evaluaciones agénticas
➤ Autoalojable en un solo nodo, o dos Mac Studios. Los pesos BF16 son de ~1.6TB. El checkpoint NVFP4 de Meta cuantiza solo los 256 expertos, reduciendo los pesos a ~530GB. Meta dice que esto funciona en cuatro GPUs Blackwell Ultra u ocho H200, o en dos Mac Studios M5 Ultra de 512GB usando MLX. La arquitectura usa 62 capas con atención grouped-query (16 cabezas KV), 8 de 256 expertos activos por token, y un Perception Encoder de 1.8B parámetros para visión
Otros detalles del modelo:
➤ Parámetros: 816B en total, 42B activos (MoE)
➤ Ventana de contexto: 1M tokens
➤ Licencia: Muse Model License, una licencia personalizada que requiere la atribución "Built with Muse Spark Open" y un acuerdo separado con Meta para negocios de Model-as-a-Service con más de $20M de ingresos anuales
➤ Modalidades de entrada: texto, imagen, video y audio. Salida: texto
➤ Disponibilidad: pesos en Hugging Face (BF16 y NVFP4), con acceso por API a través de Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter y Together AI