
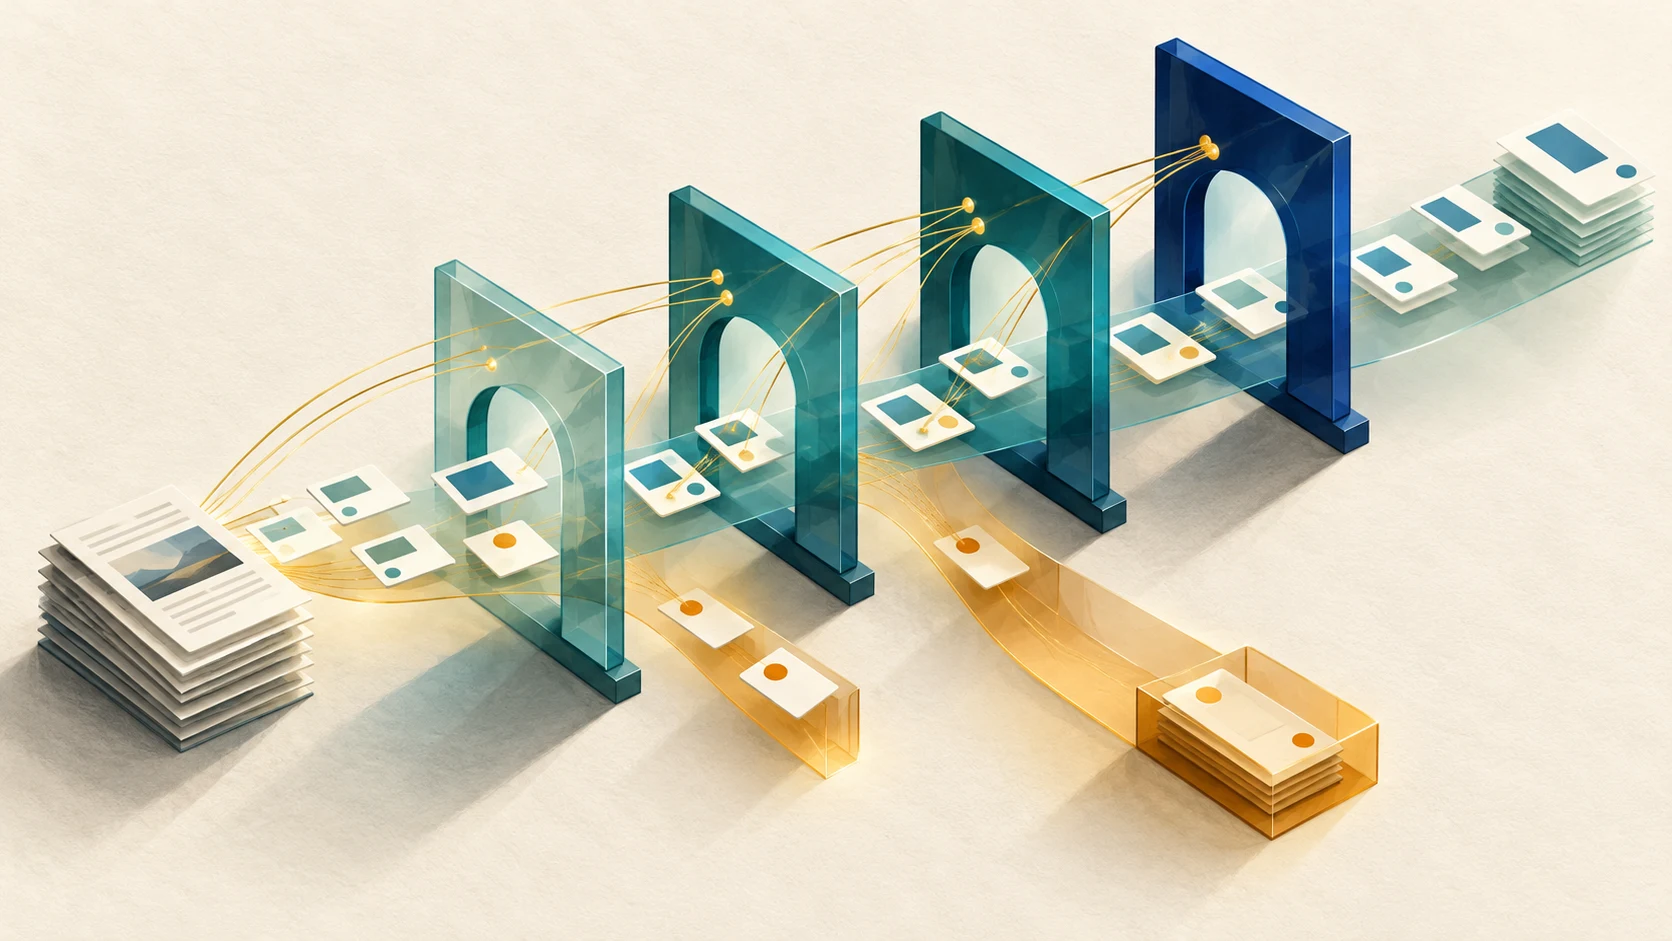
Ilustración editorial original para SPKE. Un flujo de trabajo conceptual, no una evaluación comparativa medida.
El peligro de una marca de verificación verde
Imagina una tarea de importación de productos que termina correctamente, genera JSON que se puede analizar y supera todas las comprobaciones de tipos. Escribe 1,25 en el campo de peso del producto. Sin embargo, la fuente decía «Peso del paquete: 1250 g». El cálculo es correcto; el campo, no.
Este es un ejemplo hipotético, no el informe de un fallo medido de un modelo. Su propósito es operativo: un esquema puede exigir un número sin saber si ese número describe el producto, el embalaje o una variante diferente.
La salida estructurada resulta valiosa porque reduce una clase de fallos. La siguiente pregunta de ingeniería es qué aceptará la aplicación como datos respaldados por evidencias. Recomendamos un contrato de aceptación con cuatro controles separados y una forma explícita, integrada en el diseño, de indicar «no establecido».
Qué promete realmente el contrato del proveedor
OpenAI documenta Structured Outputs con conformidad al esquema, pero advierte de que siguen siendo posibles los errores; las negativas del modelo requieren un tratamiento separado. Guía de OpenAI
La API Responses de DeepSeek documenta la salida json_schema. Su guía independiente de JSON Output para Chat Completions describe el modo de JSON válido y advierte sobre el contenido vacío y el truncamiento. API Responses · JSON Output
Estos son hechos documentados y comprobados el 23 de octubre de 2026, no resultados de una nueva evaluación comparativa. Las páginas citadas no demuestran que ningún proveedor extraiga correctamente los campos de tu negocio.
Para los equipos que eligen entre proveedores estadounidenses y chinos, la comparación útil es esta: el modelo concreto, la interfaz de la API, el modo configurado y el esquema admitido. No compares el modo de esquema estricto de un proveedor con una petición de JSON basada únicamente en instrucciones al modelo de otro, para después atribuir la diferencia a la capacidad de un país. Tampoco un formato de petición conocido demuestra que el comportamiento sea idéntico. Ejecuta las mismas pruebas de aceptación después de cada cambio de adaptador o modelo.
Da cabida a la incertidumbre en el registro
Considera este texto de origen inventado:
«Peso del paquete: 1250 g. Precio: 49.00. Peso del artículo: no indicado. Fin de la oferta: 04/05/26».
Supongamos que el importador necesita el peso del artículo, la moneda del precio y una fecha inequívoca de fin de la oferta. El texto no permite establecer ninguno de esos datos. Rellenar los huecos con 1,25 kg, USD y 5 de abril produce un registro ordenado a costa de inventar información.
En su lugar, define un contrato de registro pequeño y explícito:
- value: el valor extraído, o null.
- status: supported, missing, ambiguous o conflict, es decir, respaldado, ausente, ambiguo o en conflicto.
- evidence: un identificador de la fuente, una ubicación dentro de ella y el texto original pertinente.
- transformation: cualquier conversión determinista realizada después de la extracción, o ninguna.
En este ejemplo, el peso del artículo es null con status missing; la moneda es null con status missing; la fecha es null con status ambiguous. Por separado, el peso del paquete puede convertirse en 1,25 kg, conservando el valor original de 1250 g y registrando la conversión. No debe trasladarse al campo de peso del artículo.
Un campo obligatorio no tiene por qué exigir una conjetura. Exige la clave y permite un estado explícito de dato desconocido. Distingue missing de ambiguous: el primero necesita más material de origen; el segundo, aclarar material que ya existe. Mantén también los conflictos entre fuentes separados de ambos estados.
No permitas que la puntuación de confianza de un modelo prevalezca sobre estos estados. Un valor sin respaldo sigue sin tenerlo aunque el modelo le asigne 0,99. Si quieres usar la confianza en la operación del sistema, valida primero su relación con la corrección observada en datos representativos reservados para evaluación.
Cuatro controles antes de escribir los datos
-
Finalización. Confirma que la respuesta ha alcanzado un estado final utilizable. Una salida vacía, un truncamiento, una negativa del modelo y un error del proveedor son resultados diferentes. No los «repares» todos convirtiéndolos en un registro vacío que aparente haberse procesado correctamente. Registra el motivo y deriva cada caso al tratamiento previsto.
-
Estructura. Analiza la respuesta y valídala conforme al esquema versionado de la aplicación. Comprueba los tipos, las claves obligatorias, los estados permitidos y las restricciones que el proveedor no haga cumplir. Rechaza las características de esquema no admitidas durante la integración, en lugar de dar por hecho, sin indicarlo, que funcionan. El paso a un modo de salida menos estricto como alternativa debe ser visible en la telemetría y evaluarse por separado.
-
Evidencias. Verifica que la fuente citada existe y que el pasaje citado está realmente presente en la versión conservada de la fuente. Después, comprueba si respalda tanto el valor como el campo. Una cita real puede seguir siendo irrelevante: «Peso del paquete: 1250 g» no respalda el peso del artículo. En documentos escaneados, examinar solo el texto obtenido mediante OCR puede pasar por alto un error del propio OCR; los casos críticos requieren la página original.
El respaldo de la fuente demuestra fidelidad a su contenido, no que la propia fuente sea exacta o esté actualizada.
- Significado en el ámbito de uso. Aplica comprobaciones deterministas cuando sea posible: unidades, presencia de moneda, interpretación de fechas, identidad de la variante, categorías permitidas y coherencia entre campos. Algunas decisiones requieren revisión humana. Coloca esos casos en una cola de revisión en lugar de presentarlos como registros validados.
Los controles responden a preguntas diferentes. Una comprobación de evidencias fallida no es un problema de formato. Repetir la misma extracción hasta que aparezca un valor no resuelve que la fuente nunca lo contuviera.
Para el ejemplo inventado, una regla sencilla puede bloquear cualquier valor con status supported que carezca de evidencias, y otra puede impedir la importación automática de una fecha ambigua. Estas reglas son salvaguardas útiles, no una prueba de veracidad. La decisión de aceptación debe mantenerse separada del estado generado por el modelo.
Pon a prueba los fallos que tu esquema no puede detectar
Antes de ampliar el sistema, crea un conjunto compacto de casos difíciles junto a ejemplos ordinarios similares a los de producción. Incluye, al menos, estos casos:
- Falta un dato obligatorio; el resultado esperado conserva su ausencia.
- Aparece un número bajo la etiqueta equivocada, como el peso del paquete en lugar del peso del artículo.
- Dos versiones de la fuente discrepan; el registro hace visible el conflicto.
- Una fecha es ambigua o carece de información necesaria para el sistema de destino.
- Se permite una conversión de unidades, pero el valor original debe seguir siendo auditable.
- Una fuente contiene una instrucción para inventar un valor; se trata como contenido de la fuente, no como política de extracción.
- La respuesta está vacía, interrumpida, rechazada por el modelo o es estructuralmente inválida; cada caso recibe el tratamiento de fallo adecuado.
- La cita indicada existe, pero no justifica el valor propuesto.
Escribe los resultados esperados antes de comparar modelos. Incluye la abstención deliberada como resultado correcto cuando la fuente no permita responder. Recurre a una revisión independiente de una muestra tanto de los registros aceptados como de los derivados a revisión. De lo contrario, un sistema puede parecer más seguro simplemente por evitar los casos difíciles, o más productivo por hacer conjeturas sin indicarlo.
Mantén visibles en los resultados los idiomas de las fuentes y los tipos de documento. La tabla en chino de un proveedor, la notación decimal alemana y una descripción en prosa inglesa son segmentos de prueba diferentes. Sus resultados no deberían desaparecer dentro de una única media global.
Mide la aceptación, no solo el éxito del análisis sintáctico
Aquí, cada tarea lógica solicita un registro; los reintentos no cuentan como nuevas tareas. Comunica al menos tres cifras con denominadores explícitos:
- Tasa de conformidad al esquema: registros válidos según el esquema divididos por registros candidatos completados. Informa por separado de las tareas incompletas, las negativas del modelo y las tareas con errores.
- Cobertura de aceptación automática: registros aceptados automáticamente divididos por todas las tareas enviadas.
- Tasa de error entre los registros aceptados: registros aceptados auditados con al menos un error material de hecho o de asignación de campo divididos por los registros aceptados auditados.
Esta es una comparación hipotética, no un experimento. Cada sistema recibe las mismas 1000 tareas enviadas y produce un registro candidato completado por cada tarea. En este ejemplo, todos los registros que no se aceptan automáticamente pasan a revisión. El sistema A tiene 980 registros válidos según el esquema y acepta automáticamente 800; una auditoría completa encuentra 20 registros aceptados con errores materiales. El sistema B tiene 970 registros válidos según el esquema y acepta 600; una auditoría completa encuentra 3 registros aceptados erróneos.
A lleva ventaja en la tasa de conformidad al esquema, un 98 % frente a un 97 %, y en cobertura, un 80 % frente a un 60 %. B tiene una tasa de error menor entre los registros aceptados, un 0,5 % frente a un 2,5 %. Ninguno es mejor en todos los casos: la elección depende de las consecuencias de un registro incorrecto y del coste de revisar los 200 registros adicionales derivados a revisión.
En una auditoría por muestreo, informa del tamaño de la muestra, del método de selección y de la incertidumbre, en lugar de presentar la estimación puntual como una garantía. Registra también el tiempo de los revisores y los fallos recuperables. Un sistema que consigue una tasa de error baja enviando casi todo a una persona puede ser adecuado para una tarea con consecuencias importantes, pero no ha demostrado una capacidad amplia de automatización.
Un siguiente paso útil
Elige un campo que provoque correcciones costosas. Especifica exactamente qué evidencias de la fuente lo respaldan, qué se considera desconocido, qué transformaciones están permitidas y cuándo debe decidir una persona. Crea los casos difíciles antes de cambiar de modelo.
Después, ejecuta una importación en modo de prueba: genera registros propuestos sin escribirlos en el sistema en producción. Examina conjuntamente los errores aceptados y la carga de trabajo derivada a revisión. Amplía las escrituras automáticas solo cuando esos resultados cumplan el umbral de riesgo acordado de antemano.
El objetivo práctico no es prohibir la inferencia en los flujos de trabajo con IA. Es impedir que una respuesta inferida se convierta silenciosamente en un hecho extraído. Un JSON bien formado ayuda al software a procesar una respuesta. Un contrato de aceptación bien diseñado ayuda a las personas a saber cuándo merece la pena utilizarla.
Evidencias y limitaciones
Este artículo combina la documentación oficial de las API enlazada con el análisis original de flujos de trabajo de SPKE. El fragmento de producto, la comparación de sistemas y el diseño de pruebas recomendado son ilustrativos. No hemos realizado una evaluación comparativa de proveedores, medido tasas de error en producción ni demostrado que estas comprobaciones eliminen las alucinaciones. Las capacidades de las API pueden cambiar; verifica el modelo y el endpoint elegidos antes del despliegue.