
Del ábaco, los engranajes, la cinta de papel y los chips a las redes neuronales y un horizonte abierto. Ilustración conceptual original creada con IA, no una fotografía de un momento histórico.
Si colocamos un ábaco junto a un ordenador actual, parece que apenas tienen nada en común. Uno funciona moviendo cuentas con los dedos; el otro puede escribir código, reconocer fotografías e incluso manejar programas por nosotros. Sin embargo, ambos responden a la misma pregunta: ¿podemos sacar fuera de la cabeza el trabajo que hacemos dentro de ella?
El ábaco dio un lugar físico al valor posicional de los números. El ordenador permitió que una máquina ejecutara reglas. El aprendizaje automático avanzó un paso más: ya no hacía falta escribir todas las reglas de antemano; la máquina podía aprender de ejemplos. Con los grandes modelos de lenguaje y los agentes, empezamos a delegar también tareas: ya no solo pedimos una respuesta, sino que investiguen, programen y corrijan errores hasta entregar un resultado.
El camino nunca fue recto. Hubo promesas exageradas, recortes de financiación y largos periodos de estancamiento. También lo sostuvieron trabajos menos vistosos: mejores métodos estadísticos, conjuntos de datos más grandes, chips más baratos y software más fiable. La aceleración repentina que vemos hoy nace de la confluencia de esas mejoras acumuladas.
Este artículo se escribió el 2026-10-9. La primera parte recorre hechos que ya ocurrieron; la segunda mira hacia la AGI, cuya llegada no tiene una fecha aceptada por todos. Apostaremos por un año, sin presentar la apuesta como un hecho.
Primero aprendimos a poner los números fuera de la mente
El ábaco merece abrir esta historia, aunque no conviene llamarlo «el primer lugar donde la humanidad inventó la numeración posicional». Los tableros de cálculo, las varillas y los ábacos de cuentas pertenecen a una familia extensa; su aparición y su evolución son cuestiones distintas. En China, el ábaco de cuentas fue sustituyendo a las varillas hacia el año 1300 de nuestra era. Unidades, decenas y centenas tenían su propio lugar, y las llevadas ya no dependían solo de la memoria. Lo importante fue convertir la aritmética posicional en movimientos que podían verse y tocarse.[1]
El sistema binario resolvió otra pregunta: ¿bastan dos estados para representar todos los números? Leibniz expuso esa aritmética de forma sistemática en 1703. Los circuitos electrónicos resultaron después especialmente aptos para distinguir dos estados estables, y el sistema binario se convirtió en la base de la computación moderna. Pero por sí mismo no piensa: ofrece una representación que las máquinas pueden almacenar y manipular con facilidad.[2]
Babbage empezó a concebir la máquina analítica en 1834, reuniendo cálculo, almacenamiento y control mediante programas en un mismo diseño. No llegó a construirse por completo durante su vida, pero la idea perduró. En 1843, las notas publicadas por Ada Lovelace exploraron más a fondo la posibilidad de que una máquina procesara símbolos siguiendo una secuencia de pasos. Lo que una máquina puede hacer depende de sus engranajes o circuitos y también de nuestra capacidad para expresar un problema como programa.[3] CHM
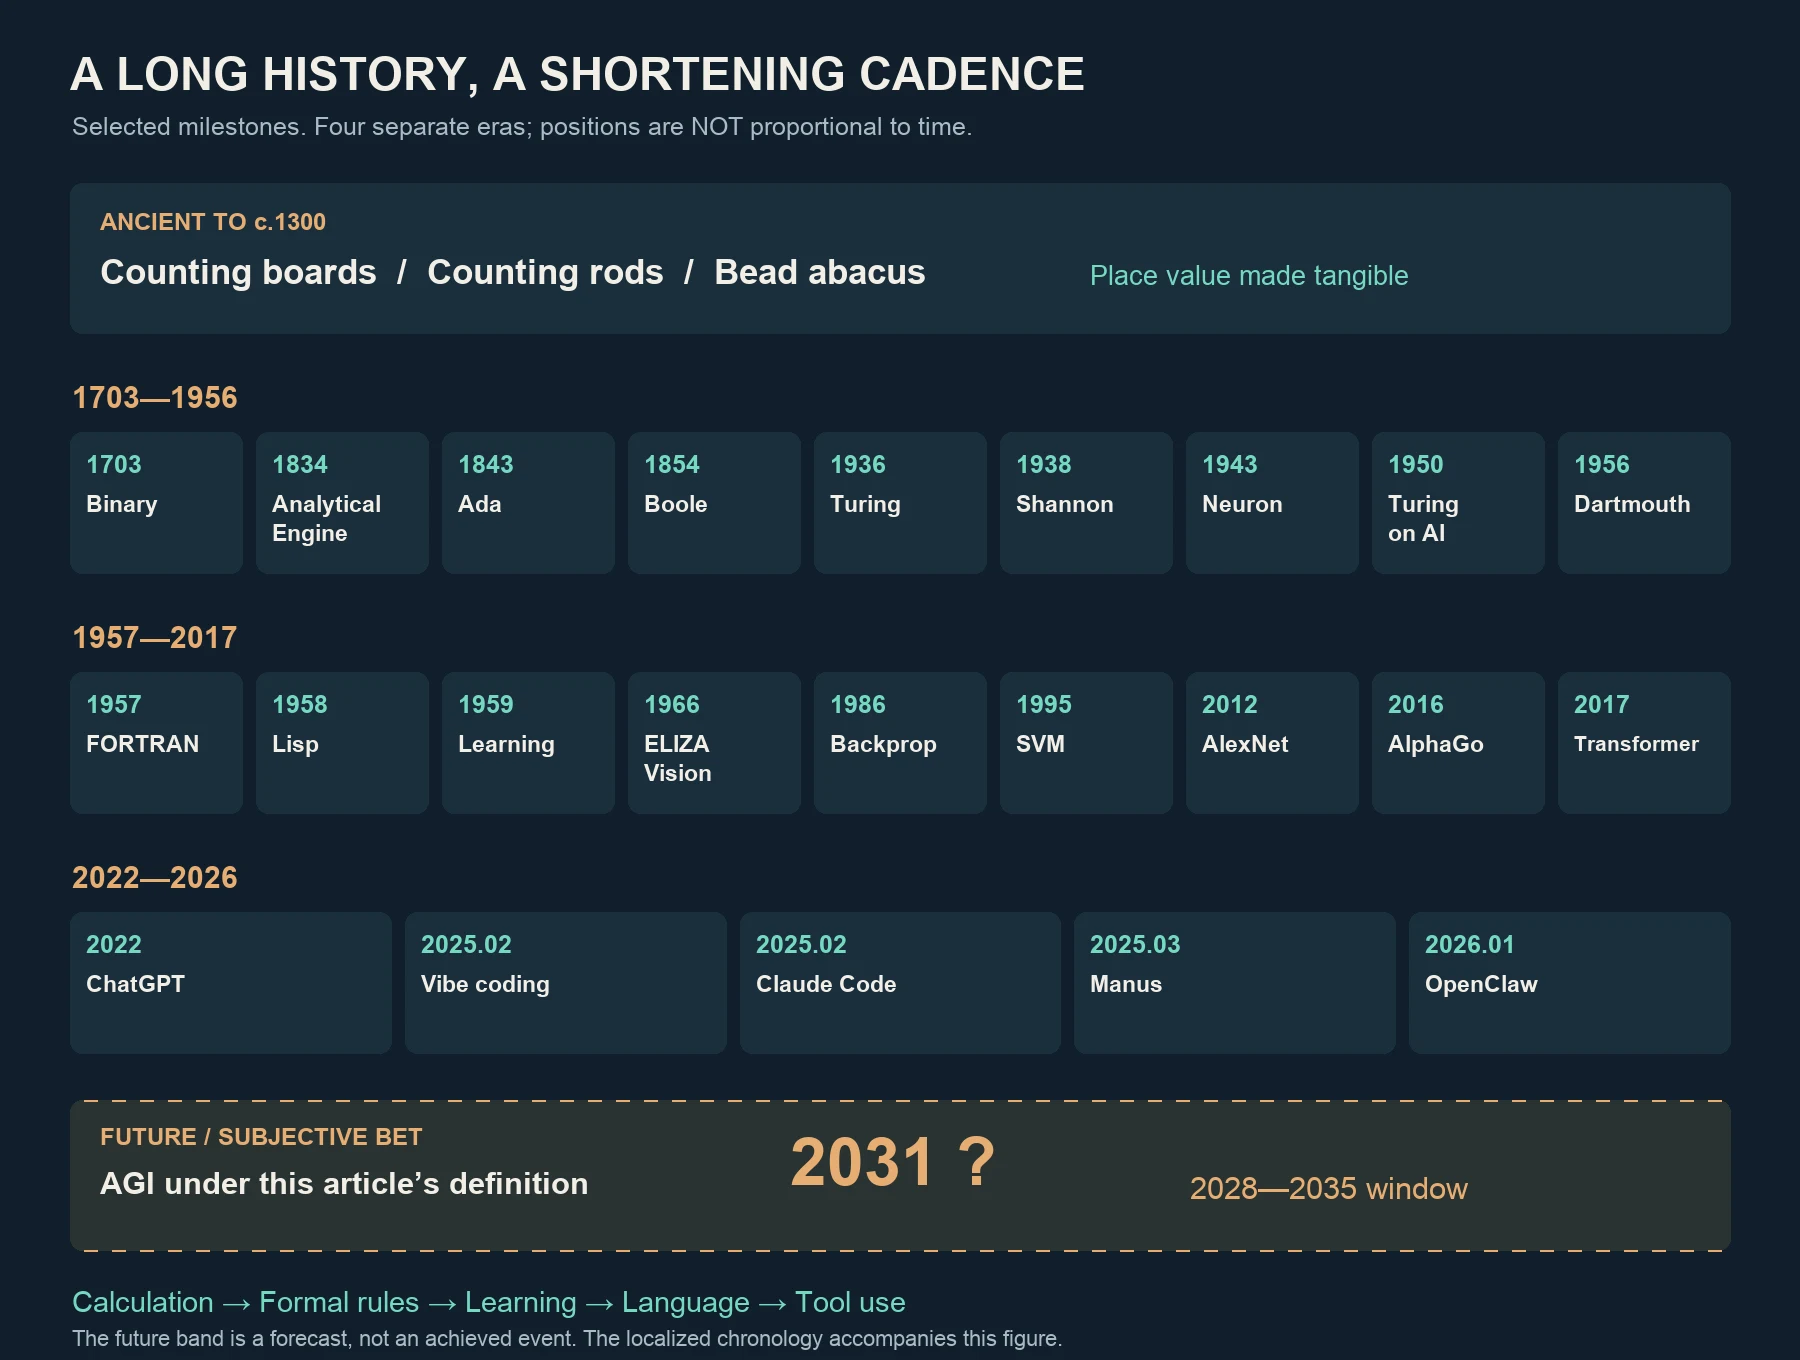
La historia del cálculo se presenta en cuatro épocas: Antigüedad, 1703–1956, 1957–2017 y 2022–2026. Los acontecimientos siguen el orden cronológico, pero los espacios no representan el tiempo transcurrido. La franja discontinua muestra una apuesta subjetiva por 2031 dentro de la ventana 2028–2035, no un acontecimiento ya ocurrido. Los nombres corresponden a la cronología siguiente.
| Fecha | Hito | Qué dejó |
|---|---|---|
| Antigüedad; hacia 1300 | Tableros de cálculo, varillas y ábacos de cuentas | El cálculo puede apoyarse en objetos externos; el valor posicional y las llevadas se convierten en acciones concretas.[1] |
| 1703 | Leibniz expone sistemáticamente el sistema binario | Dos símbolos permiten representar números y ofrecen una representación adecuada para los futuros circuitos digitales.[2] |
| 1834; 1843 | Concepción de la máquina analítica; notas de Lovelace | Cálculo, almacenamiento y control por programas comienzan a unirse; lo que se imagina para un programa va más allá de una operación aritmética.[3] CHM |
| 1854 | Álgebra de Boole | La lógica puede expresarse algebraicamente, una herramienta conceptual importante para analizar circuitos digitales.[4] |
| 1936 | Turing propone un modelo abstracto de computación | La máquina de Turing formaliza el cálculo mediante reglas y muestra que la computación tiene límites.[5] |
| 1938 | Artículo de Shannon sobre circuitos de conmutación | La lógica de Boole queda vinculada a los circuitos de relés.Artículo original |
| 1943 | Modelo de neurona artificial de McCulloch y Pitts | Se establece una influyente conexión matemática entre actividad neuronal y operaciones lógicas.Artículo original |
| 1950 | Turing publica «Computing Machinery and Intelligence» | La pregunta de si una máquina puede pensar se desplaza hacia su comportamiento observable en una interacción.Texto original |
| 1955; 1956 | Propuesta de Dartmouth; proyecto de investigación de verano | «Inteligencia artificial» se convierte en el nombre de un programa de investigación y después de una disciplina.[6] |
| 1957; 1958 | FORTRAN; Lisp | El primero impulsa el cálculo científico; el segundo se vuelve un lenguaje importante para la IA temprana.[7][8] |
Una máquina de Turing no es un ordenador inteligente listo para usar. Es un modelo abstracto que define qué significa calcular siguiendo un conjunto finito de reglas. El trabajo de Turing de 1936 tampoco garantizó que «cualquier problema acabará resolviéndose mediante cálculo». Conviene entenderlo: ninguno de los éxitos posteriores de la IA eliminó los límites de los propios problemas.[5]
En la década de 1950, los investigadores empezaron a cambiar el objetivo de las máquinas: de «calcular deprisa» a «comportarse de forma inteligente». La propuesta de Dartmouth se redactó en 1955 y el proyecto se celebró en el verano de 1956. Es un punto de partida importante de la IA moderna, aunque la humanidad ya había imaginado antes inteligencias artificiales. Más adelante, los lenguajes de programación evitaron tener que ordenar una a una las instrucciones de bajo nivel y permitieron dedicar más atención a los símbolos, la búsqueda y el razonamiento.[6][7][8]
Las máquinas aprendieron a ver, a oír y a hacer conjeturas
La IA temprana confiaba mucho en las reglas. Si se escribían los conocimientos de un experto, parecía que una máquina podría diagnosticar enfermedades, entender frases o controlar equipos. Pronto apareció la dificultad: la realidad contiene demasiadas excepciones y el sentido común es difícil de escribir entero. Los sistemas de reglas no desaparecieron, pero la investigación fue girando hacia una vía más práctica: dar suficientes ejemplos a la máquina para que aprendiera a decidir en condiciones de incertidumbre.
El reconocimiento de imágenes estudia cómo identificar objetos a partir de píxeles; el de voz, cómo convertir sonidos en texto; el procesamiento del lenguaje natural, o NLP, cómo tratar la estructura, el significado y el uso del lenguaje. Durante mucho tiempo fueron caminos separados. Más tarde empezaron a encontrarse en el aprendizaje profundo y los modelos multimodales.
| Fecha | Hito | Qué dejó |
|---|---|---|
| 1952 | Audrey, sistema de reconocimiento de dígitos hablados de Bell Labs | En condiciones limitadas, una máquina puede reconocer números en la voz; sigue muy lejos de una conversación abierta actual.Registro histórico del CHM |
| 1958 | Artículo de Rosenblatt sobre el perceptrón | Ajustar parámetros a partir de ejemplos de entrenamiento se vuelve una vía importante del aprendizaje automático temprano.[10] |
| 1959 | Artículo de Samuel sobre aprendizaje automático aplicado a las damas | La máquina puede mejorar con la experiencia; los algoritmos y los objetivos de aprendizaje siguen necesitando un diseño humano.[9] |
| 1966 | ELIZA | Unas reglas de texto sencillas pueden hacer que alguien se sienta comprendido; una conversación fluida no demuestra comprensión real.[11] |
| 1966 | Proyecto de visión de verano del MIT | Los investigadores intentan transformar estructuras de imágenes en descripciones procesables por máquinas y descubren que es mucho más difícil de lo esperado.Proyecto original |
| Décadas de 1970–1980 | Inviernos de la IA y auge y declive de los sistemas expertos | Expectativas, capacidad de cálculo y capacidad real dejan de encajar; la IA nunca ha seguido una curva ascendente sin interrupciones.[12] CHM |
| 1986 | Artículo de referencia sobre retropropagación | Se difunde un método de entrenamiento influyente para redes multicapa; las ideas relacionadas no nacieron todas ese año.[13] |
| Décadas de 1980–1990 | Reconocimiento estadístico de voz y NLP estadístico | La probabilidad permite tratar la ambigüedad y el ruido, sustituyendo poco a poco la esperanza de escribir todas las reglas.Revisión sobre voz; artículo sobre traducción estadística |
| 1995 | Artículo de Cortes y Vapnik sobre máquinas de vectores de soporte | Construir fronteras de clasificación robustas con pocas muestras se convierte en una herramienta importante del aprendizaje automático.[14] |
| 1997 | Deep Blue derrota a Kaspárov | Un sistema especializado puede superar a los mejores ajedrecistas, pero su nivel en ajedrez no se convierte automáticamente en capacidad general.[15] |
| 1998 | Artículo de referencia sobre LeNet | Las redes convolucionales muestran utilidad práctica para reconocer dígitos manuscritos y documentos.[16] |
| Décadas de 2000–2010; 2013 | Predicción de clics publicitarios a gran escala; artículo de referencia de Google | El aprendizaje automático entra en decisiones comerciales en tiempo real y mejora sus predicciones con enormes cantidades de información de retorno.[19] |
| 2009; 2012 | Conjunto de datos ImageNet; AlexNet | Los grandes datos, las GPU y las redes profundas confluyen y producen un avance notable en reconocimiento de imágenes.[17][18] |
| 2012 | Revisión de redes neuronales profundas para reconocimiento de voz | El aprendizaje profundo cambia el modelado acústico y abre una nueva etapa de mejora de los sistemas de voz.Revisión de investigación |
| 2014 | GAN | El entrenamiento adversarial amplía los caminos de los modelos generativos.Artículo original |
| 2016; 2017 | AlphaGo derrota a Lee Sedol; derrota a Ke Jie | Redes profundas, búsqueda y aprendizaje por refuerzo se combinan para superar un reto de go antes extraordinariamente difícil.[20] BGA |
| 2017 | Transformer | La atención ofrece una arquitectura más adecuada para entrenar en paralelo y se convierte en una base clave de los grandes modelos de lenguaje posteriores.[21] |
| 2018 | BERT | El preentrenamiento bidireccional impulsa la comprensión del lenguaje; los modelos empiezan a compartir representaciones lingüísticas más generales.Artículo original |
| 2020 | GPT-3 | Las instrucciones con pocos ejemplos muestran que los grandes modelos pueden resolver distintas tareas mediante el contexto, aunque con límites de fiabilidad.[22] |
| 2020 | DDPM | Los modelos de difusión con eliminación de ruido hacen avanzar la generación de imágenes; no son el origen de todas las ideas de difusión.Artículo original |
| 2020; 2021 | Avance de AlphaFold en CASP14; artículo metodológico | La predicción de estructuras de proteínas progresa mucho; predecir una estructura no significa haber validado un fármaco nuevo.Artículo original |
Las máquinas de vectores de soporte, o SVM, reflejan bien el espíritu de aquella época. No había ventanas de chat como las de hoy, pero el aprendizaje automático ya resolvía problemas serios y concretos. Reconocer un correo basura o clasificar una imagen solía ser más útil que proclamar que una máquina tenía pensamiento.[14]
La predicción de clics publicitarios llevó esa capacidad a escala industrial. El sistema estima «la probabilidad de que esta impresión reciba un clic en este contexto», lo que suele llamarse CTR. No lee la mente ni garantiza que un usuario concreto vaya a pulsar. Las probabilidades necesitan calibración, y los sistemas afrontan cambios de distribución, restricciones de privacidad y sesgos de retroalimentación. Su importancia está en haber incorporado el aprendizaje automático a un ciclo continuo que puede influir en los ingresos y en la distribución de información.[19]
El avance de 2012 en reconocimiento de imágenes devolvió a mucha gente la confianza en las redes neuronales. En 2016, AlphaGo llevó ese cambio ante el gran público. Aquel 4:1 correspondió a un duelo de cinco partidas con Lee Sedol, no a un título de campeón mundial; el encuentro de tres partidas contra Ke Jie en 2017 acabó 3:0. Los resultados ya eran asombrosos sin añadir una inexacta «conquista del campeonato».[18][20] BGA
Después de ChatGPT, de responder a entregar un resultado
El 2022-11-30, ChatGPT se abrió al público. Su importancia no estaba solo en tener un modelo más potente, sino en ofrecer por fin una entrada extraordinariamente sencilla: sin saber programar, cualquiera podía hablar con una máquina y pedirle explicaciones, reescrituras, traducciones o código. La IA dejó de ser únicamente una capacidad detrás de numerosos productos y se convirtió en algo que las personas buscaban utilizar.[23]
Los cambios siguientes pronto salieron de la ventana de chat. Los modelos podían leer más material y empezaron a conectarse a buscadores, archivos, ejecutores de código y navegadores. Aquí, un agente es un sistema de ejecución organizado alrededor de un modelo: conserva el estado de la tarea, llama a herramientas, comprueba resultados y decide el siguiente paso. El modelo realiza inferencias; el sistema de ejecución las conecta con el mundo. Ambos pueden equivocarse.
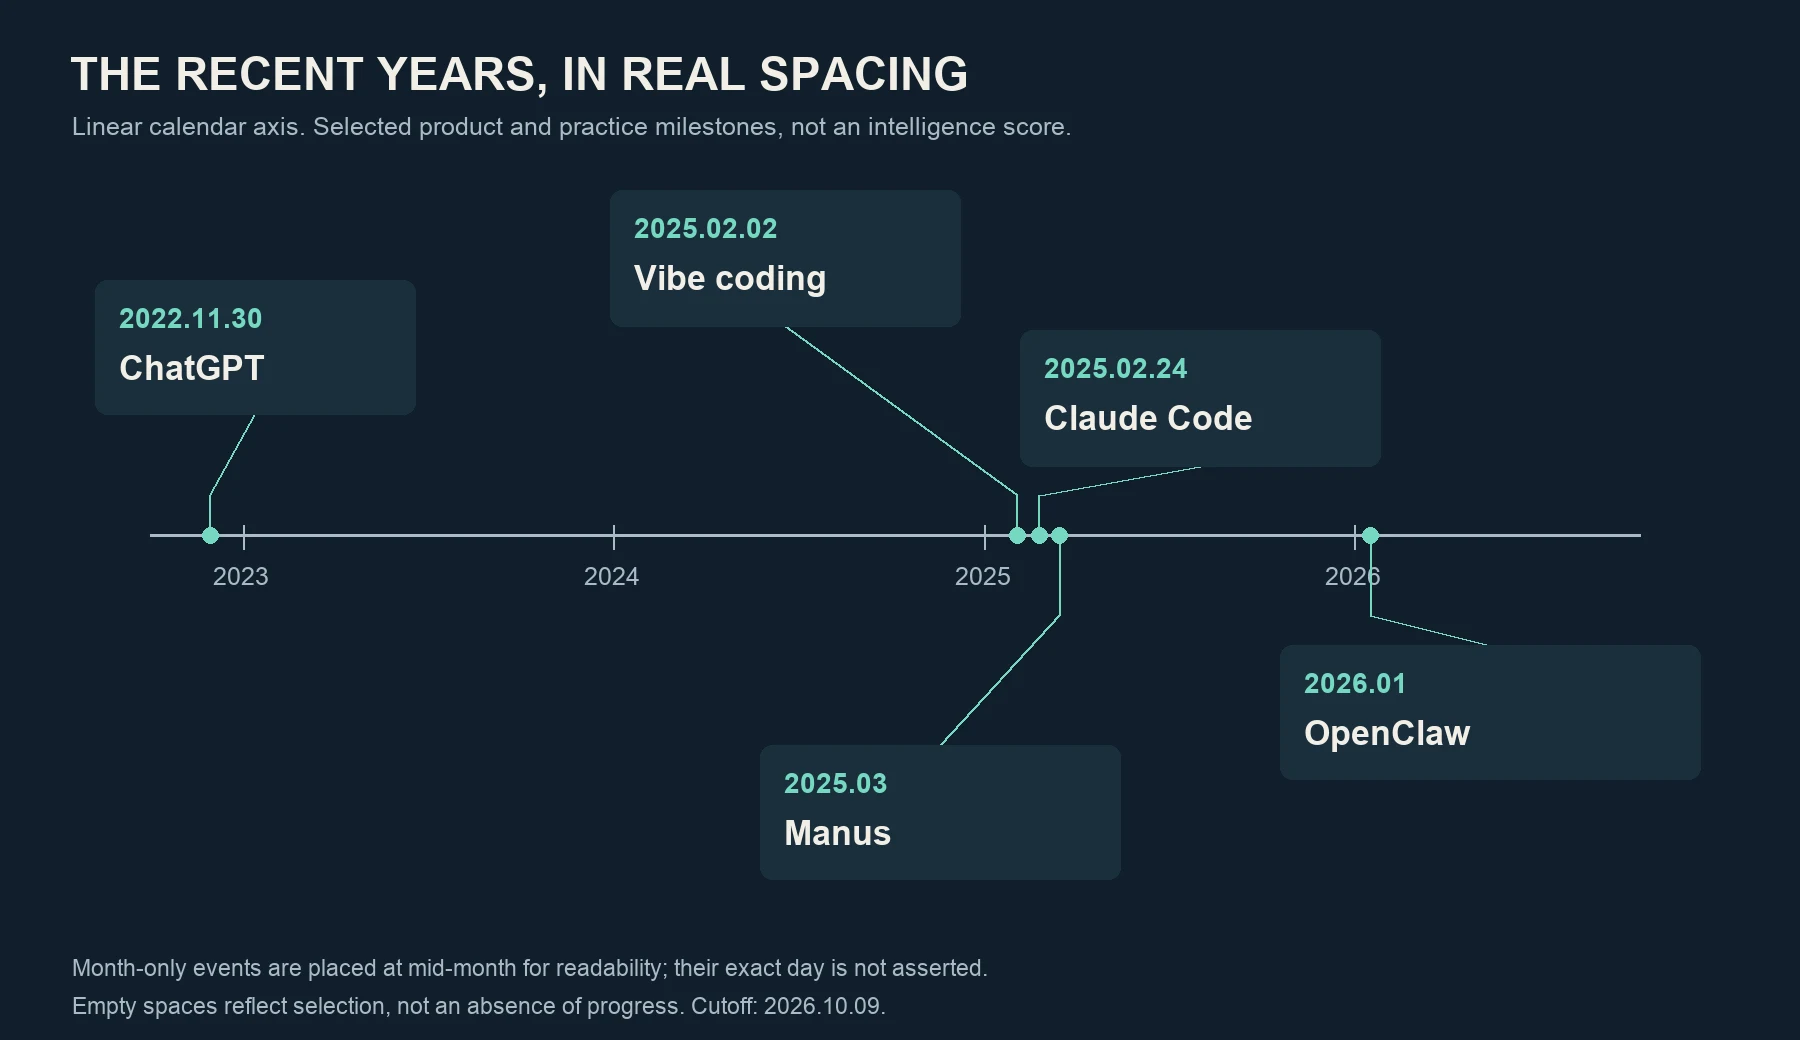
La cronología reciente de 2022–2026 utiliza una escala lineal de años: los hitos de ChatGPT, vibe coding, Claude Code, Manus y OpenClaw aparecen muy próximos. Solo se incluyen los acontecimientos elegidos para este artículo; la cantidad de puntos no equivale a una puntuación de inteligencia general. Los acontecimientos conocidos solo por mes se sitúan a mediados de mes, sin afirmar un día exacto.
| Fecha | Hito | Cómo entenderlo |
|---|---|---|
| 2022-11-30 | Lanzamiento público de ChatGPT | El lenguaje natural se convierte en una puerta de entrada popular a la IA generativa.[23] |
| 2025-2 | Se difunde el término «vibe coding» | Karpathy describe una práctica muy dependiente del código generado, con menor comprensión línea por línea; no es el nombre de todo desarrollo asistido por IA.Copia del mensaje original |
| 2025-2-24 | Vista previa de investigación de Claude Code | Un asistente de programación llega al terminal y puede trabajar con el repositorio y las herramientas.[24] |
| 2025-3 | Primera presentación pública de Manus | Un producto de agentes para completar tareas de varios pasos pone en primer plano «hazlo por mí».[25] |
| 2026-1 | Cambio de nombre y difusión pública de OpenClaw | Un agente personal autogestionado atrae atención hacia la mensajería, el estado persistente y la conexión a herramientas; es un sistema de ejecución, no un nuevo modelo fundacional.[26] |
Claude Code y vibe coding suelen aparecer en la misma frase, pero no son equivalentes. El primero es una herramienta; el segundo, una forma de usarla. Los desarrolladores profesionales también pueden emplear esa herramienta para leer el código con atención, revisar cambios y ejecutar pruebas. Que una máquina escriba deprisa no hace desaparecer la responsabilidad.[24] Copia del mensaje original de Karpathy
Manus y OpenClaw muestran dos decisiones de producto representativas: una pone el acento en encargar tareas de varios pasos a un servicio; la otra, en conectar un asistente permanente al entorno propio. Hacen visible el potencial de la ejecución autónoma y sus nuevas dificultades: ¿cuántos permisos dar, cómo detectar un fallo y cómo revertir una operación que ya salió mal? Son preguntas tan importantes como la capacidad del modelo para responder exámenes.[25][26]
La aceleración es real, pero ¿qué se está acelerando?
La humanidad tardó muchísimo en conservar y transmitir conocimiento. Entregar reglas a máquinas electrónicas llevó décadas. Pasar de asistentes de conversación para el público a la ejecución cotidiana de herramientas solo llevó unos años. A escala de una vida, la compresión es intensa. Antes era posible llegar a la edad adulta y conservar un mismo método de trabajo durante toda la carrera. Ahora, las puertas de entrada al trabajo y los límites de las herramientas disponibles pueden cambiar varias veces en pocos años.
Podemos afirmar que el ciclo de renovación de muchas herramientas cognitivas se ha acortado de varias generaciones a una sola vida, y de décadas a años. Eso no permite asegurar que la «cantidad total de progreso» reciente supera la de las décadas anteriores, ni que aquellas décadas superan toda la evolución biológica humana. Esas últimas comparaciones carecen de una unidad común. Las herramientas de piedra, la escritura, la agricultura, la Revolución Industrial y los modelos de lenguaje no son puntuaciones que puedan sumarse directamente.
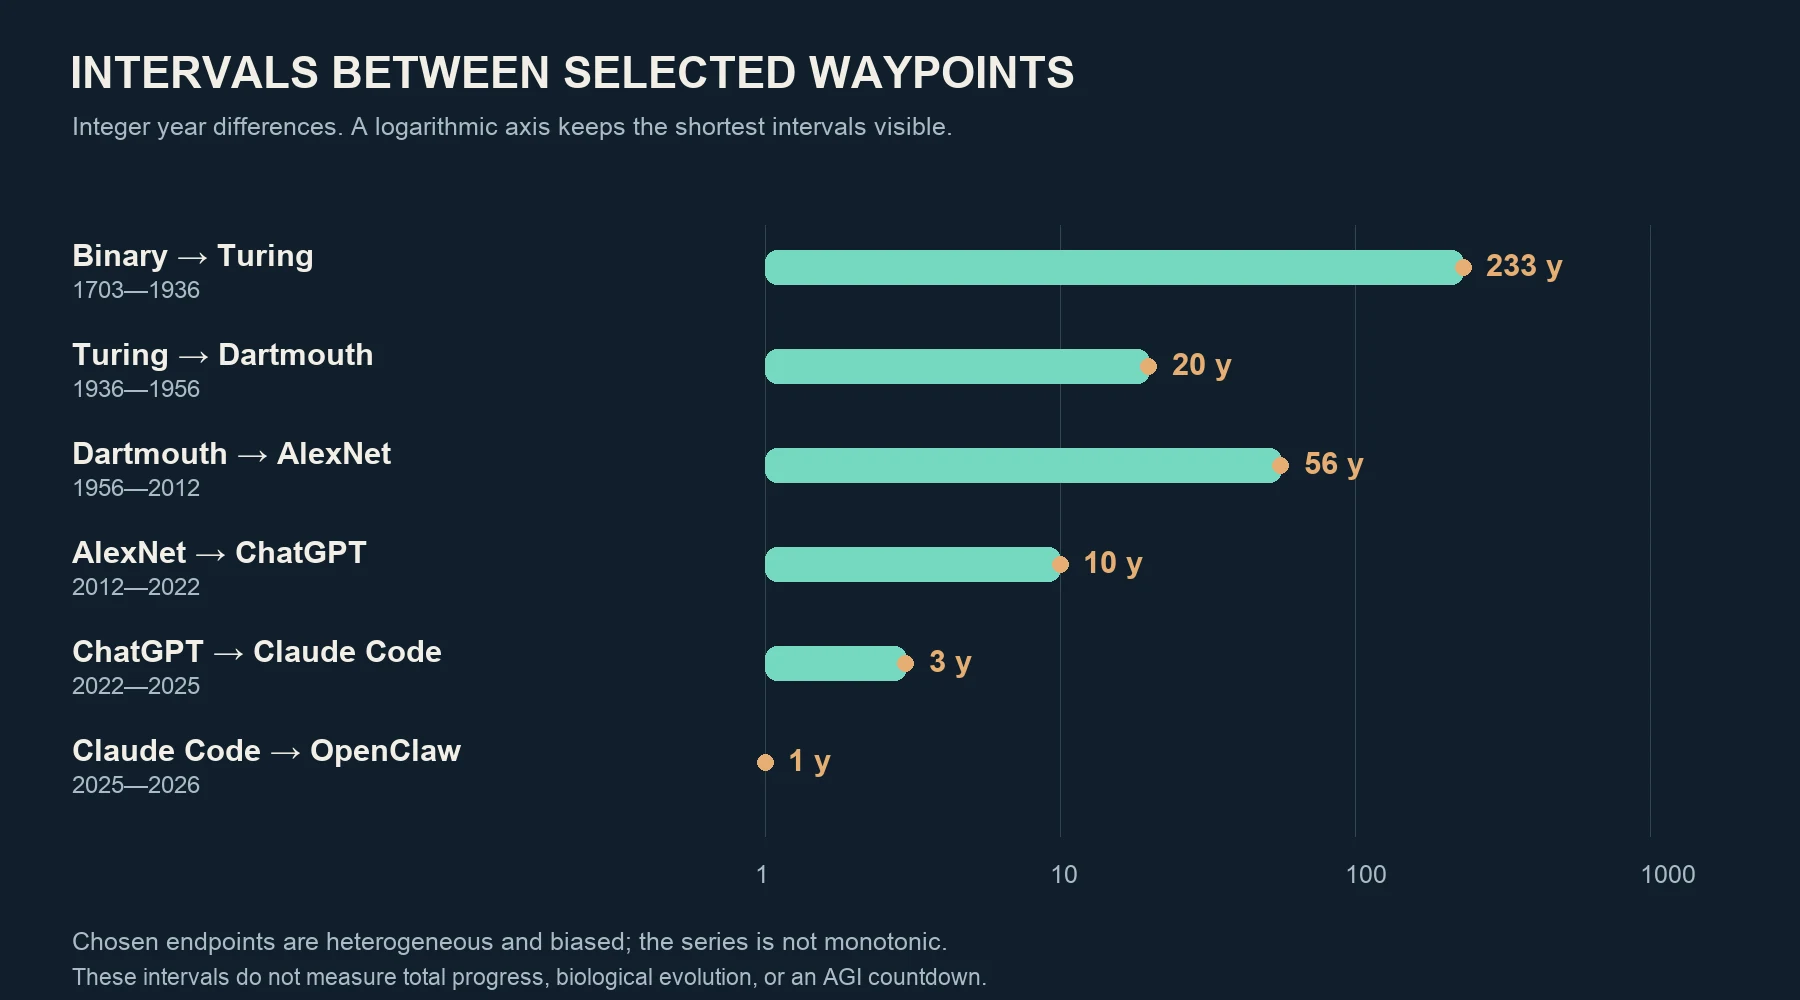
Intervalos entre algunos hitos seleccionados: 1703–1936 son 233 años; 1936–1956, 20 años; 1956–2012, 56 años; 2012–2022, 10 años; 2022–2025, 3 años; y 2025–2026, 1 año. La longitud de las barras usa una escala logarítmica y las cifras son diferencias entre años enteros. La selección tiene sesgo y la secuencia no disminuye siempre; no permite calcular una tasa de crecimiento de la inteligencia.
Las pruebas más firmes vienen de medidas concretas. El AI Index de Stanford de 2025 señala que el coste de inferencia para alcanzar un rendimiento en MMLU equivalente a GPT-3.5 bajó de 20 dólares por millón de tokens en 2022-11 a 0.07 dólares en 2024-10: una reducción de más de 280 veces. Compara costes para un umbral específico de capacidad, no afirma que todos los modelos se abarataran en la misma proporción.[28]
Un estudio publicado por METR en 2025 observó un cambio más cercano a «qué duración de tarea puede resolver». En su conjunto de tareas de software y razonamiento, el tiempo de trabajo de expertos humanos correspondiente a tareas que la IA de frontera completaba con un 50% de éxito se había duplicado aproximadamente cada 7 meses desde 2019. Se trata del tiempo que necesita una persona para hacer la tarea, y acertar la mitad de las veces no es una entrega fiable. El resultado da motivos para extrapolar, aunque impone grandes límites a su aplicación fuera de ese contexto.[27]
La aceleración también puede crear parte de sus propias condiciones. Una IA mejor ayuda a escribir software, realizar experimentos y optimizar sistemas; esos trabajos pueden mejorar la siguiente generación de IA. Pero la existencia de retroalimentación no la hace ilimitada. La calidad de los datos, la energía, los chips, la velocidad experimental, la fiabilidad y la adopción por las organizaciones pueden frenar el proceso. Los periodos de retroceso históricos recuerdan que un tramo ascendente no elimina futuras mesetas y caídas.
Apuesto por 2031, pero antes fijemos el umbral de AGI
AGI suele traducirse como inteligencia artificial general, aunque no hay una respuesta única a «¿hasta qué punto general?». Algunas definiciones exigen abarcar la mayoría de las tareas económicas; otras ponen el acento en aprender habilidades desconocidas o incluyen la autonomía. Los estudios sobre niveles de AGI separan capacidad, amplitud y autonomía, algo más útil que discutir una consigna.[29]
Aquí solo hablamos de una AGI práctica: un sistema que, en entornos digitales con permisos claros, pueda aprender tareas nuevas y realizar de forma estable un amplio abanico de trabajos cognitivos profesionales a un coste aceptable. No necesita conciencia ni un cuerpo humano, y tampoco equivale a una superinteligencia que supere a todas las personas en todos los ámbitos.
Para poder comprobar la predicción en el futuro, proponemos un umbral elegido deliberadamente. Es la definición operativa de este artículo, no un estándar del sector ni una certificación de seguridad:
| Criterio de aceptación | Umbral adoptado aquí |
|---|---|
| Amplitud | Alcanzar la mediana de rendimiento humano cualificado en al menos 5 de estas 6 categorías: ingeniería de software, análisis de información, asistencia a la investigación, comprensión multimodal, planificación y aprendizaje de herramientas nuevas. |
| Tareas desconocidas | Al menos 100 tareas no públicas por categoría; controlar filtraciones de datos de entrenamiento y permitir un uso razonable de herramientas y el aprendizaje de tareas nuevas. |
| Fiabilidad | Al menos 90% de éxito en cada ámbito que cumpla los requisitos anteriores; evaluación mediante criterios revisables fijados de antemano. |
| Tareas largas | Incluir tareas que requieran al menos 8 horas de un experto humano; admitir como máximo 2 aclaraciones humanas por tarea, sin rescates continuos. |
| Coste | Contar inferencia, herramientas, revisión y trabajo repetido; el coste por tarea no debe superar el coste humano bajo los mismos criterios de aceptación. |
| Reproducibilidad | Replicación por al menos 2 organizaciones evaluadoras independientes; mantener esos resultados durante 90 días de evaluación continua, más allá de una demostración lucida. |
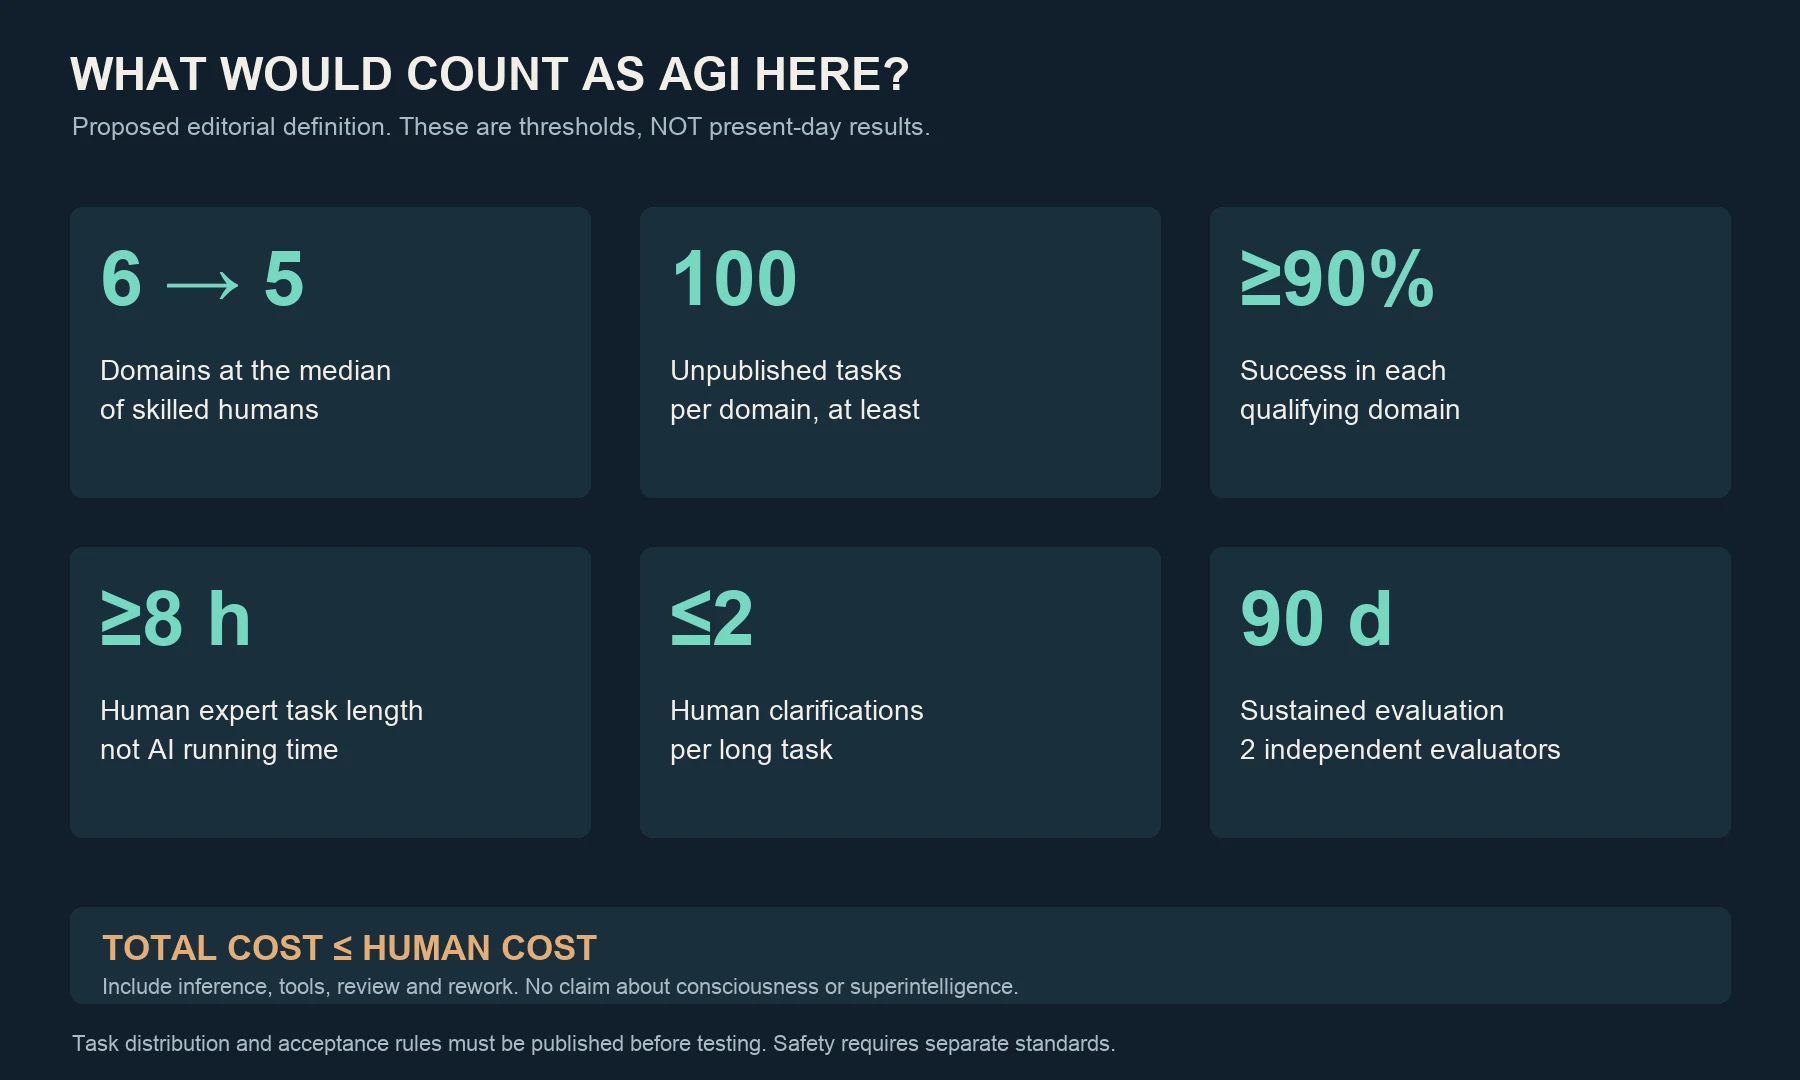
Esquema del umbral de AGI de este artículo: al menos 5 de 6 categorías, 100 tareas no públicas, 90% de éxito, tareas de 8 horas humanas, un máximo de 2 aclaraciones y replicación durante 90 días. Son requisitos de aceptación elegidos, no resultados medidos de sistemas actuales ni un estándar consensuado de AGI.
Estos criterios siguen siendo discutibles. La selección de tareas, la contratación de personas cualificadas y la evaluación de la asistencia científica deben explicarse de antemano. Las tareas que afecten a la seguridad personal necesitarán regulación y estándares profesionales adicionales. Su utilidad es reemplazar «parece que ya hemos llegado» por un juicio que pueda cuestionarse, repetirse y refutarse.
Si debo elegir un año, apuesto por 2031. Prefiero observar la ventana 2028–2035 a adivinar un mes y un día. Estas son mis probabilidades acumuladas subjetivas, a fecha de publicación, para la primera confirmación independiente según el umbral anterior. No están calibradas por un modelo estadístico ni representan un consenso de expertos:
| Primera confirmación | Mi probabilidad acumulada subjetiva |
|---|---|
| Antes de terminar 2028 | 20% |
| Antes de terminar 2031 | 50% |
| Antes de terminar 2035 | 75% |
| Después de 2035, o las vías actuales no llegan a alcanzar el umbral de este artículo | El 25% restante |
El año 2031 es el juicio mediano de esta distribución subjetiva, no un plazo técnico. El 75% hasta 2035 ya contiene las probabilidades anteriores; no deben sumarse las filas. El 25% restante tampoco significa que la AGI nunca aparecerá: incluye tanto una llegada posterior como el fracaso de las vías actuales.
Apuesto así porque lenguaje, visión, programación y uso de herramientas están confluyendo, y porque las tendencias en tareas largas y costes merecen tomarse en serio. Pero quizá lo más difícil esté al final: aprender habilidades nuevas de forma estable, reconocer errores propios, conservar la fiabilidad en entornos desconocidos y completar trabajos que requieran información experimental. Si esos obstáculos resultan más persistentes de lo previsto, habrá que retrasar el año.[27][28][29]
¿Qué me haría cambiar de opinión? Mejoras sostenidas y reproducidas de forma independiente en el éxito de tareas largas con poca intervención humana, la transferencia a tareas desconocidas y el coste total elevarían mi probabilidad de una llegada temprana. Si las clasificaciones mejoran sobre todo por preguntas conocidas, las tareas largas siguen necesitando relevos humanos o la reducción de costes se detiene, la bajaría. Más presentaciones y más demostraciones, por sí solas, no bastan para cambiar mi juicio.
La llegada de la AGI quizá no tenga una campanada clara. Algunos descubrirán primero que ya les sirve para trabajar, mientras otros seguirán tropezando con fallos; los evaluadores confirmarán la capacidad y la sociedad cambiará poco a poco después. Superar el umbral técnico, adoptar un producto y ajustar las instituciones son momentos distintos.
El futuro optimista: la capacidad humana deja de ser tan escasa
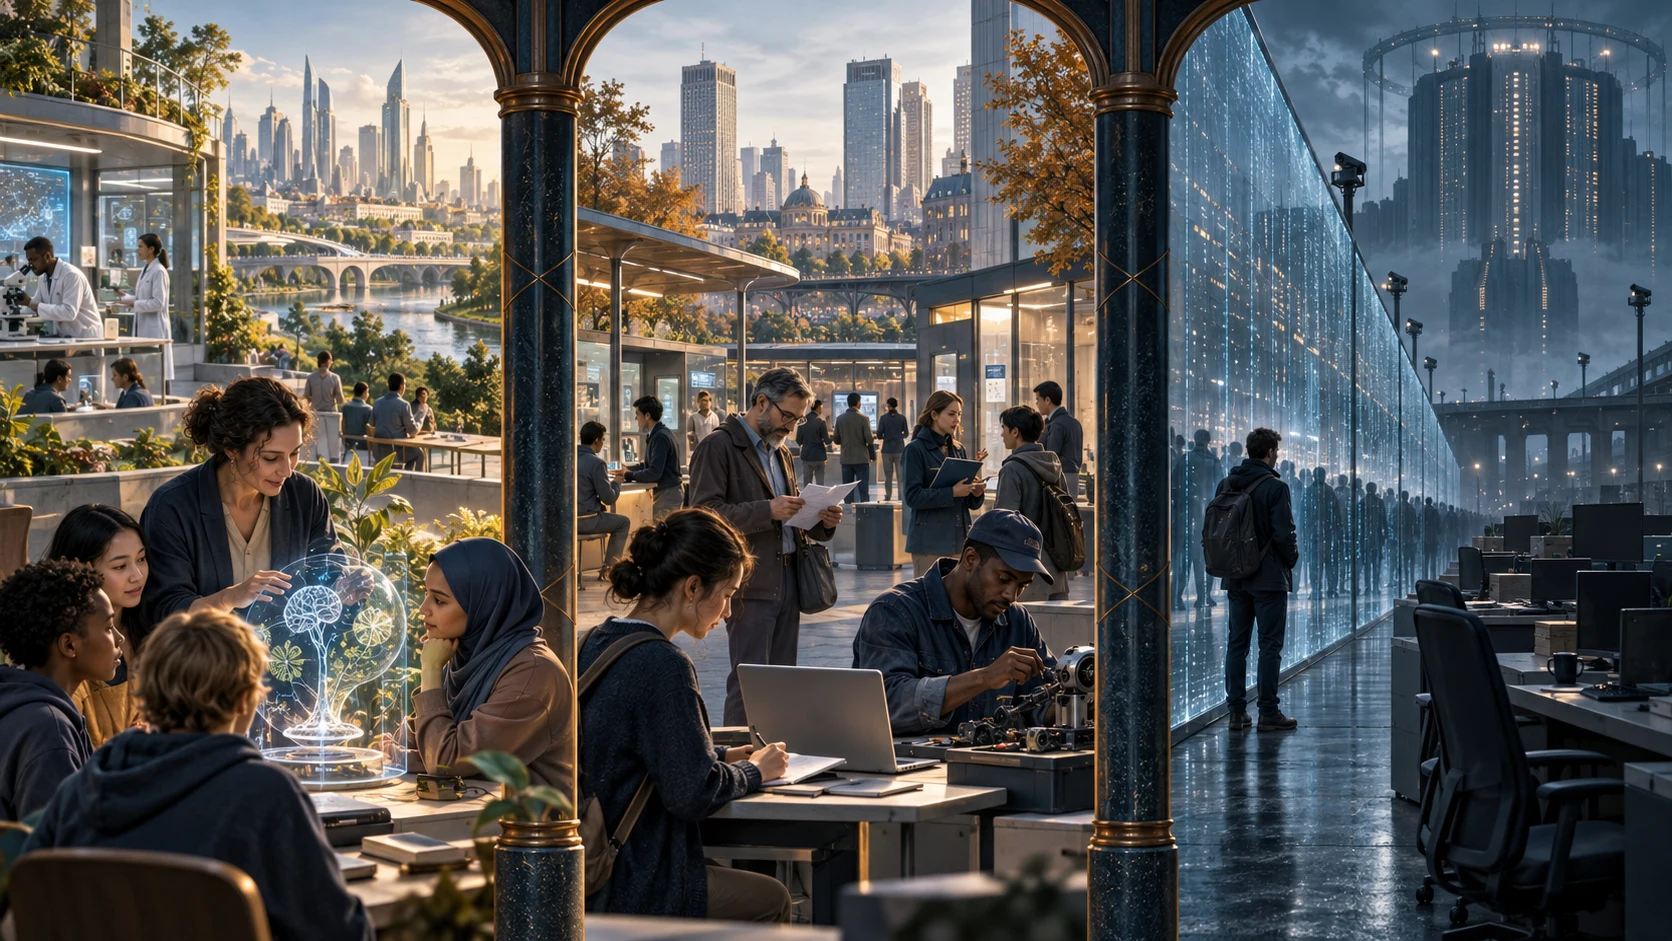
A la izquierda, conocimiento compartido y avances médicos; en el centro, transición laboral y ajustes cotidianos; a la derecha, concentración de poder y presión del desempleo. Ilustración conceptual original creada con IA de tres futuros condicionados, sin atribuirles probabilidades.
El escenario optimista exige que la capacidad sea accesible para muchos, que los despliegues sean fiables y que la sociedad quiera repartir las ganancias de productividad. Si solo unas pocas organizaciones pueden pagar los mejores sistemas, la historia cambia desde el principio.
En ciencia, la AGI podría ayudar a leer bibliografía, diseñar posibles experimentos y analizar resultados, reduciendo trabajo repetitivo en el ensayo y error. Un equipo pequeño podría disponer del cálculo y el análisis antes reservados a equipos grandes. La investigación de fármacos, materiales y energía podría acelerarse, aunque las moléculas candidatas seguirían necesitando validación, los ensayos clínicos llevarían tiempo y un texto no haría aparecer equipos de laboratorio. El cambio esperanzador sería encontrar resultados fiables más deprisa, sin prometer que las enfermedades desaparezcan de la noche a la mañana.
En educación y atención médica, las personas podrían recibir ayuda continua y paciente a menor precio. Los docentes tendrían más tiempo para atender las diferencias entre alumnos y los médicos para comprender la situación de sus pacientes. Las regiones remotas quizá recibirían primero una recopilación de información más consistente, cribados preliminares y apoyo a distancia. Para convertirlo en una mejora justa hacen falta redes accesibles, idiomas locales, protección de la privacidad y personas responsables de las decisiones finales.
El trabajo también podría dejar más espacio. Reducir documentación repetitiva, comprobaciones y coordinación liberaría tiempo para comunicarse, juzgar, cuidar y crear. Las pequeñas empresas podrían hacer cosas para las que antes no podían pagar un equipo profesional, y cualquiera convertiría con más facilidad una idea en producto. Si la productividad se traduce en menores costes de vida, jornadas más cortas y mejores servicios públicos, la mayoría vivirá mejor.
No ocurrirá automáticamente. Salarios, impuestos, políticas de competencia e inversión pública decidirán cómo repartir los beneficios. Una tecnología mejor amplía lo que se puede distribuir, pero no decide el reparto por la sociedad. En este escenario, el valor personal irá pasando de «cuánto trabajo estandarizado puedo hacer» a «qué quiero hacer, qué responsabilidades acepto y cómo convivo con los demás».
El optimismo tampoco exige dejar de aprender. Los conocimientos básicos permiten detectar si una máquina dice disparates; la experiencia profesional permite decidir si conviene usar un resultado. Cambiaría el propósito del aprendizaje: menos perseguir cada herramienta y más formular mejores preguntas y conservar el juicio propio.
El futuro pesimista: máquinas potentes, una sociedad que no llega a tiempo
El escenario pesimista no requiere que las máquinas tengan malas intenciones. Si el trabajo se sustituye más deprisa de lo que las personas encuentran otra ocupación y las ganancias se concentran en los propietarios de capacidad de cálculo, capital, datos y canales de distribución, muchos pueden perder ingresos antes de ver la mejora de productividad en las estadísticas macroeconómicas.
La presión podría llegar primero a puestos con tareas fáciles de digitalizar y resultados fáciles de evaluar. Eso no sentencia a muerte profesiones enteras: cada profesión reúne tareas distintas. Pero una fuerte caída de la demanda de redacción inicial, análisis básico, desarrollo sencillo y atención rutinaria al cliente plantearía un problema especialmente difícil a los jóvenes. Desaparecerían los empleos de entrada que servían para adquirir experiencia, mientras el juicio avanzado seguiría exigiéndola. Si las empresas contratan menos principiantes, la sociedad pierde poco a poco la escalera para formar expertos.
La concentración de poder agravaría esa presión. Si unas pocas organizaciones controlan los mejores modelos, la capacidad de cálculo y los puntos de ejecución, influirán también en quién accede al conocimiento, cómo se evalúa a las personas y qué contenido se ve. Una inteligencia más barata puede multiplicar la vigilancia, el fraude y la persuasión dirigida. Disponer de más información podría dificultar saber qué es verdad en el debate público.
La seguridad añade otra capa. Un sistema capaz, con un objetivo mal fijado, permisos excesivos o comprobaciones ausentes, puede encadenar acciones equivocadas. Puede enviar mensajes incorrectos, filtrar datos, producir software defectuoso o causar daños reales en entornos de alto riesgo. Los escenarios más extremos de pérdida de control incluyen engaño, evasión de supervisión o adquisición de más recursos. Son mecanismos posibles que debemos estudiar y prevenir; la cronología histórica no permite asignarles probabilidades creíbles.
Los países también pueden tratar la IA avanzada como un recurso estratégico en el que no aceptan quedarse atrás. La presión competitiva puede impulsar evaluaciones más breves, ocultación de fallos o conexión a infraestructuras críticas. El peligro surge entonces de muchas organizaciones aceptando demasiado riesgo a la vez, más allá de una respuesta incorrecta aislada. Armamento, ciberataques y sistemas críticos requieren especialmente que las instituciones definan autorización, auditoría, aislamiento y responsabilidad humana.
Las pérdidas personales son más silenciosas. Dejar que una máquina decida constantemente por nosotros podría debilitar la escritura, el razonamiento, la orientación y las habilidades sociales. La comodidad erosionaría la independencia hasta que, al suspenderse un servicio, subir el precio o manipularse las respuestas, descubramos que no tenemos alternativa. En ese futuro, una tecnología más potente no garantiza personas más libres.
El futuro neutral: un cambio enorme, una adaptación larga
La vida cotidiana que me resulta más fácil imaginar mezcla los tres escenarios. Algunas tareas se abaratan deprisa, ciertas profesiones cambian lentamente y unos pocos ámbitos siguen bajo dirección humana por razones de seguridad y responsabilidad. Habrá empresas exitosas y despliegues fallidos; personas que ganen tiempo y otras que pierdan poder de negociación.
Que la AGI alcance primero nuestro umbral en trabajo digital no significa que pueda reparar tuberías, cuidar mayores o construir redes eléctricas de inmediato. El mundo físico incluye cuerpos, materiales, lugares y cadenas de responsabilidad. Fabricar robots, renovar infraestructuras, obtener autorizaciones y cambiar procesos organizativos exige tiempo adicional. El coste del trabajo cognitivo podría variar antes que los precios de vivienda, energía o sanidad, que no necesariamente bajarían al mismo ritmo.
El empleo probablemente cambie primero mediante una reorganización de tareas. Un equipo reduce el personal que redacta borradores y aumenta la revisión y la coordinación; una persona gestiona más proyectos y asume más responsabilidad por los errores. Productividad e intensidad de trabajo podrían incluso crecer juntas. La investigación de la OIT sobre exposición ocupacional a la IA generativa recuerda que afectar a tareas no implica necesariamente sustituir empleos completos. Esa conclusión no puede convertirse sin más en una predicción del empleo tras la AGI, pero conviene mantener la distinción.[30]
Las instituciones intentarán ponerse al día. Las escuelas modificarán la evaluación, las empresas reasignarán permisos, tribunales y reguladores abordarán responsabilidades, y aseguradoras y auditores empezarán a ponerles precio. Muchos lugares podrían pasar por un modelo de actuación permitida por defecto con firma humana en los puntos críticos. Probablemente se parezca más a una serie de arreglos discutidos que a una actualización general de la sociedad.
La adaptación psicológica también irá detrás de las herramientas. Ver que una habilidad dominada pierde de pronto su escasez provoca malestar e inquietud. Las nuevas capacidades entusiasman, aunque perseguirlas sin descanso puede agotar. La eficiencia no resuelve automáticamente el sentido de identidad. El cuidado, la amistad, la experiencia corporal, la belleza y la participación pública seguirán orientando la vida de las personas.
Por eso, aunque apueste por 2031, no apuesto por «desde ese año, todo el mundo estará desempleado» ni por «desde ese año, todo el mundo será próspero». Los avances técnicos pueden concentrarse, mientras las consecuencias sociales se despliegan de manera distinta según región, sector y grupo. El futuro neutral supone cambios grandes, resultados desiguales y ajustes lentos.
Lo que debemos preparar es nuestro juicio y nuestras decisiones
Esta historia entusiasma y también produce algo de vértigo. El ábaco solo calcula cuando los dedos mueven sus cuentas; las máquinas actuales ya pueden recibir una petición imprecisa y empezar a buscar cómo cumplirla. Hemos sacado cada vez más trabajo cognitivo fuera de la mente, mientras seguimos aprendiendo a evaluarlo, asumir sus responsabilidades y repartir sus beneficios.
A las personas les conviene conservar una base profesional, hábitos de verificación, habilidades transferibles y formas de trabajar que no dependan de un único servicio. A las empresas les conviene invertir en procesos revisables, evaluaciones con tareas reales, permisos claros y operaciones recuperables. Para la sociedad, lo más difícil será lograr que la productividad beneficie a más que unos pocos y que la seguridad no se quede en declaraciones.
Podemos equivocarnos con el año de la AGI. Peor sería apostar que unas máquinas suficientemente inteligentes darán automáticamente un buen futuro a la humanidad. Desde el ábaco hasta hoy, las herramientas han ampliado el poder humano. Ahora debemos decidir quién lo tendrá, cómo se usará y qué vida queremos construir con él.