
Este mundo sí que parece, a veces, una organización montada sobre la marcha.
Cuando uno sigue el sector de la IA, tiene la impresión de estar ya a las puertas del futuro. Los modelos escriben código, resuelven problemas difíciles y los agentes prometen hacerse cargo de procesos de trabajo enteros. Cada día se habla más de cuánto trabajo les quedará a los humanos. Pero llega el momento de necesitar que la tecnología haga su trabajo y la respuesta no aparece.
Hasta DeepSeek, considerado por muchos un referente de la IA, puede fallar.
Según el aviso publicado por DeepSeek, una avería en sus sistemas impidió utilizar la API con normalidad el 15 de octubre de 2026, de las 8:11 a las 13:04, hora de Pekín, UTC+8. Los horarios anunciados suman exactamente cuatro horas y 53 minutos, casi cinco horas. Decir que estuvo caído «medio día» expresa el enfado; perder buena parte de una mañana de trabajo fue algo muy real.[1][2]
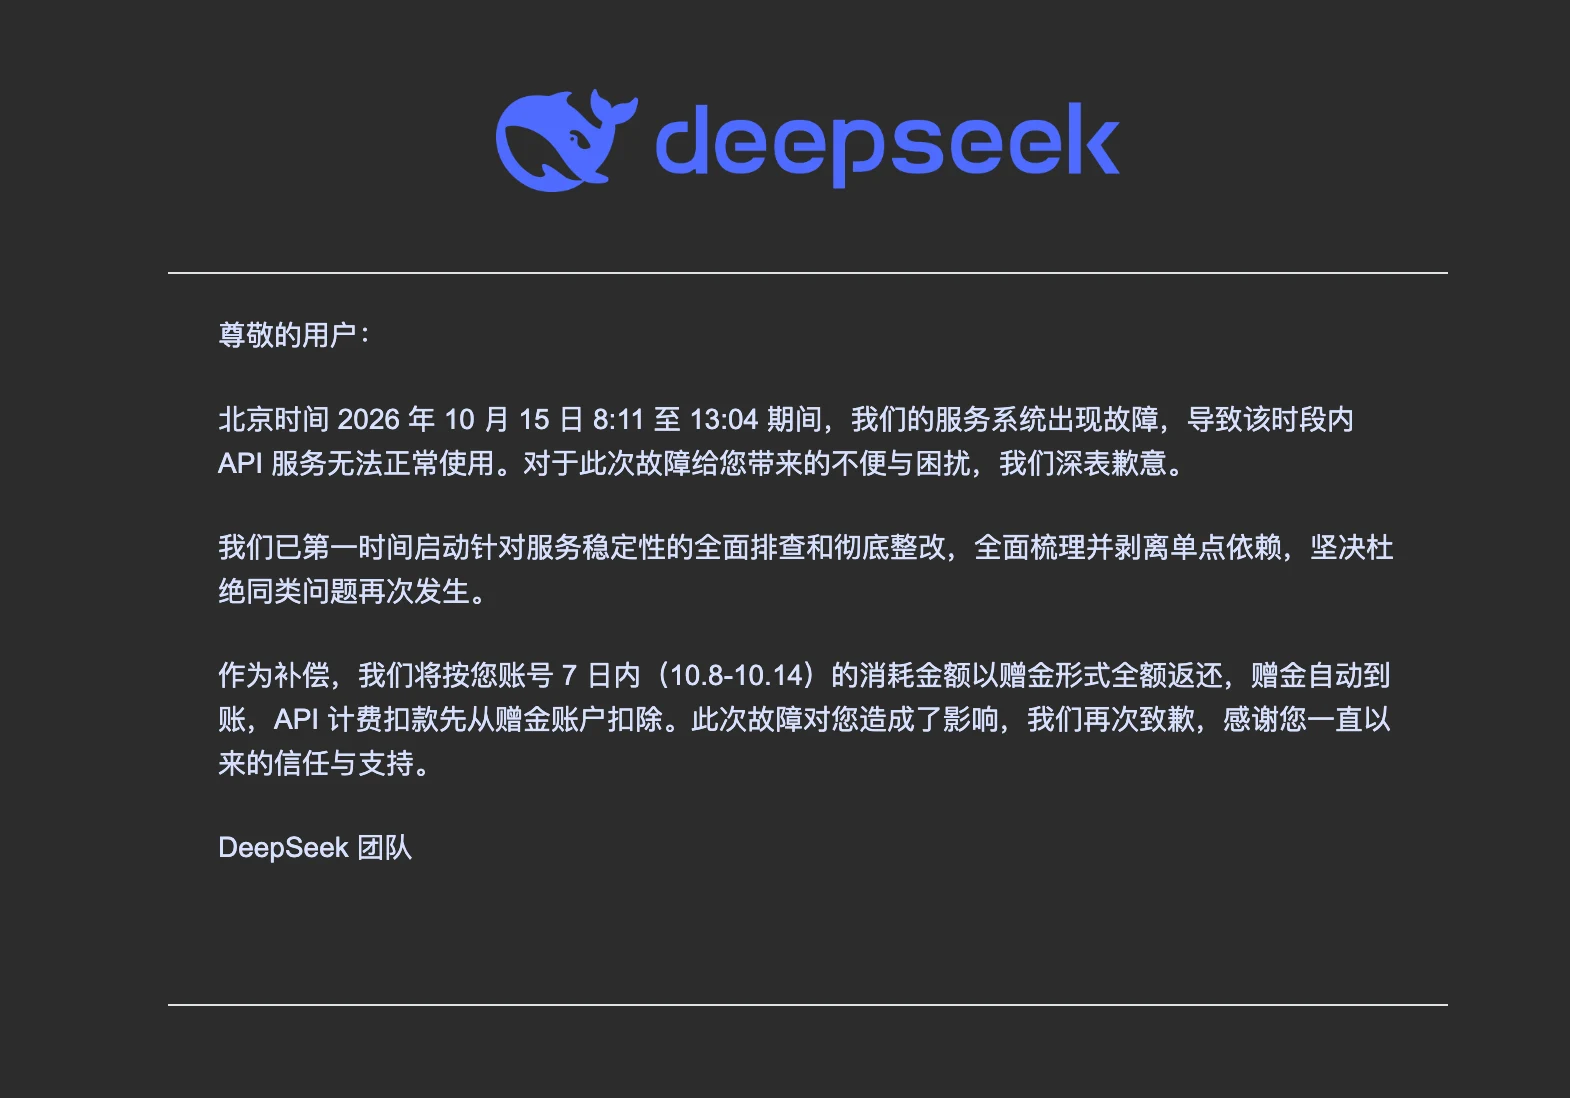
Aviso de DeepSeek sobre la recuperación del servicio y la compensación, facilitado por un lector. Los horarios y las condiciones de compensación coinciden con la información publicada ese mismo día.
Si solo estabas conversando, podías cerrar la ventana y volver más tarde. Pero cuando una API ya forma parte de un producto, de la atención al cliente, del procesamiento de contenidos o de un procedimiento interno, una interrupción en el proveedor puede dejar esperando a toda la cadena. Los usuarios te exigen la entrega a ti y los clientes llaman a tu equipo. Que el modelo suela responder de maravilla no hace que acepten automáticamente varias horas de silencio.
Esta caída deja una lección especialmente clara: la capacidad del modelo y la fiabilidad del servicio tienen que demostrar su valor por separado.
Una cosa es que un modelo responda correctamente a una pregunta. Otra es que pueda entregar esa respuesta cuando el negocio la necesita. La primera luce en las clasificaciones y los actos de presentación. La segunda suele empezar a debatirse en serio después de que algo falla. Quienes dependen de la IA para trabajar necesitan ambas.
De ese contraste nace la sensación de que el mundo funciona con arreglos improvisados. Vemos una inteligencia capaz de hablar del universo y escribir programas. Pero debajo siguen estando las máquinas, el software y las personas que pueden equivocarse o averiarse. Ningún prestigio tecnológico permite saltarse tareas tan concretas como la supervisión, la redundancia y la recuperación ante fallos.
Dicho esto, por muchas críticas que merezca la caída, la compensación de DeepSeek también merece una valoración justa.
El aviso señala que cada cuenta recibirá créditos por el importe íntegro de su consumo real durante los siete días anteriores, del 8 al 14 de octubre. Los créditos se abonarán automáticamente y tendrán prioridad al descontar los cargos posteriores de la API.[1][2]
Por ejemplo, una cuenta que hubiera consumido 100 yuanes en ese periodo recibiría 100 yuanes en créditos, según las condiciones anunciadas. DeepSeek no limitó la compensación a los cargos correspondientes a las horas de interrupción. Tomó como referencia toda una semana de consumo previo. Es un gesto que tiene peso.
Por supuesto, recibir créditos no equivale a obtener un reembolso en efectivo. Tampoco significa disponer de siete días de uso futuro gratuito y sin límite. El importe depende del consumo real de los siete días indicados y sirve para descontar cargos posteriores de la API. Explicar bien estos detalles no resta mérito a la compensación.
Lo que transmite responsabilidad es la disposición a asumir un coste concreto por el fallo. El abono automático también evita que cada usuario tenga que presentar pruebas y repetir solicitudes. Para los desarrolladores que seguirán utilizando el servicio, unos créditos que llegan solos y se descuentan directamente de las próximas facturas tienen un valor práctico.
El valor de la compensación no depende de ponerle a la empresa la etiqueta de que «le sobra el dinero». Lo que merece reconocimiento es convertir las disculpas en un saldo que los usuarios puedan utilizar de verdad.
Pero reconocer el valor de la compensación no convierte la caída en una buena noticia.
La factura de la API solo representa una parte del coste. También hay riesgos de interrupción de la actividad, retrasos en las entregas y pérdida de clientes. Unos créditos quizá no cubran las pérdidas de cada equipo. El dinero se puede compensar; recuperar el tiempo perdido y la confianza dañada puede llevar mucho más. DeepSeek merece reconocimiento por su respuesta y debe seguir respondiendo a las preguntas sobre la estabilidad del servicio.
El aviso también señala que DeepSeek identificará y eliminará los puntos únicos de dependencia.[1] ¿Dónde puede atascarse el servicio de un modelo tan potente? La caída comenzó a las 8:11, hora de Pekín. Ese horario sugiere una posibilidad que merece comprobarse: un cambio desplegado durante la noche cuya debilidad solo salió a la luz ante el tráfico de la mañana.
Primero hay que dejar claro lo que no sabemos: este aviso no revela la causa técnica del incidente. Tanto un despliegue nocturno como un aumento del tráfico matinal necesitan confirmación en los registros y la monitorización. Sigamos solo esta posible secuencia para ver cómo podría desarrollarse.
Supongamos que durante la noche se actualizó un servicio compartido. Su función es comprobar las claves de API y el saldo disponible antes de que las solicitudes lleguen al modelo. La nueva versión funciona y supera sus comprobaciones, pero una verificación que antes podía leer de una caché ahora consulta la base de datos en cada solicitud. Este servicio y este cambio son un ejemplo, no detalles demostrados de la infraestructura de DeepSeek.
Por la noche hay pocas solicitudes y una consulta adicional parece inofensiva. La interfaz sigue respondiendo, las pruebas no detectan errores y el panel de monitorización incluso puede seguir en verde. Sin embargo, el sistema ha perdido silenciosamente parte de su capacidad de procesamiento.
Llega la mañana, la gente empieza a trabajar y aumentan las llamadas de los productos y las tareas en segundo plano. Las solicitudes terminan llegando más deprisa de lo que este servicio compartido puede procesarlas. Empiezan a hacer cola para obtener conexiones a la base de datos. Las solicitudes pendientes retienen más recursos y las que vienen después tienen que esperar todavía más.
Es como un local de desayunos con una sola caja abierta. La cocina funciona y los cocineros están allí, pero todo el mundo tiene que pasar antes por la misma caja. Una vez atascada la entrada, de poco sirve tener una cocina enorme detrás.
Entonces el problema empieza a alimentarse solo. Las aplicaciones que llaman al servicio esperan demasiado, agotan el tiempo de espera y lo intentan de nuevo. Algunos productos también reintentan las peticiones en nombre de sus usuarios. Si las solicitudes anteriores no se han cancelado a tiempo, las tareas nuevas se amontonan sobre las que siguen pendientes. Puede que el volumen real de nuevas operaciones no se haya disparado, pero la carga que soporta el sistema no deja de crecer.
En ese punto, ni siquiera volver a la versión anterior garantiza recuperar el servicio de inmediato. La cola de solicitudes sigue allí, los grupos de conexiones aún no se han recuperado y los reintentos continúan llamando a la puerta. Apenas el servicio logra tomar aire, la carga vuelve a tumbarlo. La recuperación puede exigir limitar el tráfico entrante, cortar los reintentos inútiles, descartar las tareas caducadas y abrir el paso poco a poco. Corregir el código y poner el sistema de nuevo en pie pueden ser dos batallas distintas.
En esta secuencia, un cambio siembra el problema, el tráfico lo destapa y la acumulación y los reintentos lo amplifican. Los costosos clústeres de inferencia podrían seguir funcionando bien, con las solicitudes atascadas en una entrada estrecha situada antes de ellos. El punto único de dependencia no tiene por qué ser un servidor solitario. Puede ser una misma dependencia que todas las réplicas necesitan.
Hay un precedente documentado de este tipo de amplificación. El informe del incidente de Google Cloud de junio de 2025 describe cómo unos datos de políticas de cuotas provocaron fallos de Service Control y cómo, durante la recuperación, los reinicios concentrados sobrecargaron una base de datos subyacente y retrasaron el restablecimiento en algunas regiones.[3] Esto demuestra que resulta técnicamente plausible corregir el desencadenante y que el sistema siga congestionado. No demuestra que a DeepSeek le ocurriera lo mismo.
Para comprobar este escenario habría que superponer varias cronologías: qué cambió antes del incidente, cuándo aumentó el tráfico, cuándo se volvieron anómalas la latencia, las colas y la ocupación de conexiones del servicio compartido, si aumentaron los reintentos y qué sucedió después de volver a la versión anterior o limitar el tráfico. Si esos hechos encajan en orden, la hipótesis gana peso. Las 8:11 dan pie a una pregunta, no bastan para dar el caso por resuelto.
Evitar que el mismo problema vuelva a ocurrir es una promesa. El historial posterior del servicio dirá si se ha cumplido.
El incidente también recuerda algo a quienes incorporan la IA a sus negocios: hay que preparar una salida cuando el servicio falle.
Para los procesos importantes, conviene decidir de antemano si, ante una indisponibilidad temporal del modelo, el trabajo puede quedar en cola, pasar a un proveedor alternativo ya probado o volver a manos de una persona. Si hay que reintentar, se debe limitar el número de intentos, ampliar progresivamente los intervalos y escalonar los momentos de reintento para no echar más leña al fuego. Los procesos que realizan pagos, envían mensajes o modifican datos necesitan además evitar ejecuciones duplicadas cuando se restablezca el servicio.
Estos preparativos tienen poco de futuristas. Pero pueden proteger el negocio de hoy durante la próxima caída. Cuanto más en serio se use la IA, menos se puede confiar todo a la idea de que una empresa tan capaz no tendrá problemas.
DeepSeek merece críticas por una caída de casi cinco horas. Un servicio de IA que genera tantas expectativas también tiene que demostrar su fiabilidad. Y merece reconocimiento por ofrecer créditos equivalentes a los siete días de consumo anteriores. Reconocer el problema, asumir un coste y recuperar la confianza con un servicio estable a lo largo del tiempo es una actitud que conviene alentar.
Puede que el mundo funcione con más improvisación de la que nos gustaría. Tenemos motivos para exigir menos fallos y también para decir, cuando alguien asume su responsabilidad, que esta vez ha respondido con honestidad.