
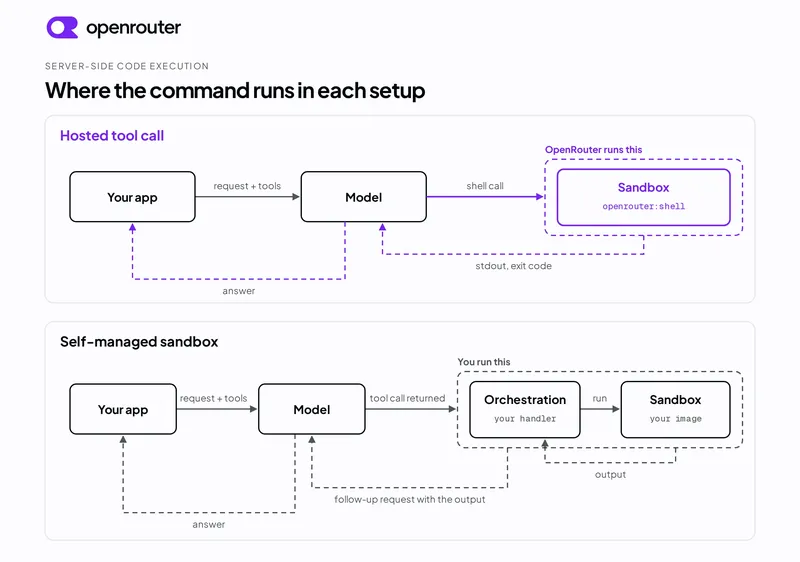
Supposons que vous construisez un agent qui répond à des questions sur un CSV téléversé par un client. Le modèle doit exécuter du Python pour obtenir la réponse. Où ce code s'exécute-t-il ?
Une option consiste à l'exécuter vous-même. Cela signifie une plateforme de bac à sable telle que E2B ou Modal, ou votre propre conteneur sur Docker, plus le travail consistant à le tenir éloigné de votre base de données et d'Internet, à plafonner son runtime et à corriger l'image.
Un outil d'exécution de code côté serveur est l'autre option. Vous ajoutez l'outil à votre requête API, le modèle décide quand il doit exécuter quelque chose, et le fournisseur exécute les commandes dans son propre bac à sable et renvoie la sortie au modèle dans la même requête. Un bac à sable désigne ici un conteneur Linux isolé avec son propre système de fichiers, une limite de temps et aucun accès réseau par défaut.
Cet article couvre quatre fournisseurs qui proposent aujourd'hui une exécution de code côté serveur, ce que chaque bac à sable peut et ne peut pas faire, ce que cela coûte en latence et en argent, et les tâches qui nécessitent encore un bac à sable que vous exploitez vous-même.
En bref
- Un outil d'exécution de code côté serveur exécute les commandes du modèle dans le bac à sable du fournisseur pendant votre requête API. Vous n'avez ni à provisionner, ni à corriger, ni à sécuriser un conteneur.
- OpenAI, Anthropic et Google exécutent chacun le code pour leurs propres modèles. Notre outil openrouter:shell exécute des commandes pour n'importe quel modèle sur les API Responses et Messages, et notre outil openrouter:bash fait de même sur l'API Messages uniquement. Les deux outils sont en version bêta.
- Notre bac à sable est un conteneur isolé limité à votre compte et à votre espace de travail, avec un accès réseau sortant désactivé par défaut et des limites par commande sur le runtime et la taille de la sortie. Le temps de bac à sable est facturé à $0.0001 par seconde avec un minimum de 30 secondes pour un conteneur nouveau ou en veille.
- Un bac à sable que vous exploitez vous-même reste le bon choix pour une image de base personnalisée, des travaux sur GPU ou une session qui s'exécute pendant des heures.
Ce que signifie l'exécution de code côté serveur
Un modèle n'exécute jamais rien lui-même. Lorsqu'il appelle un outil, il émet une requête nommant l'outil et les arguments, et quelque chose doit exécuter cela. Avec un outil côté client, ce quelque chose est votre code d'application ou le framework d'agents sur lequel vous vous appuyez. Votre application reçoit l'appel, l'exécute et renvoie le résultat dans une requête de suivi. Avec un outil côté serveur, le fournisseur exécute l'appel sur sa propre infrastructure et renvoie le résultat au modèle dans la même requête, si bien que votre application n'a aucun gestionnaire pour cela. L'exécution de code côté serveur est du deuxième type.
Vous utilisez peut-être déjà des outils qui fonctionnent de cette manière. La recherche web permet à un modèle de rechercher une information sur le web en direct, et web fetch lui permet de lire le contenu d'une URL. Dans les deux cas, vous ajoutez une entrée à la requête et le fournisseur fait le reste. L'exécution de code applique le même modèle à l'exécution de commandes.
Comment un appel d'outil devient une commande qui s'exécute
Ces étapes s'appliquent à n'importe quel outil d'exécution de code côté serveur. Lorsqu'un nom de champ apparaît, c'est celui que notre outil shell utilise.
- Vous incluez l'outil dans le tableau
toolsde la requête. - Le modèle décide qu'il doit exécuter quelque chose et émet un appel transportant une ou plusieurs commandes shell.
- Le fournisseur exécute ces commandes dans l'ordre à l'intérieur d'un conteneur isolé (sandbox).
- La sortie standard, l'erreur standard et le résultat de chaque commande sont renvoyés au modèle. Le résultat est soit un code de sortie, soit un dépassement de délai.
- Le modèle lit les résultats et vous répond soit, soit exécute d'autres commandes dans la même requête.
Les étapes deux à cinq se répètent jusqu'à ce que le modèle réponde. Le modèle exécute quelque chose, lit la sortie, décide s'il a besoin d'une autre commande, et recommence. C'est dans cette boucle qu'un outil d'exécution de code justifie sa place, car le modèle peut vérifier son travail par rapport à une sortie réelle au lieu de deviner.
Nous limitons cette boucle. Le champ max_tool_calls définit le nombre d'étapes d'outils serveur qu'une requête peut comporter. Notre référence des outils serveur fixe la valeur par défaut et le maximum à 30.
En quoi un sandbox hébergé diffère d'un sandbox que vous exécutez vous-même
Exécuter votre propre sandbox signifie posséder les composants que le fournisseur posséderait sinon. Vous choisissez une image de base, provisionnez la puissance de calcul, intégrez un SDK pour démarrer les exécutions et lire les sorties, et gérez le cycle de vie de chaque exécution. Vous êtes également responsable de la frontière de sécurité.
Un outil hébergé échange ce contrôle contre une simple entrée dans un tableau JSON. Vous ne dimensionnez pas le conteneur, vous ne le mettez pas à jour et vous ne l'exploitez pas. Nous avons conçu openrouter:shell pour le cas où le travail se résume à une poignée de commandes courtes par requête.
Qui propose aujourd'hui une exécution de code hébergée
Cet article couvre OpenAI, Anthropic, Google et OpenRouter. Les SDK d'agents et les plateformes de sandbox dédiées constituent des catégories distinctes, et toutes deux sont abordées plus loin dans l'article. Ce qui distingue les quatre fournisseurs, ce sont les modèles pour lesquels chacun exécute du code.
OpenAI exploite un shell hébergé pour les modèles d'OpenAI
D’OpenAI outil shell exécute des commandes dans un conteneur géré par OpenAI, via l'API Responses. OpenAI documente l'environnement d'exécution hébergé comme Debian 12 avec un répertoire de travail par défaut de /mnt/data. Les commandes sont exécutées sans sudo, et les sessions TTY interactives ne sont pas prises en charge. Les langages préinstallés listés dans la documentation incluent Python 3.11, Node.js 22.16, Java 17, PHP 8.2, Ruby 3.1 et Go 1.23.
Les conteneurs hébergés n'ont pas d'accès réseau sortant par défaut. Pour l'activer, un administrateur d'organisation configure une liste d'autorisation dans le tableau de bord OpenAI et vous définissez network_policy sur l'environnement conteneur dans la requête. Un conteneur peut être réutilisé entre plusieurs requêtes en passant son id dans une container_reference environnement, et son expiration est définie lors de la création du conteneur. OpenAI dispose également d'un outil d'interpréteur de code pour Python.
Anthropic exécute Python et Bash pour les modèles Claude
d'Anthropic outil d'exécution de code exécute Python et Bash dans un bac à sable géré par Anthropic, via l'API Messages. L'environnement documenté est un conteneur Linux x86_64 avec Python 3.11, 5 Gio de RAM, 5 Gio de stockage d'espace de travail et un CPU. L'accès à Internet est désactivé et aucune connexion sortante n'est autorisée, si bien que Claude travaille avec les bibliothèques préinstallées et ne peut pas installer de paquet pendant une exécution.
Trois versions des outils existent, et chaque modèle pris en charge accepte les trois. code_execution_20250825 prend en charge les commandes Bash et les opérations sur les fichiers. code_execution_20260120 ajoute un état d'interpréteur Python qui persiste entre les requêtes, ce qui dépend du tool calling programmatique d'Anthropic et n'est pas disponible sur Claude Haiku 4.5. Les conteneurs expirent 30 jours après leur création. Après environ 5 minutes d'inactivité, un conteneur est sauvegardé par checkpoint, et une requête avec son identifiant dans la fenêtre de 30 jours le restaure.
Google exécute Python pour les modèles Gemini
Google outil d'exécution de code exécute Python dans un bac à sable géré par Google, activé avec un code_execution entrée dans les outils de la requête. La documentation indique que le modèle ne peut générer et exécuter que du Python, que l'environnement de code a une durée d'exécution maximale de 30 secondes et que vous ne pouvez pas installer vos propres bibliothèques. Google publie la liste des bibliothèques incluses dans l'environnement.
Nous exécutons un shell hébergé pour n'importe quel modèle
Les trois outils ci-dessus fonctionnent chacun avec les modèles d'une seule entreprise. Le nôtre fonctionne avec n'importe quel modèle des API Responses et Messages, car nous exécutons le sandbox au niveau de la couche de routage plutôt qu'à l'intérieur d'un seul fournisseur de modèle.
Nous expédions deux outils d'exécution de code. openrouter:shell imitte la forme de l'outil shell hébergé d'OpenAI et fonctionne à la fois sur l' API Responses et l'API Messages. openrouter:bash reprend la forme de l'outil bash d'Anthropic et fonctionne uniquement sur l'API Messages.
Les deux outils sont en version bêta, l'API peut donc changer. L'exécution en bac à sable ne fonctionne que sur le point de terminaison global openrouter.ai . Les points de terminaison en région ne proposent pas l'outil shell, et Chat Completions rejette les deux outils avec une 400 qui nomme les API qui les prennent en charge.
Définissez engine sur openrouter pour l'un ou l'autre outil et les commandes s'exécutent dans notre bac à sable. La valeur par défaut engine est auto. Pour openrouter:shell, auto conserve le shell hébergé natif d'un fournisseur lorsqu'il en existe un et route vers notre bac à sable sinon. Pour openrouter:bash, auto renvoie l'appel d'outil à votre application pour qu'elle l'exécute côté client, et rien ne s'exécute sur nos serveurs.
Exécuter une commande dans notre bac à sable
Voici une requête complète qui exécute deux commandes et relit les résultats.
import os
import requests

response = requests.post(
    "https://openrouter.ai/api/v1/responses",
    headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},
    json={
        "model": "anthropic/claude-sonnet-4.5",
        "input": "Run `cat /etc/os-release` and `python3 --version`, then tell me the OS and Python version in one sentence.",
        "tools": [
            {"type": "openrouter:shell", "parameters": {"engine": "openrouter"}}
        ],
    },
)

for item in response.json()["output"]:
    if item["type"] == "openrouter:shell":
        print(item["container_id"], item["action"]["commands"])
        for result in item["output"]:
            print(result["stdout"], result["outcome"])
Nous avons exécuté cette requête le 22 septembre 2026. Le modèle a envoyé les deux commandes en un seul appel shell, et chaque commande est revenue avec son propre résultat. La sortie complète de os-release s'étend sur plusieurs lignes et est réduite ici à ses deux premières.
{
  "type": "openrouter:shell",
  "container_id": "sess_art10-418b8597e044",
  "action": { "commands": ["cat /etc/os-release", "python3 --version"] },
  "output": [
    {
      "stdout": "PRETTY_NAME=\"Ubuntu 22.04.5 LTS\"\nNAME=\"Ubuntu\"\n",
      "stderr": "",
      "outcome": { "type": "exit", "exit_code": 0 }
    },
    {
      "stdout": "Python 3.11.14",
      "stderr": "",
      "outcome": { "type": "exit", "exit_code": 0 }
    }
  ]
}
Le bac à sable a signalé Ubuntu 22.04.5 LTS avec Python 3.11.14 à cette date. L'image du runtime peut changer, lisez donc la version depuis le conteneur plutôt que de la coder en dur. La référence des outils serveur couvre les paramètres restants.
Des SDK d'agents qui encapsulent un bac à sable pour vous
Si vous vous appuyez sur un SDK d'agent plutôt que d'appeler directement une API, certains SDK encapsulent l'un de ces outils.
Le OpenAI Agents SDK est livré CodeInterpreterTool, qui exécute le code dans le bac à sable d'OpenAI, et ShellTool, qui s'exécute soit dans votre environnement d'exécution local, soit dans un conteneur hébergé par OpenAI selon la façon dont vous configurez son environnement. Vérifiez quel mode vous avez configuré avant de supposer qu'une commande a été exécutée à distance. De notre côté, openrouter:shell est une entrée dans le tools tableau comme n'importe quelle autre, donc il entre dans une boucle OpenRouter Agent SDK de la même manière qu'il entre dans une requête brute.
Ce qui nécessite encore un bac à sable qui vous est propre
Un outil hébergé convient aux travaux courts et délimités, comme exécuter un script, transformer un fichier ou vérifier un résultat. Tout ce qui nécessite une image de base spécifique ou un GPU échappe aux quatre outils hébergés et requiert une plateforme de bac à sable que vous exploitez.
Comparaison
Chaque cellule d'outil hébergé provient de la documentation du fournisseur elle-même, liée ci-dessus, à l'exception de la cellule d'environnement d'exécution d'OpenRouter, qui correspond à ce que le bac à sable a rapporté lorsque nous avons exécuté la requête ci-dessus. La colonne autogérée décrit un bac à sable que vous exploitez vous-même plutôt qu'une plateforme en particulier.
| OpenRouter | OpenAI | Anthropic | Autogéré | ||
|---|---|---|---|---|---|
| Qui l'exploite | Nous | OpenAI | Anthropic | Vous | |
| Modèles | N'importe quel modèle sur les API Responses et Messages | Modèles OpenAI | Modèles Claude | Modèles Gemini | N'importe quel modèle |
| API | Responses et Messages. openrouter:bash est disponible uniquement sur Messages | Responses | Messages | API Gemini | Tout |
| Langues | N'importe quelle commande shell. Ubuntu 22.04.5 avec Python 3.11.14 signalé le 22 septembre 2026 | Commandes shell sur Debian 12. Python, Node.js, Java, PHP, Ruby et Go préinstallés | Python et Bash | Python uniquement | Tout ce que vous construisez |
| Système de fichiers | Système de fichiers de conteneur propre, délimité à votre compte et à votre espace de travail. Les fichiers du répertoire home sont sauvegardés après chaque commande | Système de fichiers de conteneur propre avec un répertoire de travail par défaut de /mnt/data. Les données sont supprimées à l'expiration du conteneur | Conteneur isolé avec 5 GiB de stockage d'espace de travail. Les conteneurs expirent 30 jours après leur création | Non documenté | Ce que votre image et vos montages définissent |
| Réseau sortant | Désactivé par défaut. Liste d'autorisation jusqu'à 50 noms d'hôte sur les ports 80 et 443 | Désactivé par défaut. Liste d'autorisation au niveau de l'organisation plus une par requête network_policy | Désactivé | Non documenté | À configurer par vos soins |
| Installer des paquets à l'exécution | Oui, avec les hôtes de paquets dans la liste d'autorisation | Oui, avec les hôtes de paquets dans la liste d'autorisation | Non | Non | Oui |
| Persistance de session | Conteneur indexé par identifiant de conteneur. Se met en veille après 5 minutes d'inactivité. Les fichiers sauvegardés sont conservés pendant 30 jours après la dernière utilisation | Conteneur réutilisé par identifiant via container_reference. Expiration définie sur le conteneur | Conteneur restauré par identifiant dans les 30 jours suivant la création. L'état de l'interpréteur persiste sur code_execution_20260120 et versions ultérieures avec l'appel programmatique d'outils | Durée d'exécution maximale de 30 secondes par exécution. Persistance de l'état entre les requêtes non documentée | Jusqu'au plafond de chaque plateforme |
| Modèle de coût | Jetons d'inférence plus temps de sandbox à 0,0001 $ par seconde, avec un minimum de 30 secondes pour un conteneur nouveau ou en veille | Non indiqué dans la documentation de l'outil shell | 1,550 heures gratuites par organisation et par mois, puis 0.05 $ par heure et par conteneur, avec un minimum de 5 minutes par exécution | Aucun frais supplémentaire. Le code généré et la sortie sont facturés en tokens | Temps de calcul pendant l'exécution du sandbox |
Ce que notre sandbox applique
L'intérêt d'un sandbox, c'est que vous n'avez pas à faire confiance au modèle. Une commande que vous n'aviez jamais prévue ne peut pas atteindre le réseau ou le conteneur de quelqu'un d'autre, et elle s'arrête à une limite stricte de durée d'exécution et de volume d'affichage. Tout ce qui figure dans cette section décrit notre sandbox. Le tableau ci-dessus montre où les trois autres diffèrent.
Les limites qui s'appliquent à chaque commande
Nous exécutons chaque commande dans un conteneur isolé, séparé de l'infrastructure qui sert votre requête et de votre machine, et délimité par votre compte et votre espace de travail. Vous définissez vos propres plafonds avec timeout_ms pour la durée maximale d'exécution d'une commande et max_output_length pour le volume maximal qu'elle peut afficher. timeout_ms a pour valeur par défaut 120,000 ms et ne peut pas dépasser 300,000 ms. max_output_length a pour valeur par défaut 16,384 caractères par flux et ne peut pas dépasser 65,536. Un appel shell comportant plus de 100 commandes est rejeté.
L'accès réseau sortant est désactivé sauf si vous l'activez. Nous l'avons vérifié le 22 septembre 2026 en envoyant une requête sans network_policy et en demandant au modèle de récupérer https://example.com avec curl, en affichant uniquement le code de statut HTTP et en abandonnant après 5 secondes. La commande a affiché 000, qui est ce que curl affiche quand aucune réponse n'arrive, et s'est terminée avec le code 28, un curl timeout.
{ "stdout": "000", "stderr": "curl: (28) Failed to connect to example.com port 443 after 5206 ms: Connection timed out", "outcome": { "type": "exit", "exit_code": 28 } }Pour ouvrir le réseau, définissez une network_policy allowlist comprenant jusqu'à 50 noms d'hôtes ou motifs glob. Seuls les ports 80 et 443 sont accessibles, et la politique est figée au démarrage du conteneur. pip install nécessite à la fois pypi.org et files.pythonhosted.org dans l'allowlist.
L'injection de prompts et ce que le sandbox limite
Donner un shell à un modèle vous expose à l' injection de prompts. Si votre agent lit une page web, un ticket d'assistance ou un fichier téléversé par quelqu'un, un attaquant peut dissimuler dans ce texte des instructions ordonnant au modèle d'ignorer votre prompt et d'exécuter autre chose.
Les limites ci-dessus s'appliquent que le modèle suive votre prompt ou celui d'un attaquant. Une commande exécutée sous une instruction injectée ne peut atteindre aucun hôte en dehors de l' network_policy que vous avez configuré, et n'a aucun accès réseau lorsque vous laissez la politique désactivée. Elle ne peut atteindre le conteneur d'un autre locataire, et elle s'arrête au même timeout. Une allowlist élargit ce qu'une commande injectée peut atteindre, et allowed_domains: ["*"] autorise un trafic sortant sans restriction ; gardez donc l'allowlist limitée aux hôtes dont la tâche a besoin.
Vous pouvez aussi détecter une tentative qui arrive dans la requête elle-même. Détection de l'injection de prompts dans une règle de garde d'espace de travail vérifie le contenu du message fourni par l'utilisateur de chaque requête entrante par rapport à des motifs regex des techniques d'injection courantes, avant de transmettre la requête au modèle. Il n'inspecte pas ce qu'un outil serveur récupère après ce point, donc une page, un fichier ou une sortie de commande que le modèle lit via un outil nécessite un contrôle de votre part, comme la révision de la sortie du bac à sable que votre application reçoit. Une correspondance fait l'une de trois choses, selon l'action que vous configurez.
- Flag enregistre la détection et transmet la requête inchangée.
- Redact remplace la portion correspondante par
[PROMPT_INJECTION]et transmet la requête assainie. - Block rejette la requête avec un 403 avant qu'elle n'atteigne le modèle.
Lorsque plusieurs garde-fous s'appliquent, l'action la plus stricte l'emporte, dans l'ordre block, redact, flag. La détection n'est pas exhaustive et peut produire des faux positifs, donc mesurez le taux de correspondance sur votre propre trafic en mode flag avant d'appliquer redact ou block. Vous pouvez signaler un faux positif depuis la page Logs.
Ce qu'un bac à sable hébergé vous coûte en secondes et en dollars
Un bac à sable hébergé ajoute des secondes à une requête et vous laisse sans infrastructure à gérer. Il vous donne aussi un conteneur auquel vous pouvez revenir.
Les fichiers survivent entre les requêtes
Les commandes s'exécutent dans /workspace/home, et nous sauvegardons les fichiers modifiés sous ce répertoire après chaque commande. Envoyez un session_idstable, ou définissez un identifiant de conteneur dans la environment configuration de l'outil, et chaque requête avec cet identifiant atteint le même conteneur et les mêmes fichiers. Un session_id ne doit utiliser que des lettres, des chiffres, _et -. Un identifiant contenant tout autre caractère est ignoré, et nous choisissons le conteneur comme si vous n'aviez envoyé aucun session_id, ce qui signifie le plus récent container_id dans la conversation rejouée s'il en existe un, et sinon un nouveau conteneur pour cette requête. Lorsqu'un session_id dépasse 20 caractères, nous n'utilisons que les 20 derniers, donc deux longs identifiants qui se terminent de la même manière partagent un conteneur. Un identifiant container_reference peut comporter de 1 à 40 caractères du même ensemble et n'est pas tronqué, donc utilisez-le lorsque vous avez besoin que l'identifiant soit exact. Nous l'avons confirmé le 22 septembre 2026 en écrivant un fichier dans une requête et en le relisant dans une seconde requête qui partageait le même session_id.
Un conteneur se met en veille après 5 minutes d'inactivité, et ce délai d'inactivité n'est pas configurable. La mise en veille ne supprime pas les fichiers. Quand une requête avec le même id arrive plus tard, un nouveau bac à sable démarre et charge d'abord les fichiers sauvegardés. Les processus ouverts, les variables d'environnement et l'état système installé ne sont pas restaurés, donc traitez un conteneur réveillé comme une machine neuve contenant vos fichiers. Les fichiers sauvegardés sont conservés pendant 30 jours après la dernière utilisation du conteneur. Pour extraire un artefact, GET /api/v1/containers/{container_id}/files liste ce qu'un conteneur a produit, et le point de terminaison promote copie un fichier dans les documents de votre espace de travail, où il n'expire pas.
Ce que vous pouvez examiner ensuite
Chaque résultat d'outil shell dans la réponse contient les commandes exécutées par le modèle ainsi que le stdout, le stderr et le résultat de chaque commande, afin que votre application puisse les consigner de la même manière qu'elle consigne le reste de la réponse. Input & Output Logging stocke vos prompts et vos complétions sur OpenRouter pour consultation sur la page Logs, et les détections de garde-fous y apparaissent également. Pour la surveillance en production, Broadcast envoie les traces vers une plateforme d'observabilité externe au fur et à mesure de l'achèvement des requêtes.
Si vous routez in-region, l'outil shell n'est pas disponible et Input & Output Logging est ignoré, même lorsqu'il est activé. Broadcast prend en charge le routage in-region, et chaque destination est configurée avec les régions de données dont elle reçoit les traces.
Ce que le aller-retour vous coûte
Une requête qui exécute une commande en bac à sable prend plus de temps que la même requête sans commande. Dans un ensemble de requêtes individuelles que nous avons envoyées le 22 septembre 2026, une requête sans outil shell a répondu en environ 2 secondes, et les requêtes ayant effectué un appel shell ont répondu en 8 à 21 secondes selon le modèle. Ce sont des échantillons uniques d'une seule session, pas un banc d'essai. Prévoyez plusieurs secondes de surcharge par appel shell.
Le temps de bac à sable est facturé 0.0001 $ par seconde. Le chronomètre démarre lorsqu'une requête exécute pour la première fois une commande en bac à sable et s'arrête à l'achèvement de la réponse. Une requête qui démarre un conteneur neuf ou en veille est facturée un minimum de 30 secondes, et les requêtes ultérieures qui réutilisent le même conteneur actif ne paient que leur temps mesuré. La requête ci-dessus a démarré un nouveau conteneur, et son objet d'utilisation a rapporté un server_tool_cost de 0.003, ce qui correspond au minimum de 30 secondes. Un conteneur inactif entre les requêtes n'est pas facturé.
Changer de modèle sans toucher à votre code d'outils
Remplacez le modèle et votre définition d'outil reste la même.
Nous avons envoyé un même corps de requête six fois le 22 septembre 2026, en ne changeant que le champ model , et avons demandé à chaque modèle d'exécuter python3 -c "print(sum(range(1, 101)))" dans le bac à sable. Chaque modèle a effectué un appel shell et renvoyé 5050.
| Modèle | Résultat |
|---|---|
| openai/gpt-5.4-mini | 5050 |
| google/gemini-3.5-flash | 5050 |
| anthropic/claude-haiku-4.5 | 5050 |
| deepseek/deepseek-v3.2 | 5050 |
| moonshotai/kimi-k2.6 | 5050 |
| qwen/qwen3-coder | 5050 |
Les six ont exécuté dans le même bac à sable avec la même définition d'outil, quels que soient les outils natifs proposés par leur propre fournisseur, car le bac à sable nous appartient et non au fournisseur du modèle. Testez le modèle que vous prévoyez d'utiliser avant de construire dessus, car la fiabilité de l'appel d'outils diffère selon les modèles. Notre guide d'appel d'outils explique comment les outils serveur et vos propres outils de fonction partagent un même tools tableau.
Lorsque vous souhaitez une plateforme de sandbox à vous
Choisissez une plateforme de sandbox dédiée lorsque vous avez besoin de quelque chose qu'un outil hébergé ne vous apporte pas. Modal documente des sandboxes construites à partir d'images personnalisées avec une durée de vie configurable allant jusqu'à 24 heures et des ressources GPU. Daytona documente des sandboxes créées à partir d'une image de conteneur publique, y compris des sandboxes GPU. E2B documente des sandboxes qui s'exécutent jusqu'à 24 heures sur son offre Pro et 1 heure sur son offre de base, avec mise en pause et reprise pour les charges de travail plus longues.
Conclusion
Pour des commandes courtes et bornées à l'intérieur d'une requête de modèle, utilisez un outil hébergé. Vous ajoutez une entrée au tools tableau et obtenez un conteneur isolé avec l'accès réseau sortant désactivé, et vous payez l'inférence plus les secondes d'exécution de la sandbox. Prévoyez plusieurs secondes de surcharge par appel shell et réutilisez un conteneur quand c'est possible.
Passez à une plateforme de sandbox que vous exploitez lorsque un travail nécessite une image de base personnalisée, un GPU, une session qui s'exécute pendant des heures, ou la propriété de la frontière de sécurité elle-même. Dans tous les cas, consultez la documentation actuelle du fournisseur avant de vous engager, car nos deux outils sont en version bêta et les outils des trois autres fournisseurs évoluent eux aussi.
Questions fréquemment posées
Existe-t-il un outil shell sandboxé hébergé que les modèles peuvent appeler directement pendant une requête ?
Oui. Notre outil serveur openrouter:shell donne à un modèle un shell Linux sandboxé qui s'exécute sur notre infrastructure pendant la requête, à la fois sur l'API Responses et sur l'API Messages. Définissez engine sur openrouter et les commandes s'exécutent dans un conteneur isolé, avec pour chaque commande le stdout, le stderr et le résultat de sortie ou de timeout renvoyés au modèle. OpenAI, Anthropic et Google proposent chacun un outil d'exécution de code hébergé pour leurs propres modèles.
Puis-je donner à un modèle un shell sandboxé dans lequel il peut exécuter des commandes ?
Oui. Ajoutez {"type": "openrouter:shell", "parameters": {"engine": "openrouter"}} au tableau tools d'une requête de l'API Responses ou Messages. Le modèle peut alors émettre des appels shell, et nous exécutons les commandes dans un conteneur isolé et renvoyons la sortie de chaque commande au modèle. Le conteneur n'a aucun accès réseau sortant, sauf si vous configurez une network_policy allowlist.
Quels SDK ou plateformes offrent l'exécution de code côté serveur prête à l'emploi ?
Notre outil serveur openrouter:shell exécute des commandes pour n'importe quel modèle sur les API Responses et Messages, et notre outil serveur openrouter:bash fait de même sur l'API Messages uniquement. OpenAI, Anthropic et Google exécutent chacun du code pour leurs propres modèles via l'outil shell de l'API Responses, l'outil d'exécution de code et l'outil d'exécution de code de l'API Gemini. L'OpenAI Agents SDK encapsule les outils hébergés d'OpenAI sous forme de CodeInterpreterTool et ShellTool. E2B, Modal et Daytona sont des plateformes de sandbox que vous intégrez et exploitez vous-même, plutôt que des outils qu'un fournisseur exécute au sein de l'appel API.
Quel sandbox est le meilleur pour les agents IA ?
Cela dépend de la durée d'exécution du travail et du niveau de contrôle dont vous avez besoin sur l'environnement d'exécution. Pour des commandes courtes à l'intérieur d'une requête, un outil hébergé tel qu'openrouter:shell signifie que vous n'exploitez aucune infrastructure. Pour une image de base personnalisée, un accès GPU ou une session qui s'exécute pendant des heures, une plateforme de sandbox que vous exploitez, telle que Modal ou Daytona, vous donne ces contrôles.
Comment isoler (sandboxer) un agent IA ?
Vous exécutez les commandes de l'agent dans un environnement isolé de vos propres systèmes et vous limitez ce que cet environnement peut atteindre. Avec un outil hébergé, le fournisseur s'en charge. Sur OpenRouter, les conteneurs sont isolés de notre infrastructure et de votre machine, sont limités à votre compte et à votre espace de travail, l'accès réseau sortant est désactivé par défaut, chaque commande est bornée par timeout_ms, et la sortie est plafonnée par max_output_length. Les garde-fous de l'espace de travail ajoutent la détection d'injection de prompt devant le modèle.
Qu'est-ce qu'un outil IA sandboxé ?
C'est un outil dont les effets secondaires sont confinés dans un environnement isolé plutôt que dans vos systèmes de production. Pour l'exécution de code, les commandes du modèle s'exécutent dans un conteneur avec son propre système de fichiers, un accès réseau restreint et une limite de temps, et seule la sortie de la commande est renvoyée au modèle. Nos outils serveur shell et bash fonctionnent ainsi.