
Un défi majeur qui émerge à mesure que les systèmes multi-agents passent de l'expérimentation à la production consiste à s'assurer que ces systèmes sont constamment utiles, précis et explicables dans des scénarios du monde réel. Les entreprises adoptent de plus en plus les systèmes multi-agents pour résoudre des problèmes complexes du monde réel qui nécessitent un raisonnement à travers des sources de données, des outils et des contraintes métier. De la planification de la chaîne d'approvisionnement à l'analyse financière en passant par les opérations clients, ces systèmes vont au-delà de la simple réponse aux questions. Ils coordonnent plusieurs agents spécialisés pour prendre des décisions, exécuter des flux de travail et générer des recommandations exploitables.
Bien que les grands modèles de langage puissent générer des réponses fluides, les applications d'entreprise exigent des garanties beaucoup plus profondes, où les agents doivent suivre les instructions de manière fiable, sélectionner les bons outils, respecter les contraintes et fournir un raisonnement clair derrière leurs résultats.
Amazon Bedrock AgentCore est une plateforme pour construire, connecter et optimiser des agents à grande échelle, avec n'importe quel framework ou modèle. Amazon Bedrock AgentCore Evaluations, une capacité d'Amazon Bedrock AgentCore, est conçue pour relever ce défi en tant que capacité entièrement gérée pour évaluer les performances des agents tout au long du développement et de la production, permettant ainsi aux équipes de mesurer la précision, le succès des tâches et le comportement selon plusieurs dimensions de qualité. Les approches d'évaluation traditionnelles qui se concentrent uniquement sur la qualité des réponses du modèle sont insuffisantes pour les systèmes agentiques, où l'exactitude dépend de la sélection des outils, de l'exécution des flux de travail et du respect des contraintes métier. En plus de l'évaluation, le déploiement en production de systèmes agentiques nécessite des contrôles d'IA responsable. Amazon Bedrock Guardrails fournit des protections configurables telles que le filtrage de contenu, la détection de sujets refusés et la validation d'ancrage qui complètent le cadre d'évaluation. Tandis que les évaluations évaluent la qualité des agents après l'exécution, Guardrails applique les contraintes de sécurité pendant l'exécution. Dans cet article, nous nous concentrons sur l'opérationnalisation de ce cadre d'évaluation avec le support d'Amazon Bedrock AgentCore Evaluations pour les évaluateurs intégrés et les évaluateurs personnalisés. Les évaluateurs intégrés offrent des évaluations prédéfinies pour les dimensions de qualité courantes telles que l'utilité, le succès des tâches et le suivi des instructions, permettant ainsi aux équipes d'établir rapidement une référence de performance des agents sans configuration supplémentaire. Cependant, les cas d'usage d'entreprise nécessitent une validation plus approfondie et spécifique au domaine. Les évaluateurs personnalisés répondent à ce besoin, vous permettant de définir des contrôles adaptés au métier.
Nous nous concentrons également spécifiquement sur l'explicabilité en tant que dimension d'évaluation de premier plan. Nous montrons comment les évaluateurs intégrés peuvent évaluer la clarté générale des réponses. Nous présentons comment les évaluateurs personnalisés sont utilisés pour vérifier que les agents articulent explicitement la justification de leurs décisions, référencent les données ou les sorties d'outils à l'appui, et expliquent les arbitrages tels que le coût par rapport au niveau de service. En combinant ces évaluateurs, nous montrons comment AgentCore Evaluations peut aller au-delà de la qualité superficielle des réponses et fournir des insights structurés et mesurables sur la manière et les raisons pour lesquelles les agents parviennent à leurs décisions.
Pour concrétiser ces concepts, les sections suivantes parcourent une architecture de référence et une implémentation qui démontrent comment ces composants fonctionnent ensemble en pratique.
Vue d'ensemble de la solution
Pour cet article, nous utilisons une société mondiale fictive de distribution appelée AnyCompany Retail, un détaillant multinational exploitant des canaux de commerce électronique, des centres de traitement régionaux, des centres de distribution et des milliers de magasins physiques. AnyCompany connaît de fréquents déséquilibres de stocks : certaines régions font face à des ruptures de stock pendant les promotions, tandis que d'autres détiennent des stocks excédentaires. Les équipes de transport doivent également équilibrer la rapidité de livraison, la capacité des transporteurs et les coûts. L'entreprise souhaite un assistant agentique capable d'aider les planificateurs à optimiser l'allocation des stocks, à recommander des ajustements de distribution, à analyser la santé des stocks et à simuler des scénarios de routage ou de traitement des commandes.
Vous allez construire et évaluer un système décisionnel de chaîne d'approvisionnement multi-agents en utilisant Strands Agents SDK, Amazon Bedrock AgentCore MCP Server et Amazon Bedrock AgentCore Evaluations. La solution utilise Strands Agents avec un agent orchestrateur et quatre sous-agents spécialisés : un agent d'optimisation, un agent de distribution, un agent de routage et un agent d'analytique. Chaque agent s'exécute sur Amazon Bedrock AgentCore runtime avec Amazon Bedrock AgentCore memory et Amazon Bedrock AgentCore Observability activés.
L’agent orchestrateur reçoit la requête du planificateur et délègue le travail à des agents spécialisés exposés sous forme d’outils. L’agent d’optimisation appelle des outils MCP adossés à des interfaces REST simulées via Amazon API Gateway qui renvoient des décisions d’optimisation. L’agent de distribution appelle des API de recommandation pour suggérer un rééquilibrage des stocks entre les centres de distribution, les magasins et les canaux numériques. L’agent de routage appelle des API logistiques pour recommander des options de transporteur et d’itinéraire, et l’agent d’analytique répond aux questions de diagnostic de la chaîne d’approvisionnement. Cette solution utilise des modèles de fondation sur Amazon Bedrock pour la boucle d’agents. Pour connaître la disponibilité des modèles par Région, reportez-vous à Modèles pris en charge par Région AWS dans Amazon Bedrock.
La solution utilise des évaluateurs intégrés qui évaluent des dimensions de qualité générales telles que l’utilité et l’accomplissement des tâches. Elle fournit également des évaluateurs personnalisés qui évaluent des comportements propres à la chaîne d’approvisionnement, tels que la satisfaction des contraintes, la faisabilité des itinéraires, l’exactitude du SQL, l’ancrage dans les données d’inventaire et la qualité des explications. AnyCompany peut évaluer à la fois la qualité linguistique de la réponse et la validité commerciale de la décision de l’agent.
La solution prend en charge à la fois le mode à la demande et le mode en ligne avec Amazon Bedrock AgentCore Evaluations. Le mode à la demande est destiné au benchmarking en développement, aux tests de régression et aux portes d’intégration continue et de livraison continue (CI/CD). Le mode en ligne sert à la surveillance et aux alertes continues en production. Les deux modes vous aident à boucler la boucle et à agir sur les retours de vos utilisateurs. Les mêmes évaluateurs personnalisés (tels que les évaluateurs de satisfaction des contraintes, de faisabilité des itinéraires, d’exactitude du SQL et d’explicabilité de votre solution de chaîne d’approvisionnement) utilisés pour les évaluations à la demande sont réutilisés avec un objet OnlineEvaluationConfig qui référence les Amazon Resource Names (ARN) des évaluateurs et spécifie un taux d’échantillonnage (par exemple, 1–10 % des traces de production) ainsi que des filtres de session facultatifs. Le service lit ensuite automatiquement les traces depuis AgentCore Observability, les note et diffuse les résultats vers des tableaux de bord et alarmes Amazon CloudWatch . Dans cet article, vous utiliserez le mode à la demande pour tester la solution.
Le schéma d’architecture suivant illustre les différents composants de notre solution.
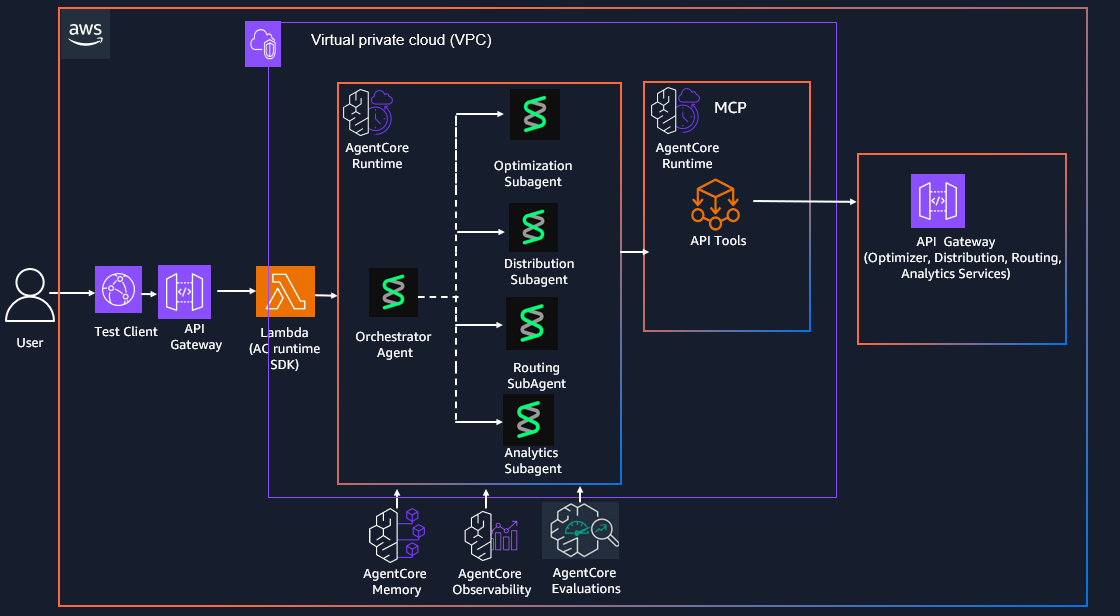
Figure 1 : Architecture de la solution multi-agents de prise de décision pour la chaîne d’approvisionnement
Cadre d’évaluation
Dans cet article, vous utiliserez une approche d’évaluation à trois couches pour les systèmes multi-agents qui construit progressivement la confiance d’entreprise. L’approche suit une progression claire : elle commence par des évaluateurs intégrés pour la qualité générale, puis ajoute des évaluateurs personnalisés pour l’exactitude commerciale, et superpose enfin des évaluateurs d’explicabilité pour la confiance et l’auditabilité.
La première couche utilise des évaluateurs intégrés ne nécessitant aucune configuration. Nous appliquons Helpfulness comme référence universelle, plus un second évaluateur spécifique à chaque agent ciblant son mode de défaillance principal : Tool Selection Accuracy pour l’orchestrateur, Response Relevance pour l’optimisation et la distribution, Instruction Following pour le routage et Faithfulness pour l’analytique.
La deuxième couche ajoute des évaluateurs personnalisés encodant des règles commerciales propres au domaine : satisfaction des contraintes pour l’optimisation, ancrage des données pour la distribution, faisabilité des itinéraires pour le routage, exactitude du SQL pour l’analytique et cohérence des plans pour l’orchestration. Ceux-ci valident la validité commerciale : la recommandation a-t-elle respecté les limites budgétaires, utilisé des données d’inventaire réelles et produit des résultats opérationnellement corrects ?
Le tableau suivant mappe les deux évaluateurs intégrés et l’évaluateur personnalisé sélectionnés pour chaque agent que vous mettrez en œuvre ici. Le second évaluateur intégré cible le mode de défaillance principal de chaque agent, tandis que l’évaluateur personnalisé encode des règles commerciales propres au domaine qui valident l’exactitude opérationnelle.
| Agent | Évaluateurs intégrés | Évaluateurs personnalisés |
| Agent orchestrateur | Helpfulness ; Tool Selection Accuracy | Évaluateur de cohérence des plans : a-t-il combiné les sorties des sous-agents en une recommandation valide et non contradictoire ? Évaluateur de trajectoire d’outils : a-t-il acheminé la requête vers le bon sous-agent ? |
| Agent d’optimisation | Helpfulness ; Response Relevance | Évaluateur de satisfaction des contraintes : budget, couverture des stocks (demande ≤ qty ≤ 2× la demande) et contraintes de capacité d’entrepôt. Évaluateur d’atteinte des indicateurs de performance (KPI) : objectif d’amélioration du taux de service/chiffre d’affaires atteint. |
| Agent de distribution | Helpfulness ; Response Relevance | Évaluateur d’ancrage des recommandations : la recommandation est ancrée dans les données actuelles d’inventaire/demande. Évaluateur d’impact sur les risques : la recommandation réduit le risque de rupture/surstock. |
| Agent de routage | Helpfulness ; Instruction Following | Évaluateur de faisabilité des itinéraires : l’itinéraire respecte les fenêtres de livraison, les coûts, les capacités des transporteurs et les contraintes régionales. Évaluateur d’accord de niveau de service (SLA) : la livraison prévue atteint le niveau de service cible. |
| Agent d’analytique | Helpfulness ; Faithfulness | Évaluateur de correction SQL : la requête correspond à l'intention de l'utilisateur. Évaluateur d'ancrage dans les données : la réponse est étayée par les résultats de requêtes d'Amazon Relational Database Service (Amazon RDS). Évaluateur de l'absence d'affirmations non étayées. |
Explicabilité
La troisième couche de notre approche d'évaluation applique des évaluateurs d'explicabilité comme des vérifications distinctes et transversales sur les agents. Ceux-ci évaluent indépendamment si les agents expriment la justification de leurs décisions, citent des preuves à l'appui issues des sorties d'outils, expliquent quelles contraintes ont façonné la réponse, expriment les compromis entre des objectifs concurrents, clarifient pourquoi des sous-agents spécifiques ont été invoqués et divulguent les hypothèses lorsque les données sont incomplètes. En isolant l'explicabilité dans sa propre couche d'évaluation, nous pouvons mesurer la transparence de manière indépendante. Une recommandation peut être exacte mais inexpliquée (réussissant les évaluateurs personnalisés mais échouant aux tests d'explicabilité), ce qui donne aux équipes des signaux exploitables sur la question de savoir si les agents ont besoin d'une meilleure expression du raisonnement plutôt que d'une meilleure logique de décision.
Le tableau suivant définit les six évaluateurs d'explicabilité indépendants que vous implémentez ici et qui sont appliqués aux agents comme une couche transversale. Ils évaluent si les agents expriment leur raisonnement, citent des preuves, expliquent les contraintes et les compromis, et divulguent les hypothèses. Ils sont mesurés séparément de la précision afin que les équipes puissent distinguer les réponses inexpliquées mais correctes des réponses bien expliquées mais erronées.
| Évaluateur | Agents | Ce qu'il vérifie |
| Qualité de la justification de la décision | Tous | L'agent a-t-il expliqué pourquoi il a fait la recommandation ? |
| Attribution des preuves | Analytics, Distribution, Routing | A-t-il cité les champs de données, la réponse d'API ou le résultat SQL utilisés ? |
| Raisonnement sur les contraintes | Optimization, Routing | A-t-il expliqué quelles contraintes ont façonné la réponse finale ? |
| Explication des compromis | Optimization, Distribution, Routing | A-t-il expliqué les compromis entre le coût, le niveau de service et le risque de stock ? |
| Explicabilité de l'utilisation des outils | Orchestrator | A-t-il expliqué pourquoi chaque sous-agent ou outil MCP a été invoqué ? |
| Divulgation des hypothèses | Tous les agents | A-t-il clairement énoncé les hypothèses lorsque les données étaient incomplètes ? |
Prérequis
Avant de déployer cette solution, configurez votre environnement de développement avec les outils suivants.
- Installez l' AWS Command Line Interface (AWS CLI)
- Installez l' AWS Serverless Application Model (AWS SAM) CLI v1.100.0+
- Installez Docker v20.x+
- Installez Node.js v18.x+
- Installer Python v3.11+
Dépendances
L'implémentation Strands Agents nécessite également les dépendances suivantes, qui sont empaquetées dans le DockerFile :
- strands-agents # Framework multi-agents Strands Agents
- strands-agents-tools # Outils et utilitaires pour agents Strands
- requests # Bibliothèque HTTP pour les appels API
- bedrock-agentcore # Fonctionnalité principale des agents Amazon Bedrock
- boto3 # SDK AWS pour Python (Boto3)
Déployer et exécuter la solution
La solution est disponible au téléchargement depuis notre dépôt GitHub et offre un déploiement en une seule étape pour déployer et accéder à la solution dans votre environnement AWS :
# Edit terraform.tfvars: set vpc_id and runtime_subnet_azs
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
Les sorties incluent les ARN du runtime, l'URL de l'API AnyCompany Retail, l'URL de l'API d'évaluation et l'ARN de la mémoire.
Exécuter la solution
Suivez ces étapes pour exécuter la solution :
Le dossier test_client/ contient un script Python qui invoque l'agent Supply Chain déployé avec 20 requêtes d'exemple (5 par sous-agent) afin de valider la fonctionnalité de bout en bout. Chaque catégorie s'exécute sous forme de session multi-tours, et les identifiants de session sont affichés à la fin pour être utilisés avec l'API des évaluateurs.
cd test_client
pip install -r requirements.txt
cd terraform
terraform output supply_chain_arn
Exécuter toutes les requêtes (20 au total, 4 sessions)
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" --region <your_region>
Exécuter des catégories de sous-agents spécifiques
#Only optimization queries (1 session, 5 turns)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
#Only routing and analytics (2 sessions, 5 turns each)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category routing analytics
Le client de test affiche chaque requête et la réponse complète de l'agent. À la fin, il affiche les identifiants de session à utiliser avec les évaluateurs.
Créer et exécuter des évaluations
Le dossier test_evaluators/ contient des scripts pour exécuter des évaluations sur les sessions des agents. Ces évaluations s'exécutent de manière asynchrone et les résultats sont enregistrés sous forme de fichiers markdown dans S3.
Vous devez d'abord invoquer la solution multi-agents de prise de décision pour la chaîne d'approvisionnement comme décrit précédemment afin de générer des sessions d'agent avec des traces, et noter les identifiants de session affichés à la fin de l'exécution du client de test. Enfin, attendez 3 à 5 minutes après l'exécution de la solution pour que les traces se propagent vers CloudWatch.
cd test_evaluators
pip install -r requirements.txt
cd terraform
terraform output evaluators_api_url
Créer des évaluateurs personnalisés
python test_evaluator.py --api-url "https://<evaluators-api-url>" createCeci enregistre les évaluateurs personnalisés et affiche leurs identifiants. Conservez-les pour les utiliser avec la commande run.
Exécuter des évaluations
Passez une liste d'identifiants d'évaluateurs séparés par des virgules (personnalisés ou intégrés). Au moins 1 est requis :
# Run custom + built-in evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<session-id-from-test-client>" \
--evaluators " sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>,Builtin.Correctness,Builtin.GoalSuccessRate"
L'API renvoie immédiatement 202. Les résultats sont enregistrés de manière asynchrone dans S3 à :
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<session-id>/<timestamp>/EvaluationResults.mdSupprimer des évaluateurs
python test_evaluator.py --api-url "https://<evaluators-api-url>" delete \
--evaluator-ids "sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>"
Exécuter une évaluation d'optimisation
Maintenant que vous comprenez le cadre d'évaluation et avez déployé la solution, passons en revue une évaluation ciblée de bout en bout de l'agent d'optimisation. Cette démonstration montre comment combiner un évaluateur personnalisé de précision métier (couche 2) avec des évaluateurs d'explicabilité (couche 3) pour évaluer à la fois l'exactitude et la transparence des décisions d'optimisation.
Étape 1 : Exécuter les requêtes d'optimisation
Tout d'abord, invoquez le client de test avec uniquement la catégorie optimization pour générer une session ciblée :
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" \
--category optimization \
--region <your_region>
Ceci exécute 5 requêtes d'optimisation sous forme de session multi-tours. L'agent traite des requêtes telles que « Quel est le niveau de stock optimal pour prod-001 sur les 30 prochains jours ? » Chaque requête oblige l'agent d'optimisation à appeler les outils MCP, à récupérer les prévisions de la demande et à produire des recommandations de réapprovisionnement qui respectent les contraintes de budget, de couverture des stocks et de capacité d'entrepôt. À la fin de l'exécution, le client de test affiche l'identifiant de la session d'optimisation.
Étape 2 : Exécuter l'évaluateur Constraint Satisfaction (couche 2 : précision métier)
Une fois la session d'optimisation générée, exécutez l'évaluateur personnalisé Constraint Satisfaction pour valider si les recommandations de réapprovisionnement de l'agent respectent les règles métier. Cet évaluateur vérifie trois contraintes simultanément :
- Budget : le coût de détention supplémentaire tient-il dans le budget restant (budget_limit − budget_used) ?
- Couverture des stocks : le niveau recommandé est-il ≥ à la prévision de la demande (évite la rupture de stock) et ≤ à 2× la demande (évite le surstockage) ?
- Capacité d'entrepôt : le niveau recommandé tient-il dans l'espace d'entrepôt disponible ?
Exécutez l'évaluateur avec les évaluateurs intégrés Helpfulness et Response Relevance :
cd test_evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
L'API renvoie immédiatement un HTTP 202. Les évaluations s'exécutent de manière asynchrone. Les résultats sont enregistrés dans S3 :
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<optimization-session-id>/<timestamp>/EvaluationResults.mdÉtape 3 : Exécuter les évaluateurs d'explicabilité (Couche 3 : confiance et auditabilité)
Après avoir confirmé que l'agent d'optimisation produit des recommandations satisfaisant les contraintes, la question suivante est : explique-t-il son raisonnement ? Une recommandation peut être exacte mais opaque. Une telle recommandation passe l'évaluateur de contraintes mais n'arrive pas à expliquer pourquoi elle a choisi un niveau de stock spécifique.
En utilisant le même ID de session d'optimisation qu'à l'Étape 1, exécutez maintenant les deux évaluateurs d'explicabilité qui s'appliquent à l'agent d'optimisation :
- Decision Rationale Quality — L'agent a-t-il expliqué pourquoi il a fait la recommandation ? (par exemple, « Nous recommandons 1,500 unités parce que la prévision de demande est de 1,200 et que nous visons un facteur de sécurité de 1.25× »)
- Constraint Reasoning — L'agent a-t-il expliqué quelles contraintes ont façonné la réponse finale ? (par exemple, « Le budget permet jusqu'à 1,800 unités mais la capacité d'entrepôt nous limite à 1,600, donc nous recommandons 1,500 »)
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
Ces évaluateurs évaluent indépendamment la transparence. Ils sont mesurés séparément de l'exactitude.
Interprétation des résultats combinés
En exécutant les trois évaluateurs sur la même session d'optimisation, vous obtenez une image complète de la qualité de l'agent selon deux dimensions :
| Dimension | Évaluateur | Question à laquelle il répond |
| Exactitude métier (Couche 2) | Constraint Satisfaction | Les recommandations sont-elles opérationnellement correctes ? |
| Explicabilité (Couche 3) | Decision Rationale Quality | Pourquoi l'agent fait-il cette recommandation ? |
| Explicabilité (Couche 3) | Constraint Reasoning | Quelles contraintes ont façonné la réponse ? |
Tableau 3 : Couverture de l'évaluation selon les dimensions de qualité
Cette approche par couches permet des améliorations ciblées. Si les scores de satisfaction des contraintes sont élevés mais que les scores d'explicabilité sont faibles, la logique de décision de l'agent est solide, mais sa communication doit être améliorée. Inversement, si l'explicabilité est élevée mais que des contraintes sont violées, l'agent articule bien son raisonnement mais applique une logique incorrecte. Chaque mode de défaillance a un chemin de remédiation différent, et le cadre d'évaluation rend cette distinction mesurable.
Nettoyage
Pour éviter des frais récurrents, nettoyez votre compte AWS en une seule étape après avoir essayé la solution.
terraform destroyConclusion
Dans cet article, nous avons montré comment construire et évaluer un système décisionnel de chaîne d'approvisionnement multi-agents à l'aide d'Amazon Bedrock AgentCore Evaluations, en nous concentrant sur la vérification que le comportement de l'agent n'est pas seulement fonctionnel, mais aussi utile, exact et explicable. En utilisant le scénario d'AnyCompany Retail Group, nous avons montré comment un agent orchestrateur et des sous-agents spécialisés collaborent pour résoudre des problèmes complexes tels que l'allocation des stocks, la planification de la distribution, l'optimisation du routage et le diagnostic de la chaîne d'approvisionnement, tout en s'intégrant aux sources de données et aux API d'entreprise. Comme illustré tout au long de l'architecture, l'exactitude dans les systèmes agentiques va au-delà de la qualité des réponses. Elle dépend de la sélection des bons outils, de l'exécution du flux de travail correct, du respect des contraintes métier et de l'ancrage des sorties dans les données.
En combinant des évaluateurs intégrés avec des évaluateurs personnalisés, les équipes peuvent valider systématiquement à la fois la qualité générale des réponses et l'exactitude des décisions propres au domaine. L'ajout d'évaluateurs axés sur l'explicabilité garantit en outre que les agents articulent clairement leur raisonnement, référencent les données à l'appui et expliquent les arbitrages d'une manière que les utilisateurs métier peuvent comprendre et sur laquelle ils peuvent agir en toute confiance. Cette approche pilotée par l'évaluation permet une amélioration continue à partir de données d'exécution réelles, établit des barrières de qualité avant le déploiement en production et fournit un cadre évolutif pour délivrer des systèmes multi-agents cohérents, transparents et alignés sur le métier.
Pour commencer, explorez Amazon Bedrock AgentCore Evaluations et appliquez ces modèles à vos propres applications multi-agents. Trouvez le code source complet dans le dépôt d'exemples Amazon Bedrock AgentCore sur GitHub. Commencez par activer l'observabilité, définir les dimensions d'évaluation clés pour votre cas d'usage, puis introduire progressivement des évaluateurs intégrés et personnalisés pour mesurer ce qui compte le plus.
Pour en savoir plus, visitez la Amazon Bedrock AgentCore page du service ou commencez directement dans la console Amazon Bedrock.
Articles liés :
- Créer des agents d'IA fiables avec Amazon Bedrock AgentCore Evaluations
- Créer des systèmes multi-agents LangGraph serverless hautement évolutifs dans AWS avec Amazon Bedrock AgentCore
- Évaluer les agents d'IA : leçons du monde réel tirées de la création de systèmes agentiques chez Amazon