
Lorsqu'un utilisateur demande à l'assistant de support, une application RAG (Retrieval Augmented Generation) créée avec LangChain, de comparer deux produits selon trois dimensions, il pose en réalité six questions simultanément. La recherche par similarité utilise un seul vecteur de requête pour encapsuler toutes les intentions. Le récupérateur génère ensuite la meilleure approximation de la moyenne de ces intentions. La réponse obtenue est concise. La recherche s'exécute sans erreur. Les scores de pertinence semblent raisonnables. Pourtant, les extraits récupérés, bien que topiquement pertinents, ne couvrent qu'une fraction de ce que la question demandait réellement.
Dans cet article, nous présentons une application RAG sur Amazon Bedrock Managed Knowledge Base avec LangChain. Nous exécutons la même question en plusieurs parties via la récupération standard et la récupération agentique, et lisons les événements de trace pour voir le plan produit par le modèle. Nous abordons également le coût des deux chemins de récupération et quand le moins cher est le bon choix.
La récupération agentique est disponible sur Amazon Bedrock Managed Knowledge Base. Au lieu d'une seule recherche, Amazon Bedrock Managed Knowledge Base planifie la récupération. Il décompose la question en sous-requêtes, les exécute, juge s'il dispose de suffisamment d'éléments probants, et effectue une nouvelle recherche dans le cas contraire. Le langchain-aws package expose à la fois la récupération agentique et la récupération standard, afin que vous puissiez utiliser l'une ou l'autre depuis une application LangChain.
Vue d'ensemble de la solution
Amazon Bedrock Managed Knowledge Base, la capacité RAG entièrement gérée d'Amazon Bedrock, supprime de l'architecture RAG le magasin de vecteurs auto-géré, les embeddings et les modèles de reclassement. Vous configurez une source de données, et Amazon Bedrock Managed Knowledge Bases gère le découpage en extraits, l'embedding, le stockage et la récupération. Cette procédure pas à pas utilise Amazon Simple Storage Service (Amazon S3).
Amazon Bedrock Managed Knowledge Bases fournit deux API. Nous discutons brièvement de ces différences dans cet article. L'API Retrieve exécute une recherche hybride et renvoie des extraits notés. L'API AgenticRetrieveStream exécute une boucle de planification et diffuse les étapes sous forme d'événements de trace. Dans le langchain-aws package, la première est un récupérateur LangChain standard que vous pouvez insérer dans une chaîne. La seconde est une fonction de récupération directement depuis une base de connaissances.
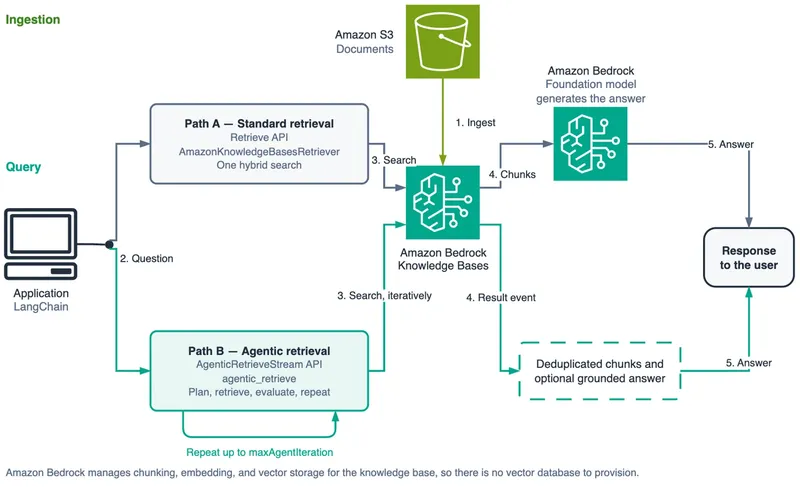
Le diagramme suivant montre l'architecture de la solution. L'application interroge Amazon Bedrock Knowledge Bases en utilisant soit l'API Retrieve (standard, en un seul appel), soit l'API AgenticRetrieveStream (boucle de planification multi-étapes). Les deux chemins renvoient des extraits de documents depuis la base de connaissances, que l'application utilise ensuite pour générer une réponse fondée.
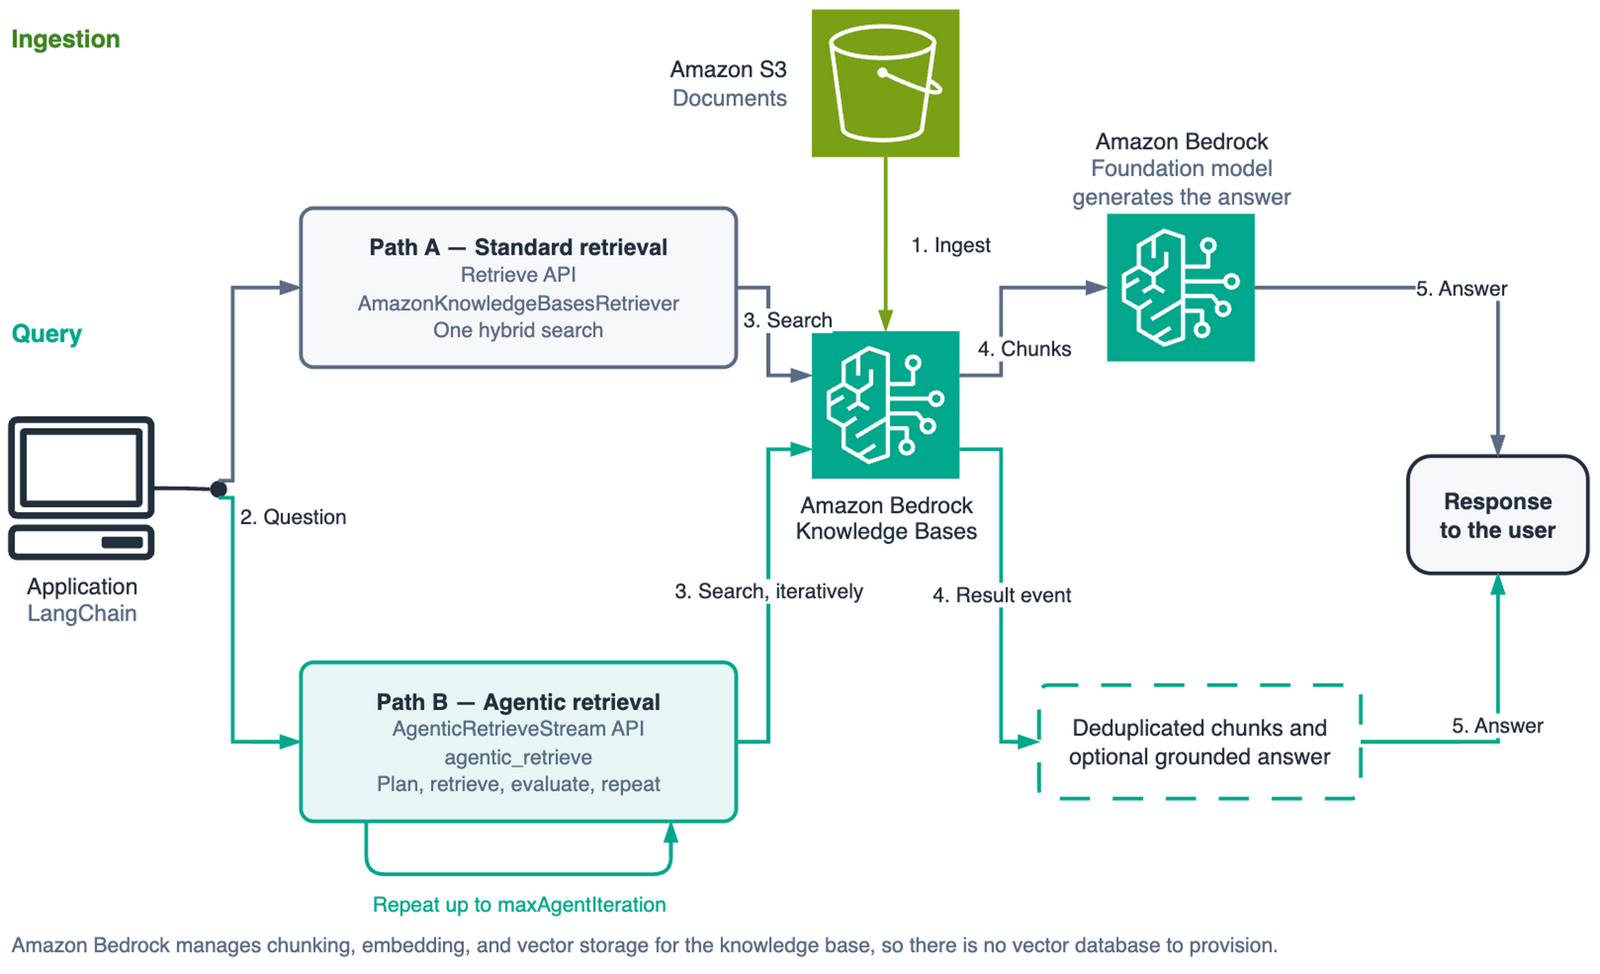
Figure 1 : Architecture de la solution pour interroger Amazon Bedrock Knowledge Bases avec les API Retrieve et AgenticRetrieveStream
Procédure d'implémentation
Les sections suivantes vous guident dans la création d'une base de connaissances, son interrogation avec les deux méthodes de récupération, et la lecture des événements de trace produits par le planificateur agentique.
Prérequis
Pour suivre ce guide, vous avez besoin de :
- Un compte AWS avec accès à Amazon Bedrock dans une Région où Amazon Bedrock Managed Knowledge Bases et la récupération agentique sont disponibles. Cette procédure pas à pas utilise la Région USA Est (Virginie du Nord) (
us-east-1), et le code le suppose tout du long. Consultez la documentation AWS pour les autres disponibilités Régionales et le support. - Deux identités AWS Identity and Access Management (IAM), décrites dans la section suivante : un rôle de service que la base de connaissances assume, et des permissions sur l'identité depuis laquelle vous appelez les API.
- Python 3.12 ou version ultérieure.
- Un bucket S3 contenant les documents d'exemple. Le corpus a besoin de plusieurs documents couvrant des sujets qui se chevauchent, afin qu'une question comparative ait quelque chose à interroger. Un document unique et plat ne peut pas démontrer la planification de requêtes.
Installez les paquets. La version de Boto3 compte : agentic_retrieve_stream n'existait pas avant la version 1.43.32.
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
Autorisations
Deux identités sont impliquées et il vaut la peine de les séparer délibérément. La base de connaissances endosse un rôle de service pour lire vos documents et appeler le modèle d'embedding. Votre application utilise une identité d'appelant du AWS Security Token Service (AWS STS) pour effectuer les requêtes. Aucune des deux n'a besoin des permissions de l'autre.
Amazon Bedrock crée le rôle de service pour vous si vous le lui laissez faire. Pour fournir le vôtre, donnez-lui une politique de confiance permettant à Amazon Bedrock de l'assumer. Limitez sa portée avec aws:SourceAccount et aws:SourceArn afin qu'un autre compte ne puisse pas l'utiliser comme un adjoint confus (confused deputy) :
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
Le rôle de service a également besoin de s3:ListBucket sur votre bucket et de s3:GetObject sur son contenu, tous deux conditionnés par aws:ResourceAccount. Réduisez le caractère générique knowledge-base/* à des identifiants de base de connaissances spécifiques une fois que vous les avez créés.
L'identité d'appelant AWS STS a besoin d'un ensemble différent. bedrock:AgenticRetrieveStream et bedrock:InvokeModelWithResponseStream ne peuvent pas être limités à un Amazon Resource Name (ARN) de base de connaissances. bedrock:Retrieve et bedrock:GetDocumentContent le peuvent :
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent est souvent négligée. La récupération agentique l'appelle lorsqu'une étape FullDocumentExpansion décide qu'un passage manque de contexte pour répondre. Une politique avec seulement bedrock:Retrieve fonctionne jusqu'à ce que le planificateur cherche à atteindre un document entier, puis échoue en cours de requête.
Pour créer et gérer la base de connaissances elle-même, le rôle d'appelant a également besoin de bedrock:CreateKnowledgeBase sur *, ainsi que des actions GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJobet ListIngestionJobs sur knowledge-base/*. Si vous utilisez des guardrails, ajoutez bedrock:GetGuardrail et bedrock:ApplyGuardrail.
L'exécution de ce guide pas à pas peut entraîner des coûts de stockage et d'ingestion de documents dans la base de connaissances, des appels de récupération et des inférences de modèle de fondation (FM).
Pour plus d'informations sur les tarifs, consultez la section Knowledge Bases de Amazon Bedrock pricing.
Supprimez les ressources lorsque vous avez terminé cette expérience.
Création et remplissage de la base de connaissances
Créez la base de connaissances avec un managedKnowledgeBaseConfiguration. En définissant embeddingModelType sur MANAGED utilise le modèle d'embedding géré par le service.
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
Il n'y a pas de storageConfiguration dans cette requête. Pour une base de connaissances auto-gérée, vous en passeriez une décrivant votre vector store. Amazon Bedrock Managed Knowledge Base n'en prend pas, ce qui est le signal le plus clair dans l'API qu'Amazon Bedrock possède la couche de stockage.
Attachez le compartiment S3 comme source de données, puis démarrez une tâche d'ingestion. L'ingestion est asynchrone, donc interrogez jusqu'à ce que la tâche atteigne un état terminal plutôt que de dormir pendant un intervalle fixe en croisant les doigts.
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
La configuration complète de la source de données et la gestion des erreurs se trouvent dans le dépôt d'exemple.
Interroger avec le retriever LangChain
AmazonKnowledgeBasesRetriever encapsule l'API Retrieve et se comporte comme n'importe quel autre retriever LangChain. Pour les Amazon Bedrock Managed Knowledge Bases, passez managedSearchConfiguration. C'est le point qui piège beaucoup de gens : vectorSearchConfiguration est l'ancien chemin pour les bases de connaissances où vous gérez votre propre vector store. C'est ce que montrent la plupart des exemples existants.
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
Chaque résultat est renvoyé sous forme de DocumentLangChain. Le score de pertinence se trouve dans metadata["score"], et les métadonnées propres au document source sont sous metadata["source_metadata"], renommées pour éviter toute collision. Si vous souhaitez éliminer les résultats à faible confiance, définissez min_score_confidence sur le retriever au lieu de filtrer ensuite.
Pour une question avec une seule intention claire, c'est le bon outil. C'est un seul appel. La latence est la plus faible des deux options, et vous gardez le contrôle total sur la manière dont la réponse est générée. La plupart des requêtes qu'un assistant en production reçoit sont de cette forme, et utiliser une boucle de planification pour y répondre gaspille de l'argent et du temps.
Là où la récupération en un seul appel atteint ses limites
Donnons maintenant au même retriever une question en plusieurs parties :
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
Cinq chunks reviennent, classés par score hybride par rapport à un seul embedding de cette question entière.
Cette question contient six intentions : deux services selon trois dimensions. Noter le texte récupéré pour trouver des preuves de chacune d'elles donne une mesure concrète de ce qu'un seul embedding récupère.
| numberOfResults | Chunks | Part du corpus | Sous-intentions couvertes | Manquantes |
| 5 | 5 | 10% | 4 sur 6 | checkout on-call, inventory restore |
| 10 | 10 | 19% | 6 sur 6 | aucune |
À cinq résultats, un seul embedding représentant six intentions en manque deux. À dix, les six sont couvertes, avec un gaspillage visible : deux sous-intentions sont couvertes deux fois et un chunk n'en porte aucune.
Le récupérateur a fait son travail. La limitation est structurelle : un seul vecteur ne peut pas représenter six intentions, et il n'existe aucune étape dans le processus qui demande si les éléments de preuve renvoyés suffisent à répondre à la question.
Exécution de la récupération agentique
La récupération agentique n'est pas un récupérateur LangChain, mais une fonctionnalité des Amazon Bedrock Managed Knowledge Bases. Le langchain-aws package l'expose comme une fonction autonome, agentic_retrieve, car l'API sous-jacente diffuse ses résultats et ne correspond pas à l'interface synchrone BaseRetriever . Il n'y a aucun indicateur sur AmazonKnowledgeBasesRetriever qui permet de l'activer.
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
Avec generate_response=True, le service renvoie une réponse fondée et des citations avec les fragments récupérés, de sorte que vous obtenez une réponse sans câbler un appel de modèle distinct. La fonction ne fonctionne qu'avec un Amazon Bedrock Managed Knowledge Base.
En interne, le service planifie, récupère, évalue si les preuves sont suffisantes et itère si ce n'est pas le cas. La fonction d'aide masque tout cela et renvoie les fragments finaux, ce qui est pratique mais signifie que vous ne pouvez pas voir le plan.
Lecture des événements de trace
Pour observer le modèle décomposer la question, appelez agentic_retrieve_stream sur le client bedrock-agent-runtime directement. C'est le seul endroit de ce guide où nous contournons langchain-aws, car la fonction d'aide rejette les événements de trace et n'expose pas maxAgentIteration ni un modèle de planification personnalisé.
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
Définissez generateResponse sur False lorsque vous ne souhaitez que le comportement de récupération. L'API génère par défaut une réponse fondée, ce qui coûte un appel de modèle supplémentaire dont vous n'avez peut-être pas besoin pendant que vous examinez le plan.
Le champ step d'un événement de trace vous indique où en est le planificateur. SpeculativeRetrieval s'exécute avant le premier plan pour réduire la latence et ne compte pas dans votre budget d'itérations. Planning est l'étape où le modèle lit la question et les résultats précédents et émet des sous-requêtes. Retrieval se déclenche une fois par sous-requête. FullDocumentExpansion apparaît lorsque le modèle décide qu'un passage manque de contexte pour répondre et récupère plutôt le document entier. Chacun porte un statut de IN_PROGRESS, SUCCEEDED, ou FAILED, ainsi qu'un message lisible par l'humain.
Les fragments finaux arrivent séparément. Le result est son propre type d'événement plutôt qu'une cinquième étape, et il contient les fragments dédupliqués de chaque itération ainsi que la réponse fondée lorsque la génération de réponse est activée. Effectuez une branche sur la clé de l'événement, comme le démontre la boucle précédente, plutôt que d'attendre une valeur d'étape terminale.
Le texte de la sous-requête est la partie qui mérite d'être journalisée. Il se trouve dans attributes.actions[].retrieve.inputQuery.text, et non dans les champs de trace de premier niveau, de sorte qu'un gestionnaire qui ne lit que step et status vous montre que la planification a eu lieu sans vous montrer ce qu'elle a décidé.
Le diagramme suivant montre la boucle de planification de récupération agentique, y compris les étapes de récupération spéculative, de planification, de récupération des sous-requêtes, d'évaluation et de re-planification facultative.
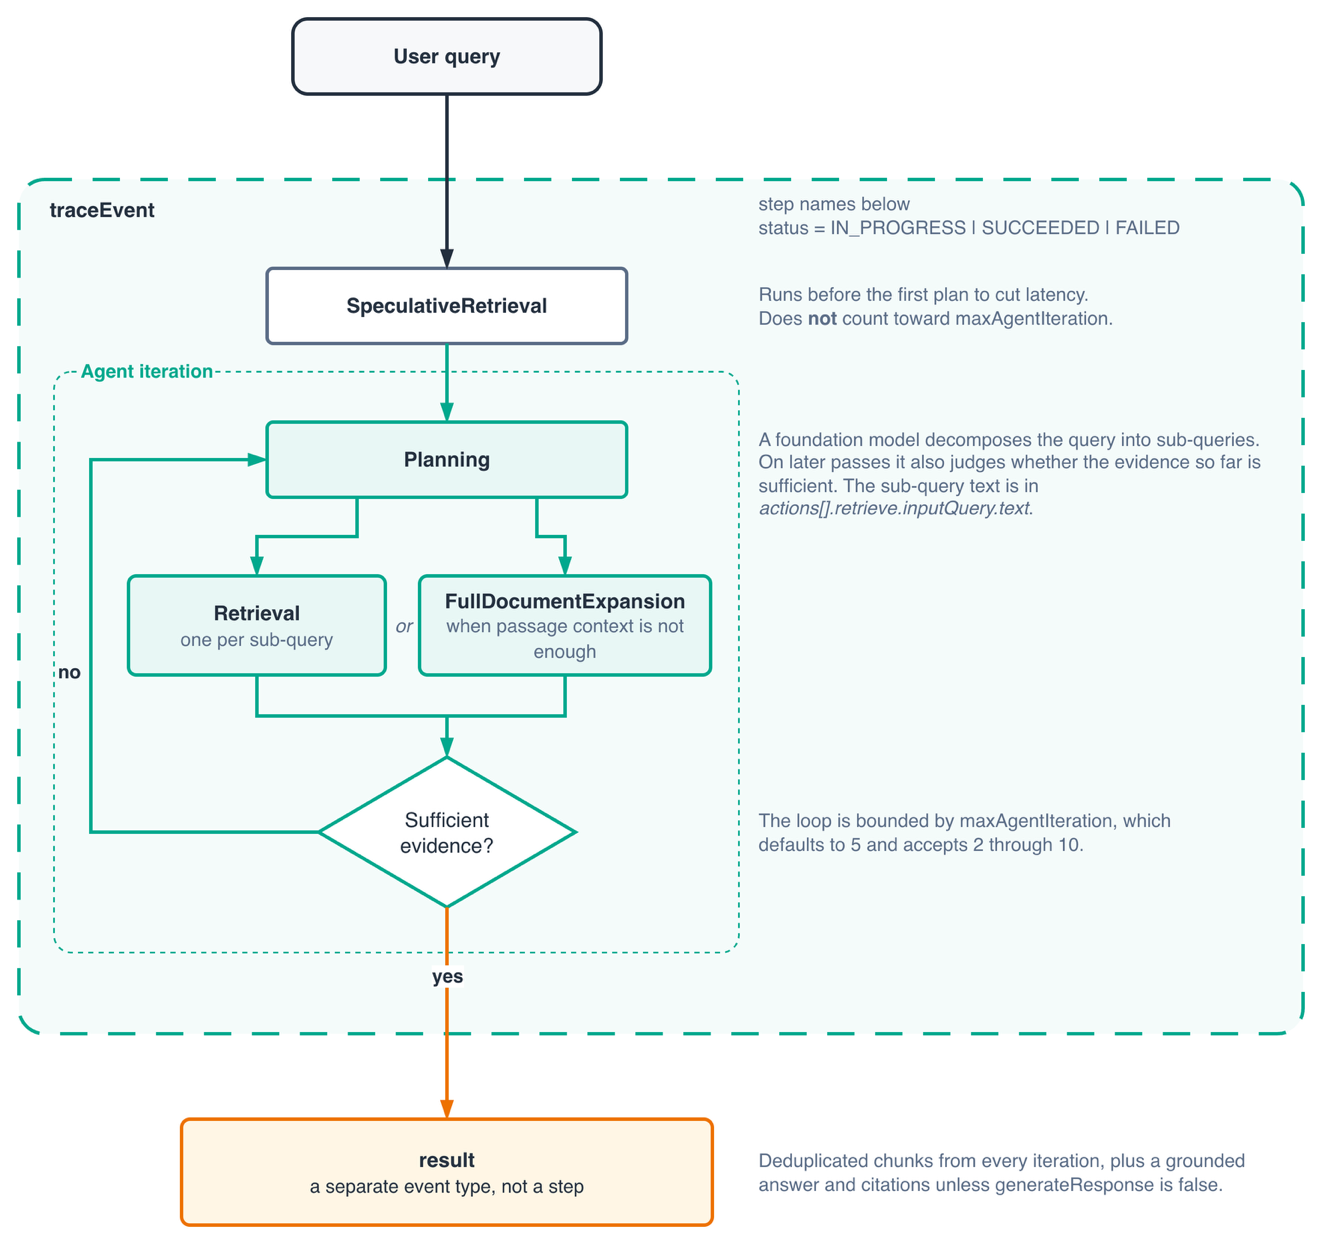
Figure 2 : Étapes de la boucle de planification de récupération agentique
Deux détails sont bon à savoir avant de vous appuyer sur ce mécanisme. La déduplication s'applique uniquement à l'événement result , de sorte qu'un chunk récupéré par trois sous-requêtes apparaît une fois à la fin mais trois fois dans les traces.
Le second concerne les scores. Une réponse Retrieve donne à chaque chunk un champ typé score contenant sa pertinence par rapport à la requête. Les résultats de la récupération agentique comportent content, metadata, et sourceRetriever, sans champ typé équivalent. Le code qui lit result["score"] après le passage à une autre API ne obtient rien. Si vous classez ou filtrez par pertinence, prévoyez cette différence.
En production, utilisez Amazon Bedrock Guardrails pour appliquer des politiques de contenu et des vérifications d'ancrage sur les réponses générées. Les deux chemins de récupération prennent en charge les guardrails. La récupération agentique prend en charge les guardrails via policyConfiguration.bedrockGuardrailConfiguration plutôt que via l'argument guardrail_config que prend le récupérateur LangChain, et prend en charge uniquement le mode BLOCK . Si vous dépendez du mode MASK , c'est une raison de rester sur l'API Retrieve.
maxAgentIteration accepte de deux à dix et sa valeur par défaut est cinq. Laissez-le à la valeur par défaut. À deux ou trois, le planificateur exécute un cycle, n'émet aucune sous-requête et renvoie ce que l'étape de récupération spéculative a déjà trouvé. Il s'agit d'un comportement en une seule passe au prix agentique. La décomposition commence à quatre. Le planificateur s'arrête souvent tôt lorsqu'il juge les preuves suffisantes, de sorte que le plafond est une borne plutôt qu'une cible.
Comparaison des deux chemins de récupération
Pour contextualiser ce comportement à grande échelle, AWS a évalué la récupération agentique sur MuSiQue, un benchmark public multi-hop. L'évaluation a montré un rappel amélioré par rapport à la récupération en une seule passe, avec les plus grands gains sur les questions les plus difficiles. Les questions à un seul saut ont vu des gains inférieurs à cinq points. Ce dernier chiffre correspond à la forme du compromis : la décomposition aide lorsqu'il y a quelque chose à décomposer.
Construction de la chaîne RAG
Pour le récupérateur standard, la composition habituelle en LangChain Expression Language (LCEL) fonctionne directement :
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs compte plus qu'il n'y paraît. Passer Document des objets directement dans un prompt rend leur repr, et le modèle reçoit un bruit de métadonnées mélangé au contexte.
Pour mettre la récupération agentique dans la même position, enveloppez-la dans un RunnableLambda, puisqu'il s'agit d'une fonction plutôt que d'un retriever :
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
Notez que generate_response est désactivé ici. Le service peut générer la réponse lui-même, mais dans une chaîne vous voulez généralement votre propre prompt et votre propre modèle, donc vous récupérez les chunks et générez en aval. Utilisez la génération du service quand vous voulez un seul appel et moins de code, et la version enveloppée quand le prompt doit être sous votre contrôle.
Choisir entre la récupération standard et la récupération agentique
Utilisez Retrieve pour des questions courtes et bien délimitées. C'est moins cher, plus rapide, cela fonctionne avec des bases de connaissances auto-gérées et cela renvoie des scores dans les résultats. La plupart du trafic de production ressemble à cela.
Utilisez AgenticRetrieveStream lorsque les questions sont à plusieurs volets, comparatives ou exploratoires, ou lorsque les preuves s'étendent sur plus d'une base de connaissances. Il enregistre jusqu'à cinq bases de connaissances en une seule requête et achemine les sous-requêtes à l'aide d'une description en langage naturel que vous joignez à chacune. L'autre API ne peut absolument pas faire cela. Il coûte plus cher par appel, effectue plusieurs invocations de modèle et présente la latence la plus élevée des deux.
Acheminer selon la forme de la requête plutôt que d'en choisir une pour tout est le modèle que nous recommandons. Un classifieur ou une heuristique sur la question peut diriger la majorité du trafic vers le chemin le moins coûteux et réserver le planificateur aux questions qui en ont besoin.
Nettoyer les ressources
Supprimez la base de connaissances, sa source de données, les objets et le compartiment S3, ainsi que le rôle IAM que vous avez créé. Une base de connaissances contenant des documents continue d'engendrer des frais de stockage.
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
Le dépôt inclut un script de nettoyage qui vide également le compartiment et supprime le rôle.
Conclusion
Nous avons montré comment créer une application RAG sur Amazon Bedrock Knowledge Bases avec LangChain, et comment la récupération agentique traite les questions à plusieurs volets que la récupération en une seule passe répond mal. Nous avons également montré les frictions de l'intégration actuelle. La récupération agentique est une fonction plutôt qu'un retriever LangChain, elle a donc besoin d'un RunnableLambda pour s'intégrer dans une chaîne. Les événements de trace qui montrent le plan de requête nécessitent un appel direct boto3 .
La récupération agentique échange un coût par appel plus élevé contre un rappel amélioré sur les questions multi-sauts, en utilisant un modèle intégré pour la planification des requêtes. La prochaine étape utile consiste à mesurer votre propre mix de requêtes avant de tout faire passer par un planificateur.
Pour commencer, consultez la documentation d'Amazon Bedrock Knowledge Bases et le code d'exemple associé. Pour obtenir de l'aide pour appliquer cela à votre propre charge de travail, contactez votre équipe de compte AWS.