
Amazon Quick est le compagnon d'IA agentique d'Amazon conçu pour le travail. Vous créez des agents qui raisonnent sur vos données, appellent des connecteurs d'actions et mènent des tâches multi-étapes à leur terme. Promouvoir ces ressources (agents de chat, connecteurs d'actions, bases de connaissances, flux et espaces) d'un compte AWS de développement vers un compte de production, comme vous le feriez pour toute autre application, a été une tâche manuelle et source d'erreurs. Cet article montre comment l'automatiser avec un serveur Model Context Protocol (MCP) idempotent et auditable sur Amazon Bedrock AgentCore.
Les éléments constitutifs d'une solution agentique sont ses agents, connecteurs d'actions, bases de connaissances et espaces: des agents de chat configurés avec des instructions personnalisées, des connecteurs pour Slack, Jira et d'autres intégrations, des bases de connaissances ancrées dans vos propres documents, et l'espace qui les relie tous. Les équipes les assemblent et les itèrent rapidement dans un compte de développement.
La plupart des entreprises utilisent des comptes AWS distincts pour le développement et la production, parfois avec l'assurance qualité (QA) entre les deux. Lorsque les agents, connecteurs d'actions et bases de connaissances sont validés dans un compte de développement, il n'existe aucun moyen natif en un clic de les promouvoir vers le compte suivant. Les équipes reconstruisent chaque ressource à la main : recréer chaque agent avec les mêmes instructions et invites de démarrage, rattacher les connecteurs d'actions de chaque agent, accorder à nouveau les permissions des ressources, et reprovisionner le compartiment Amazon Simple Storage Service (Amazon S3), sa politique de compartiment et la source de données derrière chaque base de connaissances. Le travail est lent, difficile à auditer et il est facile de commettre des erreurs subtiles, ce qui compromet la gouvernance dont les entreprises ont besoin.
Gérer les ressources Amazon Quick via une API
Les ressources Amazon Quick sont programmables. Les espaces, agents, connecteurs d'actions, bases de connaissances et flux sont gérés via l'API Amazon Quick (qui fait partie de la surface d'API Amazon QuickSight), qui fournit le cycle de vie complet des ressources : création, lecture, mise à jour, suppression et liste. Tout ce qu'un utilisateur métier configure dans Amazon Quick, un agent avec ses instructions et invites de démarrage, un connecteur, une base de connaissances ou un flux, peut être inspecté, recréé, mis à jour et gouverné par programmation, permissions incluses.
Cette surface programmable est ce qui rend possible une promotion gouvernée. Au lieu de recréer chaque ressource à la main, nous lisons une ressource et ses permissions via l'API et les réappliquons dans un autre compte exactement telles qu'elles étaient. Le migrateur de cet article compose les opérations de création, lecture, mise à jour et liste en un seul flux de travail répétable, et il n'émet jamais de suppression sur la cible, de sorte qu'une exécution ne fait qu'ajouter ou mettre à jour.
Dans cet article, nous présentons le Quick Resource Migrator, un exemple de serveur MCP hébergé sur le runtime Amazon Bedrock AgentCore, une capacité d'Amazon Bedrock AgentCore, qui automatise la promotion entre comptes des ressources Amazon Quick en un seul appel d'outil. Il est piloté par les ressources : vous choisissez un type de ressource (agent, connecteur, base de connaissances, flux ou espace) et sélectionnez par id, par nom, ou tout. Il est idempotent (peut être réexécuté sans risque), et il copie fidèlement les permissions en décrivant la source et en rejouant les mêmes actions dans la cible. Le code source complet est disponible dans le dépôt aws-samples.
Présentation de la solution
Le migrateur promeut un ensemble choisi de ressources en un seul appel. Il s'agit d'un upsert : une ressource qui n'existe pas encore dans la cible est créée, et celle qui existe déjà est mise à jour sur place. Chaque mise à jour est protégée par une sauvegarde versionnée écrite dans Amazon S3 avant la modification, de sorte que chaque ressource conserve un historique complet que vous pouvez consulter et vers lequel revenir. Un aperçu en lecture seule indique exactement ce qu'une exécution créerait ou mettrait à jour avant que vous ne vous engagiez, et la migration elle-même s'exécute sur Amazon Bedrock AgentCore, elle peut donc être pilotée depuis Amazon Quick ou tout client compatible MCP.
Ce qui est migré
- Modèle de sélection : Choisissez un type de ressource (agent, connecteur, base de connaissances, flux ou espace) et sélectionnez les ressources par id, par nom, ou toutes. La sélection est pilotée par les ressources. Migrez directement un type de ressource, ou migrez un espace pour emmener avec lui ses ressources liées.
- Agents de chat : Recréés avec leurs instructions personnalisées, leur identité, leur ton, leurs invites de démarrage et leur message de bienvenue, avec leurs connecteurs d'actions rattachés à nouveau (remappés vers le compte cible). Lorsqu'un espace est migré, ses agents y sont automatiquement reliés à nouveau.
- Connecteurs d'actions : Recréés avec leur configuration. Les valeurs secrètes ne sont jamais lues depuis la source. Les connecteurs sont créés avec des identifiants provisoires et réauthentifiés dans la cible.
- Bases de connaissances : La base de connaissances est enregistrée dans le compte cible, sa source de données est recréée et ses permissions sont copiées. Pour les bases de connaissances adossées à S3, le migrateur provisionne également le compartiment cible et sa politique de compartiment (une sortie distincte de la migration). Les documents (objets S3) eux-mêmes ne sont pas copiés.
- Flux : Recréés dans le compte cible à partir de leur définition. Comme les identifiants de flux diffèrent d'un compte à l'autre, les flux sont appariés par nom : un flux cible de même nom est mis à jour, sinon un nouveau flux est créé. Les permissions des flux sont copiées.
- Espaces : Recréés dans le compte cible et reliés à nouveau à leurs agents, connecteurs et bases de connaissances (avec les Amazon Resource Names (ARN) des ressources remappés vers la cible). Migrez d'abord les ressources liées afin que les ARN cibles se résolvent. Les permissions des espaces sont copiées.
Principes de conception clés
- Sélection pilotée par les ressources. Vous migrez un type de ressource à la fois (agent, connecteur, base de connaissances, flux ou espace), en sélectionnant par id, par nom, ou tous. Les agents sont recréés avec leurs connecteurs d'action rattachés à nouveau. Les espaces sont recréés et reliés à nouveau à leurs agents, connecteurs et bases de connaissances, avec les ARN remappés vers le compte cible.
- Fidélité des permissions. Les permissions ne sont pas codées en dur. Le serveur appelle l'
Describe*PermissionsAPI pertinente sur chaque ressource source et rejoue la liste d'actions identique dans la cible, en remappant les principals vers les utilisateurs enregistrés dans le compte cible. - Idempotence. Chaque ressource est créée ou mise à jour. Le serveur décrit d'abord la cible et décide s'il faut créer ou mettre à jour, de sorte que la réexécution d'une migration converge vers le même état au lieu de produire des doublons ou d'échouer.
- Privilège minimal et isolation. Le rôle source est en lecture seule. Le rôle cible ne détient que les actions nécessaires à la migration. Le runtime authentifie les appelants avec un JSON Web Token (JWT) Cognito et peut s'exécuter en mode réseau virtual private cloud (VPC).
- Mises à jour sûres et réversibles. Avant que l'outil de migration ne mette à jour une ressource cible existante, il écrit un instantané versionné de cette ressource, et de ses dépendances, dans un bucket de sauvegarde dédié. Si cette sauvegarde ne peut pas être écrite, la mise à jour est abandonnée. Chaque ressource créée ou mise à jour est également sauvegardée par instantané, et un outil de restauration peut ramener n'importe quelle ressource à une version antérieure.
Architecture
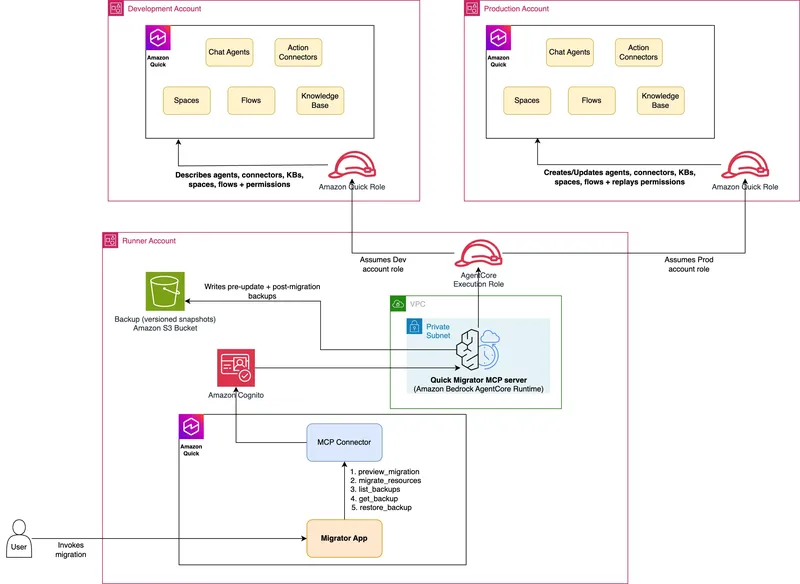
La solution utilise un modèle à trois comptes. Un compte d'exécution central héberge le serveur MCP sur le runtime Amazon Bedrock AgentCore. Le serveur assume un rôle en lecture seule dans le compte source et un rôle en lecture-écriture dans le compte cible à l'aide d'AWS Security Token Service (AWS STS), de sorte qu'aucun identifiant de longue durée ne soit stocké nulle part.
Figure 1 : Architecture du serveur MCP Amazon Quick Resource Migrator
Responsabilités des composants
| Composant | Responsabilité |
| Runtime AgentCore (compte d'exécution) | Héberge le serveur MCP (server.py). Assume des rôles dans les comptes source et cible et orchestre la migration. S'exécute en mode réseau VPC avec un autorisateur JWT Cognito. |
| Amazon Cognito (compte d'exécution) | Pool d'utilisateurs, serveur de ressources et client d'application machine à machine. Émet le JWT (octroi client-credentials, portée invoke) que les appelants présentent à AgentCore. |
| Rôle d'exécution du runner | Le rôle d'exécution AgentCore : Amazon CloudWatch Logs, télémétrie, et sts:AssumeRole vers les rôles source et cible. |
| Rôle du migrateur (compte source) | Permissions describe/list Quick Sight en lecture seule plus lecture de la base de connaissances. |
| Rôle du migrateur (compte cible) | Autorisations de création/mise à jour en lecture-écriture Quick Sight, écriture sur la base de connaissances et sur S3, et ListUsers pour la résolution des principaux. |
| Bucket de sauvegarde (compte runner) | Bucket S3 chiffré qui stocke des instantanés versionnés pré-mise à jour et post-migration des ressources cibles. Le runtime y écrit directement. La restauration y lit. Optionnel (désactivé si non défini). |
Tableau 1 : Composants architecturaux
Flux de migration
- Résoudre les ressources : à partir du type de ressource et du sélecteur (id, nom ou all), résoudre les identifiants concrets des ressources dans le compte source.
- Décrire la source : décrire chaque ressource sélectionnée afin de capturer sa configuration et ses autorisations.
- Connecteurs : recréer chaque connecteur. La configuration d'authentification est assainie vers le modèle de création (écriture) avec des secrets fictifs, puis réauthentifiée dans la cible. Copier les autorisations.
- Bases de connaissances : créer le bucket cible (
knowledge-base-<env>-<account>), la politique de bucket, la source de données et la base de connaissances, puis copier les autorisations de la base de connaissances. Les objets S3 ne sont pas copiés. - Agents : recréer chaque agent avec ses connecteurs d'action attachés (remappés vers le compte cible), puis copier les autorisations de l'agent. Le lien agent-espace est restauré lorsque l'espace lui-même est migré (voir l'étape espace).
- Flows : recréer chaque flow à partir de sa définition, en faisant correspondre par nom (les ID de flow diffèrent selon les comptes) : mettre à jour un flow cible de même nom ou en créer un nouveau, puis copier les permissions du flow.
- Spaces : recréer chaque space et relier à nouveau ses agents, connecteurs et bases de connaissances avec des ARN remappés vers le compte cible (migrer d'abord ces ressources), puis copier les permissions du space.
- Report : renvoyer un rapport JSON des ressources créées ou mises à jour, des buckets, des sauvegardes, des permissions ignorées et de toutes les erreurs.
Outils exposés par le serveur MCP
Le serveur expose cinq outils, tous définis dans server.py.
preview_migration (lecture seule)
preview_migration prend un ID de compte source, un type de ressource (agent, connector, knowledge base, flow, space ou all), un sélecteur (id, name ou all) et une région AWS. Il renvoie un inventaire des agents, connecteurs d'action, bases de connaissances et flows qui seraient migrés, avec leurs noms et types, sans effectuer aucun changement. Utilisez-le comme un essai à blanc pour confirmer le périmètre et pour soutenir une étape d'approbation de gestion du changement avant la promotion. Lorsque vous passez également un ID de compte cible, la réponse ajoute un mappage source-vers-cible qui marque chaque ressource CREATE ou UPDATE, afin que vous puissiez voir exactement ce qu'une migration changerait avant de l'exécuter.
migrate_resources (migration complète)
migrate_resources prend les ID des comptes source et cible, un type de ressource (agent, connector, knowledge base, flow ou space), un sélecteur (id, name ou all), une région, les noms des environnements source et cible (utilisés dans le nom du bucket de la base de connaissances) et le nom du rôle de service Quick Sight. Il effectue la migration complète create-or-update décrite ci-dessus et renvoie un rapport structuré de tout ce qu'il a créé, mis à jour et accordé, ainsi que les erreurs éventuelles. Comme il est idempotent, vous pouvez l'exécuter de façon répétée, par exemple à chaque version, et il converge vers le même état cible.
list_backups (lecture seule)
list_backups recherche dans le catalogue de sauvegardes et liste les versions disponibles pour chaque actif. Les sauvegardes sont les instantanés antérieurs à la mise à jour que le migrateur écrit dans le bucket de sauvegarde, un objet versionné par mise à jour, afin que vous puissiez voir l'historique complet de toute ressource migrée.
get_backup (lecture seule)
get_backup renvoie la sauvegarde complète stockée pour un actif et une version donnés (la plus récente par défaut), y compris la configuration de la ressource capturée et ses dépendances.
restore_backup
restore_backup réapplique une version de sauvegarde stockée sur la ressource cible, en la mettant à jour sur place, ou en la recréant si elle n'existe plus. Il effectue d'abord une nouvelle sauvegarde avant restauration, si bien que le retour arrière est lui-même réversible.
Déployer la solution
Le code source complet et les instructions de déploiement pas à pas se trouvent dans le dépôt aws-samples README. À un niveau élevé, vous déployez trois piles AWS CloudFormation, les rôles AWS Identity and Access Management (IAM) inter-comptes, le réseau VPC et le runtime AgentCore authentifié par Cognito qui héberge le serveur MCP, puis vous enregistrez ce runtime comme connecteur d'action dans Amazon Quick.
Utiliser le migrateur via une Quick App
En enregistrant le runtime comme connecteur d'action, vous pouvez piloter le migrateur depuis Amazon Quick en langage naturel, et vous pouvez également créer une Quick App : une expérience web pointez-et-cliquez superposée aux mêmes outils MCP. Vous ne construisez pas cette interface à la main. Le dépôt inclut un prompt d'app-builder prêt à l'emploi que vous collez dans l'app builder d'Amazon Quick, en remplaçant les ID de connecteur et d'action de l'espace réservé par les vôtres pour générer l'application. L'application transforme le workflow en flux guidé : choisir un compte source et un compte cible ainsi que les ressources à promouvoir, prévisualiser ce qui sera créé ou mis à jour, exécuter la migration et consulter un historique de chaque migration passée, chacune sauvegardée par les instantanés S3 versionnés que le serveur écrit. Les écrans suivants montrent cette expérience.
Un exemple de Quick App
- Comme l'application est générée à partir d'un prompt, chaque build diffère. Les écrans suivants montrent un tel exemple. Dans celui-ci, la page d'accueil demande le Source Account ID, le Target Account ID, le type de ressource (agent, connector, knowledge base, flow ou space) et le sélecteur (id, name ou all), avec des options supplémentaires disponibles selon les besoins.
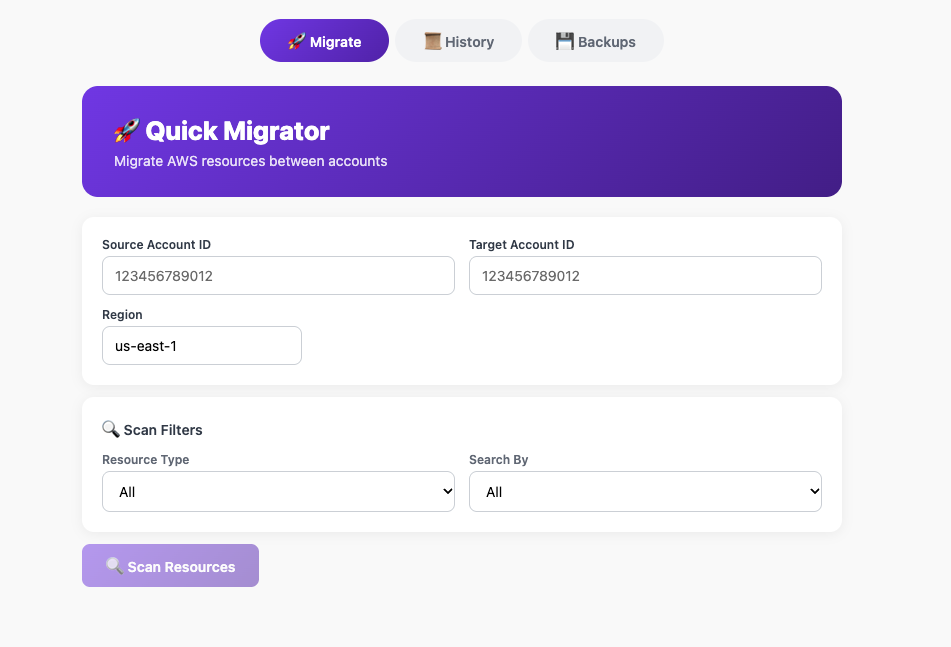
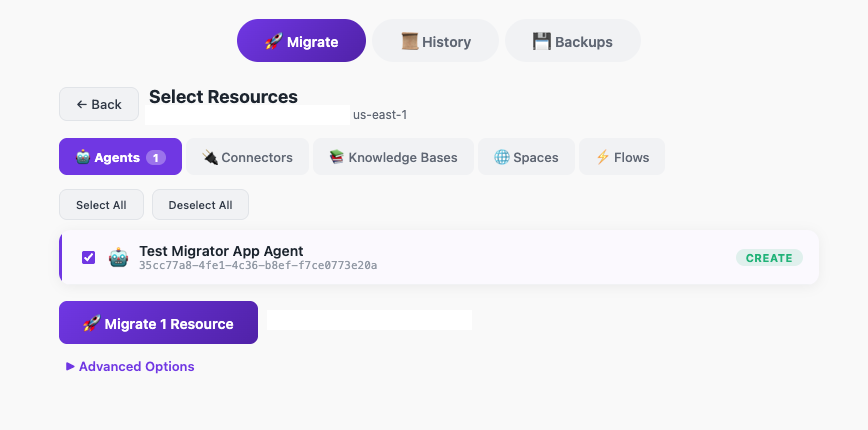
Figure 3 : Options de migration supplémentaires disponibles sur la page d'accueil
- Après avoir choisi Confirm & migrate, vous voyez une réponse comme celle-ci :
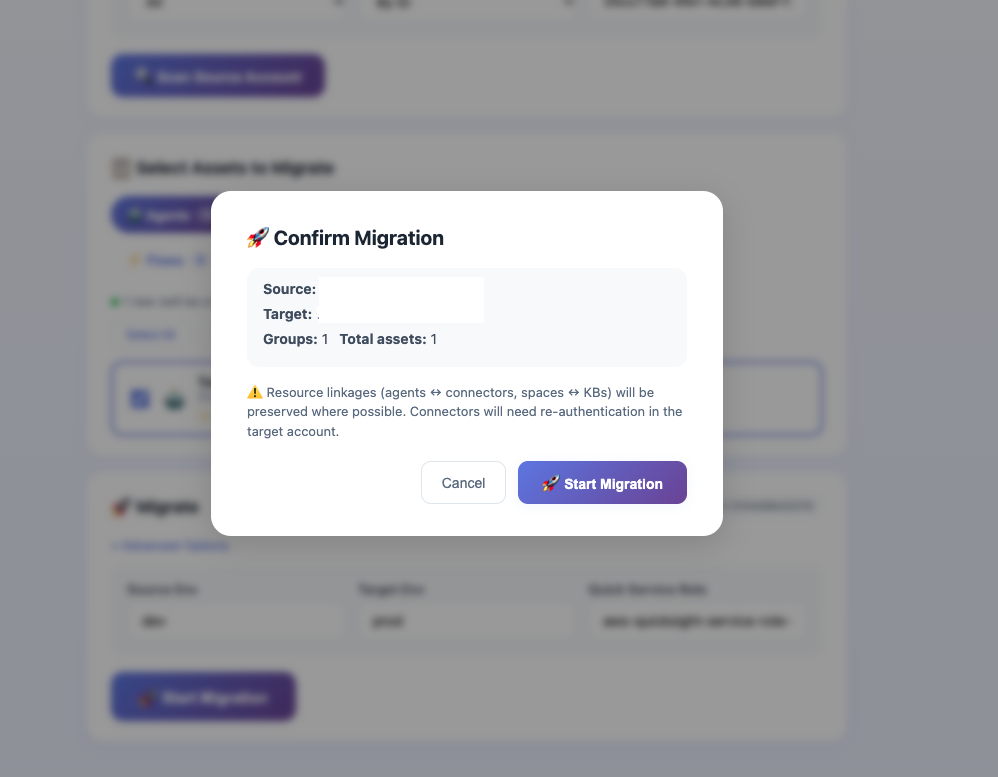
Figure 4 : La réponse de confirmation après avoir choisi Confirm and migrate
- Après avoir confirmé et migré, vous devriez voir la réponse du serveur MCP renvoyant les ressources qui ont été créées/mises à jour.
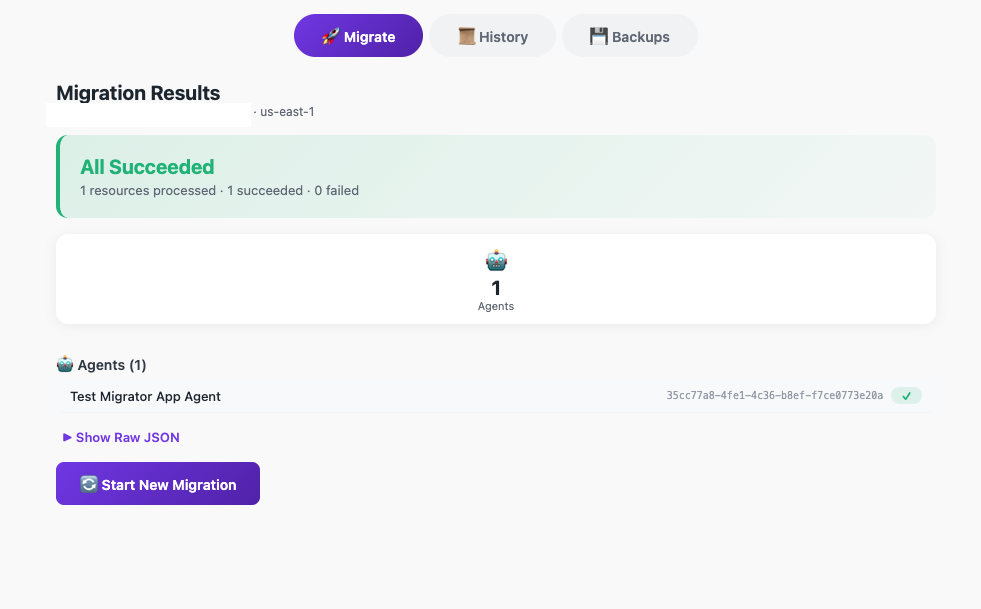
Figure 5 : La réponse du serveur MCP listant les ressources qui ont été créées ou mises à jour
- Ouvrez l'onglet History pour voir chaque migration passée. Chaque entrée est adossée à l'instantané versionné que le migrateur a écrit sur Amazon S3, ce qui vous donne un enregistrement complet et auditable de ce qui a été promu et à quel moment, avec la possibilité d'inspecter n'importe quelle version antérieure.
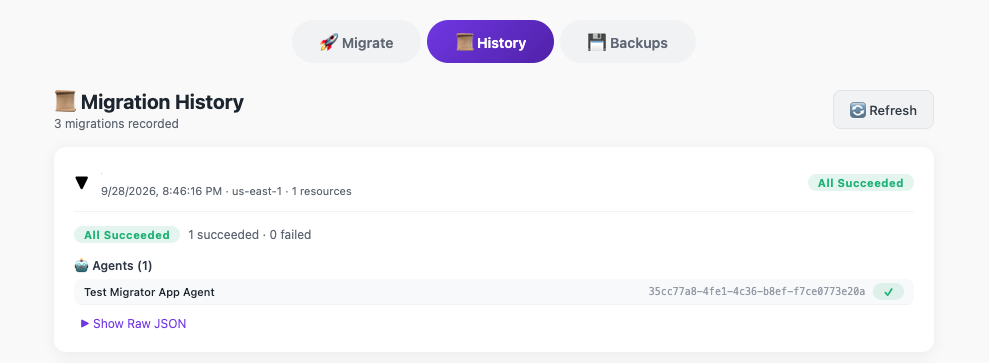
Figure 6 : L'onglet History montrant un enregistrement auditable des migrations passées
- Pour effectuer une restauration, sélectionnez la version de sauvegarde d'une ressource et choisissez Restore. L'application réapplique cette version enregistrée à la cible. Comme elle capture d'abord une nouvelle sauvegarde avant de restaurer, le retour arrière est lui-même réversible.
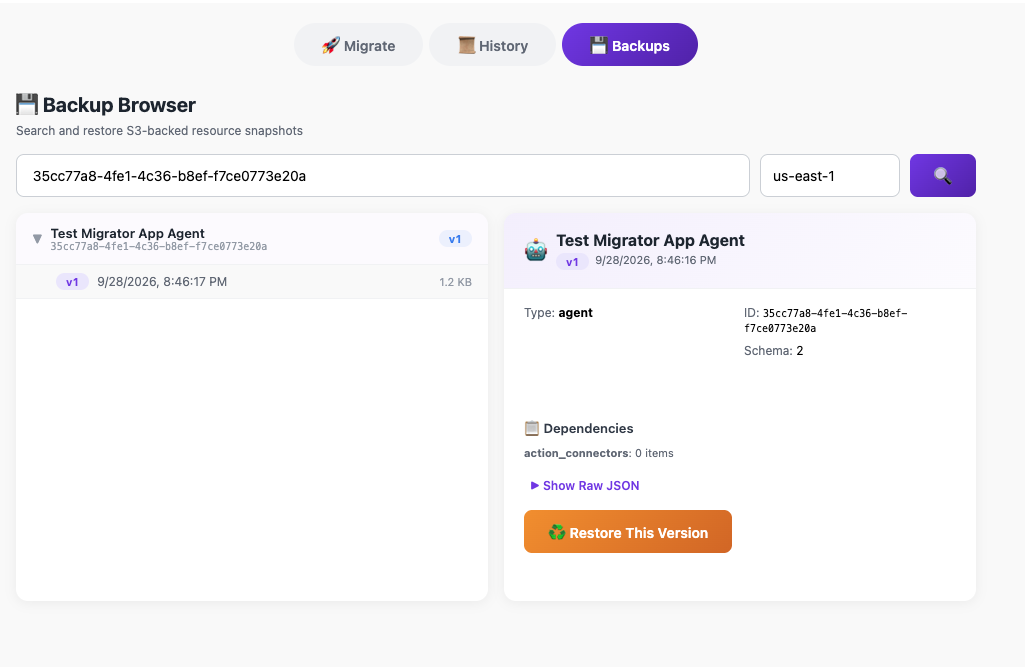
Figure 7 : Restauration d'une ressource vers une version de sauvegarde antérieure
Conclusion
La promotion inter-comptes est une attente de base pour les logiciels d'entreprise, et jusqu'à présent, c'était la pièce manquante d'Amazon Quick. Le Quick Resource Migrator transforme une tâche lente, manuelle et difficile à auditer en une tâche rapide, répétable et gouvernée : un seul appel d'outil recrée les agents, les connecteurs et les bases de connaissances dans un compte cible et copie fidèlement les autorisations, le tout de manière idempotente, afin que vous puissiez l'exécuter à chaque version.
Clonez le dépôt d'exemple, déployez-le dans un compte d'exécution (runner) et essayez de promouvoir un agent ou une base de connaissances du développement vers la production. Adaptez ensuite ce modèle à vos propres exigences de gouvernance et de renforcement.