L'Agent Arena classe la capacité des agents à résoudre des problèmes dans différents domaines.
Les laboratoires américains dominent dans tous les domaines :
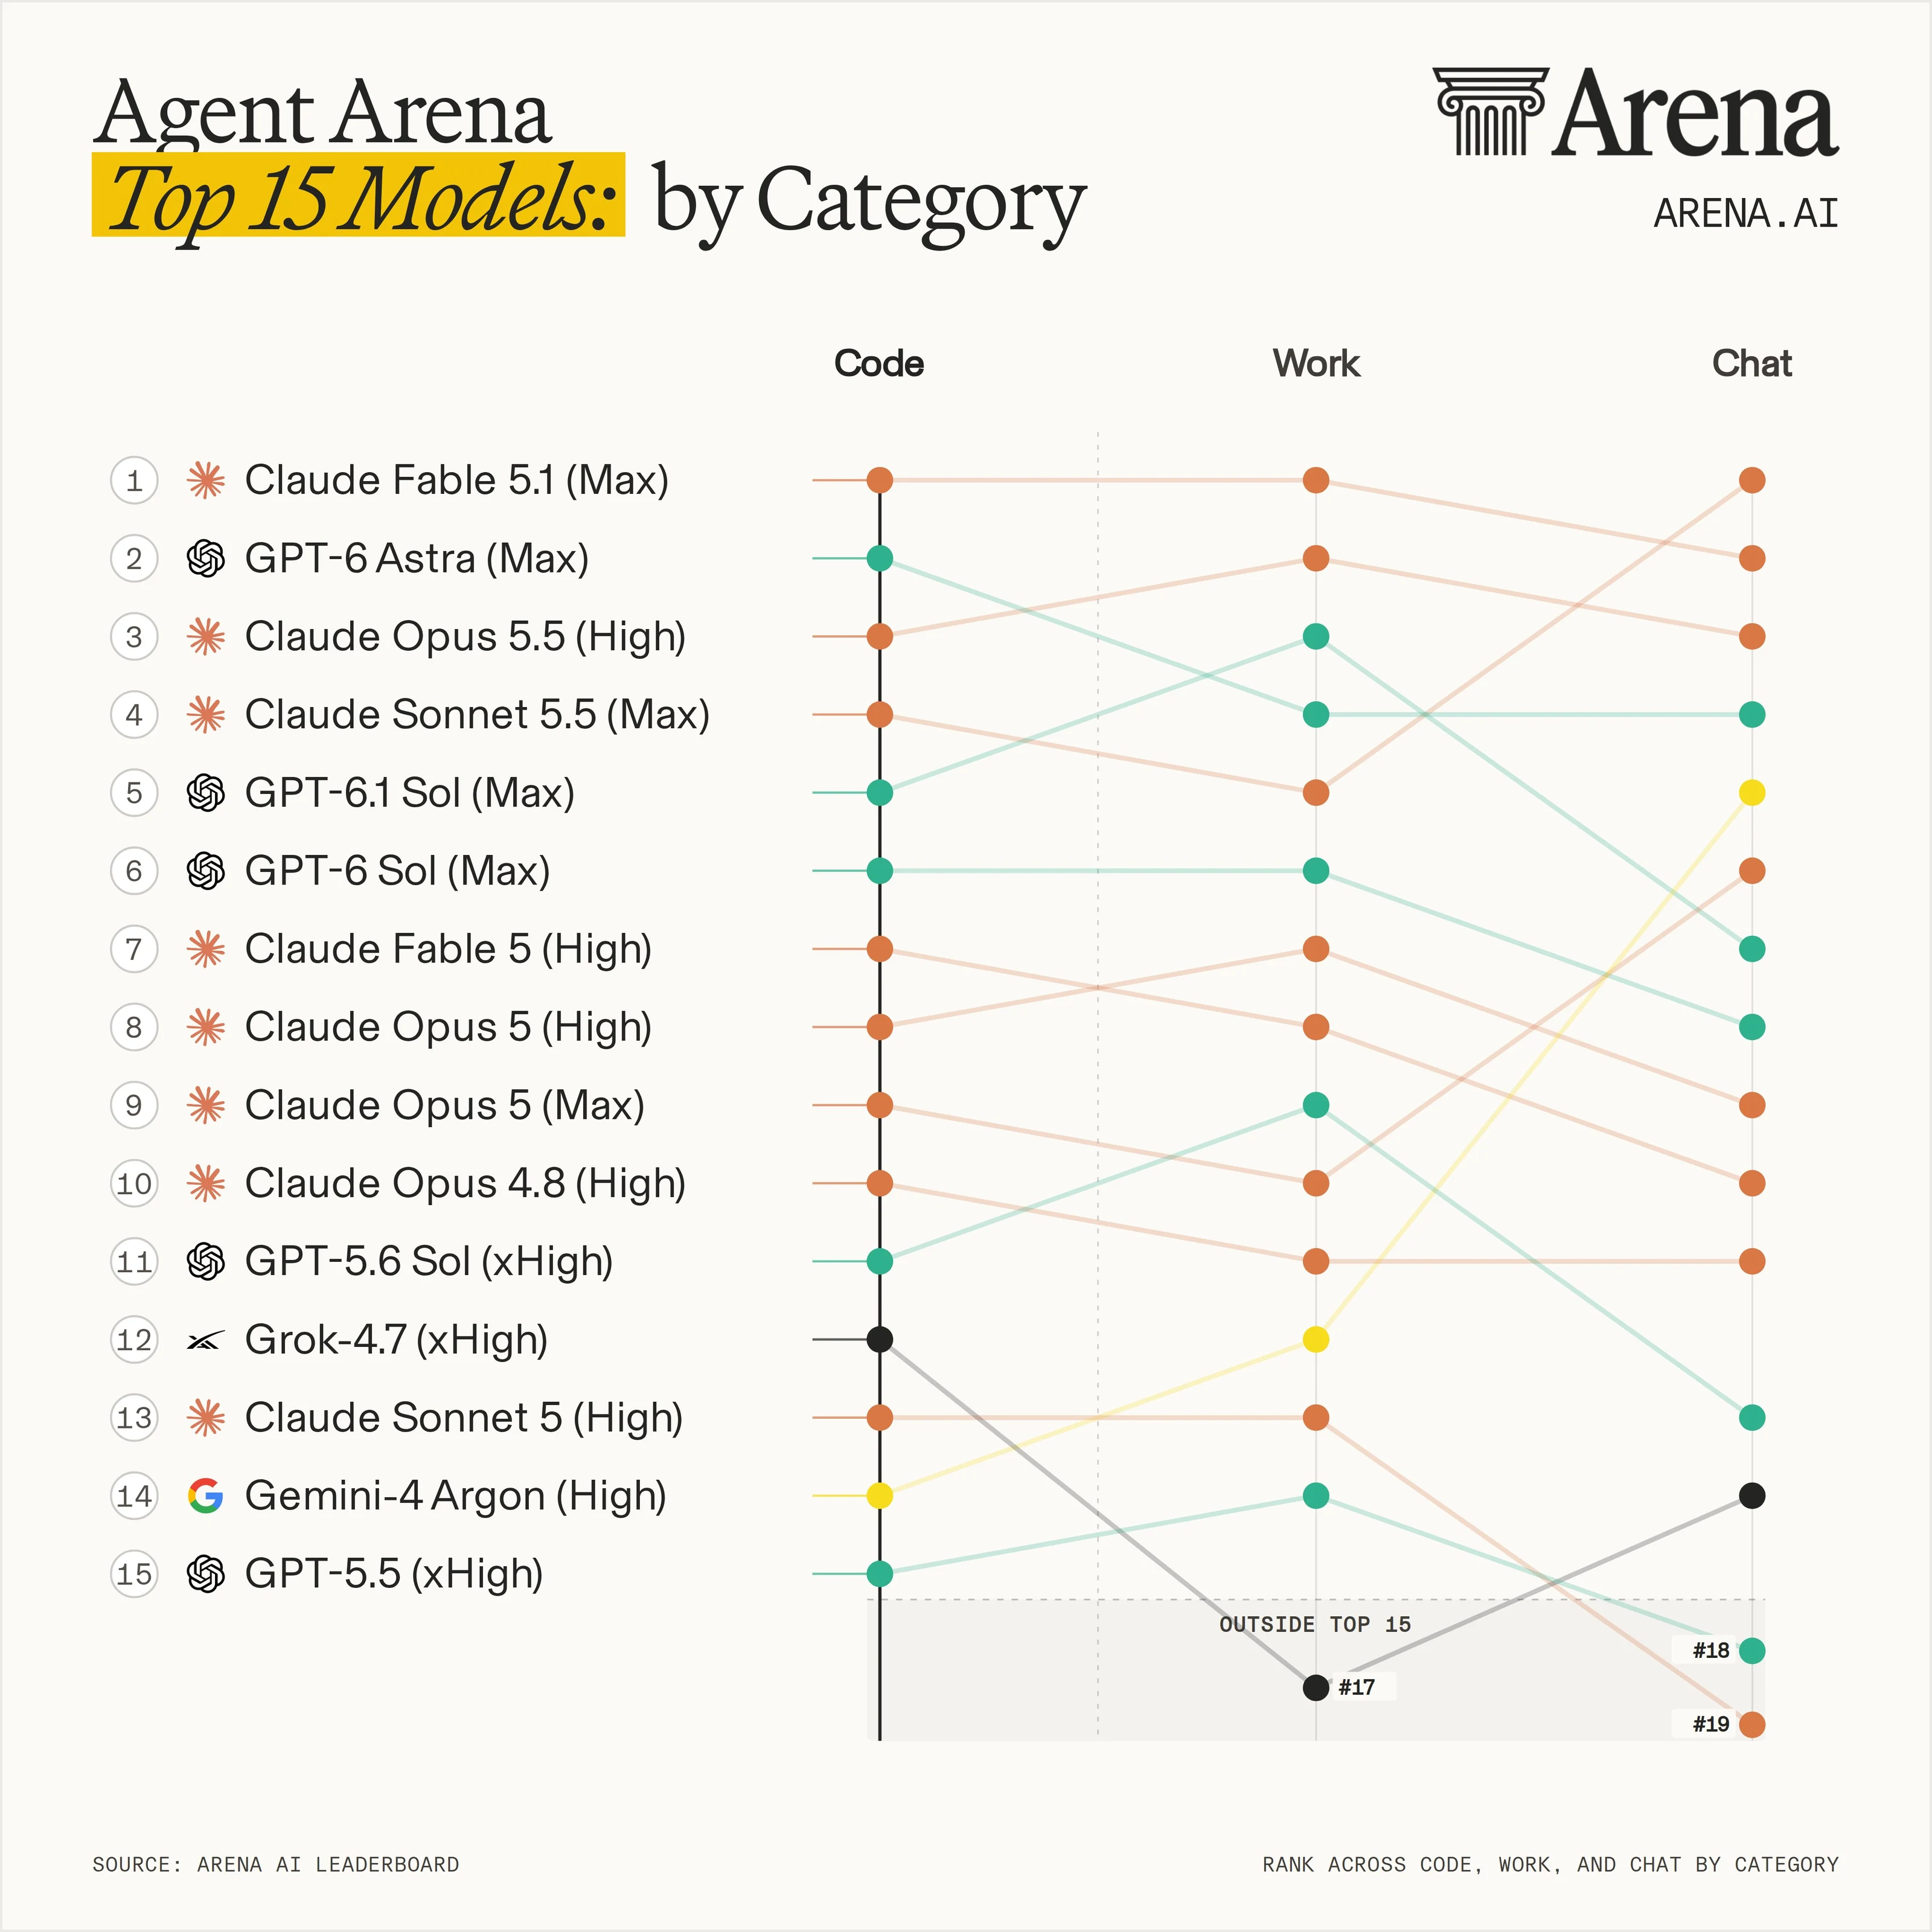
- les modèles d'@AnthropicAI occupent la #1 position en Code, Work et Chat
- GPT 6 Astra (Max) d'@OpenAI reste dans le top quatre des trois catégories : #2 en Code et #4 en Work et Chat
Les modèles de tête restent solides dans toutes les catégories, mais leur ordre change :
- Claude Fable 5.1 (Max) domine à la fois Code et Work et se classe #2 en Chat
- Claude Sonnet 5.5 (Max) domine Chat et se classe #4 en Code et #5 en Work
Les classements en Code et Work évoluent plus ensemble que Chat :
- Gemini 4 Argon (High), par exemple, se classe #14 en Code et #12 en Work mais #5 en Chat, ce qui met en évidence une force distincte dans les tâches d'agents conversationnels
L'Agent Arena classe les modèles en fonction de l'amélioration nette globale par rapport à la frontière actuelle, ainsi que des performances dans des catégories spécifiques de tâches agentiques. Ces classements s'appuient sur des traces en direct collectées auprès d'agents tentant de résoudre des tâches du monde réel soumises par des humains du monde entier.
- Code : écriture et débogage de code, automatisation de flux de travail et analyse de données
- Chat : écriture créative, apprentissage, questions personnelles, recherche quotidienne et génération de médias
- Work : documents, recherche professionnelle, planification et rédaction professionnelle
Ce visuel montre comment les modèles sélectionnés se comparent à travers les catégories de l'Agent Arena au 5 octobre 2026.