
Nous passons rapidement à un environnement informatique caractérisé par des agents autonomes très généraux, de plus en plus autonomes. Animés par de grands modèles de langage (LLM) capables de générer dynamiquement des plans et d’utiliser des outils externes, ces systèmes offrent la possibilité pour l’IA de gérer sans problème des tâches complexes et multi étapes en notre nom. Cependant, la réalisation de ce potentiel nécessite de résoudre un défi clé : permettre aux agents de fonctionner correctement tout en garantissant qu’ils agissent de manière appropriée.
Aujourd’hui, nous partageons un rapport complet sur un nouveau atelier : "Problèmes ouverts et émergents en privécy et sécurité agentique : un point de vue contextual”, résultat d’un effort collaboratif impliquant plus de 50 dirigeants académiques et industriels de diverses institutions. Nous nous sommes rencontrés lors du atelier Google Contextual Agent Privacy and Security (CAPS), qui s’est tenu à la fin de 2025 à New York. Dans ce rapport, vous trouverez une analyse des défis fondamentaux de la privécy et de la sécurité auxquels les agents autonomes sont confrontés aujourd’hui, nécessitant des défenses coordonnées aux niveaux système, modèle, utilisateur et écosystème.
Écarts d’agentivité
Le défi central de l’IA agentique est que, pour qu’un agent soit utile, il peut avoir besoin d’accéder à des données personnelles et de pouvoir entreprendre des actions connexes dans une grande variété de contextes. Cependant, cet accès, combiné avec la flexibilité comportementale des agents, exige des approches significativement différentes de celles utilisées dans les logiciels traditionnels. Contrairement aux logiciels traditionnels déterministes, les agents se distinguent en trois dimensions critiques qui posent des défis que la communauté de recherche doit relever ensemble :
- Interfaces non structurées et ambiguïté des entrées : Les agents traitent les instructions sous forme de langage naturel ou d’images, ce qui rend difficile la définition du « comportement attendu » ou la protection contre des manipulations adverses telles que prompt injection.
- Flots de contrôle probabiliste : La planification générative conduit à des parcours d'exécution probabilistes que les méthodologies de test traditionnelles ne peuvent pas garantir facilement.
- Autonomie et délégation : Lorsque les agents traitent des tâches plus longues et délèguent des sous-tâches à d’autres agents, la supervision traditionnelle du utilisateur devient moins efficace et risque d’être insuffisante, ce qui peut entraîner une « fatigue de confirmation ».
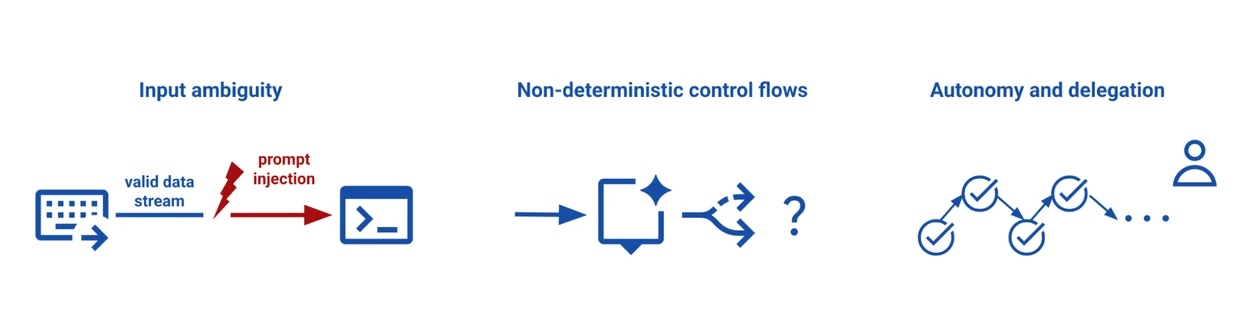
Les défis de confidentialité et de sécurité de l’IA agentique.
Le filtre contextuel
Comme les agents utiles doivent parfois partager des données et accomplir des tâches, nous pensons que l’avenir des agents fiables dépend de leur capacité à raisonner, à comprendre, et à se conformer aux normes sociales ainsi qu’à la pertinence de leurs actions – pour le contexte spécifique dans lequel ils opèrent.
Mais comment pouvons-nous enseigner à un agent à comprendre le « contexte » et l’appropriation ? Notre rapport se base sur la théorie de l’intégrité contextuelle (CI), qui définit la confidentialité non seulement comme le secret ou le contrôle, mais aussi comme « un flux d’informations approprié » selon des normes sociales établies et justifiables. Une norme informationnelle spécifique au contexte est définie par ses acteurs (qui envoient et reçoivent les informations à qui), les types d’informations (catégories spécifiques d’informations, comme les registres médicaux ou financiers) et les principes de transmission (les règles régissant le flux, comme la confidentialité ou la réciprocité). Par exemple, vous pourriez être prêt à partager votre liste de achats de cadeaux avec une assistante virtuelle, mais pas avec vos famille et amis. Notre rapport étend et généralise l’intégrité contextuelle à l’échange d’informations vers la sécurité contextuelle, c’est-à-dire l’appropriation des actions de l’agent. En ancretant la confidentialité et la sécurité de l’agent dans l’intégrité contextuelle, nous explorons comment concevoir des systèmes qui évaluent si une action est socialement et contextuellement appropriée avant son exécution.
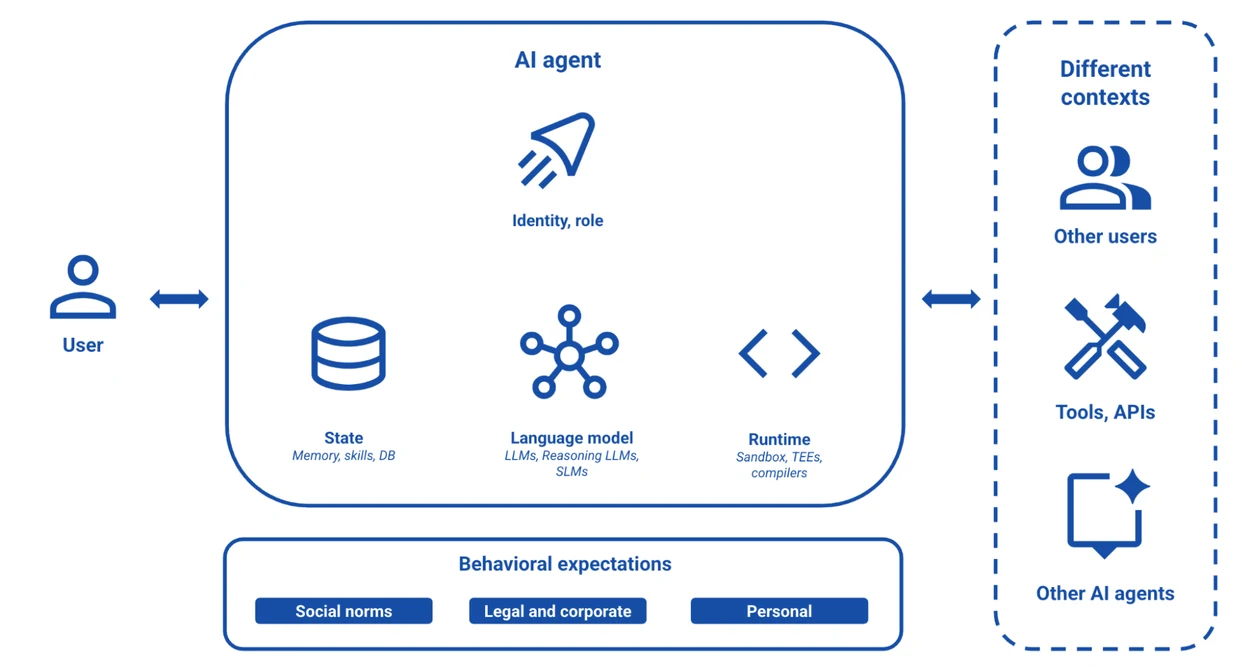
Modèle d’un agent de IA générique interagissant avec d’autres utilisateurs, outils et agents dans différents contextes.
Mise en œuvre de l'intégrité contextuelle
Pour la première fois depuis l’élaboration de la théorie de l’intégrité contextuelle, les LLM offrent une opportunité de créer des politiques lisibles par les machines qui dépendent véritablement du contexte. Historiquement, il y a eu un écart sémantique entre les normes contextuelles de haut niveau et les permissions système de bas niveau. Par exemple, « protéger mes données tout en organisant mes voyages pour une conférence » nécessite des instructions spécifiques sur les informations utilisateur qui doivent être partagées lors de l’achat de vols, de la demande de visas et de la communication avec les organisateurs.
Les méthodes traditionnelles telles que les permissions manuelles ou les politiques rédigées par des experts ne peuvent pas s’adapter à un avenir où les agents IA exécutent de manière autonome de nombreuses tâches complexes et longues. Alors que les modèles de langage commencent à comprendre le CI, nous affirmons que ce fossé peut être comblé. Notre rapport préconise l’ajout d’un moteur de politique contextuelle qui complète les interactions entre modèles et utilisateurs, et qui fait partie d’une couche de supervision permettant de vérifier et de garantir la pertinence des actions. Ce moteur de politique comprend un cycle de génération dynamique de politiques qui peut fonctionner en temps réel (illustré ci-dessous), afin de personnaliser les politiques en fonction des demandes de l’utilisateur et des contextes dynamiques ou ouverts, y compris les nouveaux outils et capacités qui pourraient être découverts en temps réel. Cela permet au système d’évaluer si un flux de données demandé est approprié avant que les informations ne quittent le espace de travail de l’utilisateur.
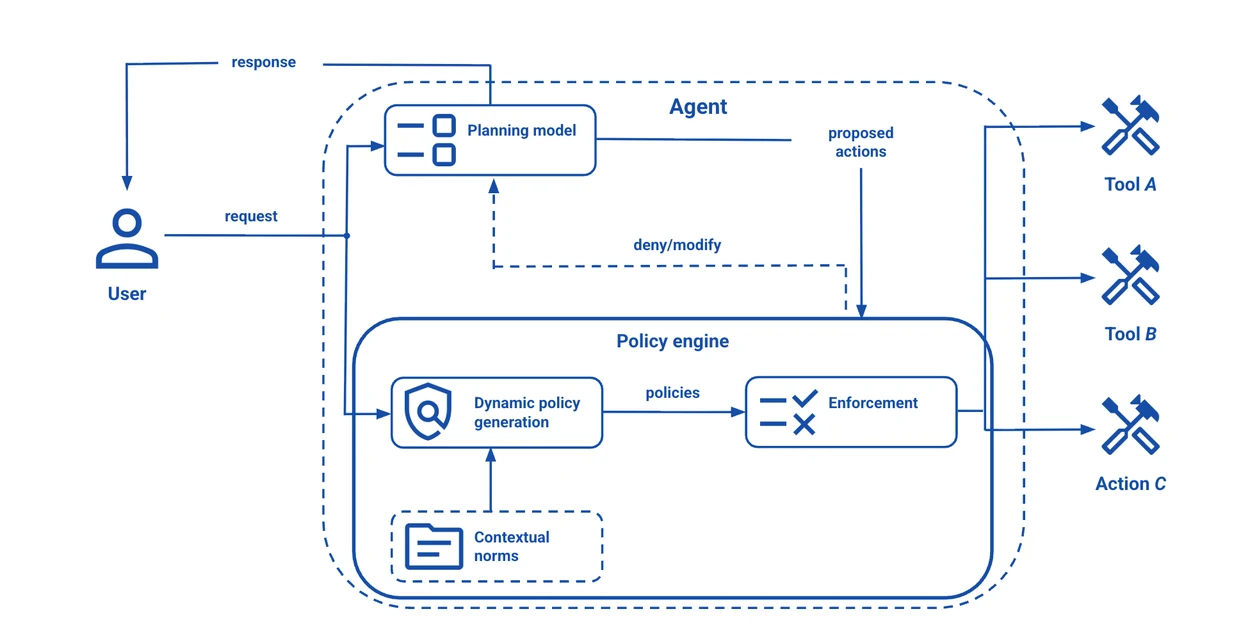
Cet exemple illustratif montre comment une architecture de moteur de politique contextuelle peut être mise en œuvre dans un système agentique.
Approche multi-couches pour la confidentialité et la sécurité agentique
En travaillant sur les moteurs de politique contextuelle en collaboration avec les avancées nécessaires aux niveaux modèle et utilisateur, une approche multi-couches est mise en œuvre. Notre rapport décrit les opportunités d’innovation au sein de l’ensemble du stack.
- Sandboxing au niveau du système : L’environnement d’exécution peut imposer des mesures supplémentaires pour limiter l’impact des échecs de l’agent ou du modèle, et faciliter la détection et la réponse. Les systèmes d’exploitation traditionnels appliquent le sandboxing en limitant statiquement l’accès, par exemple aux fichiers ou aux réseaux. Pour les agents, nous explorons la limitation dynamique des capacités de l’agent, l’établissement de son identité, et l’autorisation ou le retrait d’accès aux données en fonction des changements du contexte.
- Réflexion au niveau du modèle : Un agent exécutant des tâches complexes doit juger de l’adéquation de ses actions, comme la partage des données utilisateur. Les recherches futures devraient permettre aux modèles de déterminer les ambiguïtés liées aux prompts peu spécifiés par l’utilisateur et de raisonner sur l’adéquation en fonction des normes contextuelles évolutives.
- Contrôles centrés sur l’utilisateur : Le cadre traditionnel « Avis et choix » suppose que les individus peuvent prendre des décisions détaillées concernant les actions qui affectent les données personnelles, en s’appuyant sur l’hypothèse de la prévisibilité. Cependant, le comportement des agents autonomes est intrinsèquement probabiliste, à grande échelle et génératif. Nous explorons l’évolution des interfaces vers des mécanismes de contrôle dynamiques, contextuels et personnalisés, en accord avec les modèles mentaux des utilisateurs.
- Interactions de multiples agents : Afin que les agents d’IA puissent collaborer en toute sécurité sur des tâches complexes, il est nécessaire de développer des barrières efficaces pour empêcher les agents de collaborer entre eux et de violer les normes contextuelles.
- Gouvernance de l’écosystème : Nous explorons les défis liés aux mécanismes de gouvernance afin d’établir une série de normes contextuelles qui sont collectées et partagées entre les agents. De plus, comme les normes peuvent varier selon les domaines et les entités, nous avons besoin de mécanismes permettant de résoudre les conflits, négocier les changements de norme et vérifier le respect des règles.
Mesurer la confidentialité et la sécurité de manière dynamique
Enfin, nous proposons le développement de nouvelles approches pour les évaluations de sécurité qui s’appliquent plus directement aux systèmes hautement autonomes à plusieurs agents. Notre rapport souligne la nécessité de normes standardisées pour les benchmarks multi-agents – des environnements dynamiques « Agent Gym » où les chercheurs peuvent simuler en toute sécurité des interactions complexes et en cascade pendant des périodes prolongées. Avec ces sandboxes open-source, nous pouvons établir une base solide, partagée en matière de confidentialité, de sécurité et de sécurité à l’échelle académique et industrielle.
Une action à entreprendre
C’est un projet ambitieux, mais créer un écosystème agentique sûr, fiable et de confiance est une tâche trop importante pour toute discipline, organisation ou secteur isolé. En appelant à de nouvelles idées et à des collaborations sans précédent, le rapport expose des opportunités fondamentales ; il constitue un appel à l’action pour la communauté de la recherche dans tous les domaines – université, gouvernement, société civile et industrie – afin de développer les bases nécessaires pour un écosystème sûr, fiable et respectueux de la vie privée. Nous vous invitons à lire le rapport technique.
Remerciements
Nous tenons à remercier Lillian Tsai pour avoir été co-auteure principale, et Sarah de Haas pour avoir coordonné le atelier, la rédaction du rapport et les articles sur le blog. Kassem Fawaz, Stefan Mellem, Helen Nissenbaum et Nina Taft ont contribué à la conceptualisation, à la rédaction des différentes sections, et ont guidé le processus de rédaction. Sebastian Benthall, Madiha Zahrah Choksi, Seliem El-Sayed, Ferdinando Fioretto, Adrià Gascón, Ashish Hooda, Ivan Petrov, Francesco Pinto, Octavian Suciu, Trishita Tiwari, Harold Triedman, Ren Yi et Wen Zhang ont été les responsables de chaque section. Nous sommes reconnaissants envers plus de 50 chercheurs, partenaires académiques et dirigeants industriels qui ont co-écrit le rapport ou participé aux discussions du atelier. Ce travail a été soutenu par Daniel Ramage, Corinna Cortes, Yossi Matias, Pushmeet Kohli, Hank Levy, Raluca Ada Popa, Amanda Walker, Brendan McMahan et James Manyika.