
Le codage et les tâches agentiques exigent davantage des modèles d’IA que jamais : refactoriser un repository comprenant des centaines de fichiers, maintenir un workflow agentique de plusieurs heures sans perdre le contexte, et raisonner sur des problèmes complexes de systèmes en utilisant des outils à chaque étape. Pour répondre à ces exigences avec des modèles ouverts, il a historiquement fallu mettre en place et gérer sa propre infrastructure d’inférence.
GLM 5.3 de Z.ai (Zhipu AI) est désormais disponible sur Amazon Bedrock. GLM 5.3, publié sur Hugging Face Hub, est un modèle de mix de experts à 753B de paramètres optimisé pour le codage et les tâches agentiques à long terme. En particulier, Z.ai a rapporté que le modèle présente des capacités notables en cybersécurité. Sur Amazon Bedrock, vous pouvez l’utiliser via des APIs entièrement gérées, avec inférence interrégionnelle, stockage en cache des prompts et différents niveaux de services. Vous n’avez pas à gérer d’infrastructure. L’accès au GLM 5.3 sur Bedrock est disponible pour les clients d’entreprise éligibles.
Dans cet article, nous vous montrons comment exécuter GLM 5.3 sur Amazon Bedrock en utilisant les API compatibles avec OpenAI, et réduire les coûts et les temps de latence grâce au stockage en cache des prompts. Nous mettons ensuite le modèle en action dans un flux de travail agentique réaliste : exécuter une vérification de sécurité autorisée de votre application avec Strix, un agent d’essai de pénétration d’IA open-source.
Quels sont les nouveaux éléments par rapport au GLM 5
GLM 5 est arrivé sur Amazon Bedrock au début de cette année. GLM 5.3 s’appuie sur la même lignée, avec une série d’améliorations importantes :
- Code plus robuste : Z.ai affirme des performances compétitives sur une gamme de benchmarks de codage, incluant DeepSWE, Terminal Bench 3.0 et FrontierSWE. Ils rapportent également une amélioration de 50 % par rapport à GLM 5.2 dans leur propre benchmark de codage interne. Aucune comparaison directe avec GLM 5 n’a été rapportée, car l’ampleur des améliorations a nécessité la mise à jour des tests de benchmark eux-mêmes depuis l’annonce GLM 5.1.
- Capacités de cybersécurité émergentes : Les performances rapportées dans les tests de sécurité se distinguent, ce qui fait que le modèle convient naturellement aux processus de sécurité défensifs. Par exemple, Z.ai a mesuré un score élevé de 84,5 sur le benchmark CyberGym au moment de la sortie.
- Intégration plus large de Amazon Bedrock : Profils d’inférence interrégionaux, mise en cache implicite et explicite des prompts, et parité améliorée des fonctionnalités des API de Responses et de Chat Completions compatibles avec OpenAI, ainsi que d’Invoke et de Converse.
Capacités clés
- Programmation Frontier et performances agentiques. GLM 5.3 est conçu pour l’ingénierie de systèmes complexes et les tâches agentiques à long terme. Ces tâches comprennent le raisonnement multiétapes, les workflows enrichis par des outils, ainsi que le maintien d’un contexte cohérent au sein de grandes bases de code.
- Accès flexible à l’API. Vous pouvez invoquer GLM 5.3 via les APIs de réponses et de complétions de conversation compatibles avec OpenAI, ou via les APIs Amazon Bedrock Invoke et Converse.
- Stockage du prompt. GLM 5.3 prend en charge par défaut le stockage implicite (automatique) des prompts, ainsi que des contrôles de cache explicites (recommandés) pour les APIs Responses et Chat Completions. Pour les tâches agentiques où des prompts système importants ou le contexte du répertoire sont renvoyés à chaque tour, le stockage réduit à la fois la latence et les coûts d’entrée.
- Inference interrégionnelle. GLM 5.3 est disponible via les profils d’inference interrégionnelle aux États-Unis (
us.zai.glm-5.3) et au niveau mondial (global.zai.glm-5.3). Vous envoyez des demandes vers la région AWS « source » de votre choix, et Amazon Bedrock route sécurisément chaque demande pour son traitement. Pour plus de détails, veuillez vous référer à la Guilde d’utilisateurs Amazon Bedrock. - Niveaux de service. Choisissez Flex pour optimiser les coûts pour les tâches peu sensibles au temps, Priorité pour privilégier les requêtes ayant une importance critique en termes de latence en contrepartie d’un prix plus élevé, ou Standard pour un équilibre par défaut entre prix et vitesse.
Prérequis
Pour les exemples d'utilisation suivants, vous avez besoin de :
- Un compte AWS avec accès à Amazon Bedrock.
- AWS Identity and Access Management (IAM) permissions pour appeler le modèle de base et le profil d’inférence cible :
bedrock:InvokeModel,bedrock:InvokeModelWithResponseStreametbedrock:CallWithBearerToken. - (Pour les démos basées sur du code) Python 3.10 ou ultérieure.
- (Seulement pour la démo de test de sécurité optionnelle) installer Docker et Strix avec l’extension bedrock.
Essaie GLM 5.3 sur la console Amazon Bedrock
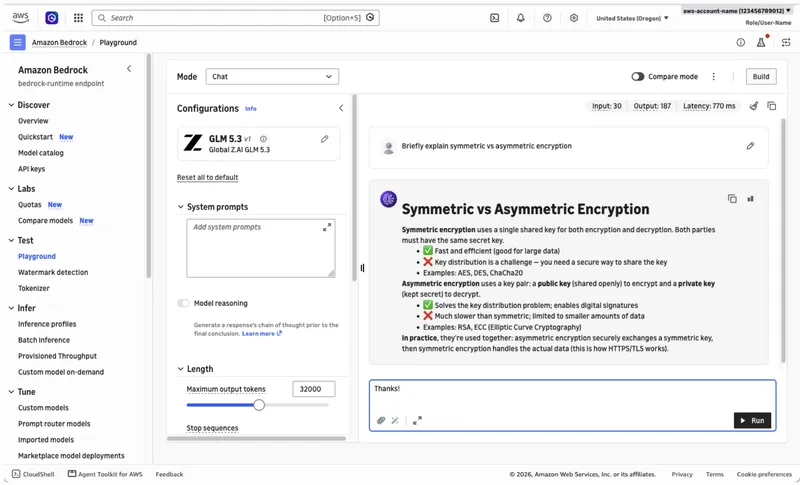
Vous pouvez commencer à envoyer des prompts à GLM 5.3 via le Consoles de gestion AWS, sans avoir besoin d’écrire de code ou d’installer des outils de développement. Pour commencer, naviguez vers Amazon Bedrock et choisissez Test > Playground dans le menu latéral gauche.
D’ici l’interface de jeu, vous pouvez sélectionner GLM 5.3 dans la liste de modèles et envoyer vos premiers prompts via l’interface de chat, comme montré dans l’image suivante :
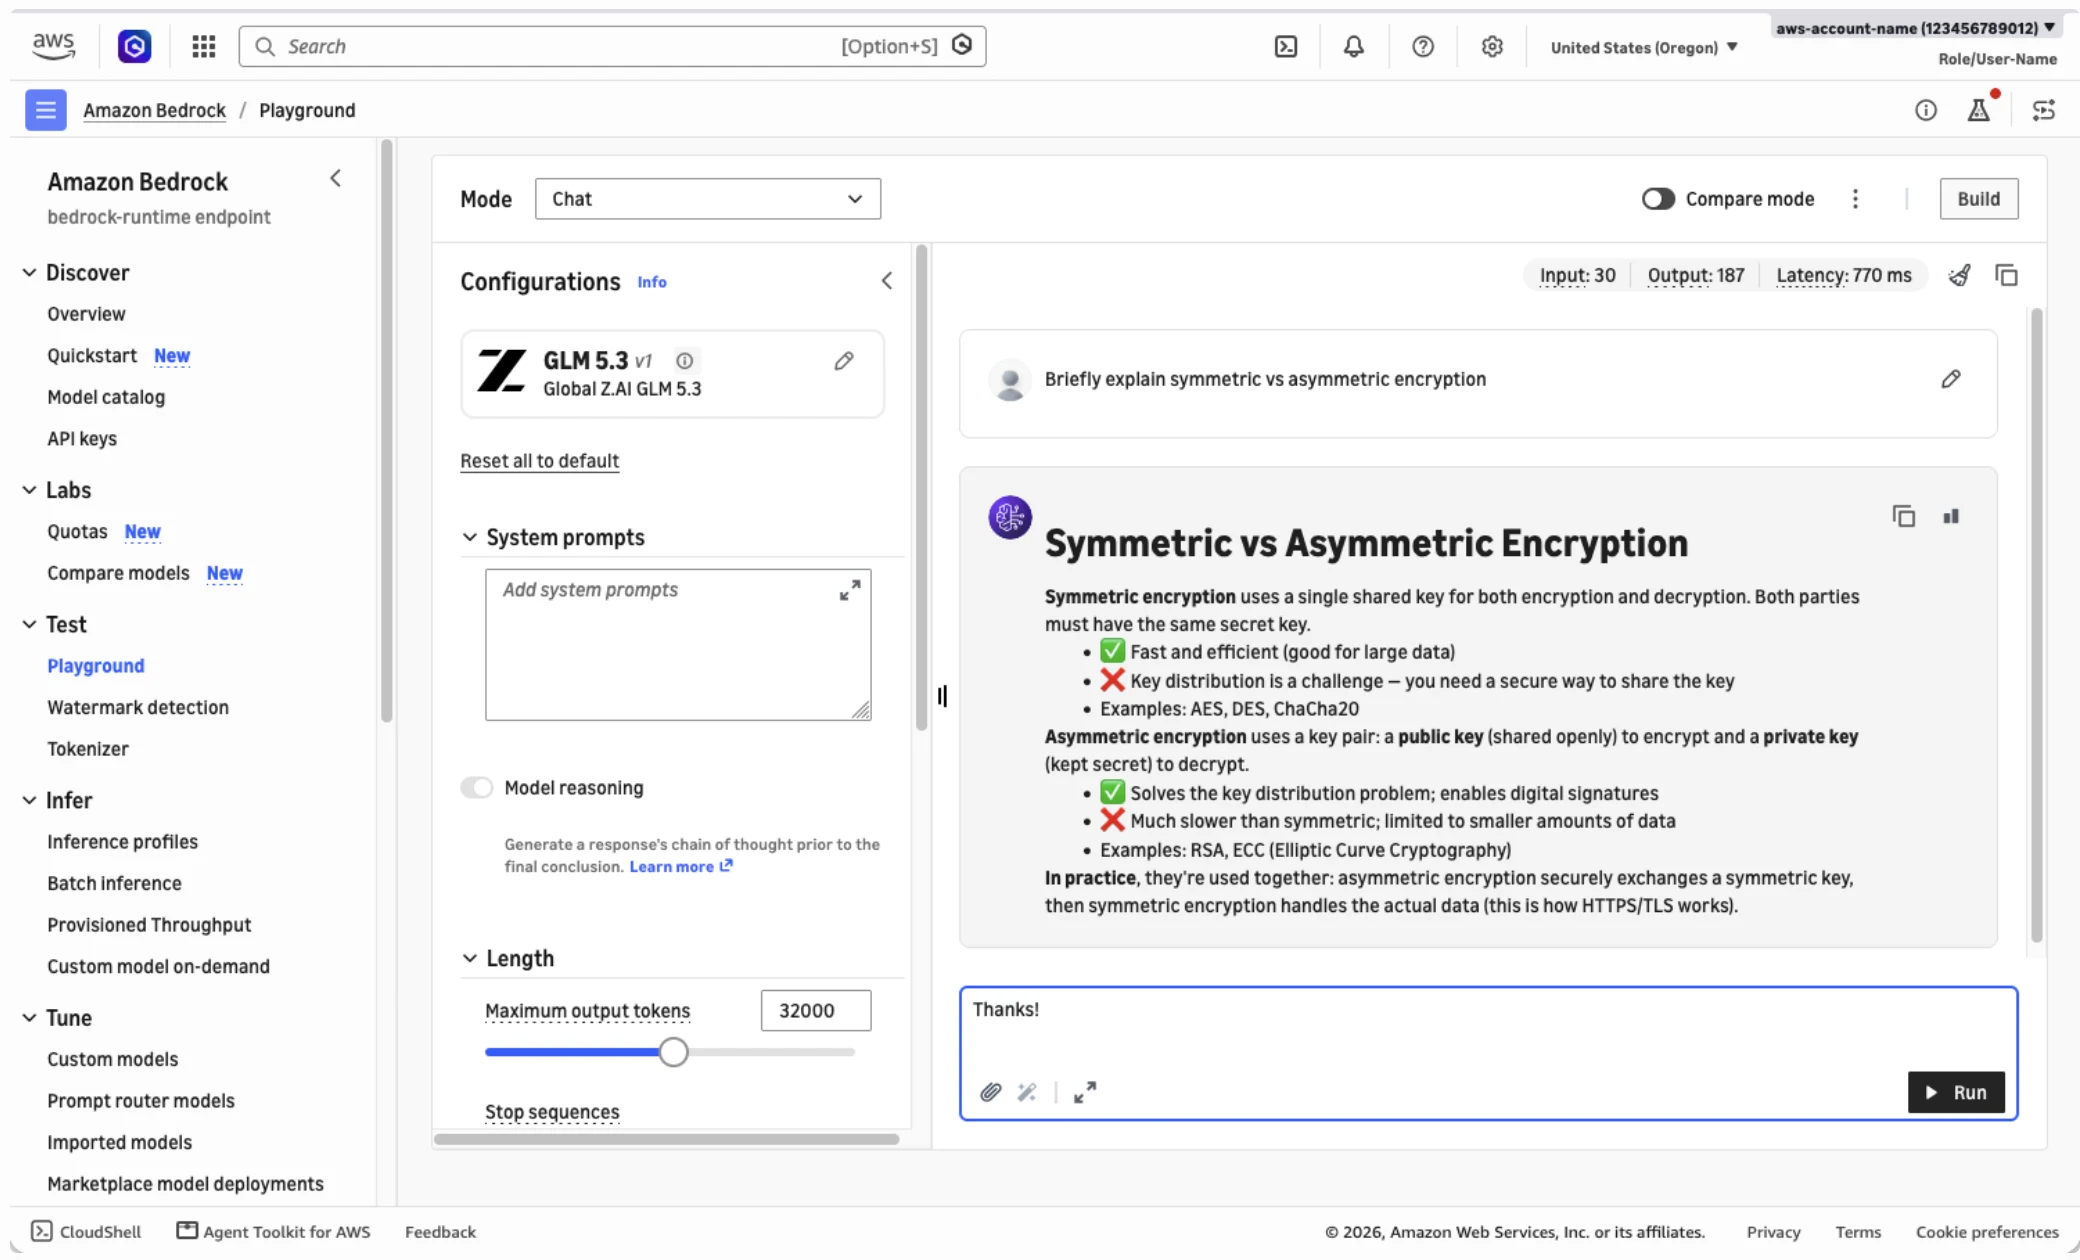
Figure 1 : Conversation avec GLM 5.3 sur la console Amazon Bedrock
Commencez avec l’API de réponses
De manière programmatique, vous pouvez appeler le modèle via l’endpoint bedrock-runtime. Cela prend en charge les API Responses et Chat Completions compatibles avec OpenAI, ainsi que les API Amazon Bedrock Invoke et Converse pour GLM 5.3. Pour les nouvelles applications, il est recommandé d’utiliser les API compatibles avec OpenAI, car elles offrent un ensemble de fonctionnalités plus complet.
Amazon Bedrock prend en charge la génération de clés API pour les intégrations compatibles avec OpenAI qui en nécessitent. Cependant, nous recommandons fortement d’utiliser des identifiants de durée courte plutôt que des clés API de longue durée lorsque possible.
Dans l’exemple suivant, nous utiliserons l’API Responses depuis Python en utilisant le SDK Python d’OpenAI, ainsi que la bibliothèque aws-bedrock-token-generator pour générer des tokens de courte durée à partir de vos identifiants standard de AWS CLI.
- Installer les packages nécessaires.
pip install -U openai aws-bedrock-token-generator - Enregistrez le code suivant dans
bedrock-request.py.from aws_bedrock_token_generator import provide_token from openai import OpenAI region = "us-west-2" # Your source AWS Region client = OpenAI( api_key=provide_token(region=region), base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1", ) resp = client.responses.create( input="Refactor this Python function to be iterative instead of recursive: ...", model="global.zai.glm-5.3", ) print(resp.output_text) - Exécutez le script, qui affichera les résultats du modèle.
python bedrock-request.py
Optimiser l'inference avec un stockage explicite du prompt
Les processus de codage et de gestion des connaissances à longue durée réexpédient souvent un contexte stable au cours de plusieurs échanges de conversation, tels que les messages du système, les définitions d’outils ou les fichiers du répertoire.
GLM 5.3 sur Amazon Bedrock prend en charge le stockage caché des prompts par défaut, ce qui permet de réduire la latence de réponse et les coûts de tokens d’entrée pour les appels répétés utilisant le même préfixe de prompt initial.
Avec le mode caching explicite des prompts, vous identifiez spécifiquement les préfixes de prompts réutilisables, ce qui peut améliorer davantage le taux d’accès au cache (et par conséquent la latence et l’économie de coûts) par rapport au caching implicite.
Pour utiliser le stockage du prompt explicite avec GLM 5.3, comme montré dans l'exemple suivant :
- Sélectionnez le mode de stockage cache explicite via
prompt_cache_optionssur votre demande. - Ajoutez une ou plusieurs balises
prompt_cache_breakpointsur les blocs de contenu d’entrée pour indiquer la fin (incluse) des préfixes de prompts réutilisables. Chaque point de rupture doit contenir au moins 1 024 tokens pour être éligible à l’encodage en cache.
resp = client.responses.create(
    model="global.zai.glm-5.3",
    # Enable explicit caching mode:
    extra_body={"prompt_cache_options": {"mode": "explicit"}},
    input=[
        {
            "type": "message",
            "role": "system",
            "content": [
                {
                    "type": "input_text",
                    "text": SYSTEM_PROMPT,
                    # A long, static system prompt is a great target for caching:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ]
        },
        {
            "type": "message",
            "role": "user",
            "content": [
                {
                    "type": "input_text",
                    "text": USER_INPUT,
                    # Multiple breakpoints can also be defined, for layered cache:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ],
        },
    ],
)

if resp.usage.input_tokens_details.cached_tokens:
    print("Hit cache!")
Pour plus d'informations, veuillez vous référer à la section cachement des prompts de la Documentation utilisateur Amazon Bedrock.
Exemple de charge de travail agentique : Tests de sécurité autorisés avec Strix
Un travail qui bénéficie directement des avantages de GLM 5.3 est le test de sécurité automatisé de vos propres applications. Strix est un agent d’essai de pénétration d’IA open-source qui exécute votre code de manière dynamique, détecte les vulnérabilités et les valide avec des tests de preuve de concept. À l’heure actuelle, la documentation de Strix utilise GLM 5.3 comme modèle par défaut. Vous pouvez configurer Strix pour qu’il utilise GLM 5.3 sur Amazon Bedrock plutôt qu’un fournisseur d’inférence tiers, de sorte que l’inférence du modèle se déroule sous le contrôle de votre compte AWS.
Veuillez tester uniquement les applications que vous possédez ou sur lesquelles vous avez une autorisation écrite explicite. Tester de manière non autorisée la sécurité des systèmes qui ne vous appartiennent pas est illégal dans la plupart des juridictions et viole la Politique d’utilisation acceptable d’AWS. Dans cette démonstration, l’objet cible est OWASP Juice Shop, une application de exemple intentionnellement vulnérable exécutée localement sur votre machine.
Si vous souhaitez des tests de sécurité continus et entièrement gérés, en plus de gérer vous-même les agents open-source, AWS Continuum offre des tests d’intrusion sur demande et autres analyses de sécurité en tant que service géré. Ces deux approches sont complémentaires : les agents open-source comme Strix vous permettent des tests personnalisables, guidés par le développeur, dans le flux de production, tandis que AWS Continuum effectue des évaluations gérées à grande échelle.
Pour exécuter une vérification de sécurité autorisée
- Commencez l’exemple de l’application cible Juice Shop localement.
docker run --rm -p 3000:3000 bkimminich/juice-shop - Configurer Strix pour utiliser GLM 5.3 sur Amazon Bedrock. Strix utilise en arrière-plan LiteLLM, de sorte que (comme indiqué dans leur documentation pour Amazon Bedrock) vos identifiants AWS CLI seront pris en charge automatiquement. Cela signifie qu’il n’est pas nécessaire d’utiliser une clé API, mais vous pouvez définir des variables d’environnement telles que
AWS_PROFILEetAWS_REGIONpour configurer votre connexion. À l’heure de la rédaction de ce texte, LiteLLM ne résout pas encorebedrock/global.zai.glm-5.3. Jusqu’à ce que cela soit corrigé, vous pouvez spécifier explicitement la route Converse API et le profil d’inférence Amazon Resource Name (ARN), comme montré dans le fragment suivant :# Fill in the REGION and ACCOUNT_ID placeholders below before running! export STRIX_LLM="bedrock/converse/arn:aws:bedrock:{AWS_REGION}:{AWS_ACCOUNT_ID}:inference-profile/global.zai.glm-5.3" - Exécuter Strix contre l’objet local.
strix --target http://localhost:3000 - Attendez que l’agent Strix racine soit terminé, puis examinez les résultats.
Strix crée une équipe de sous-agents pour cartographier la surface de menace, explorer une gamme de catégories potentielles de vulnérabilités, et tenter de valider chaque constat à l’aide d’un prototype fonctionnel. Cela permet de réduire le temps consacré à la triage des faux positifs. Une exécution réussie génère un rapport indiquant la gravité, les preuves et les conseils de correction pour chaque constat.
Le vidéo suivante montre le parcours complet de configuration et d’exécution de Strix par rapport à l’application d’exemple, ainsi que l’exploration des résultats :
Figure 2 : Exécution d’un exemple de test de sécurité avec GLM 5.3 et Strix
Nettoyer
Arrêtez le conteneur de la boutique de jus Ctrl+C dans le terminal où il est exécuté, ou exécutez docker ps Pour trouver l’ID du conteneur et l’arrêter docker stop <container-id>. L’inference Amazon Bedrock est payante par token, sans ressources persistantes, donc aucun coût supplémentaire n’est facturé après que les demandes ont été traitées. Si vous avez généré une clé API Amazon Bedrock pour cette démonstration et ne l’avez plus besoin, supprimez-la dans la console Amazon Bedrock.
Disponibilité
Tester GLM 5.3 dans la console Amazon Bedrock, l’utiliser via des assistants de codage tels que OpenCode, comme indiqué dans notre article récent avec Kimi K3, ou connecter vos applications personnalisées via les API supportées.
Intéressé par la manière dont Amazon Bedrock peut soutenir votre équipe ? Connectez-vous à nous pour commencer la conversation.