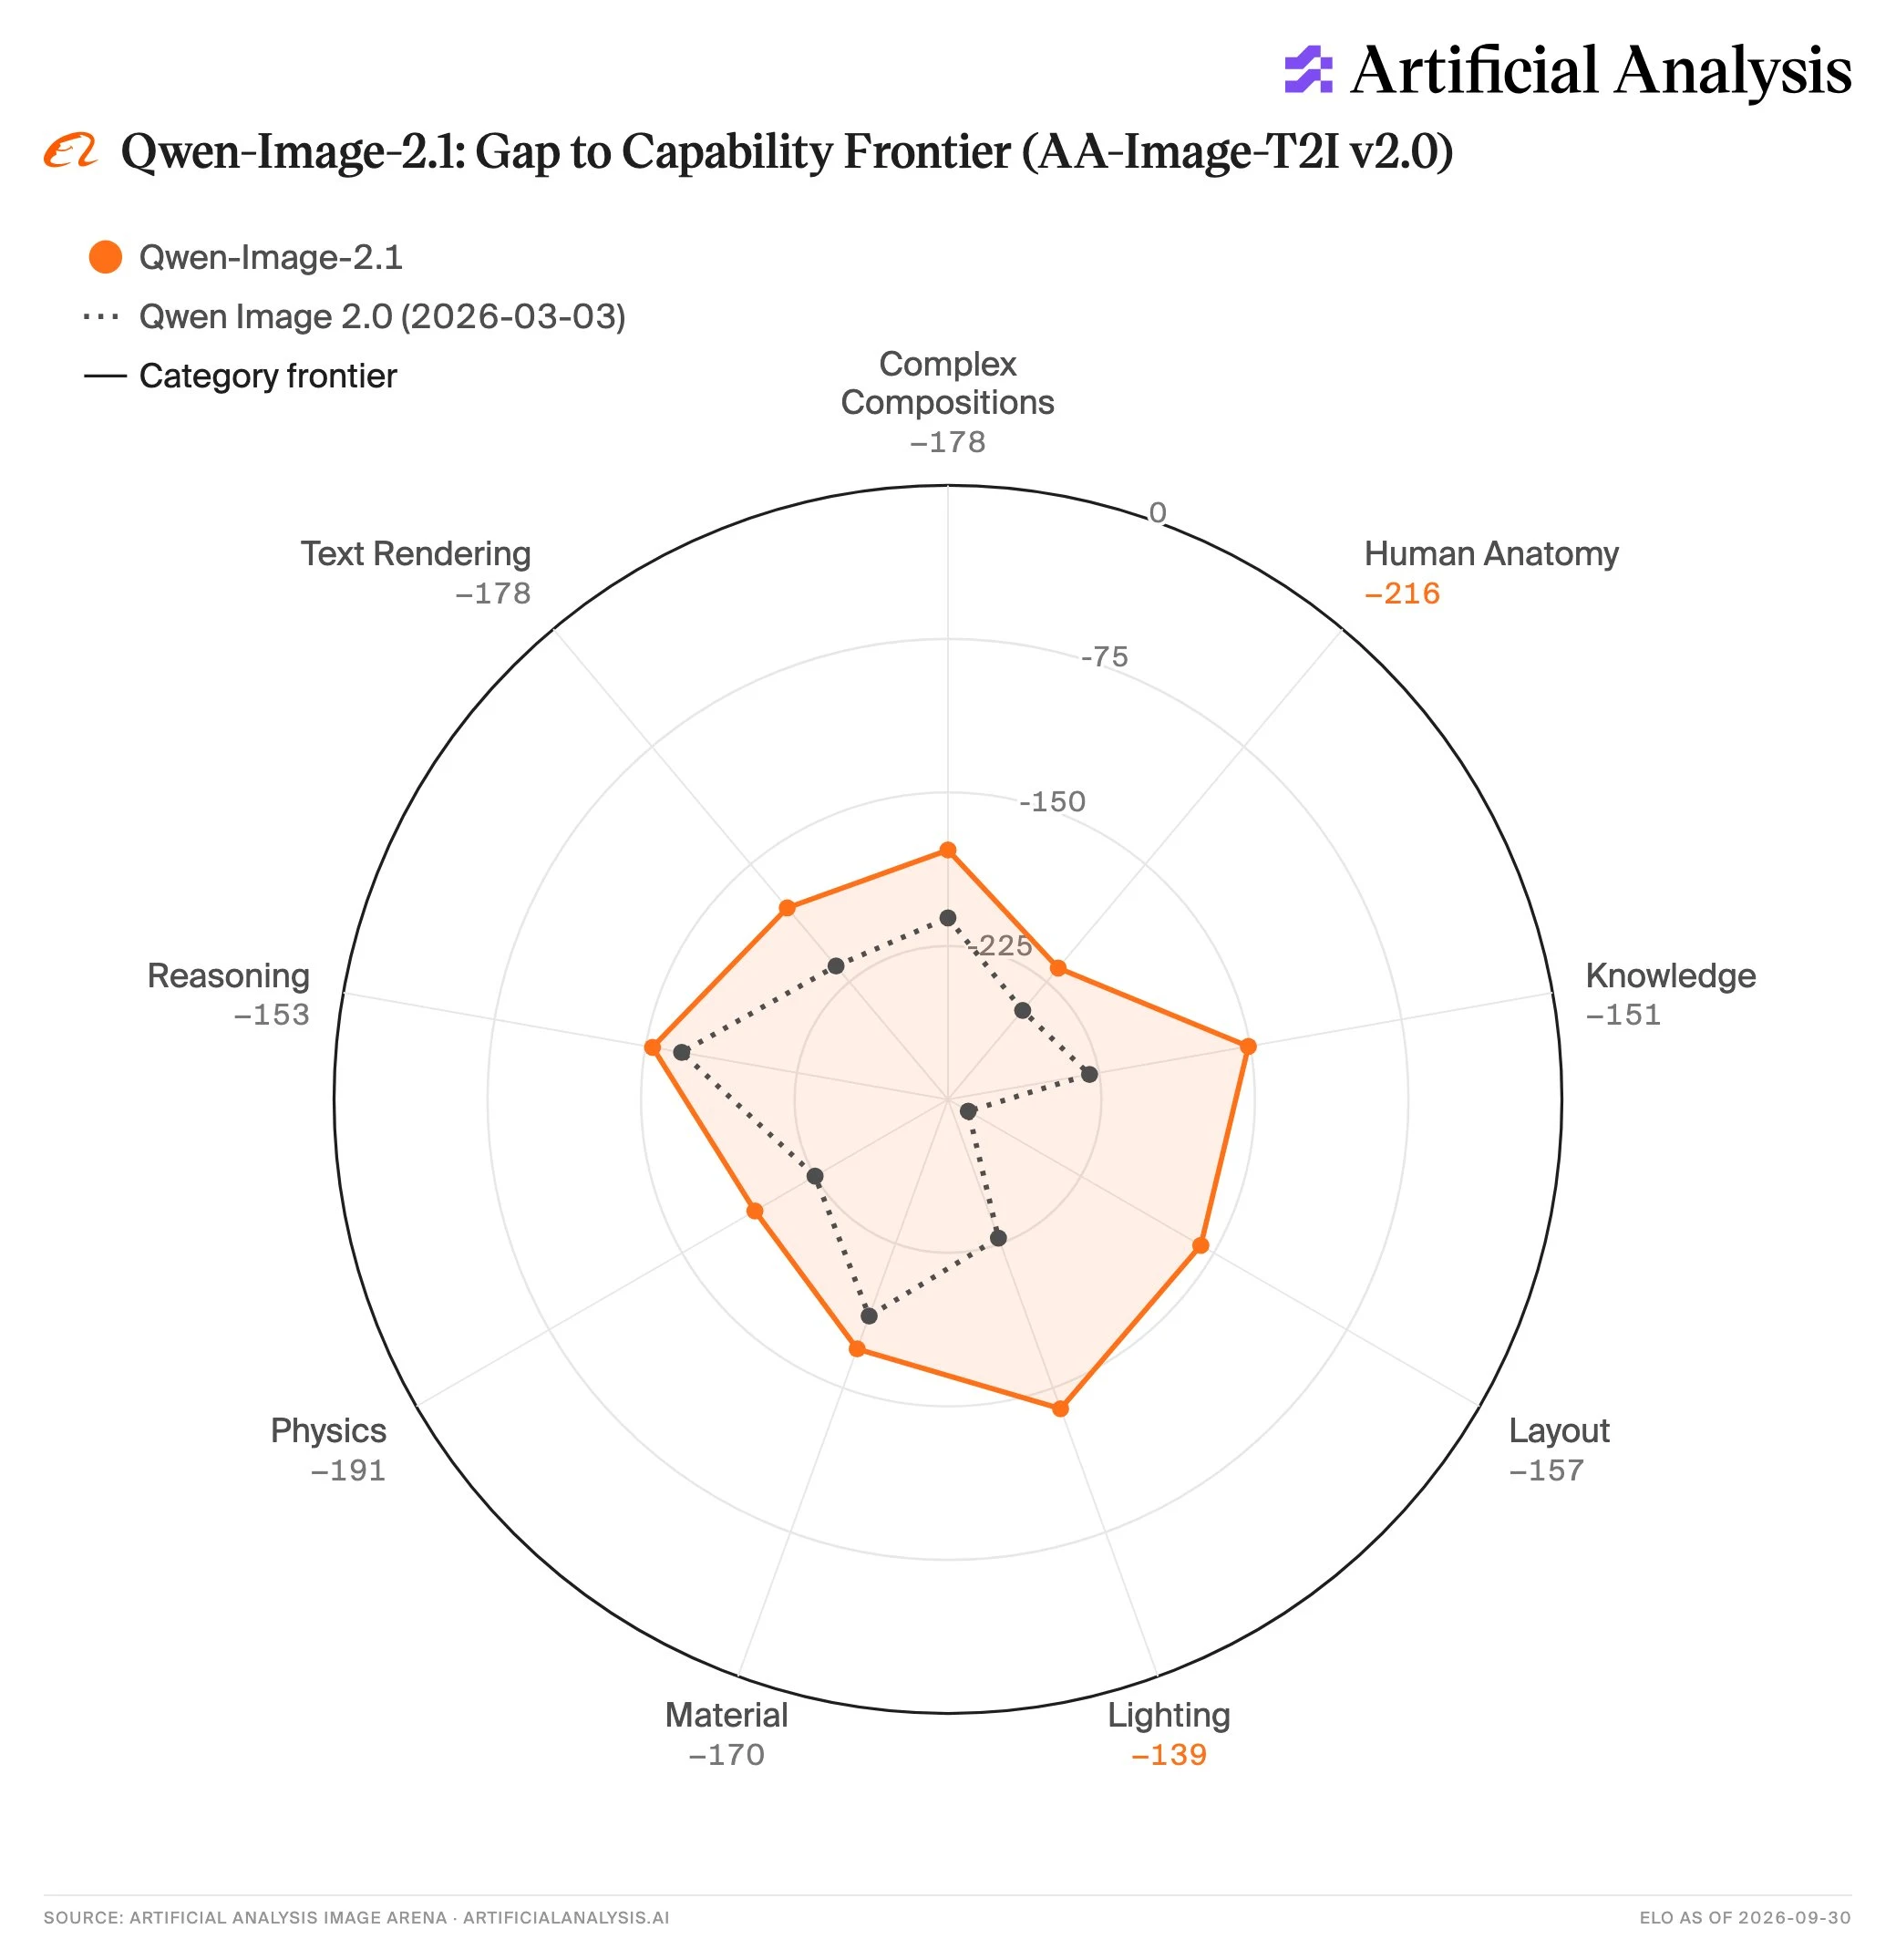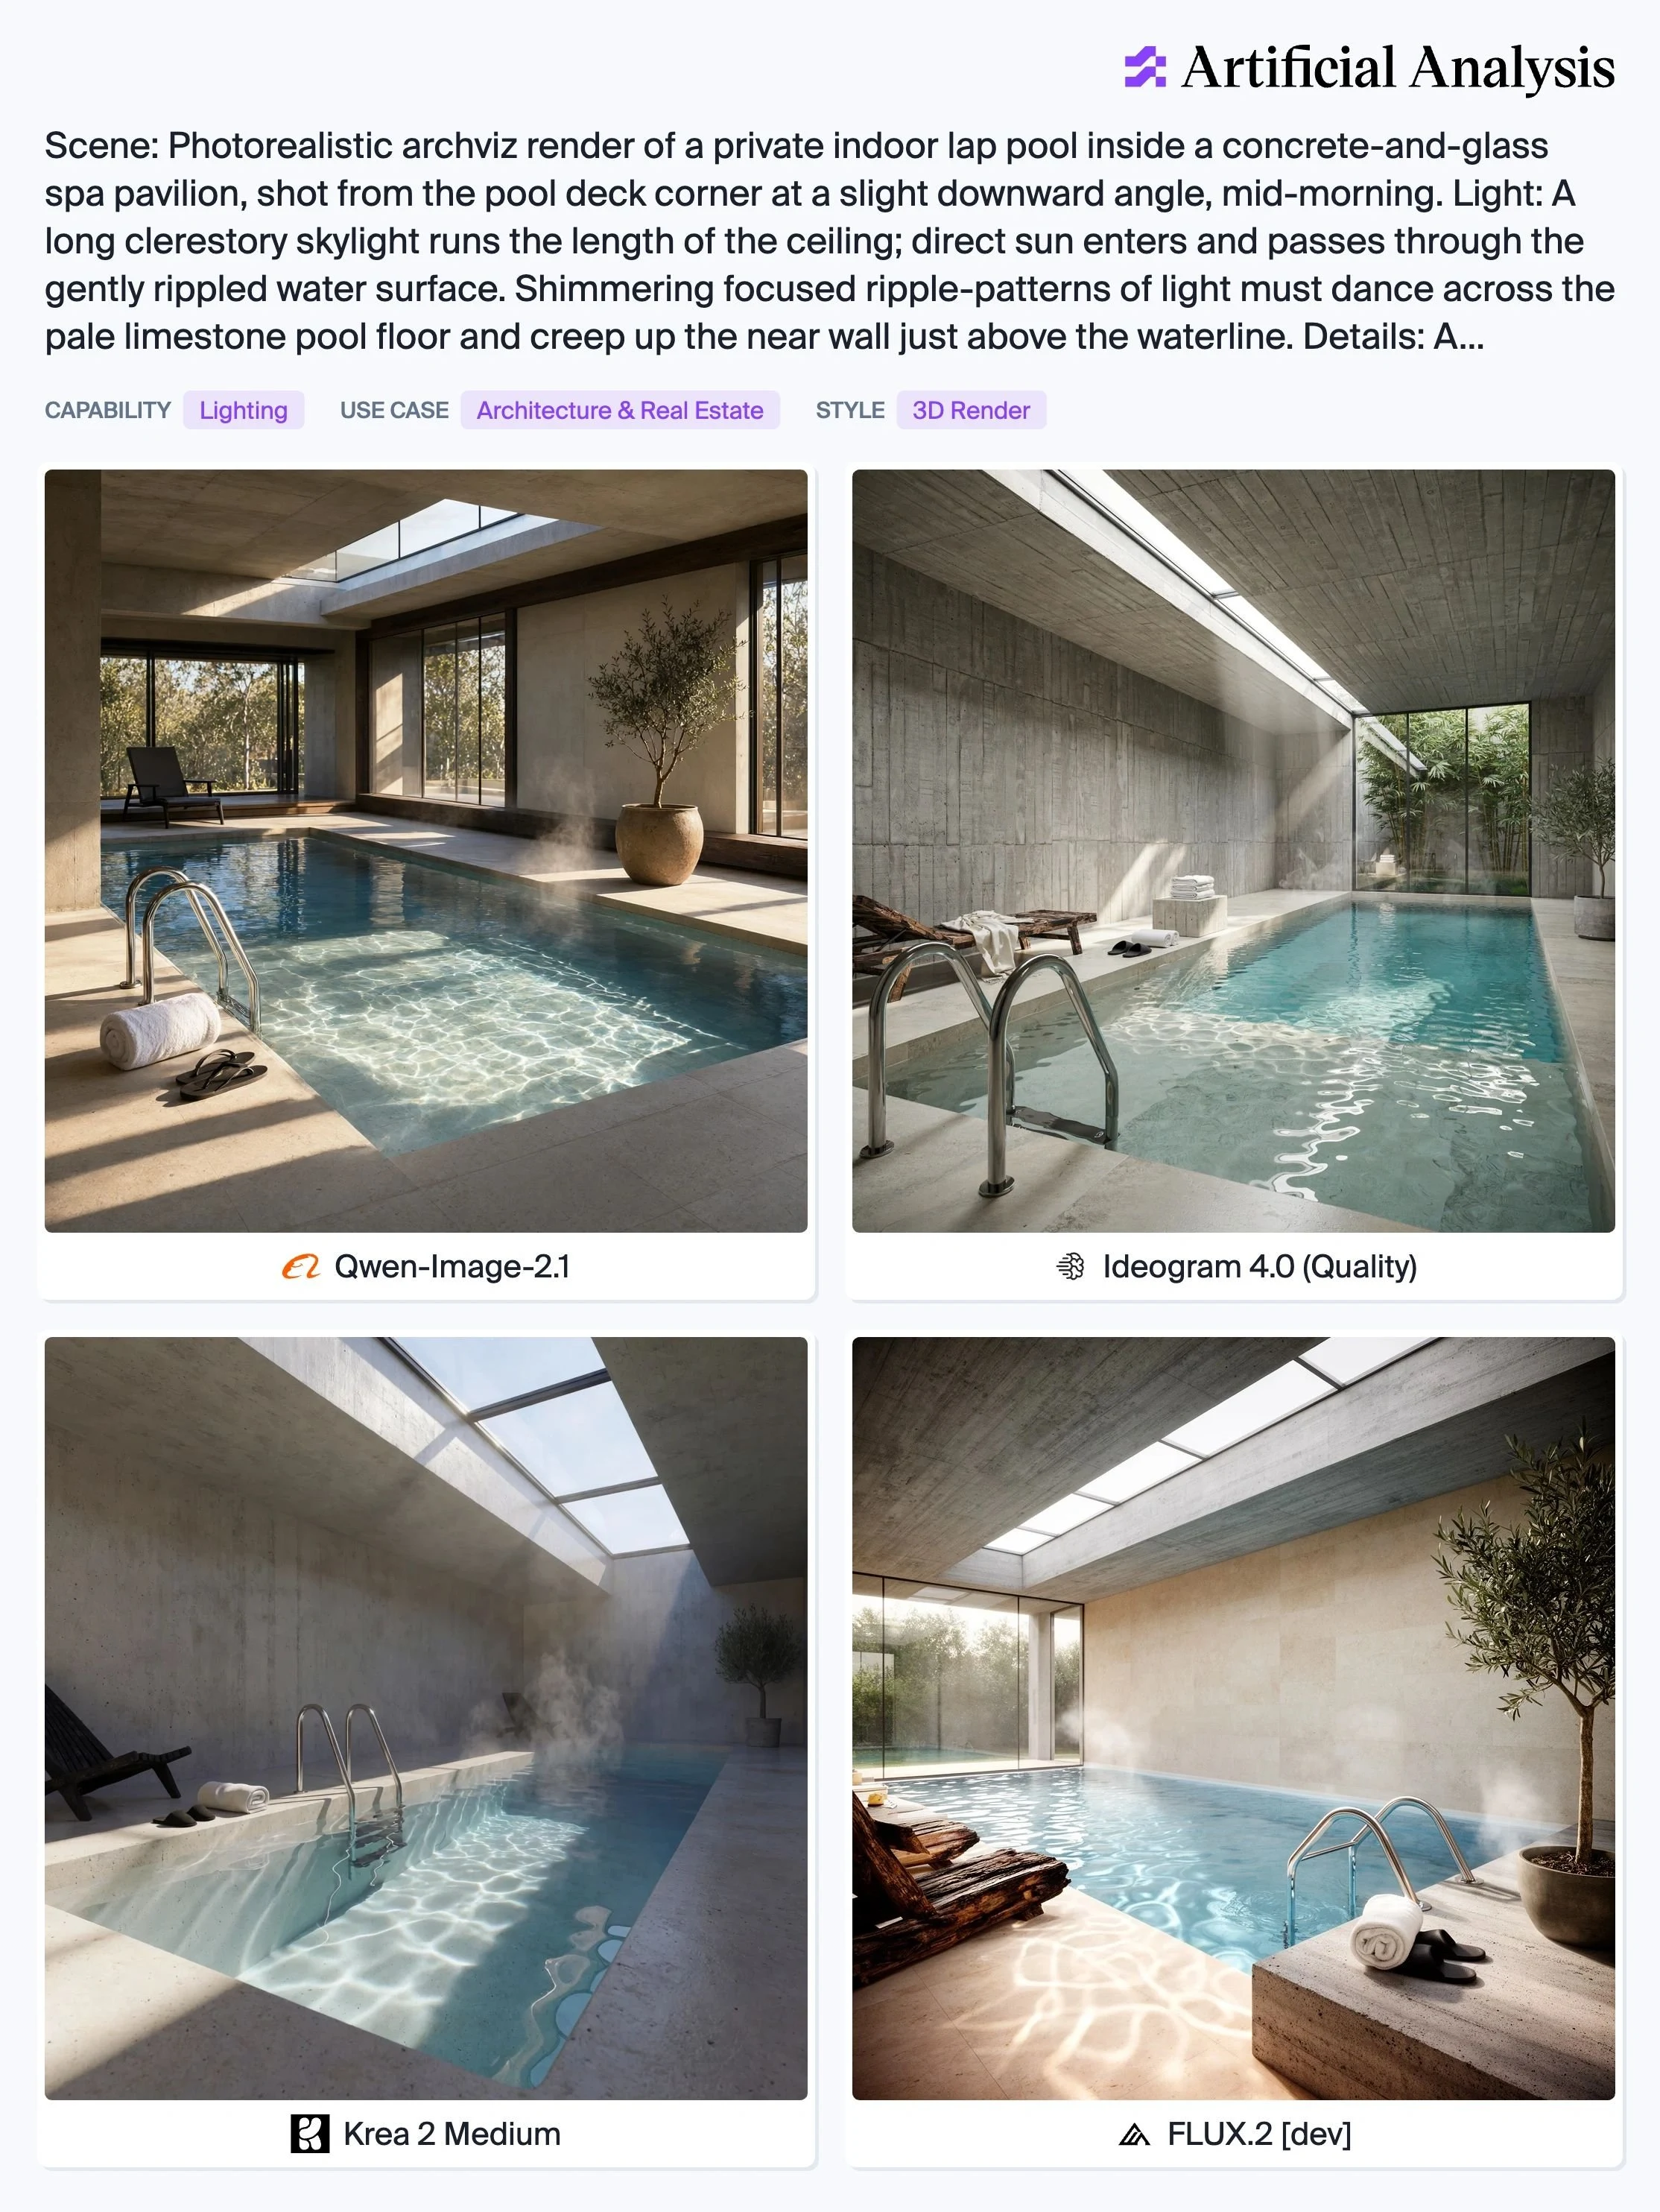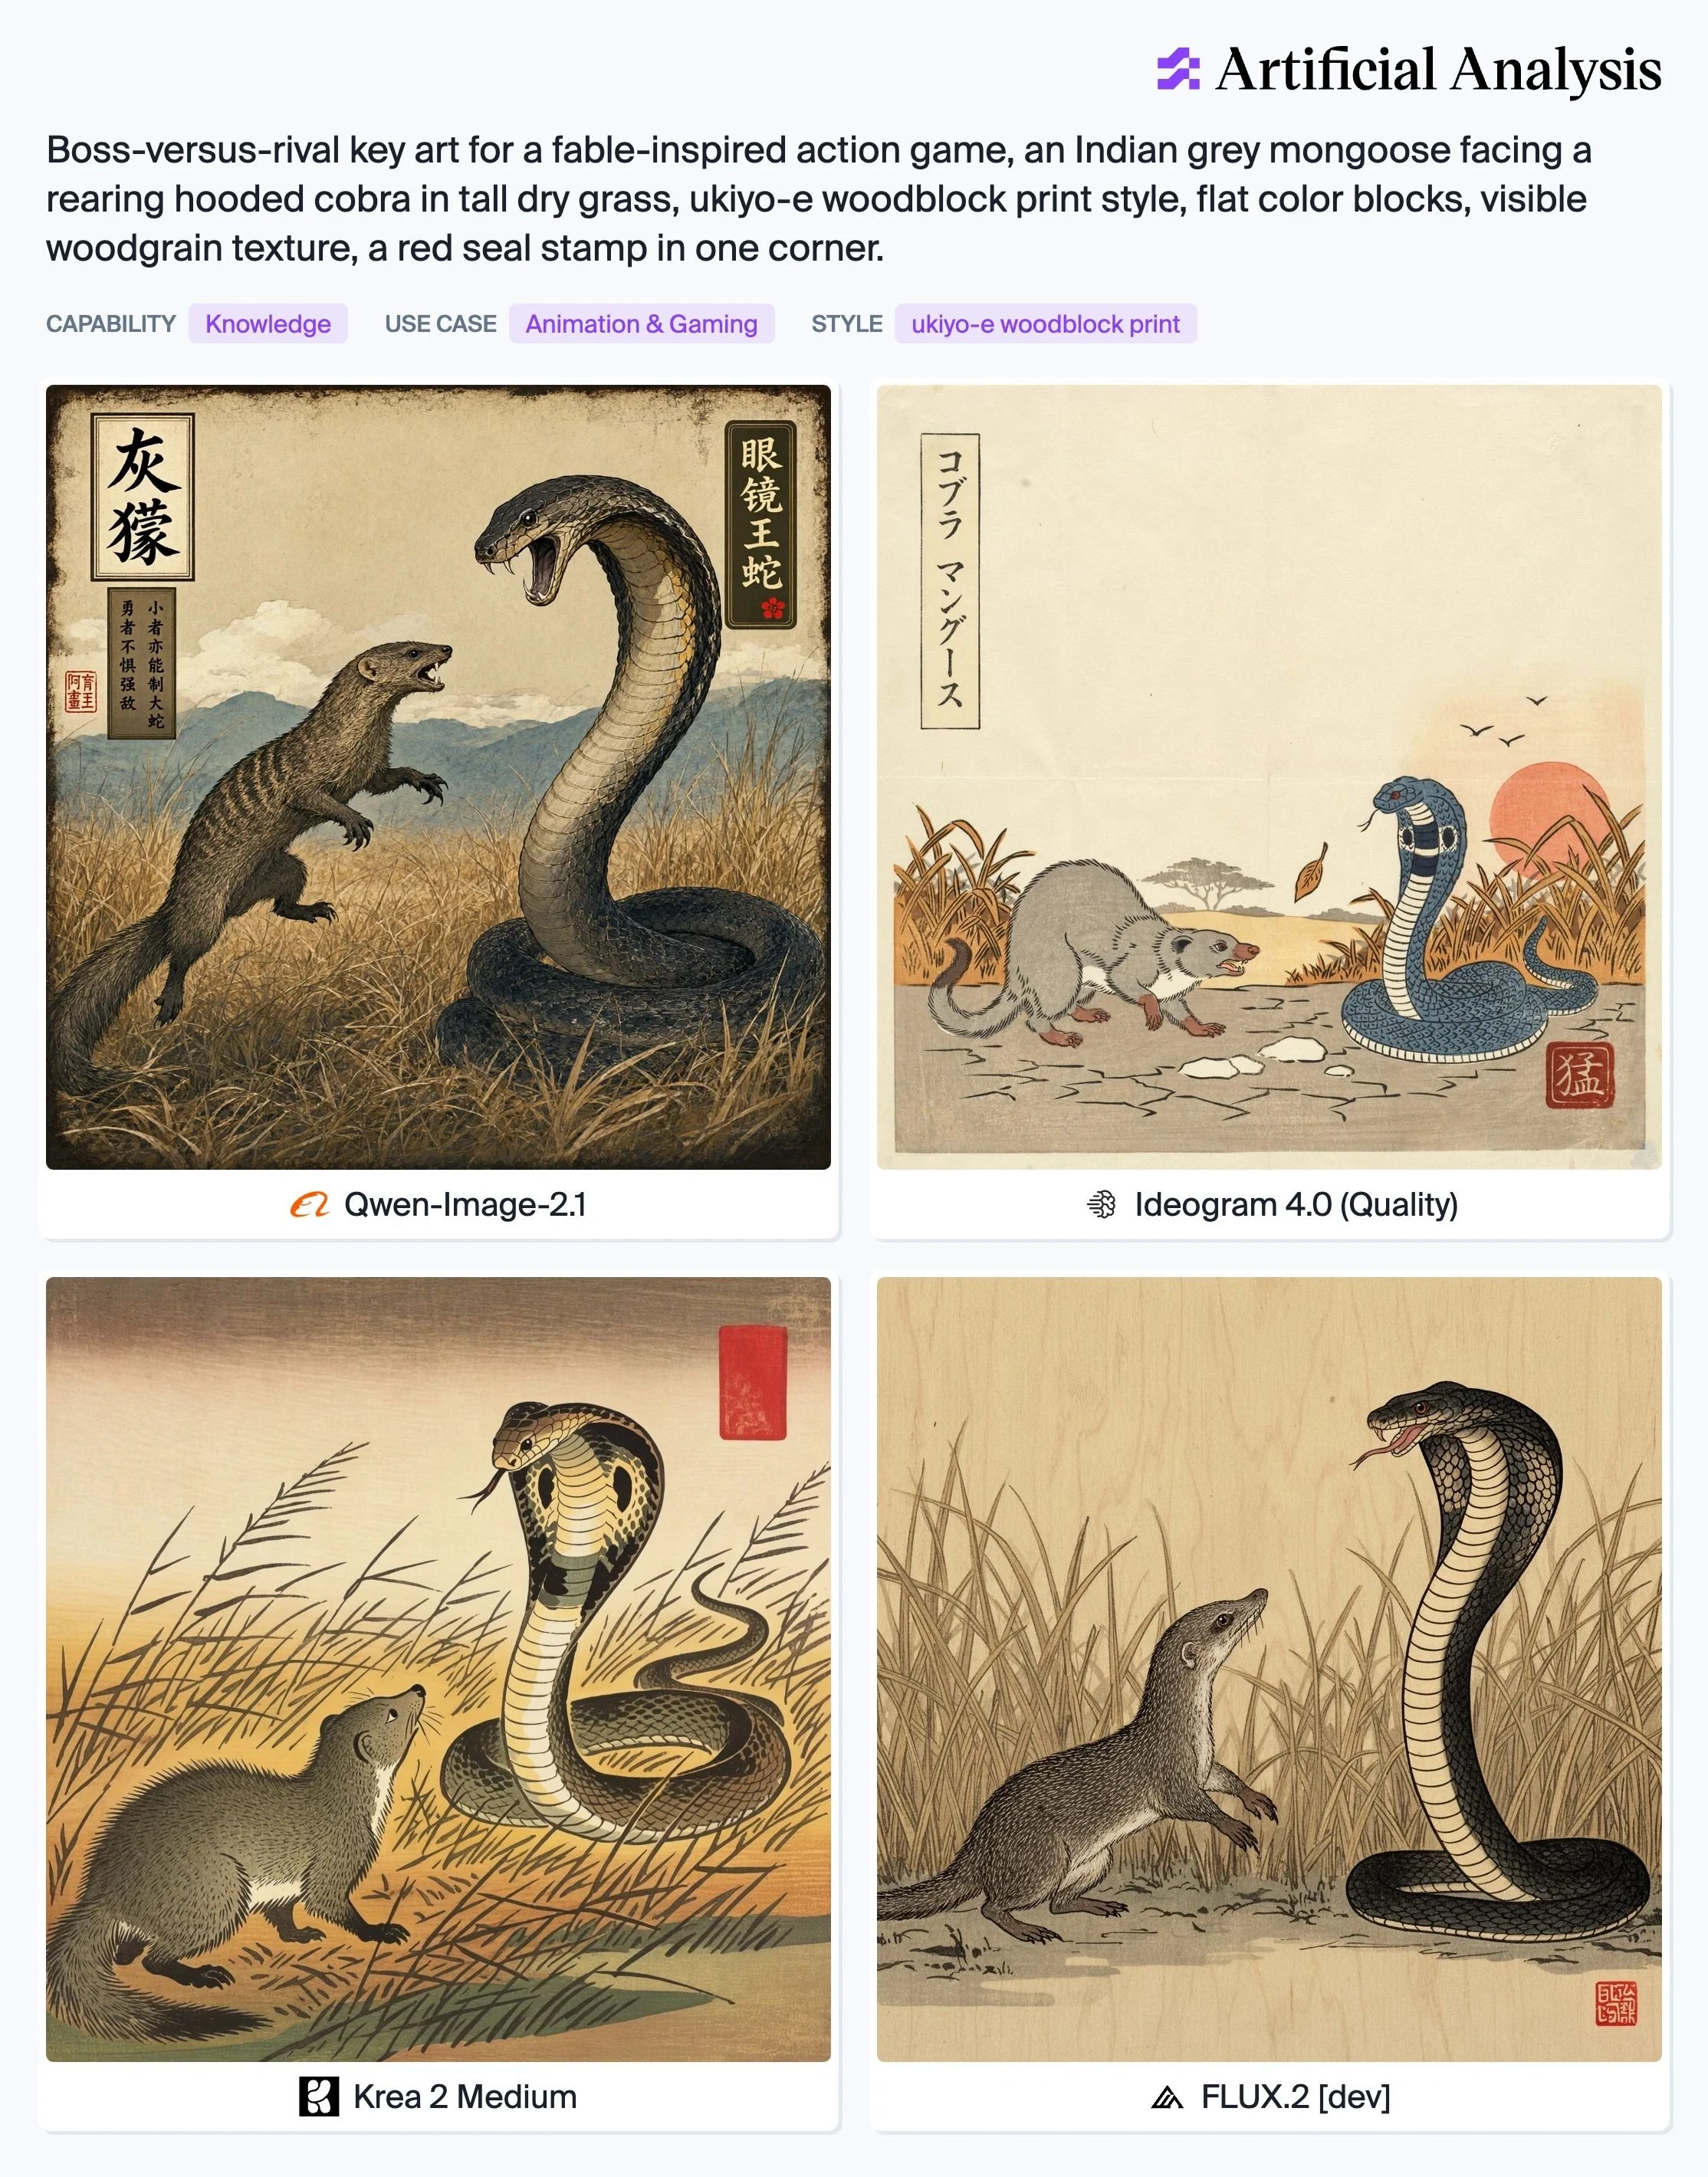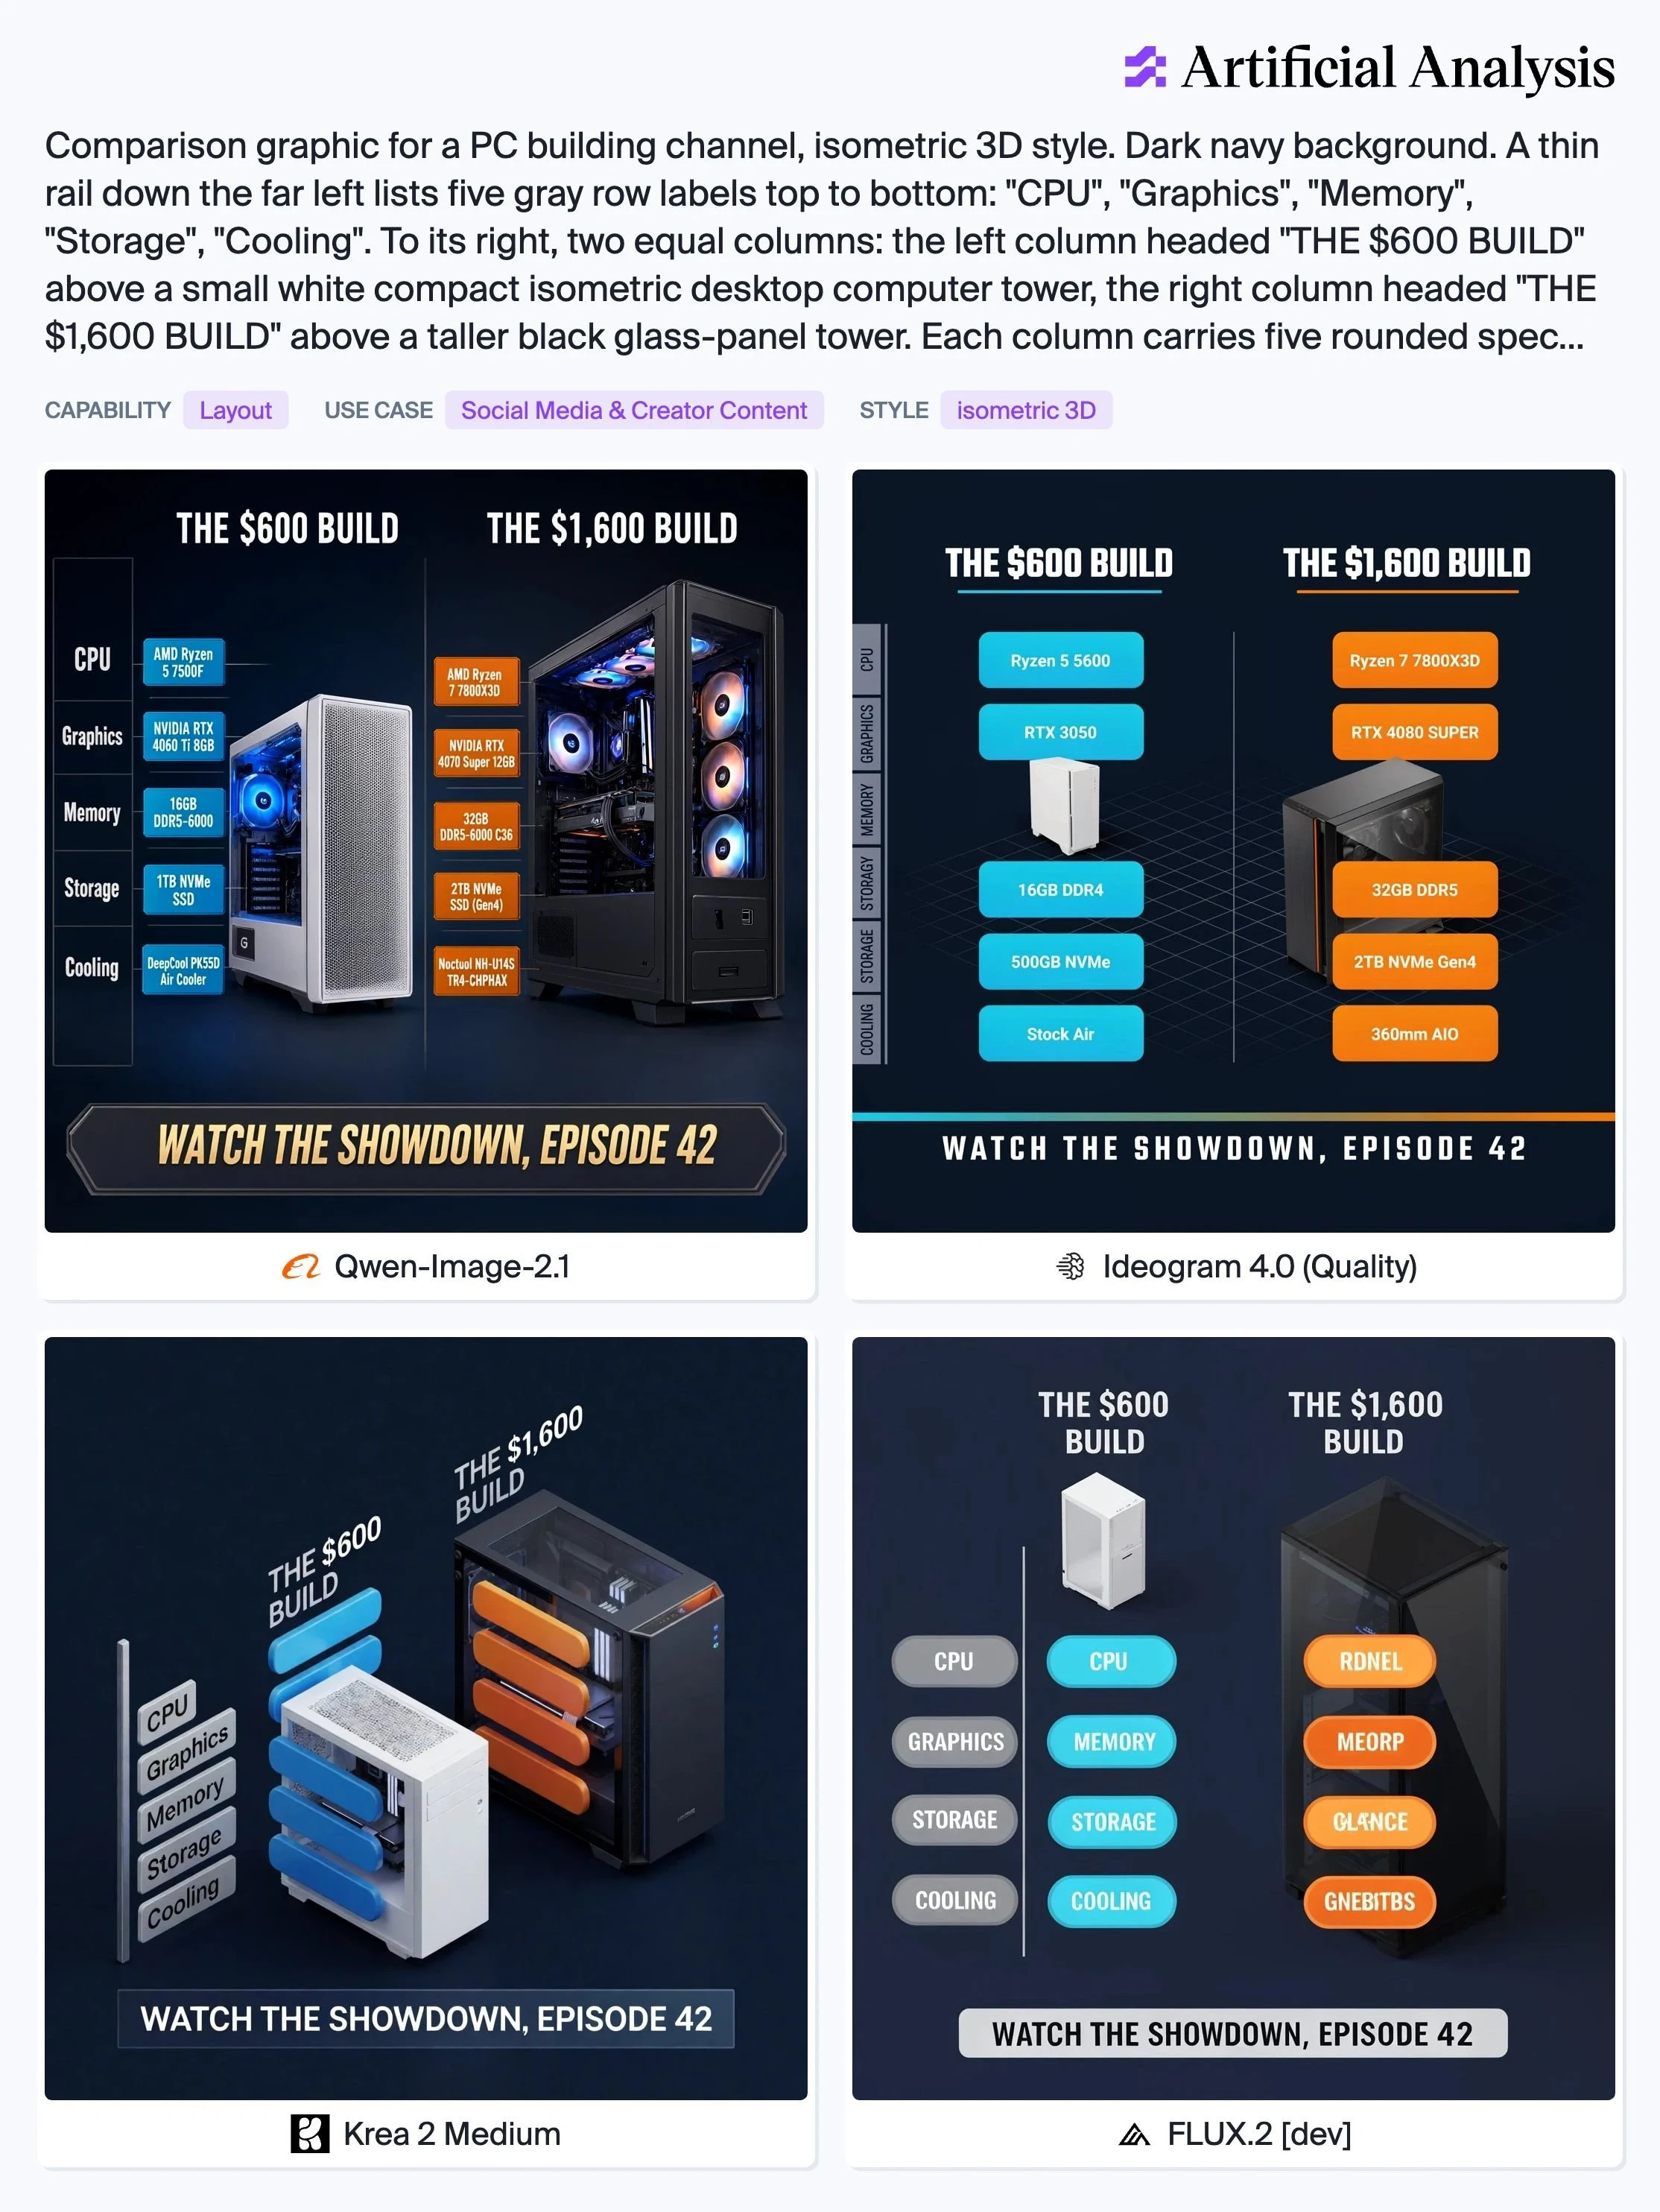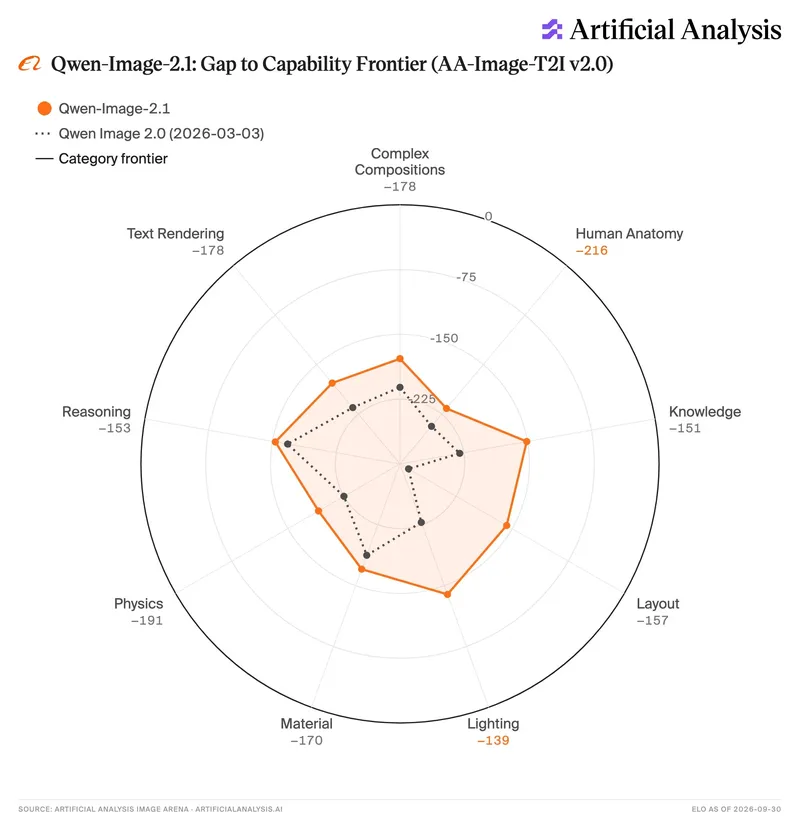
Là où Qwen-Image-2.1 est le plus fort en Text to Image : le plus proche de la frontière de catégorie parmi tous les modèles en Lighting, Knowledge et Reasoning
Notre taxonomie Text to Image mesure 9 capacités et 10 cas d'usage, chacun avec son propre classement. Les capacités sont les compétences individuelles qui entrent dans la création d'une image.
Qwen-Image-2.1 est le plus proche de la frontière de catégorie en Lighting, suivi de Knowledge, Reasoning et Layout. Face à Qwen Image 2.0, il réduit l'écart avec la frontière sur chaque capacité, avec les plus grands gains en Layout, Lighting et Knowledge.
➤ Lighting couvre la réflexion, la réfraction, les ombres et la caustique.
➤ Knowledge couvre les monuments réels, les espèces et les faits de domaine dans les sciences et le sens commun.
➤ Reasoning couvre l'interprétation des expressions idiomatiques, les mathématiques et les sciences, le raisonnement spatial et temporel, et le mélange de concepts.