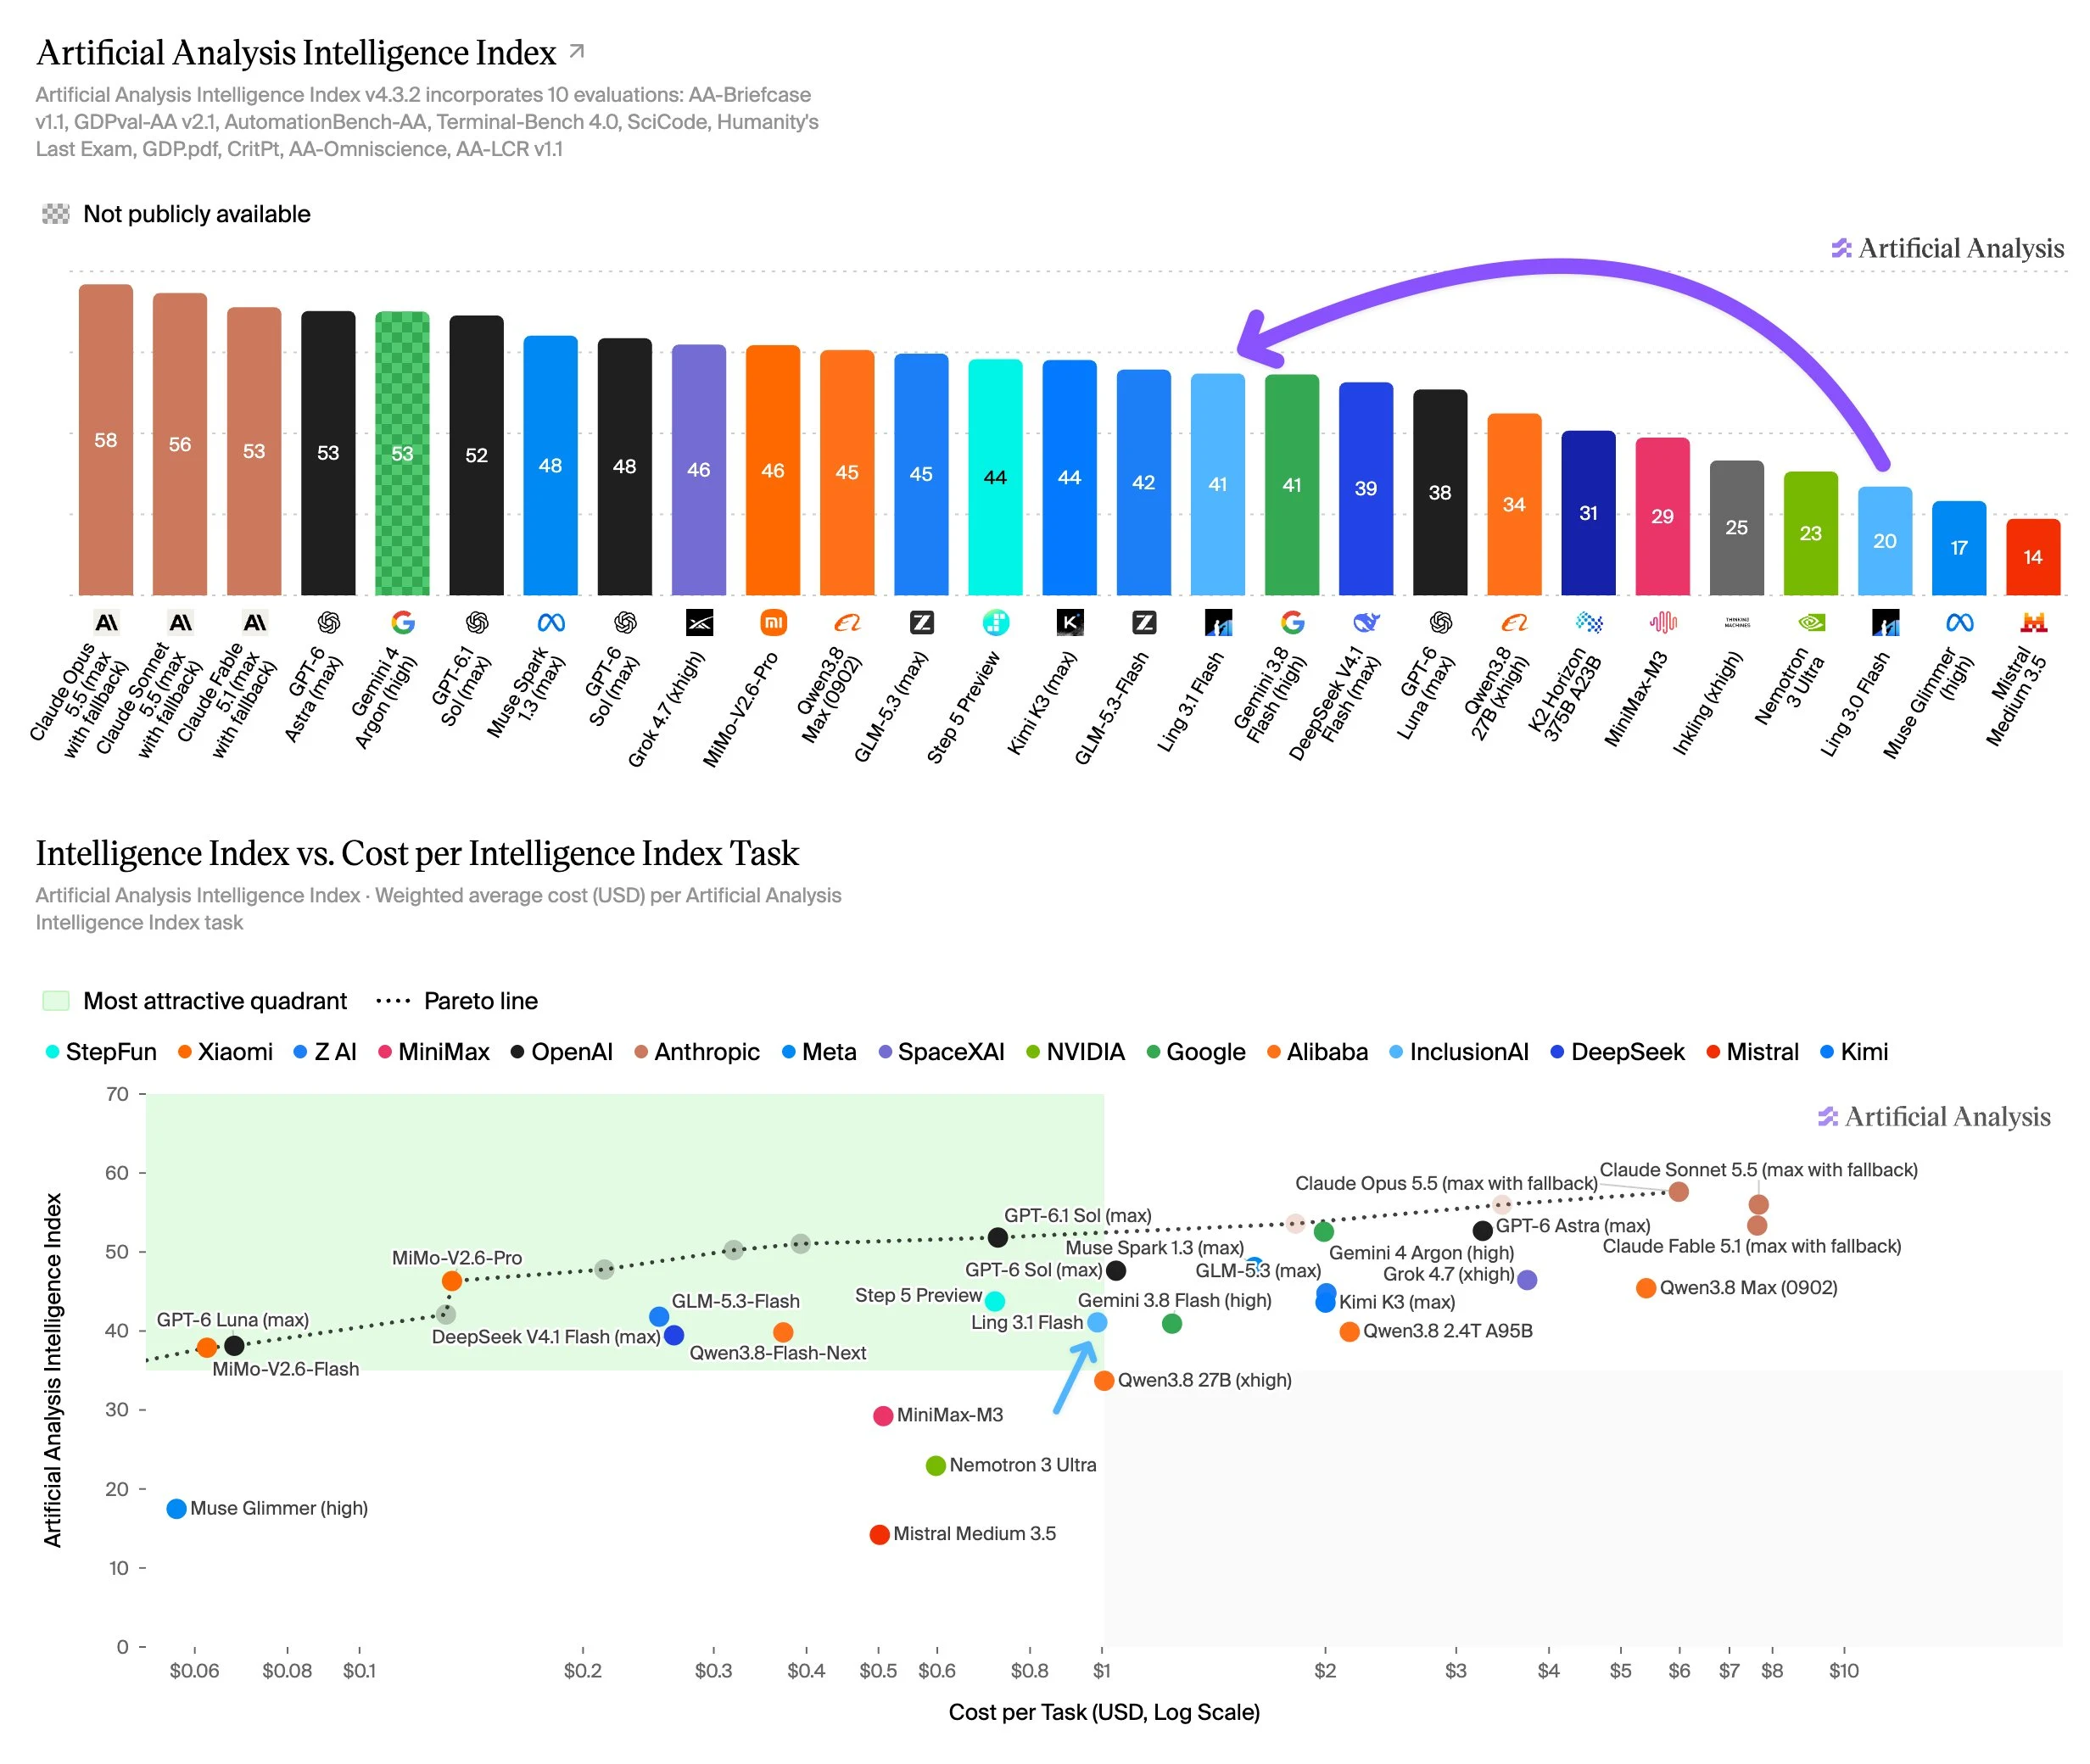
Ling 3.1 Flash fait de gros progrès en intelligence par rapport à son prédécesseur, atteignant 41 points sur l’Indice d’Intelligence Analytique Artificielle, avec une amélioration particulière des capacités agents.
@AntLingAGI a publié Ling 3.1 Flash, un modèle de raisonnement avec 560B de paramètres totaux, 25B de paramètres actifs et une fenêtre de contexte de 1M tokens. Il obtient une note de 41 sur l’Indice d’Intelligence Artificielle d’Analyse v4.3, contre 20 pour Ling 3.0 Flash, lancé en août. Ling 3.1 Flash sera probablement en mode poids ouvert, et le groupe Ant Group publiera les poids prochainement.
Résultats clés :
➤ Ling 3.1 Flash améliore les capacités agentiques par rapport à son prédécesseur. Avec un GDPval-AA v2 Elo de 1,622 et un AA-Briefcase Elo de 1,400, le modèle rivalise avec des modèles similaires tels que GLM-5.3-Flash, Gemini 3.8 Flash (haute) et DeepSeek V4.1 Flash (Max). Ling 3.1 Flash montre également des gains notables sur AutomationBench-AA (62%) et Terminal-Bench v4.0 (33%).
➤ Ling 3.1 Flash : +2 points sur AA-Omniscience, soit une amélioration de 22 points par rapport à Ling 3.0 Flash (-18). Par rapport à son prédécesseur, son taux d’exactitude est passé de 18 % à 29 %, tandis que le taux de hallucination est passé de 44 % à 38 % pour un taux d’essai similaire (56 % à 58 %), ce qui montre que l’avantage provient principalement du fait de savoir plus, et non d’éviter davantage. Pour comparaison, DeepSeek V4.1 Flash (Max) a un taux de hallucination de 97 %.
➤ Ling 3.1 Flash est un modèle plus grand que son prédécesseur, avec un prix correspondant, mais plus efficace en termes de tokens. Il dispose de 560B de paramètres totaux et de 25B de paramètres actifs, contre 124B et 5,1B pour Ling 3.0 Flash. Son prix est de 0,30 $ / 0,90 $ par 1M tokens entrée/sortie, contre 0,075 $ / 0,22 $ auparavant. Il a utilisé 218M de tokens de sortie pour exécuter l’Indice d’Intelligence, soit 16% moins que Ling 3.0 Flash (261M).
➤ Ling 3.1 Flash a un coût plus élevé par tâche que certains concurrents, mais reste dans le quadrant le plus attrayant. Ling 3.1 Flash coûte 0,99 $ par tâche, bien plus que GLM-5.3-Flash (0,42 $) et DeepSeek V4.1 Flash (Max, 0,32 $), mais moins que Gemini 3.8 Flash (High), qui coûte 1,24 $.
Détails du modèle supplémentaire :
➤ Taille : 560B de paramètres totaux, 25B actifs
➤ Fenêtre de contexte : 1M tokens
➤ Tarifs : 0,30 $ par 1 M de tokens d’entrée et 0,90 $ par 1 M de tokens de sortie, avec une réservation en cache à 0,06 $ par 1 M (réduction de 80 %)
➤ Disponibilité : Accessible via Novita AI, les poids seront disponibles bientôt