
Amazon SageMaker HyperPod donne aux équipes de machine learning (ML) accès à de vastes pools de calcul accéléré pour l'entraînement et le réglage fin des modèles. Lorsque plusieurs équipes partagent un même cluster, la configuration technique est généralement simple. La partie difficile, c'est la gouvernance. Vous devez décider quelles équipes peuvent utiliser le cluster, quelle capacité chaque équipe obtient, ce qui se passe lorsque la charge de travail d'une équipe entre en concurrence avec celle d'une autre, et qui est responsable lorsque l'utilisation s'écarte de la politique. Amazon SageMaker Unified Studio ajoute une autre considération : vous pouvez connecter un cluster SageMaker HyperPod à un projet afin que les membres de l'équipe puissent lancer des charges de travail depuis leur espace de travail de projet. Cette commodité est précieuse, mais une fois que plusieurs équipes partagent la visibilité sur le même cluster, les contrôles qui gouvernent qui peut faire quoi deviennent encore plus importants. Dans cet article, nous montrons comment administrer SageMaker HyperPod via SageMaker Unified Studio tout en préservant les contrôles de gouvernance sous-jacents. Nous couvrons les quatre couches de contrôle : organisation, projet, cluster et charge de travail. Nous expliquons également comment concevoir des politiques d'identité, de capacité et d'observabilité à travers celles-ci. À la fin, vous disposerez d'un modèle reproductible pour offrir du calcul SageMaker HyperPod approuvé aux équipes de ML dans leur contexte de projet, tout en laissant les opérations de cluster à l'équipe d'infrastructure.
Amazon SageMaker HyperPod est une fonctionnalité d' Amazon SageMaker AI. Amazon SageMaker Unified Studio est l'environnement de développement de données et d'IA où les équipes construisent avec leurs données et leurs outils. Avec SageMaker Unified Studio, vous pouvez connecter un projet à un cluster SageMaker HyperPod existant. Les membres peuvent ensuite lancer des charges de travail de machine learning, consulter les informations du cluster et des tâches, et ouvrir un workflow JupyterLab. Vous continuez à gérer les clusters via les interfaces et les API d'Amazon SageMaker AI.
Cette séparation offre aux équipes d'infrastructure un modèle opérationnel utile. Vous pouvez gérer l'infrastructure du cluster via des processus établis d'opérations cloud. Parallèlement, vous pouvez présenter du calcul approuvé aux équipes de machine learning dans leur contexte de projet. Dans cet article, nous décrivons comment concevoir des frontières d'infrastructure, gouverner les accès, allouer une capacité partagée et exploiter SageMaker HyperPod de manière cohérente via SageMaker Unified Studio.
Comprendre les frontières administratives
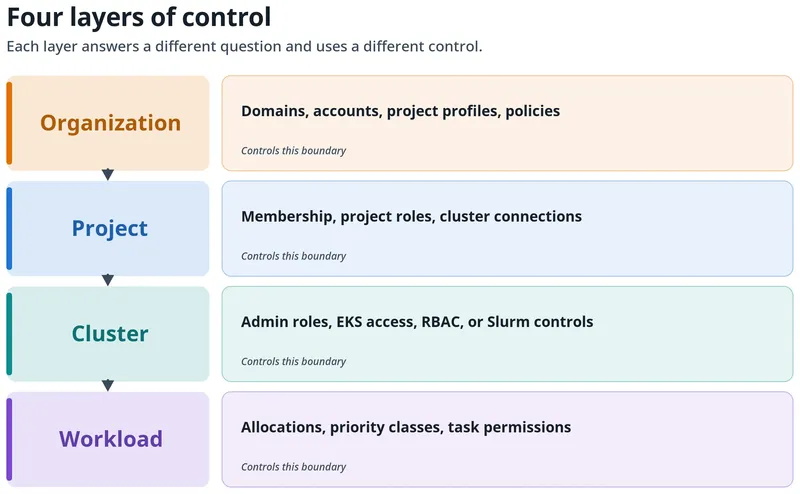
Un environnement bien gouverné sépare l'administration organisationnelle, l'accès aux projets et les opérations de cluster. Chaque couche répond à une question différente et utilise un contrôle différent. Le tableau suivant résume chaque frontière, ses contrôles principaux et son objectif administratif.
| Frontière | Contrôles principaux | Objectif administratif |
| Organisation | Domaines SageMaker Unified Studio, unités de domaine, comptes associés, profils de projet et politiques d'autorisation | Détermine qui peut créer des projets, quels comptes et Régions les projets peuvent utiliser, et quels outils sont disponibles |
| Projet | Adhésion au projet, rôles de projet et connexions SageMaker HyperPod | Définit le contexte de collaboration et les ressources AWS auxquelles les membres du projet peuvent accéder |
| Cluster | Rôles d'administrateur de cluster SageMaker HyperPod, entrées d'accès Amazon EKS, contrôle d'accès basé sur les rôles (RBAC) et EKS Pod Identity, ou contrôles Slurm | Gouverne la configuration du cluster, l'accès au planificateur, les espaces de noms, les tâches et les opérations d'infrastructure |
| Charge de travail | Allocations de calcul, classes de priorité, politiques de prêt et d'emprunt, et permissions de tâches | Contrôle qui peut soumettre du travail et comment la capacité partagée est attribuée |
Traitez ces contrôles comme des couches. Une connexion SageMaker HyperPod ajoute un cluster approuvé à un projet. Elle ne remplace pas les contrôles AWS Identity and Access Management (IAM), Amazon Elastic Kubernetes Service (Amazon EKS) ou Slurm du cluster. Examinez ensemble le rôle du projet, le rôle d'accès de la connexion, les entrées d'accès EKS et les contrôles RBAC ou Slurm, l'identité des charges de travail, les politiques de données et de clé AWS Key Management Service (AWS KMS) , la politique réseau, les restrictions d'affichage des tâches et la politique du planificateur. Rendez le cluster disponible uniquement après que ces contrôles soient alignés.
Ces contrôles forment quatre couches, illustrées dans la figure suivante.
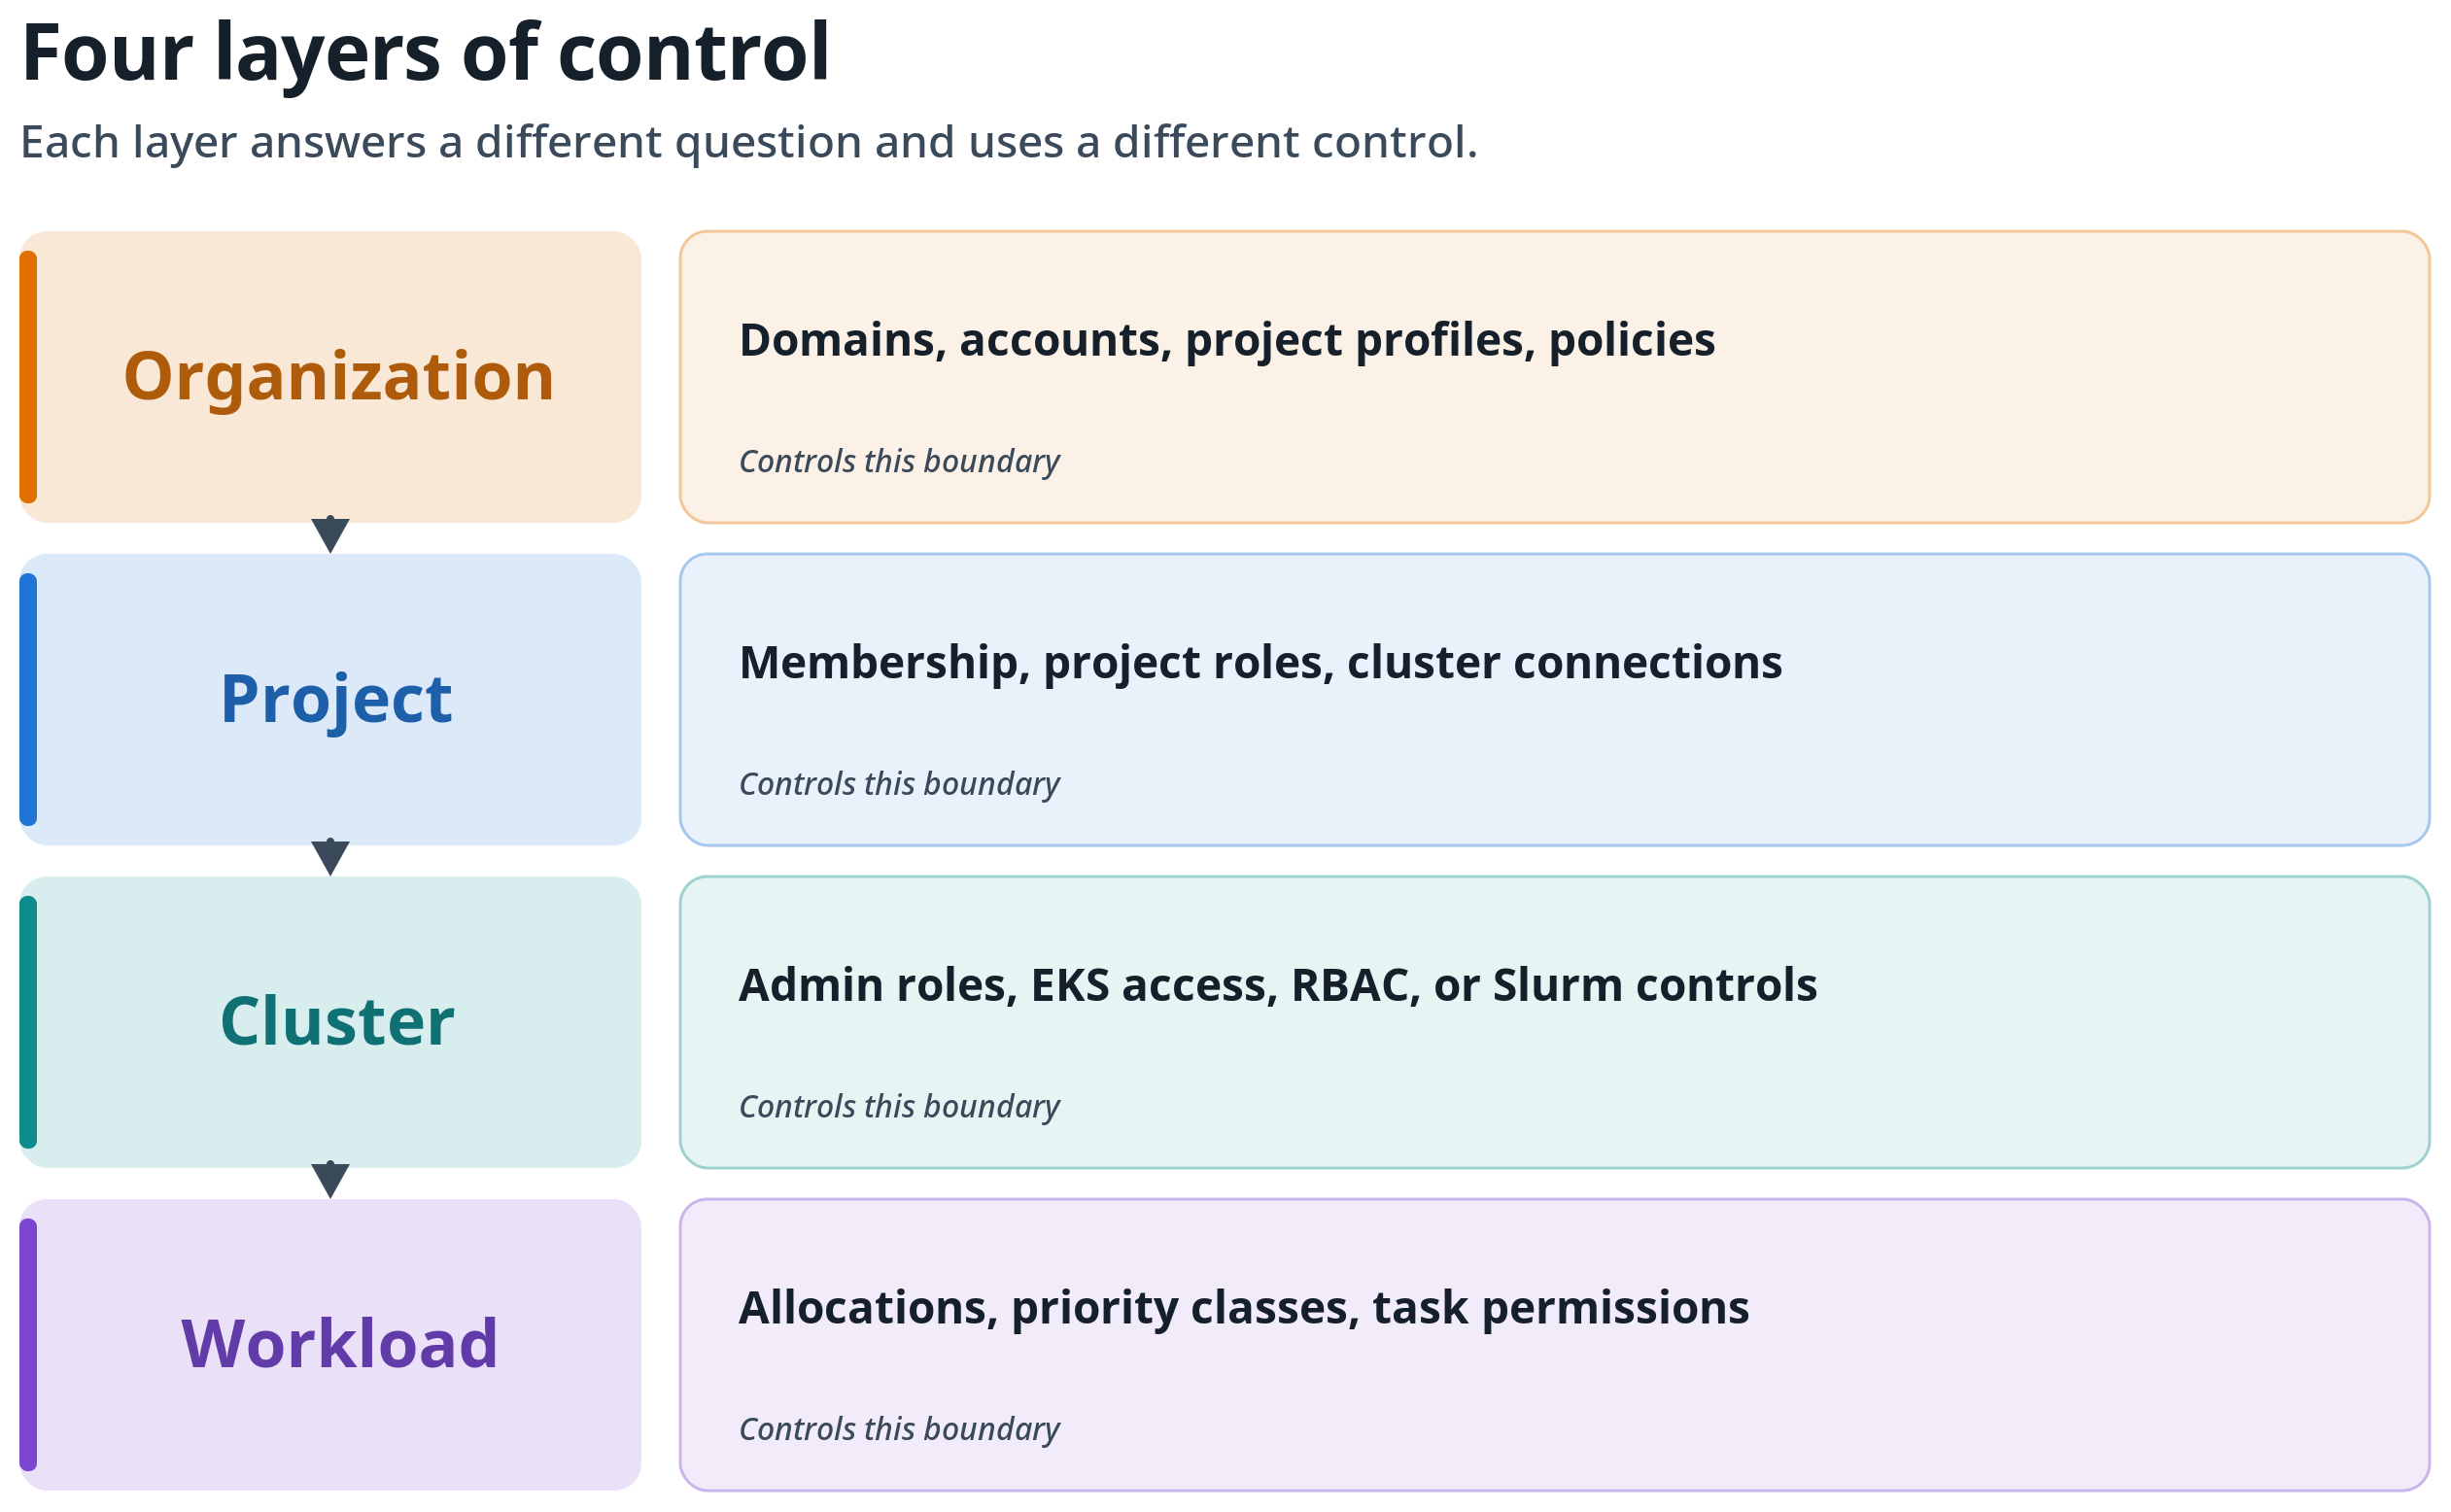
Figure 1 : Les quatre niveaux de contrôle : organisation, projet, cluster et workload. Chaque niveau répond à une question différente et utilise un contrôle différent ; examinez donc chacun à sa propre frontière.
Les projets SageMaker Unified Studio sont des frontières de collaboration. Ce ne sont pas des frontières de sécurité d'exécution fortes. Conservez le cluster SageMaker HyperPod, l'ordonnanceur et la capacité d'accélérateurs rare dans un compte de capacité désigné unique. Les utilisateurs et jeux de données approuvés peuvent rester dans le même compte ou dans des comptes consommateurs et de données distincts. AWS documente la prise en charge multi-comptes pour la gouvernance des tâches SageMaker HyperPod sur les clusters Amazon EKS. Bien que les On-Demand Capacity Reservations puissent être partagées entre comptes, centralisez la propriété des clusters SageMaker HyperPod et l'administration de la capacité dans le compte de capacité. Utilisez un accès inter-comptes approuvé plutôt que de faire de chaque compte consommateur un administrateur de capacité indépendant.
- Pour Amazon EKS, utilisez un espace de noms par locataire avec RBAC, des comptes de service par locataire et des rôles EKS Pod Identity, des politiques réseau de refus par défaut, ainsi que des autorisations de stockage et AWS KMS propres à chaque locataire. Pour Slurm, utilisez la comptabilité Slurm avec des comptes hiérarchiques et des associations, la qualité de service (QoS), les politiques de priorité et de partage équitable, ainsi que des partitions. Utilisez également l'identité du système d'exploitation et les permissions de fichiers, les contrôles réseau et des chemins de données propres à chaque locataire.
- Utilisez des rôles IAM et des politiques de ressources, plutôt que la seule appartenance au projet, pour contrôler l'accès aux compartiments Amazon Simple Storage Service (Amazon S3), aux clés AWS KMS, aux secrets, aux registres de conteneurs et à d'autres services de données. Utilisez les politiques de projet et d'unité de domaine pour la collaboration et la délégation.
- Pour les clusters Amazon EKS, utilisez la gouvernance des tâches SageMaker HyperPod, y compris les quotas, les classes de priorité, le prêt et l'emprunt, ainsi que la préemption, pour partager équitablement le pool central d'accélérateurs. Pour les clusters Slurm, utilisez les contrôles natifs de partitions, de qualité de service (QoS), de priorité, de partage équitable et de préemption. Slurm n'offre pas le même modèle de prêt et d'emprunt. Ces contrôles d'ordonnancement déterminent quand une charge de travail autorisée reçoit du calcul. Ils n'accordent pas l'accès aux espaces de noms ni aux données.
Pour une isolation renforcée au sein d'un cluster, utilisez des nœuds dédiés ou des groupes de nœuds et des contrôles d'admission le cas échéant. Utilisez un cluster ou un compte distinct lorsque des exigences légales, réglementaires ou de sécurité exigent une isolation stricte de l'infrastructure. L'accès consommateur inter-comptes peut préserver la propriété au niveau du compte sans dupliquer le cluster central SageMaker HyperPod. Dans le compte de capacité, utilisez les profils de projet et les unités de domaine avec des politiques d'autorisation de projet pour déléguer la création et la propriété des projets.
La figure suivante montre une capacité centralisée avec des contrôles de charge de travail, d'identité, de données, de réseau et de visibilité propres à chaque locataire.
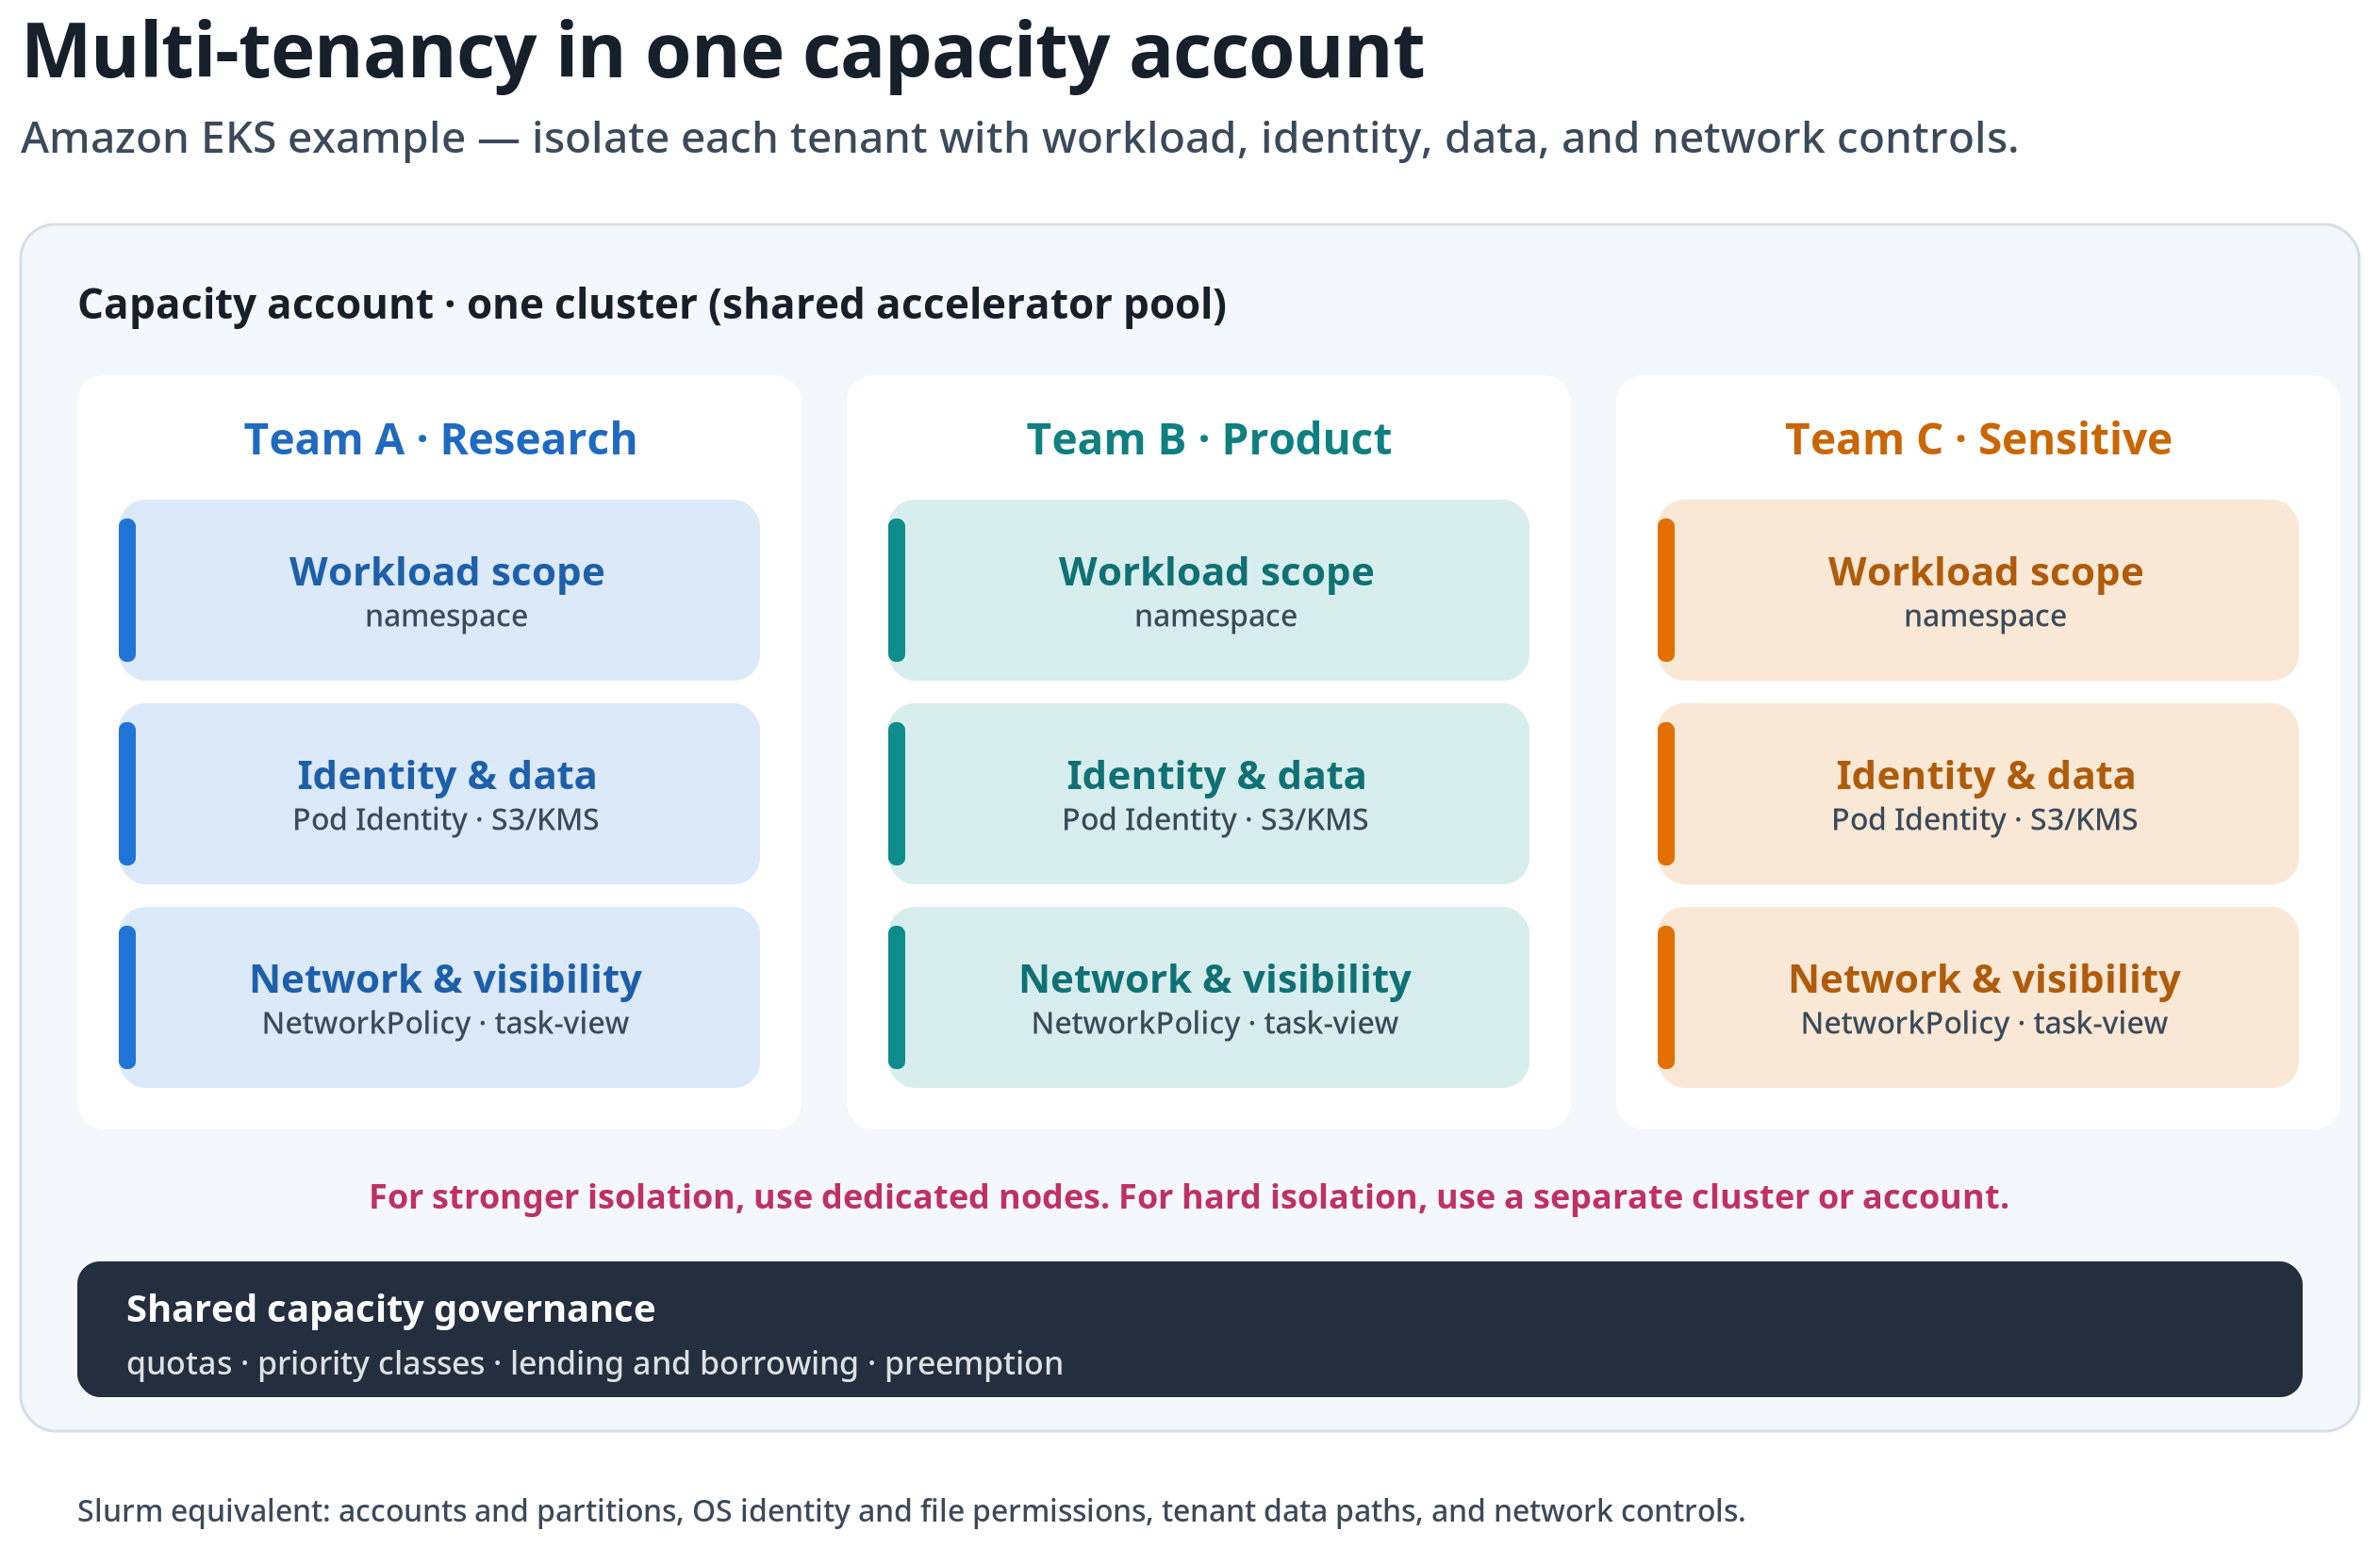
Figure 2 : Capacité SageMaker HyperPod centralisée. Le cluster et l'ordonnanceur restent dans un seul compte de capacité. Chaque locataire reçoit des contrôles de charge de travail, d'identité, de données, de réseau et de visibilité des tâches. Les exigences d'isolation stricte utilisent une infrastructure dédiée.
La figure 3 montre comment ces frontières se connectent lorsque SageMaker Unified Studio expose le calcul SageMaker HyperPod approuvé aux membres du projet.
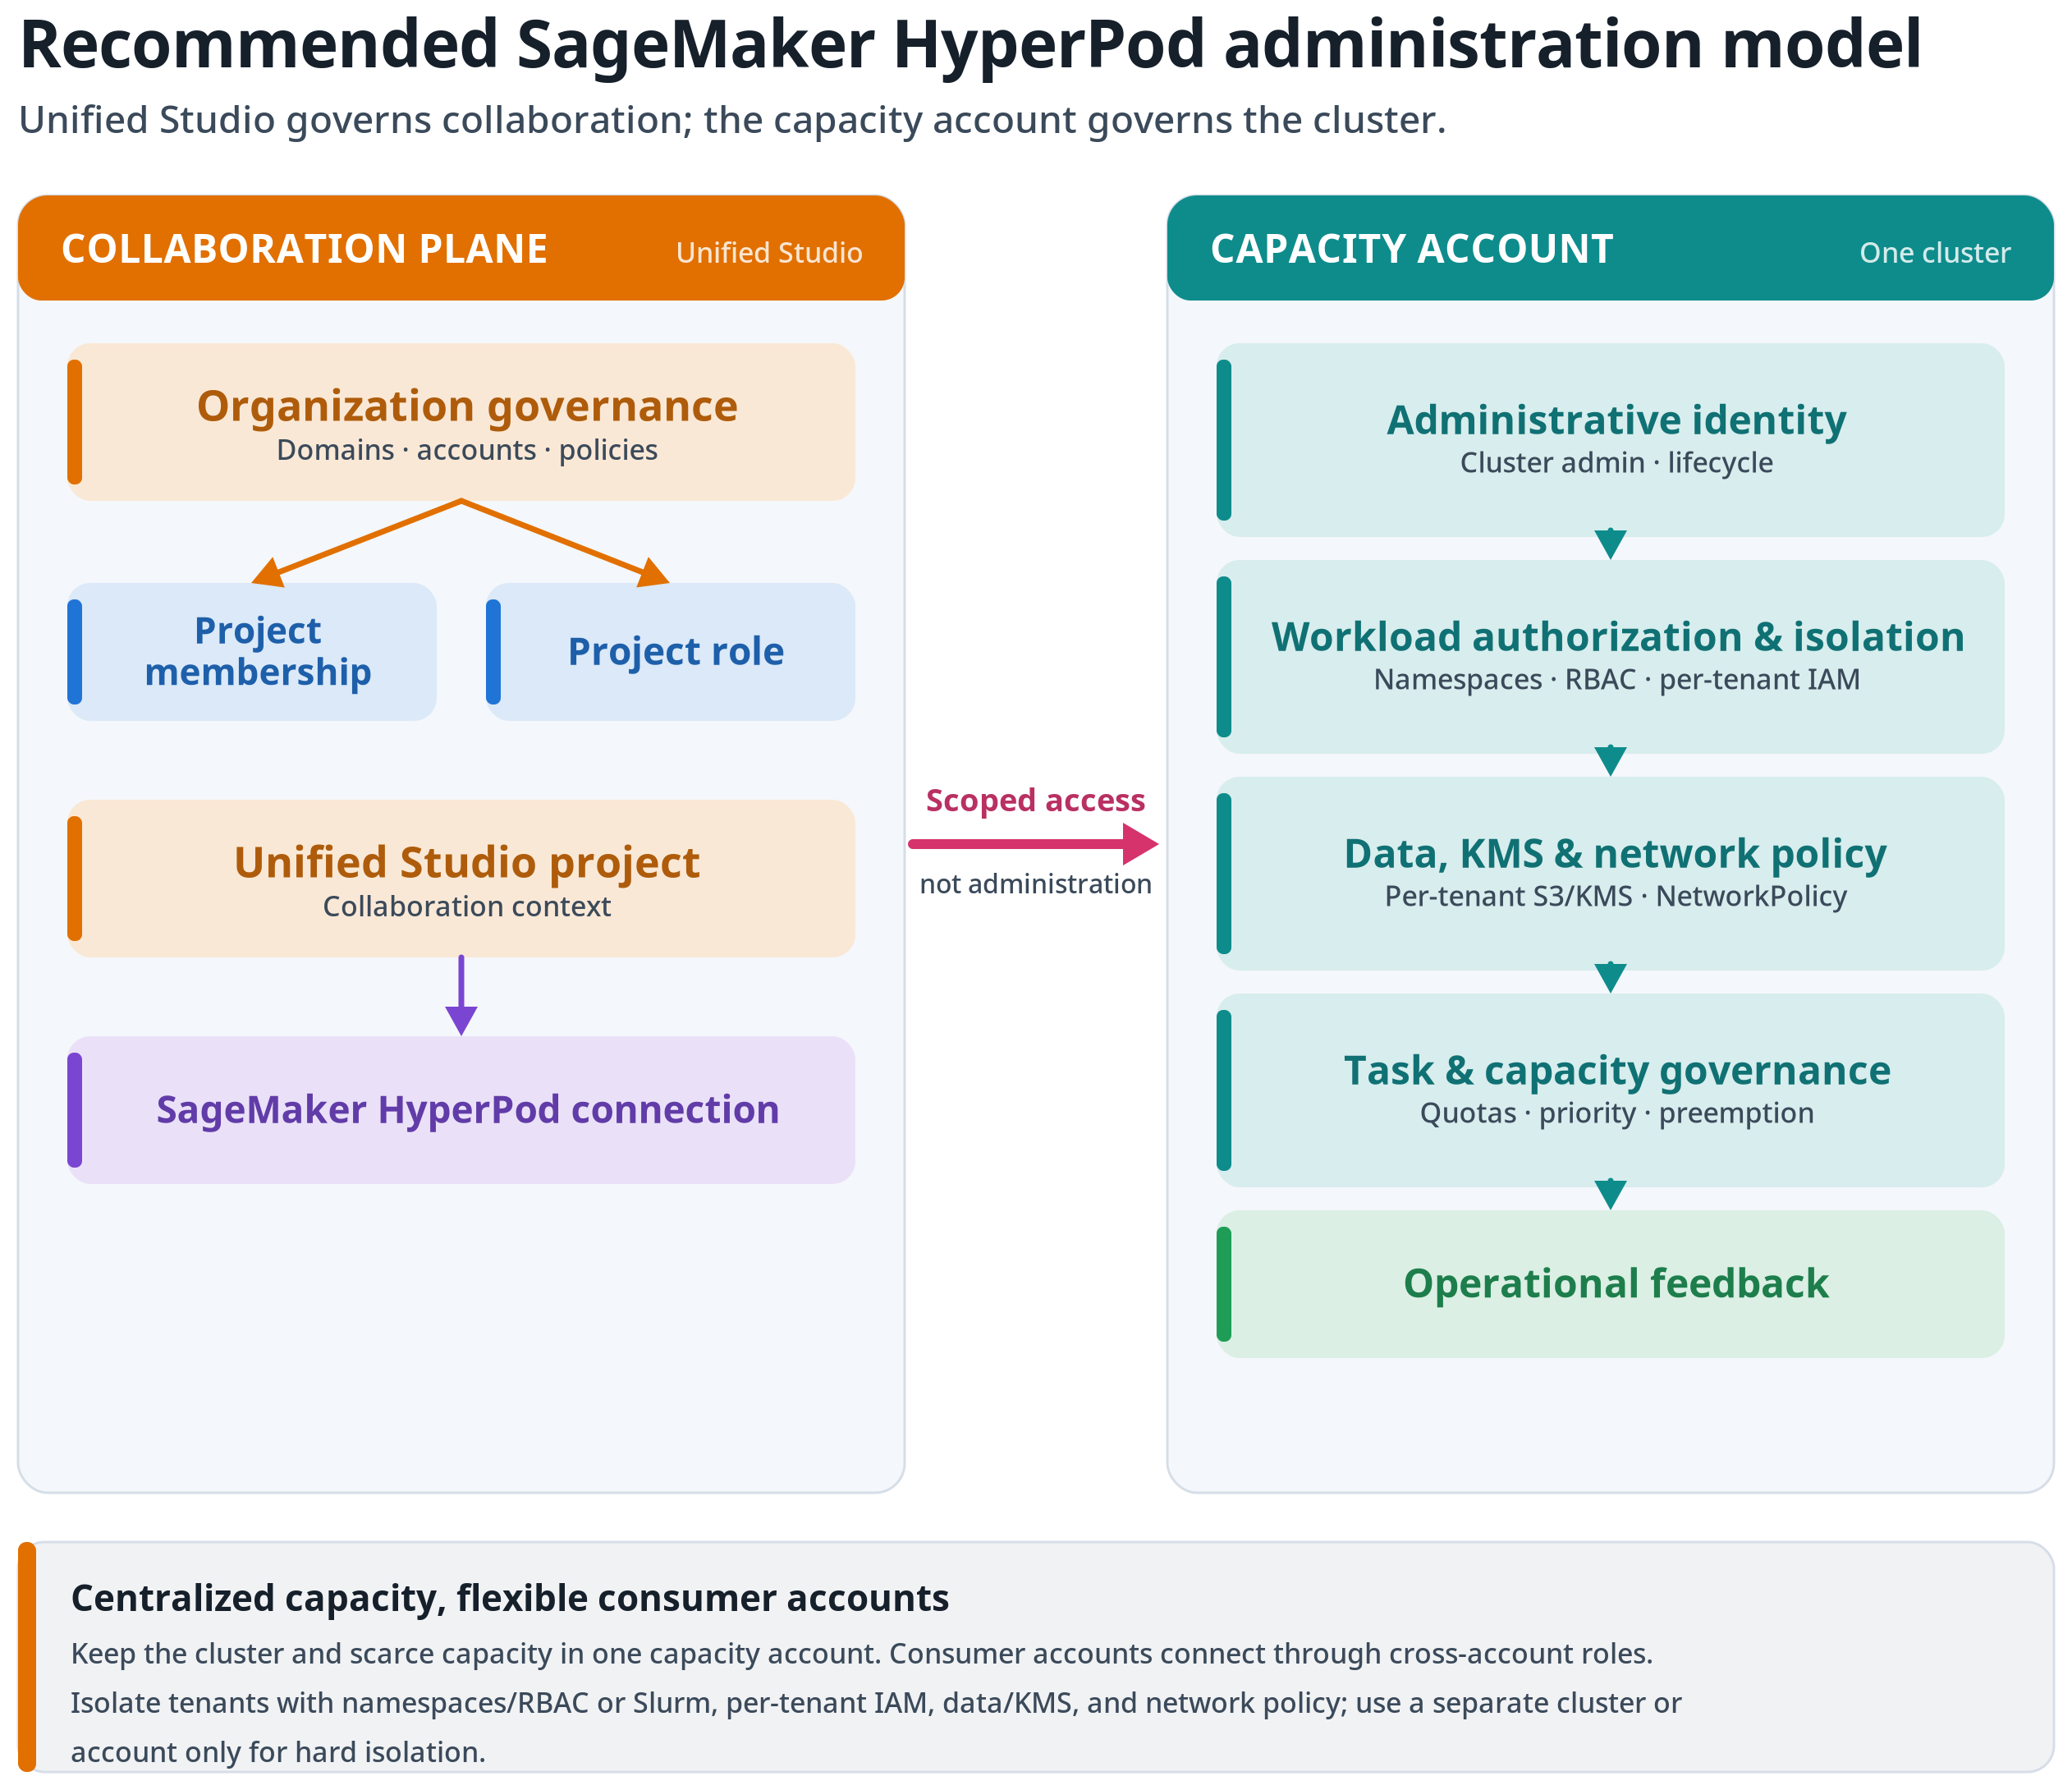
Figure 3 : Modèle d'administration SageMaker HyperPod recommandé. SageMaker Unified Studio gouverne le contexte de collaboration, tandis que l'identité du cluster, l'autorisation des charges de travail, la politique d'ordonnancement et les contrôles opérationnels restent séparés.
Déterminez quand SageMaker Unified Studio constitue la bonne expérience d'administration
Avec SageMaker Unified Studio, les équipes d'apprentissage automatique qui travaillent déjà dans un projet peuvent suivre un chemin approuvé vers un calcul SageMaker HyperPod partagé. Les membres peuvent trouver les clusters connectés, examiner le statut et les métadonnées, inspecter les tâches et les métriques prises en charge, et passer à JupyterLab sans utiliser un inventaire d'infrastructure séparé.
Cette expérience ne remplace pas l'administration du cluster. Le tableau suivant montre comment chaque persona doit utiliser SageMaker Unified Studio parallèlement aux interfaces propres au service.
| Persona | Utiliser SageMaker Unified Studio pour | Continuer à utiliser des outils propres au service pour |
| Administrateur de domaine ou d'infrastructure | Les unités de domaine, la politique de création de projets, les profils de projet, la politique d'adhésion et le placement des comptes | Les contrôles au niveau de l'organisation, le provisionnement des comptes et l'automatisation de l'infrastructure |
| Administrateur de cluster SageMaker HyperPod | La présentation des connexions de cluster approuvées et la revue des vues de cluster, de tâches, de paramètres et de métadonnées | La création de clusters, les mises à jour, la configuration de résilience, les modules complémentaires, l'administration EKS ou Slurm et la réponse aux incidents |
| Propriétaire de projet | La gestion de l'adhésion au projet et l'offre aux utilisateurs d'un contexte de projet cohérent pour le calcul approuvé | La demande de modifications d'infrastructure et l'approbation des exigences d'accès propres à l'activité |
| Ingénieur ML ou scientifique des données | La recherche de calcul approuvé, la revue du statut des charges de travail et l'ouverture du flux de travail JupyterLab | La soumission et la gestion de charges de travail détaillées via la CLI SageMaker HyperPod, kubectl, ou les outils Slurm selon le cas |
Utilisez SageMaker Unified Studio lorsque l'appartenance à un projet, l'accès aux données, les outils de développement et le calcul nécessitent un contexte commun. Pour les modifications de cluster et l'automatisation répétable, continuez à utiliser les API SageMaker AI, l'infrastructure as code et les outils d'orchestration. Pour des implémentations de référence et des intégrations, consultez le site AI on SageMaker HyperPod .
Prenez les décisions d'infrastructure avant de connecter un cluster
Avant d'approuver une connexion, documentez le compte de capacité, tout compte consommateur ou de données, la région AWS, les chemins réseau, les identités, les propriétaires, les limites des charges de travail et les exigences d'isolation. Si vous avez besoin d'aide pour créer un cluster, reportez-vous à la documentation Amazon SageMaker HyperPod ou au site AI on SageMaker HyperPod.
Séparez les identités administratives et les identités de charge de travail. Préservez la distinction SageMaker HyperPod entre les administrateurs de cluster et les utilisateurs data scientists lors de la création des rôles de projet et d'accès. Un rôle orienté projet ne devrait pas recevoir de permissions sur le cycle de vie du cluster uniquement parce que ses utilisateurs exécutent des charges de travail. Reportez-vous à AWS Identity and Access Management for SageMaker HyperPod pour le modèle de permissions pris en charge.
Traitez le réseau comme un contrôle de bout en bout. Restreignez l'accès au point de terminaison de l'API Kubernetes Amazon EKS aux chemins réseau administratifs approuvés, contrôlez l'entrée et la sortie des pods, et vérifiez que le projet, le rôle de connexion, le rôle de charge de travail et le réseau du cluster ne prennent en charge que les chemins de données prévus. Pour la configuration spécifique à l'orchestrateur, reportez-vous à Orchestrating SageMaker HyperPod clusters with Amazon EKS.
Par exemple, configurez l'accès privé au point de terminaison de l'API Amazon EKS et ne l'autorisez qu'à partir des sous-réseaux administrateur ou de charge de travail approuvés. Appliquez une politique Kubernetes de type default-deny NetworkPolicy et autorisez explicitement les chemins requis de service à service et de sortie. Utilisez des points de terminaison de cloud privé virtuel (VPC) pour des services tels qu'Amazon S3, Amazon Elastic Container Registry (Amazon ECR) et Amazon CloudWatch le cas échéant, et attribuez à chaque tenant un rôle de charge de travail dédié pour l'accès aux données.
Créez un contrat de connexion. Un contrat de connexion est un enregistrement de gouvernance géré par le client, tel qu'une page wiki, un ticket, un enregistrement de catalogue de services ou un fichier suivi dans un dépôt d'infrastructure sous forme de code. Ce n'est pas une fonctionnalité de la plateforme. Consignez les informations suivantes pour chaque connexion projet-cluster approuvée :
- Propriétaire métier, propriétaire des opérations et propriétaire des coûts.
- Unité de domaine et projet SageMaker Unified Studio.
- Compte du cluster, Région, nom et orchestrateur.
- Rôle de projet et Amazon Resource Name (ARN) du rôle d'accès utilisé par la connexion.
- Types de charge de travail approuvés et classification des données.
- Espaces de noms EKS ou périmètre d'accès Slurm.
- Politique d'ordonnancement et propriétaire des exceptions.
- Attentes en matière de surveillance, de support et de mise hors service.
Ce contrat donne aux réviseurs un enregistrement unique pour évaluer et approuver le chemin d'accès complet.
Gouverner l'identité et la visibilité des tâches
Contrôlez à la fois les actions et la visibilité. Une configuration incorrecte des noms de tâches, des espaces de noms, des demandes de ressources et des modèles d'utilisation peut révéler des informations sur le travail d'une autre équipe.
Utilisez des groupes plutôt que des attributions individuelles pour l'appartenance aux projets et l'accès aux clusters lorsque c'est possible. Examinez chaque rôle à sa propre frontière au lieu de créer un rôle large qui couvre le domaine, le projet, le cluster et la politique de charge de travail.
Le flux de travail suivant montre comment séparer ce qu'un utilisateur peut voir de ce qu'un utilisateur peut faire.
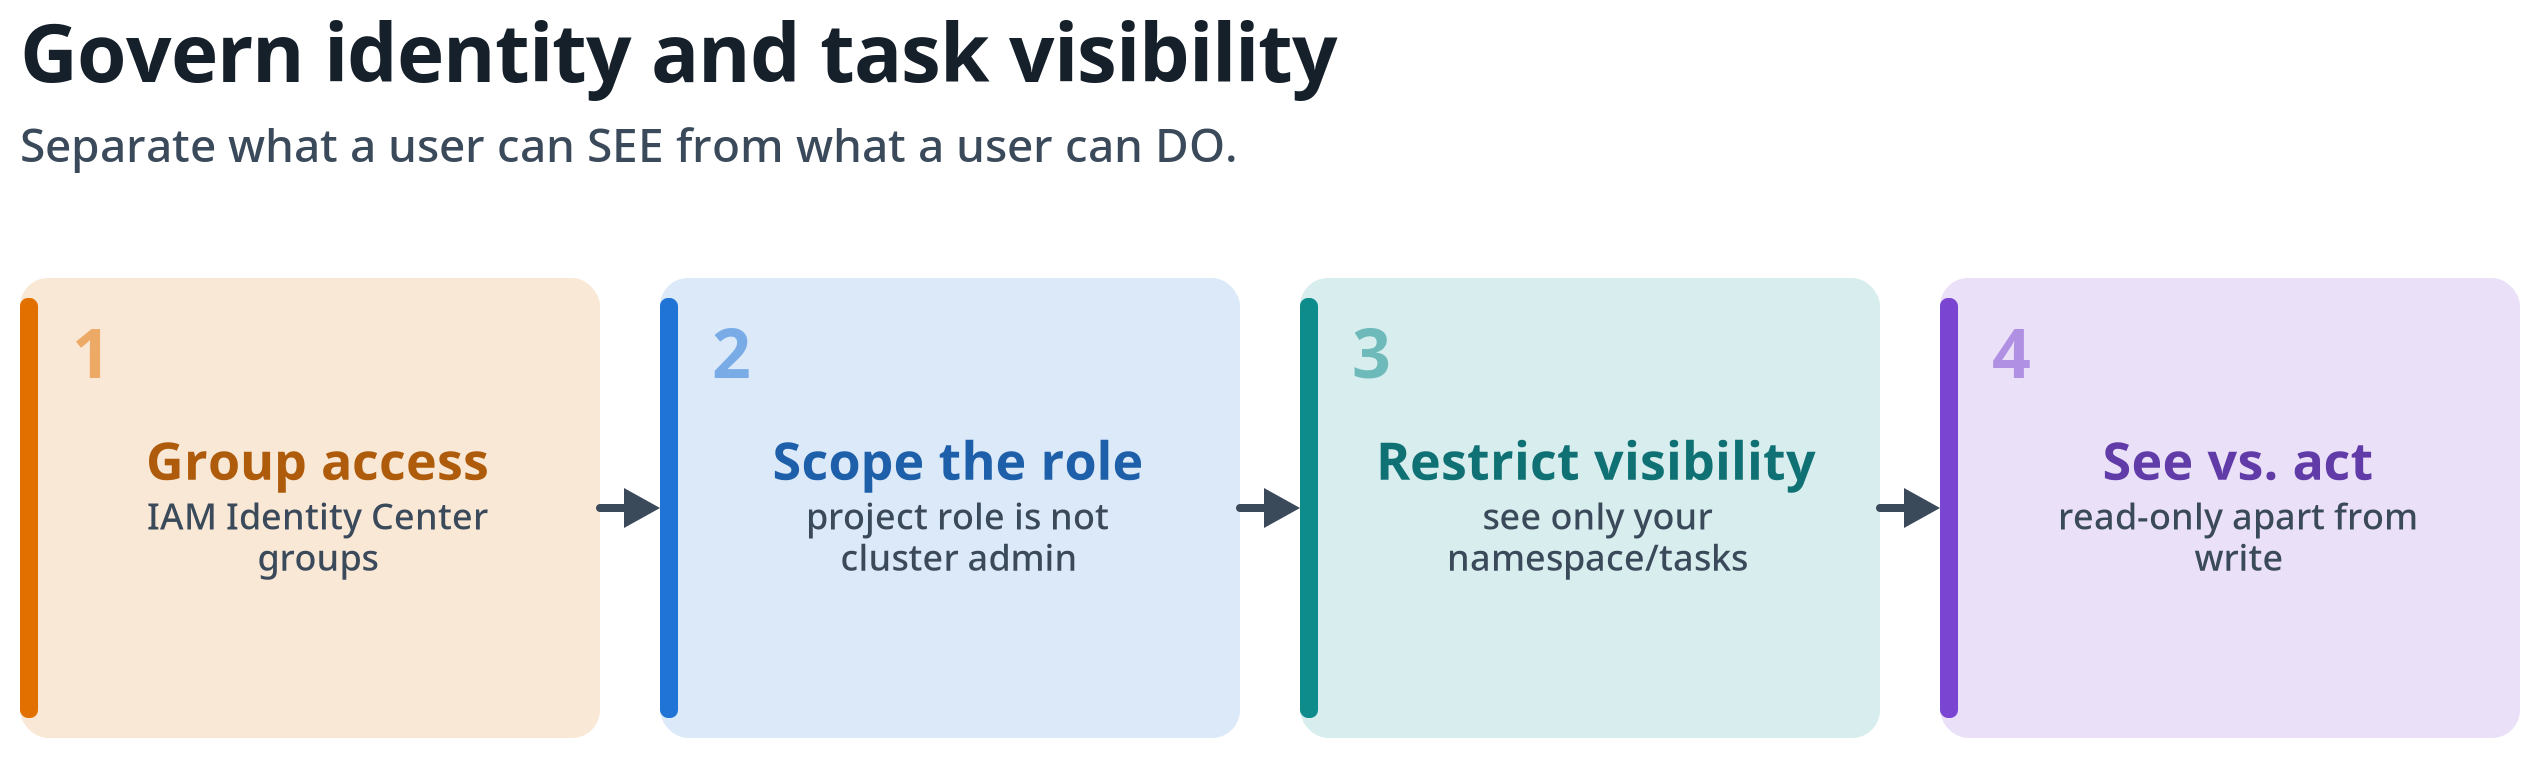
Figure 4 : Gouvernance de l'identité et de la visibilité des tâches. Attribuez l'accès via des groupes, délimitez chaque rôle à sa frontière, restreignez la visibilité des tâches et séparez la capacité de voir le travail de la capacité d'agir dessus.
Examinez la visibilité par défaut des tâches avant l'intégration des utilisateurs. La documentation pour SageMaker HyperPod dans SageMaker AI Studio explique que les utilisateurs de SageMaker AI Studio peuvent voir toutes les tâches des clusters Amazon EKS par défaut. Pour les clusters Slurm, chaque utilisateur de SageMaker AI Studio peut consulter, gérer et interagir avec les tâches disponibles. Configurez les restrictions de vue des tâches avant d'intégrer plusieurs équipes : voir Restrict task view in Studio for EKS clusters pour Amazon EKS et Restrict task view in Studio for Slurm clusters pour Slurm. L'appartenance à un projet n'est pas une frontière de sécurité au niveau du cluster.
Pour les clusters Amazon EKS, mappez chaque équipe à un espace de noms approuvé et à des permissions RBAC, et mappez chaque compte de service de charge de travail à un rôle IAM spécifique au tenant. Pour l'accès aux données entre comptes, associez le compte de service à un rôle EKS Pod Identity dans le compte de capacité (cluster) et définissez un rôle IAM cible sur l'association (targetRoleArn). EKS Pod Identity effectue alors automatiquement l'assumption de rôle entre comptes, de sorte que le code applicatif n'a pas besoin d'appeler AssumeRole. Le rôle cible réside dans le compte consommateur ou de données. Gardez la visibilité en lecture seule séparée des permissions de création, de mise à jour ou de suppression des charges de travail. Pour les clusters Slurm, définissez des contrôles équivalents pour les utilisateurs, les comptes, les partitions, les systèmes de fichiers et la visibilité des tâches.
Par exemple, le rôle Kubernetes RBAC suivant accorde à une équipe un accès en lecture seule aux jobs uniquement dans son propre namespace. Un rôle distinct est requis pour créer ou supprimer des workloads, ce qui maintient le « voir » séparé de l'« agir ».
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: team-research
  name: research-job-viewer
rules:
  - apiGroups: ["batch"]
    resources: ["jobs"]
    verbs: ["get", "list", "watch"]
  - apiGroups: ["kubeflow.org"]
    resources: ["pytorchjobs"]
    verbs: ["get", "list", "watch"]
Traduisez les priorités métier en politique d'ordonnancement
Pour les clusters Amazon EKS, appliquez la gouvernance des tâches uniquement après la mise en place des contrôles d'accès aux identités et aux workloads.
La figure suivante sépare les deux décisions que cela implique.
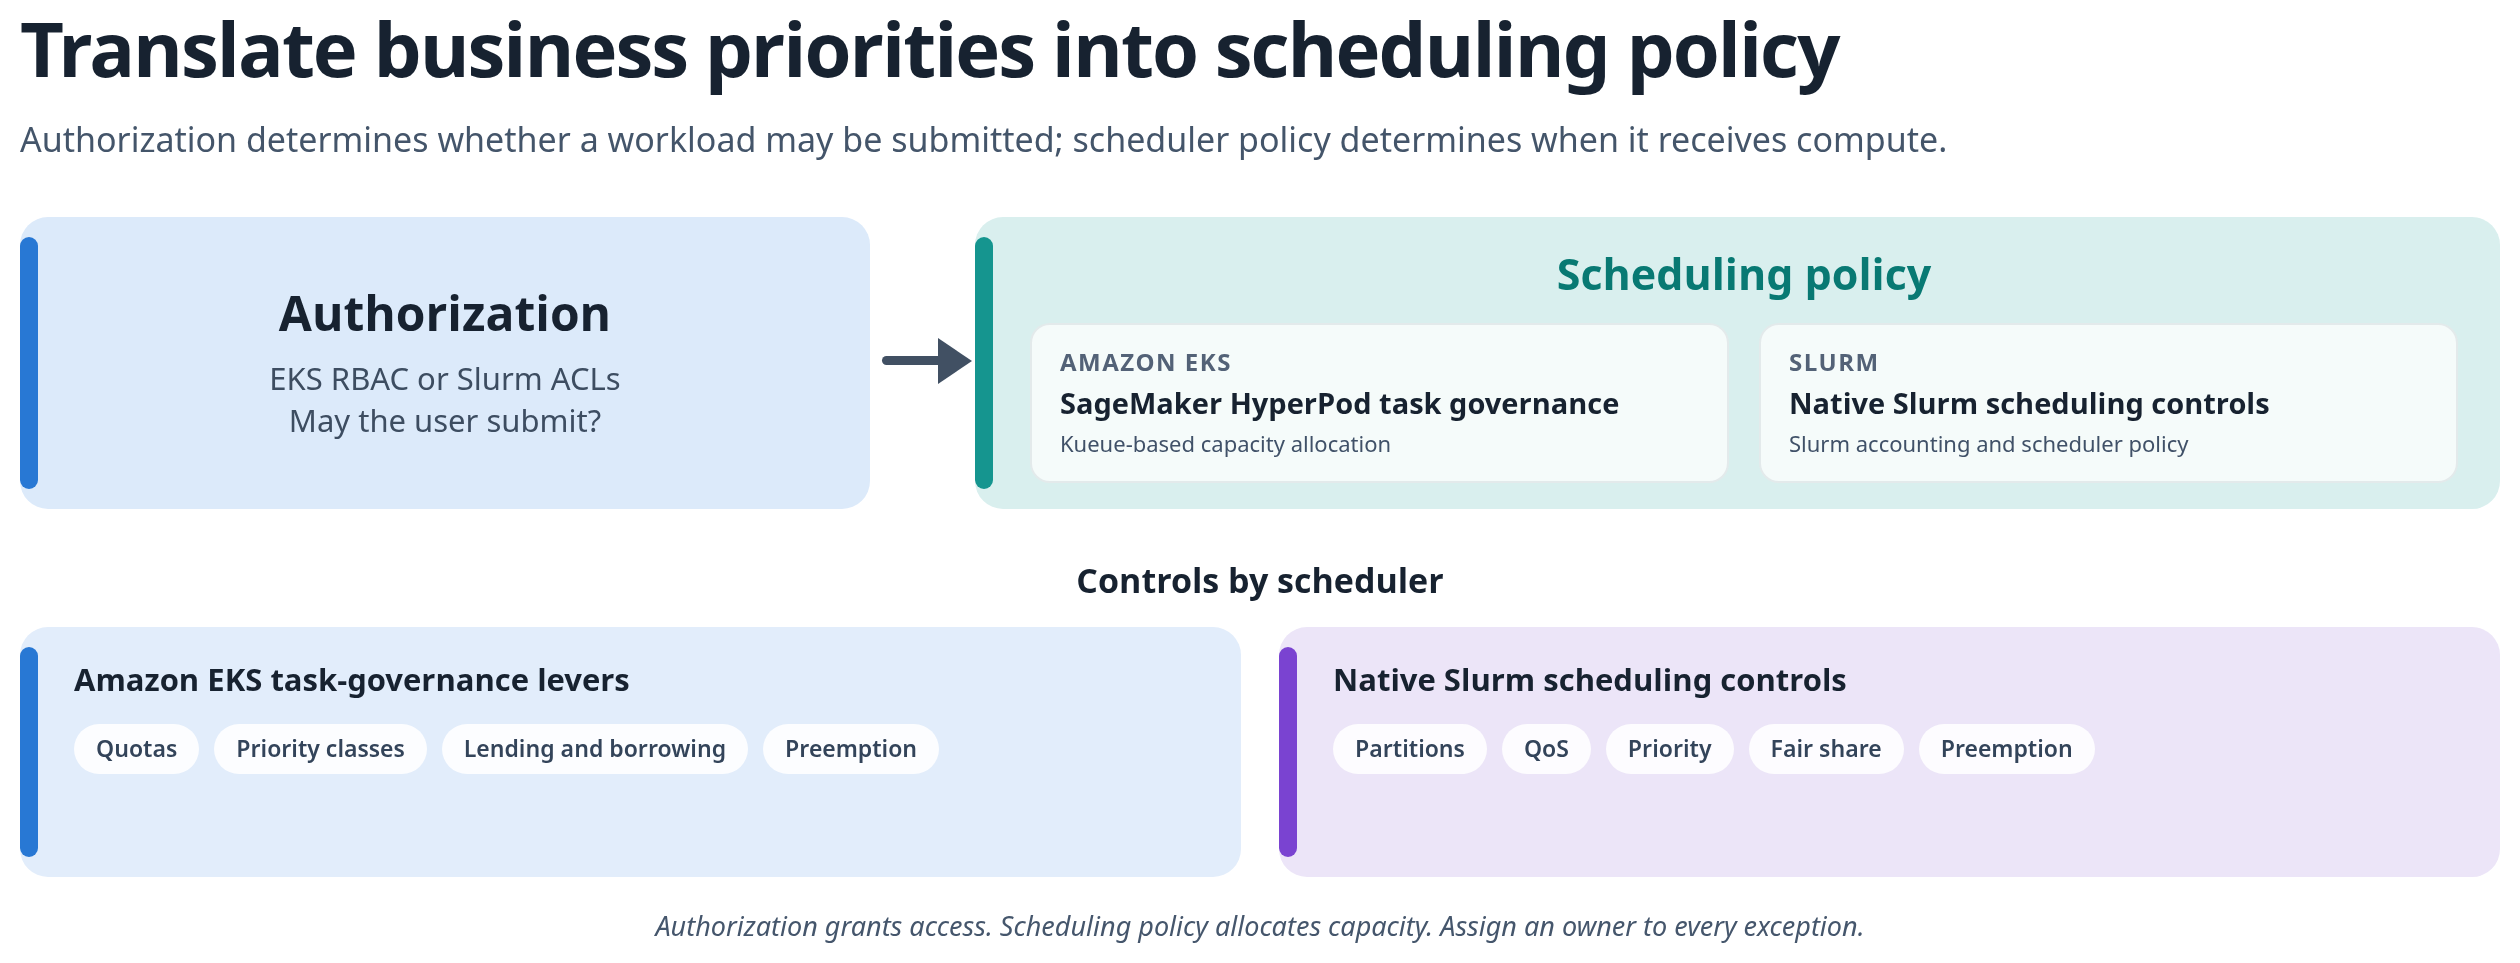
Figure 5 : Maintenir l'autorisation et la politique d'ordonnancement séparées. Le RBAC EKS ou les ACL Slurm déterminent si un utilisateur peut soumettre un workload. La gouvernance des tâches SageMaker HyperPod pour Amazon EKS ou les contrôles natifs d'ordonnancement Slurm déterminent quand il reçoit du calcul.
Capacité garantie et partagée documentée, classes de priorité, et savoir si une équipe peut utiliser l'allocation inactive d'une autre équipe. Attribuer un responsable à chaque exception. La gouvernance des tâches s'applique également aux SageMaker HyperPod spaces (environnements JupyterLab ou Code Editor autonomes qui s'exécutent directement sur le cluster), veillez donc à inclure ces charges de travail de développement interactif dans la politique d'allocation.
Par exemple, sur un cluster Amazon EKS, vous pouvez accorder à l'équipe de formation de production une allocation garantie de 60 pour cent avec une classe de priorité élevée, permettre à l'équipe de recherche d'emprunter la capacité inactive à une priorité inférieure, et autoriser la préemption de cette capacité empruntée lorsque l'équipe de production soumet des travaux. Désignez un responsable unique pour approuver toute exception à cette politique afin que les demandes ponctuelles ne deviennent pas discrètement la norme.
Gardez l'autorisation et la politique d'ordonnancement séparées. Les RBAC EKS ou les ACL Slurm déterminent si un utilisateur peut soumettre une charge de travail. La gouvernance des tâches SageMaker HyperPod pour Amazon EKS, ou les contrôles d'ordonnancement natifs de Slurm, déterminent quand cette charge de travail autorisée reçoit du calcul. Utiliser le quota de l'ordonnanceur comme contrôle d'accès, ou les contrôles d'autorisation comme politique d'ordonnancement, produit un comportement ambigu et rend les incidents plus difficiles à diagnostiquer.
L'article Best practices for Amazon SageMaker HyperPod task governance explique les pondérations de partage équitable, les quotas, le prêt et l'emprunt, les classes de priorité et les scénarios d'allocation courants. Pour les clusters Amazon EKS, utilisez ces modèles lors de la définition de la politique d'allocation. Pour les clusters Slurm, utilisez les contrôles d'ordonnancement natifs décrits précédemment.
Utiliser l'observabilité comme boucle de rétroaction de gouvernance
Avec SageMaker Unified Studio, vous pouvez consulter les détails du cluster SageMaker HyperPod pour les tâches, les métriques, les paramètres et les métadonnées. Pour les clusters Amazon EKS, les métriques de gouvernance des tâches incluent des vues matériel, équipe et tâche. Ces vues vous aident à comparer l'intention de la politique avec la consommation réelle.
Traitez l'observabilité comme une boucle, comme illustré dans la figure suivante.
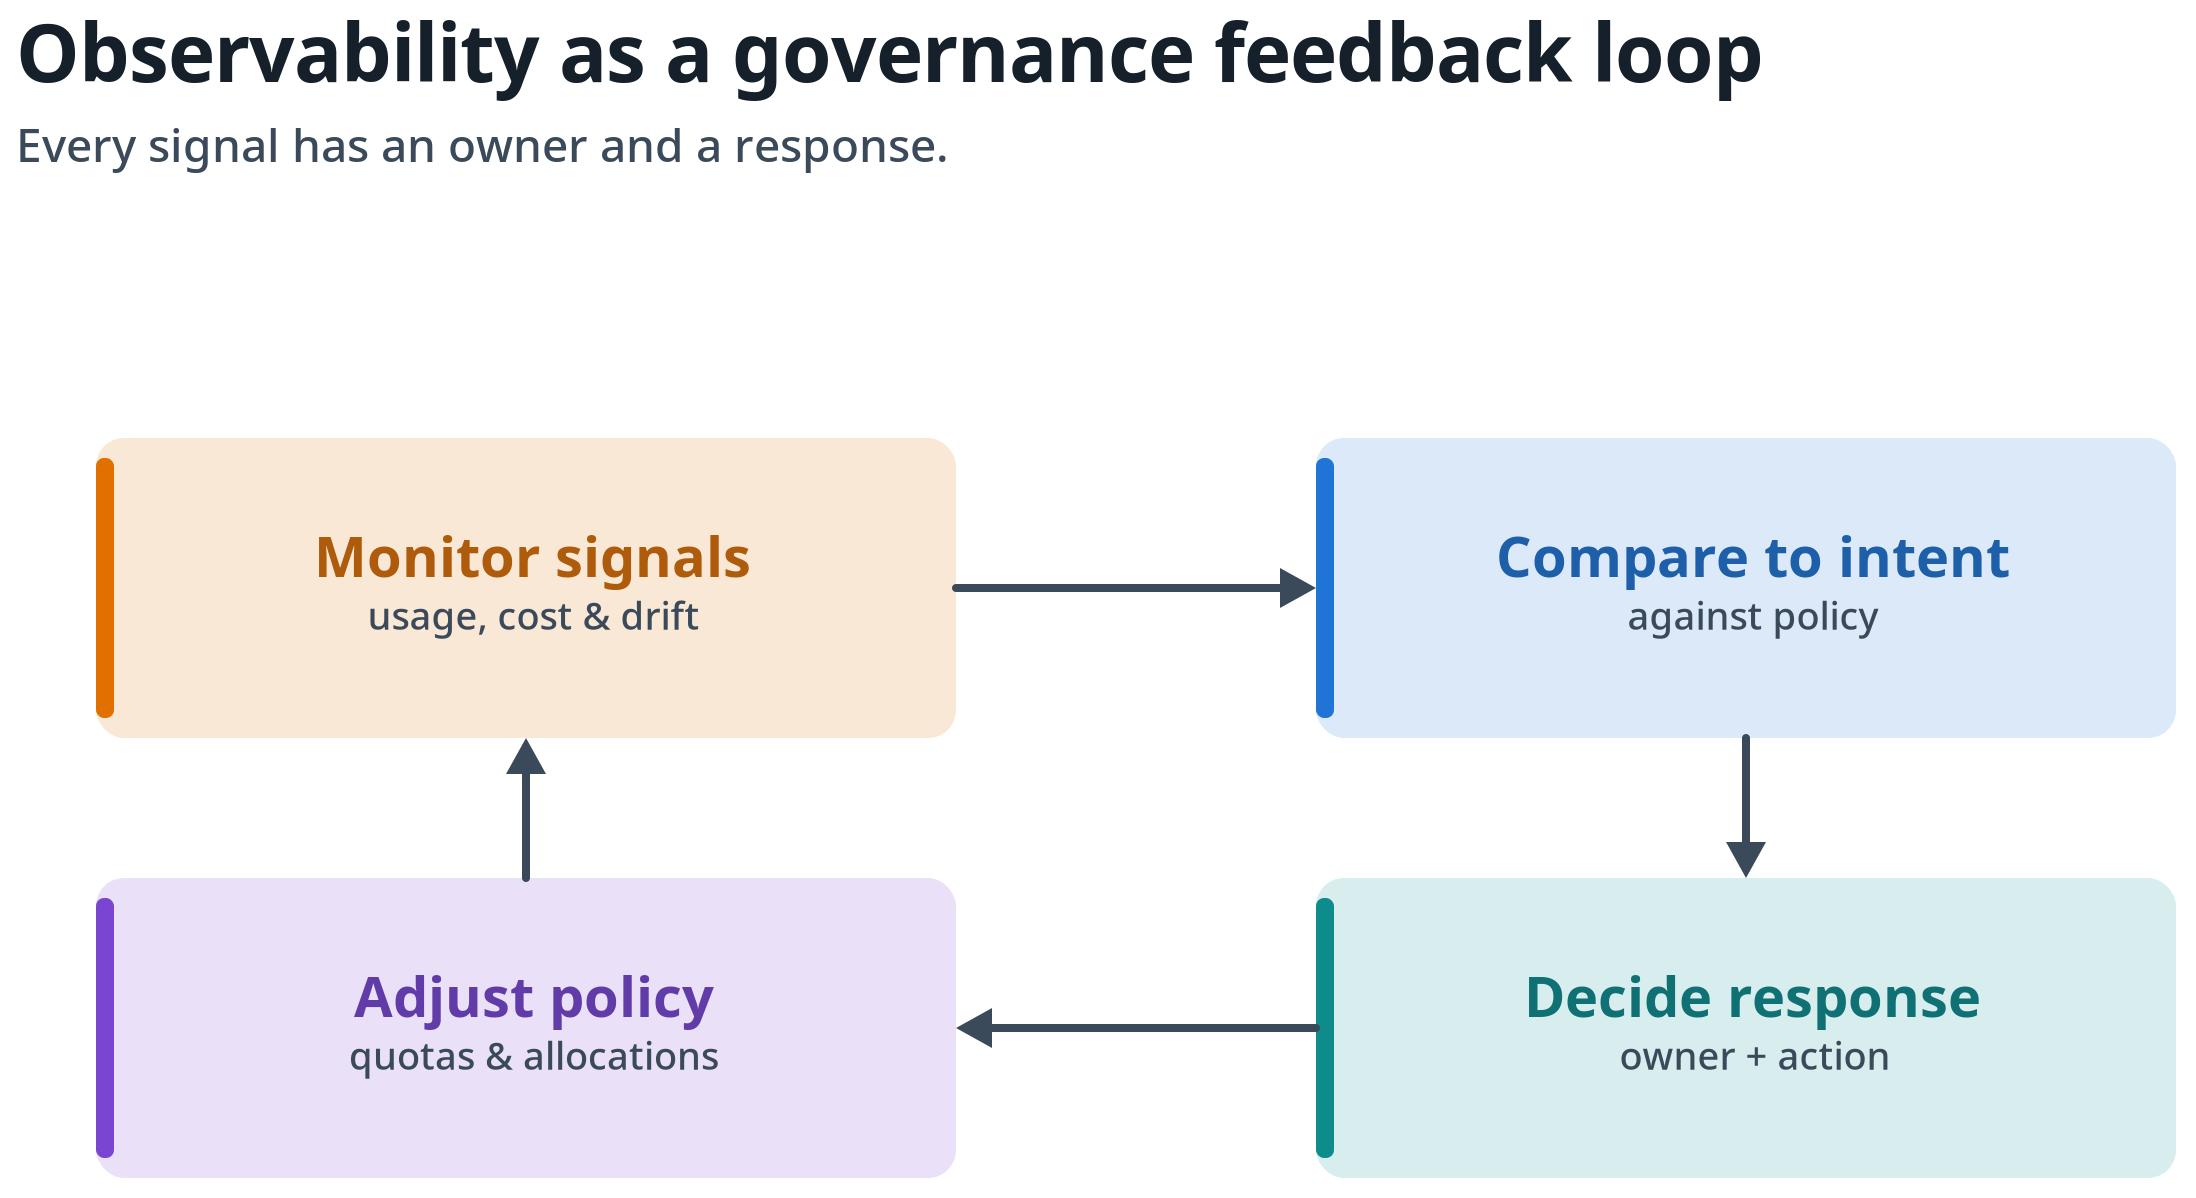
Figure 6 : L'observabilité comme boucle de rétroaction de gouvernance. Surveiller les signaux, les comparer à l'intention de la politique, décider d'une réponse, et ajuster la politique et les allocations, en attribuant un responsable et une réponse à chaque signal.
Définissez un responsable et une réponse pour chaque signal que vous surveillez. Les exemples suivants transforment les données de tableau de bord en décisions administratives.
| Signal | Décision administrative |
| Capacité du cluster et utilisation des accélérateurs | Déterminer si la faible utilisation est temporaire, dictée par la politique, ou causée par des contraintes de charge de travail |
| Allocation et utilisation par équipe | Vérifier si la capacité réservée et partagée reflète toujours la demande métier |
| Durée d'exécution et temps d'attente des tâches | Examiner la politique de priorité, le dimensionnement des charges de travail ou la contention de capacité |
| Tâches en attente et préemptées | Confirmer que les résultats de l'ordonnanceur correspondent au modèle de priorité approuvé |
| Santé des nœuds et événements de récupération | Déclencher le processus d'incident du cluster et valider les objectifs de récupération |
Pour les clusters Amazon EKS, la table des tâches affiche les tâches Kubeflow (PyTorch, MPI et TensorFlow), et les tâches PyTorch sont affichées par défaut. Les charges de travail soumises par d'autres mécanismes peuvent ne pas y apparaître. Pour les clusters Slurm, les tables de tâches affichent les travaux dans la file d'attente actuelle de l'ordonnanceur, tandis que la comptabilité Slurm fournit des données historiques sur les travaux via des outils tels que sacct. Définissez où vous obtenez les données historiques des tâches, les preuves d'audit et les détails des incidents.
Le module complémentaire Amazon CloudWatch Observability EKS est requis pour les vues de métriques documentées. Ce module complémentaire a ses propres prérequis : version 2.4.0 ou ultérieure, et la CloudWatchAgentServerPolicy politique IAM attachée au rôle du nœud worker Kubernetes. Les métriques Kueue, qui alimentent les vues de gouvernance des tâches, peuvent entraîner des frais de métriques CloudWatch après le niveau gratuit. Reportez-vous à la documentation du tableau de bord SageMaker HyperPod pour les considérations actuelles de configuration et de tarification.
Examiner les connexions tout au long de leur cycle de vie
Définissez un calendrier de revue pour chaque connexion. Définissez également des revues pilotées par les événements pour les changements de propriétaire du projet, de rôles d'accès, de compte ou de Région, de capacité du cluster, de version de l'orchestrateur, de classification des données ou de couverture de supervision. Utilisez le contrat de connexion pour consigner chaque décision.
La figure suivante montre les étapes du cycle de vie.
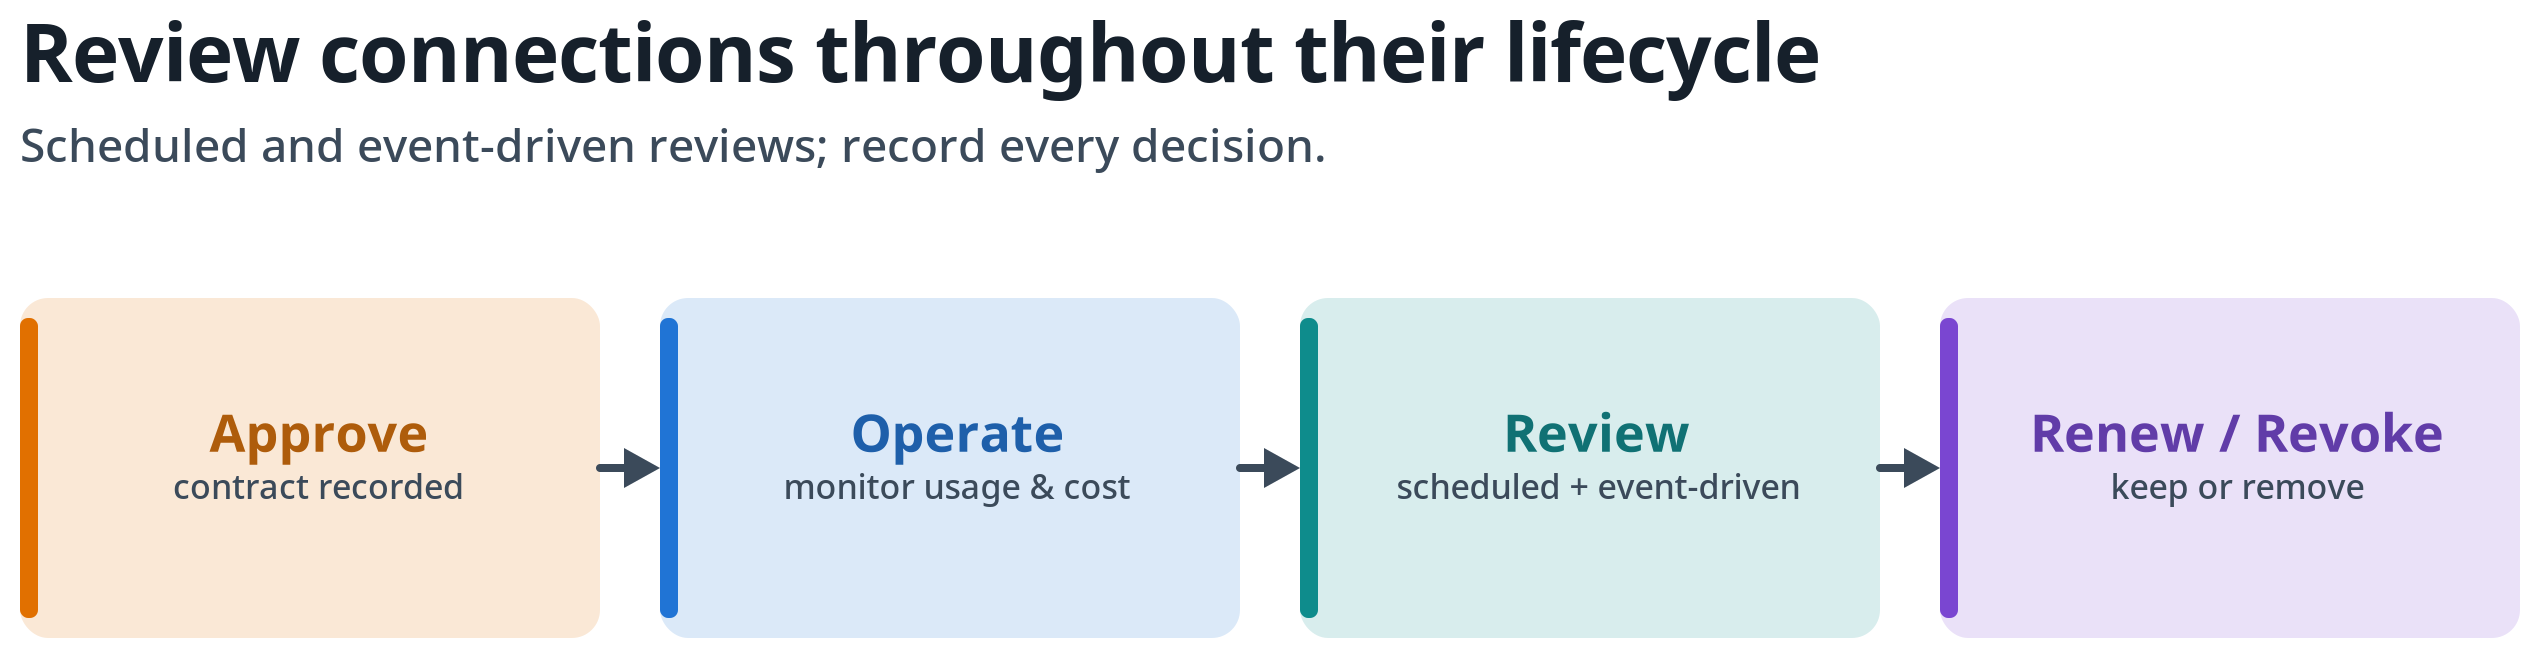
Figure 7 : le cycle de vie de la connexion. Approuvez une connexion avec un contrat de connexion consigné, exploitez-la et surveillez-la, revoyez-la selon un calendrier et lors d'événements définis, puis renouvelez-la ou révoquez-la.
Automatisez l'inventaire et la collecte des preuves lorsque cela réduit le travail manuel, mais conservez l'approbation entre les mains d'administrateurs responsables. Révoquez les connexions qui n'ont plus de finalité métier ni de responsable désigné.
Conclusion
Avec Amazon SageMaker Unified Studio, les équipes de machine learning peuvent suivre un parcours axé sur les projets vers un calcul SageMaker HyperPod approuvé, tandis que les équipes d'infrastructure conservent le contrôle du cluster centralisé. Commencez avec un seul cluster de non-production et un projet de test. Configurez l'identité de charge de travail, la portée de namespace ou Slurm, les permissions de données, la politique réseau, les restrictions de vue des tâches et la gouvernance des tâches pour Amazon EKS, ou les contrôles natifs d'ordonnancement pour Slurm, avant d'ajouter des membres. Installez l'add-on Amazon CloudWatch Observability EKS afin que les vues de métriques se remplissent, et consignez l'approbation complète dans le contrat de connexion. Utilisez des rôles inter-comptes pour les comptes consommateurs approuvés, et utilisez une infrastructure dédiée lorsqu'une isolation stricte est requise. Suivez la procédure de connexion SageMaker HyperPod pour les étapes de mise en œuvre.